快速导读:ONEIRA用coding Agent维护可扩展世界状态表,把交互结果写成显式状态再渲染成条件视频,让新生成物体可交互、改过的结果跨片段保持。
生成式视频世界模型已经能合成可漫游、可做简单交互的开放环境,但开放生成并不等于完整交互:世界在像素上变大时,新出现的物体未必被登记成可操作实体;一次看起来合理的交互,也未必被写成后续片段必须遵守的状态。作者把这两条要求分别叫作Open-World Interactivity与Persistent State——看见的要能接着动手,改过的要一直改着。
ONEIRA(arXiv:2610.01614,Monash / Bristol / 大连理工 / 港中深 / Oxford)把世界演化从视觉实现里拆出来:coding Agent读当前观察与目标,把交互规划写进可扩展的世界状态表;轻量引擎沿相机轨迹把表渲染成粗糙条件视频;预训练视频模型再补外观、运动和表里没有的交互细节。新物体可从生成帧登记进表,旧的状态变化则跨片段保留。项目页https://madaoer.github.io/projects/oneira/。
英文题目:ONEIRA: From Open-Ended Generation to Open-World Interaction in Video World Models
论文出处:arXiv 每日论文精选 · arXiv:2610.01614
原始论文:PDF / 论文页面
这篇论文解决什么问题?
传统模拟器里物体存在于权威状态、动作改的是这份状态。生成世界则常把“存在”只留在像素里,把“改过”只留在最近几帧的视觉上下文里,于是场景可以在观感上扩张,可交互集合却不跟着扩张。
现有视频世界模型把控制从相机、玩家输入扩展到语言事件,也用记忆改善长程一致性,但世界状态仍多隐式地藏在像素、提示或潜上下文中。显式三维模拟器能引用和保存物体,可交互范围却被预置资产绑死。缺的不是“有一份状态”,而是一份能随生成世界一起变大的状态。
ONEIRA因此让coding Agent维护轻量表:只存交互相关的几何与状态,把长相和复杂运动交给视频先验;训练与推理使用同一套状态表示,避免“推理时才突然多出一张表”。
核心创新
- 用coding Agent持续更新可扩展世界状态表,实现开放世界可交互与持久状态。
- 以状态表加粗糙条件视频作为世界演化与视频生成的接口,支持实例级控制。
- 训练管线把视频与相机路径、状态表、chunk交互字幕对齐,训练推理同一表示。
方法概览
片段级闭环:coding Agent规划目标实例与时机,引擎更新表并沿相机轨迹渲染粗糙条件视频(环境球、地面网格、用颜色编码状态的三维盒),视频模型在首帧、可选记忆帧、条件视频与chunk字幕上生成。新物体从生成观察登记,被移动物体丢盒后重注册。MiniMax-H3 Ref2VA上LoRA微调,训练与推理共用同一状态表示。
- 系统四件套:coding Agent A、世界状态表T、引擎E、视频生成器G。片段k上,A读取Tk−1与当前首帧,输出规划动作Pk=(目标实例、动作类别、交互chunk、相机停距、连带改变的其他物体)。引擎做确定性状态转移Tk=U(Tk−1,Pk),沿相机路径Ck把Tk渲染为条件视频Vk并写chunk字幕ck,再由G生成该段。末帧与更新后的表启动下一段。
- 表Tk=(Gk,Ok),Gk为可行走地面;每个物体条目含语义标签、世界坐标中心与尺度、偏航、是否在该位姿在场,以及σ∈{0,1,2}的交互状态(0为默认,非默认语义由文本指定)。交互改变的是结果而不是完整运动轨迹:被搬走的物体先丢掉包围盒,停稳后再从生成帧重新登记;探索中新看见的物体同样并入Ok。条件视频按Wonder的思路画环境球与立方格脚手架,地面网格和物体盒子的颜色编码状态(紫默认、黄已改、虚线表示从表中移除)。记忆帧只保留与当前Tk状态一致的旧视角,避免过期外观顶掉新状态。
- 生成器以MiniMax-H3 Ref2VA为骨干,对DiT注意力投影做rank 128的LoRA;条件视频448×256,输出832×480。实验中coding Agent为Claude Opus 4.8,感知工具建表,OpenGL渲染条件视频。训练语料约1万条十秒clip,用同一套表与渲染代码对齐相机路径、状态表和chunk级交互字幕。
逐图理解论文
状态表闭环
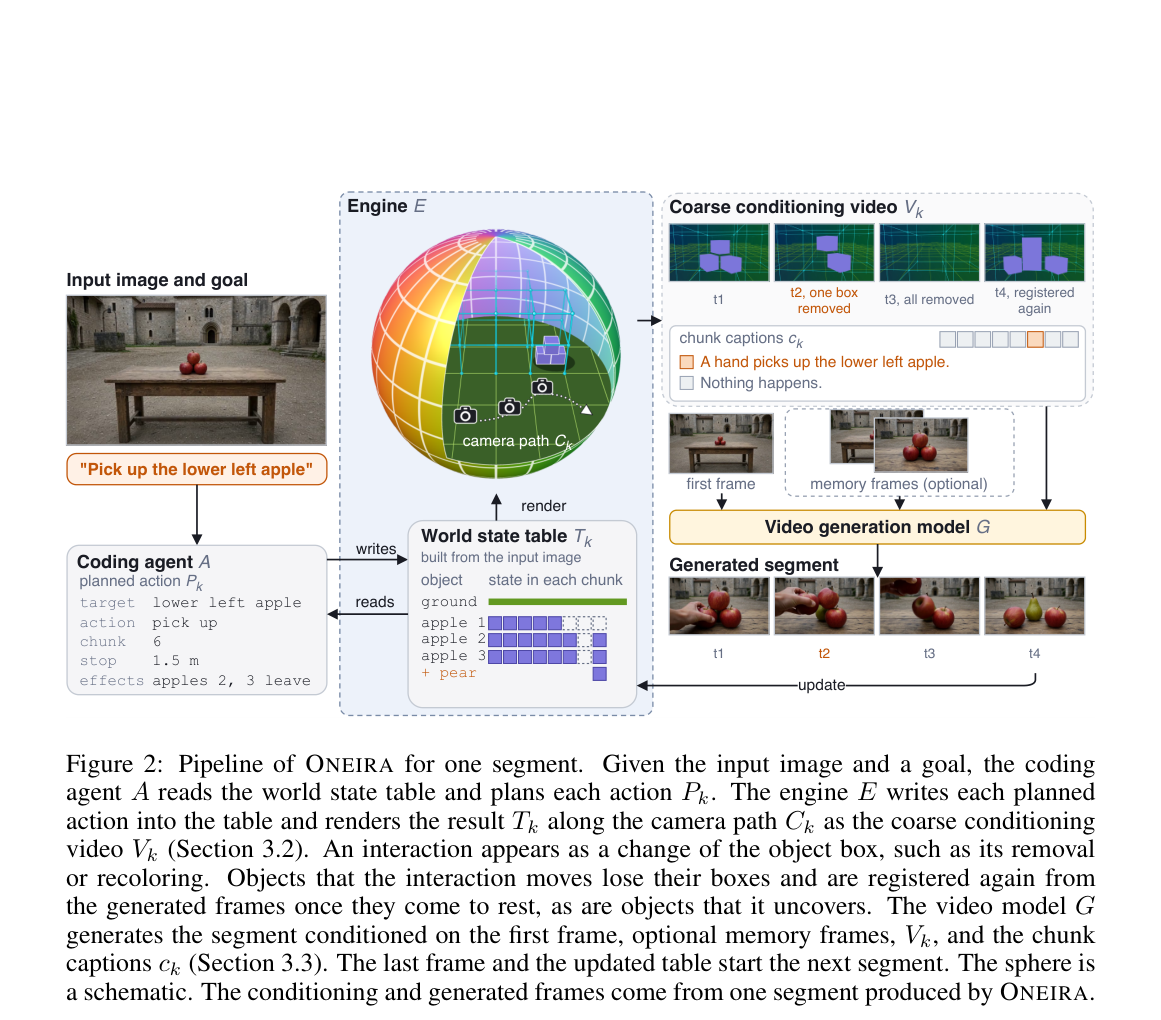
图2是单片段管线,宜作特色图。左侧输入庭院桌上三只苹果与目标“Pick up the lower left apple”;coding Agent写出target/action/chunk/stop/effects。中间引擎用彩色环境球与相机路径把世界状态表渲染出来,表里apple 1–3按chunk从紫盒变为虚线,并新增pear。右侧粗糙条件视频在t2移除一只盒、t3全移除、t4再登记,橙色chunk字幕写“A hand picks up the lower left apple”。视频模型G吃首帧、可选记忆帧、Vk与ck,生成段末出现梨,并回写表。
关键证据
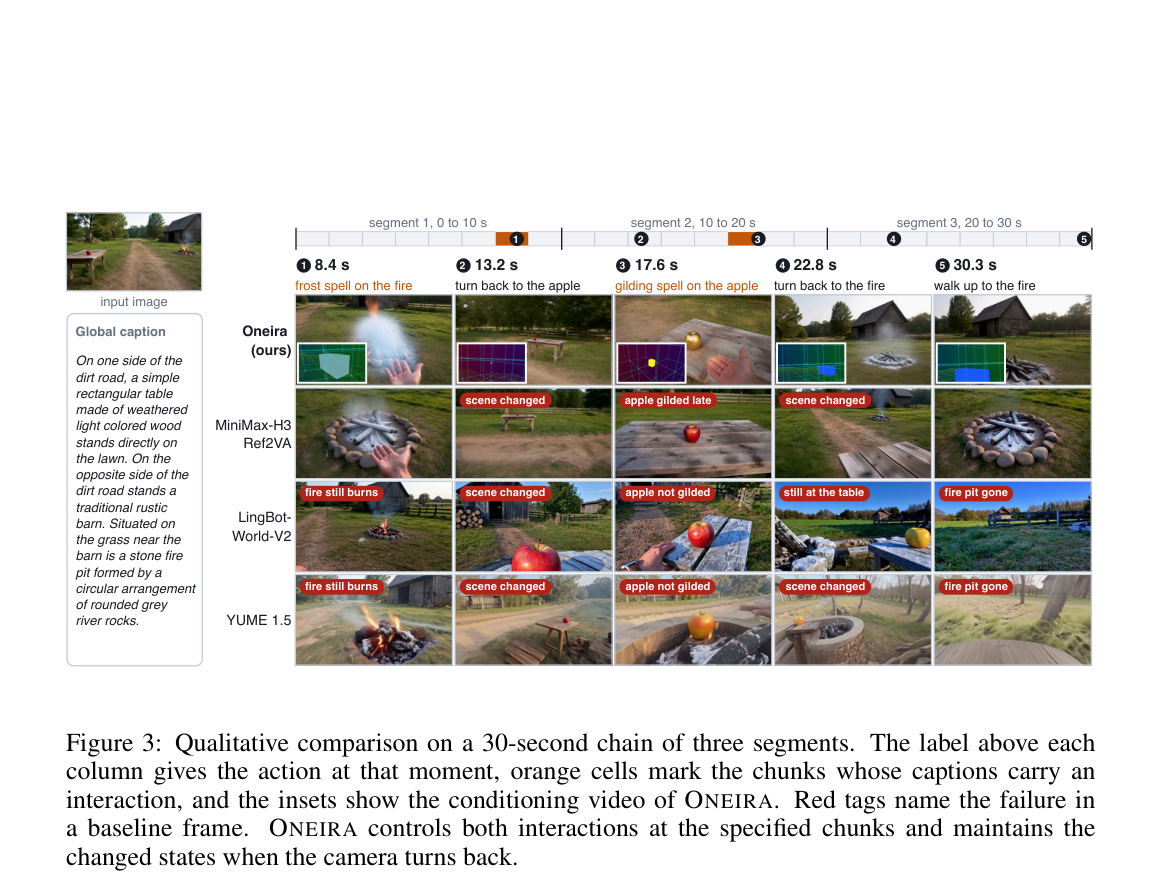
图3对比三十秒三段链。时间轴橙色格标交互chunk:8.4秒霜冻灭火、17.6秒给苹果镀金,中间与之后是转回。ONEIRA行带条件视频小窗,火灭且回头仍灭,苹果镀金且回头仍在。MiniMax行红标scene changed与apple gilded late;LingBot与YUME行火仍烧、苹果未镀金,随后still at the table或fire pit gone。用来说明持久状态不是邻帧好看,而是回头时改过的东西还在。
Figure 4: Data pipeline
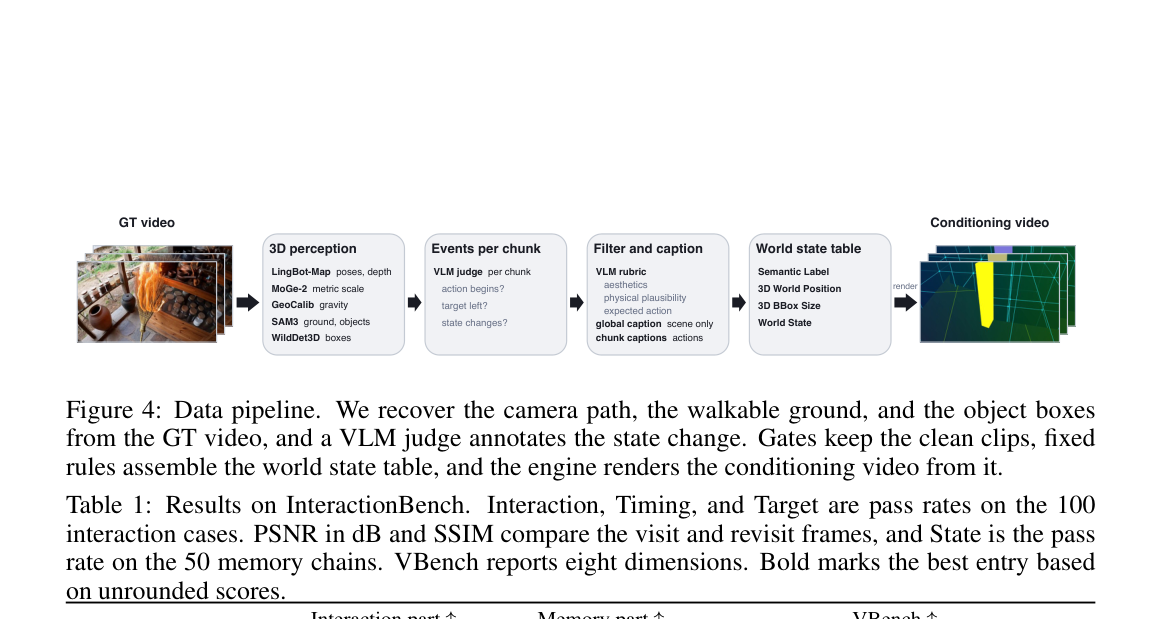
图4是训练数据管线:真值视频经LingBot-Map位姿深度、MoGe-2尺度、GeoCalib重力、SAM3地面物体、WildDet3D三维盒;VLM按chunk问动作是否开始、目标是否离开、状态是否改变;再经美学与物理合理性门控,写成只描述场景的全局字幕与动作chunk字幕,组装状态表并渲染条件视频。该裁切下沿还露出Table 1表题,交互三项与记忆PSNR等数字以正文表1为准,不要把这张图当成结果主图。
实验如何设计?
- InteractionBench含100个交互案例与50条记忆链,首帧由GPT-Image-2生成。交互分单目标50与多目标50,后者或是五种相同物体,或是两类各三件;动作用12类动作中的一或两个。记忆链为两段共20秒:先交互,再把相机转走并回到交互后到过的位姿。
- 对照为骨干MiniMax-H3 Ref2VA,以及LingBot-World-V2、YUME 1.5、AlayaWorld。LingBot与AlayaWorld吃逐帧位姿,YUME与MiniMax只吃按chunk写的相机文本;记忆部分给MiniMax与ONEIRA同样数量的记忆帧。交互分Interaction/Timing/Target三个通过率,前两项由Gemini 3.7 Flash当VLM裁判,Target则对生成视频重建状态表看改的是不是目标实例。记忆部分报重访PSNR/SSIM与State保持率,并在全部150例上报告VBench八维。
- 数据管线从真值视频恢复相机、地面与三维盒,VLM按chunk标注状态变化,过滤后按固定规则建表并渲染条件视频。来源包括专有模型合成的十二类状态改变第一人称视频,以及Sekai真实行走与ABot游戏导航。图5显示导航约占42%、交互约占58%。消融分别去掉环境球/立方格、物体盒子或chunk字幕。
关键结果与论文证据
- 表1上ONEIRA交互三项通过率为Interaction 0.78、Timing 0.76、Target 0.82,分别高出最强基线约0.29、0.19、0.29。对照常常在指定chunk里开始了某种动作(三项中有三项基线Timing高于Interaction),但改错内容或改错实例。记忆部分PSNR 21.11、SSIM 0.64、State 0.80;相对第二名PSNR约+93%、SSIM约+83%、State约+18%。MiniMax靠记忆帧能把State做到0.68,但没有相机控制,重访帧不在同一位姿,PSNR只有10.96(页8–9)。
- 图3是三十秒三段链:先对火堆施霜冻、转回桌子给苹果镀金、再转回火堆。ONEIRA在橙色chunk里完成两处交互,回头时火仍灭、苹果仍金。MiniMax把苹果镀金晚了约一个chunk,转身后面貌改景;LingBot-World-V2与YUME 1.5火没灭,随后火塘消失或整段换景。作者把差距归结为:记忆帧保住改后外观,状态表钉住物体位置,条件视频钉住相机转弯(页7、9)。
- 表2去掉环境球后Interaction降到0.63、旋转误差升到3.32°;去掉盒子后Target 0.61,模型只能从文本猜实例;去掉chunk字幕后Timing 0.66,全局提示说得出时刻却对不齐chunk。完整模型为0.78/0.76/0.82,RotErr 2.60°、TransErr 0.13(页9)。
阅读时需要注意
- 当前动作空间仍是离散的,精细操作与连续控制(如机器人)还不在范围内。
- 复杂交互的物理真实感取决于视频模型学到的动力学,而不是显式物理引擎。
- 显式状态改善了交互结果的持久性,长程视觉一致性仍受底层视频生成器上限约束。
关联工作
- LingBot-World、YUME、AlayaWorld等把交互结果主要留在生成观察里;ONEIRA先写表再渲染。
- 代码世界模型与可编程场景能提供可编辑状态,ONEIRA的coding Agent直接从目标选择改哪个实例、何时改,并记录第一人称结果。
- 粗条件视频生成(G-buffer、三维代理、相机脚手架)多编码几何与视点;ONEIRA额外用盒子颜色编码物体状态。