快速导读:SpaTime 把冻结 StreamVGGT 的因果三维几何 token 逐帧融入流式视觉语言模型,并用可微响应时刻损失监督何时作答。
具身智能在厨房或走廊里被提问时,视频往往还在到来:杯子在左还是右,离起点还有多远,饮水机大约几米。答太早等于猜测尚未看见的部分,答太晚会卡住当前动作。SpaTime(arXiv:2610.08713,Purdue University 与 Goertek Alpha Labs)针对这一设定,把冻结 StreamVGGT 的因果三维几何 token 逐帧加到流式视觉语言模型上,并用地图化的响应时刻损失监督何时开口。
作者把离线空间基准改成带到达时刻与真值作答时刻的 StreamVSTI-Bench 与 StreamVSI-Bench。仅在前者 132,568 条样本上微调后,慈善模式总体准确率 49.20%,平均响应时刻误差 ∆t 为 0.12 秒,相对最准时的流式基线 Streamo(0.35 秒)缩短约 66%。严格模式下为 48.80%,与慈善结果接近。工作是预印本,尚未同行评审。
英文题目:SpaTime: Streaming Vision-Language Models for Spatio-temporal Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2610.08713
原始论文:PDF / 论文页面
这篇论文解决什么问题?
空间推理视觉语言模型与流式视觉语言模型一直朝两个相反方向拉。VG-LLM、VLM-3R 把 VGGT 或 CUT3R 几何先验写入语言模型,在 VSI-Bench、VSTI-Bench 上较强,但几何编码、特征融合与生成都对完整帧序列做全局处理,问题若在中途到达就无法作答。VideoLLM-online、Dispider、Streamo 按帧发出状态 token、自己决定何时响应,却没有显式三维表示,空间题容易猜错尺度。
StreamVGGT 已经表明:把 VGGT 蒸馏成带 KV 缓存的因果 Transformer 后,每帧几何代价可以恒定。真正缺的是两块。第一,几何 token 必须在不看未来帧的前提下进入语言模型,而现有融合多为离线全序列设计。第二,作答时刻本身要可训练:流式常用的逐帧交叉熵或 focal 损失对早一帧和早十帧给同样惩罚。SpaTime 同时补这两块。
核心创新
- 用冻结 StreamVGGT 的因果几何 token 与视觉 token 做逐帧相加融合,全程不查阅未来帧且每帧代价恒定。
- 提出可微响应时刻损失,把首次作答概率聚成期望时刻,按与真值帧的距离惩罚过早或过晚开口。
- 给出把离线空间问答改成流式评测的流程,建成 StreamVSTI-Bench 与 StreamVSI-Bench。
方法概览
SpaTime 建在 Qwen2.5-VL-7B-Instruct 与冻结 StreamVGGT 上。每帧视觉编码器产出 Vt,几何编码器以因果注意力与 KV 缓存产出 Gt,二者冻结。融合沿用 VG-LLM:对几何网格做 2×2 合并,用带 RMSNorm 的两层 MLP 投到语言模型隐空间,再与同帧视觉 token 逐位置相加得到 St,每帧 324 个融合 token。语言模型用 LoRA,embed_tokens 与 lm_head 全量训练以学习三个状态 token:⟨Silence⟩继续看流,⟨Standby⟩已看到线索但仍需后续帧,⟨Response⟩触发作答。因果注意力保证 t 时刻只看 ≤t 的帧。状态感知 focal 损失处理静默占优;响应时刻损失从三分类 logit 取出作答概率 pk,用生存形式 p̄k=pk∏j<k(1−pj) 表示首次作答落在第 k 帧的概率,soft-argmax 得到可微期望时刻 t̂ans,再对 (t̂ans−tans)/T 做 δ=0.2 的 Huber。类型权重 wfut=1、wcur=wpast=0,λtime=3.0,只监督必须等待的 current-ask-future。总损失 Lfocal+Ltime。基准方面,从 ScanNet、ScanNet++、ARKitScenes 的 VSTI/VSI 标注重建三维资产,投影 OBB 做几何可见性,Qwen2.5-VL-7B 复核可识别性,按题型规则选定 tans,再随机分配 current-ask-current / past / future 变体。
- 骨干是 Qwen2.5-VL-7B-Instruct,几何编码器是冻结的 StreamVGGT。每帧视觉编码器产出 Vt,几何编码器只用当前帧与历史 KV 产出 Gt。可训练部分包括融合投影器、语言模型 LoRA、状态 token 嵌入和 LM head,可训练参数约 1,461.2M(15.0%)。视觉 ViT 与视觉–语言对齐器保持冻结。
- 融合沿用 VG-LLM:对几何网格做 2×2 空间合并,经 RMSNorm 与两层 MLP 投到语言模型隐维度,再与同帧视觉 token 逐位置相加,每帧得到 324 个融合 token。因为几何编码器因果、融合按帧,t 时刻只处理 ≤t 的帧,每帧代价不随流变长而增加。
- 语言模型沿用 Streamo 的多轮协议。每帧把融合 token、时间戳和待回答句拼成用户轮,助手轮必须以 ⟨Silence⟩、⟨Standby⟩ 或 ⟨Response⟩ 开头;只有 Response 后才写答案。因果注意力掩码禁止看未来帧。状态感知 focal 损失处理静默占优。
- 响应时刻损失把“何时开口”变成可微标量。从决定该帧状态 token 的那一行取出三分类 logit,softmax 得到作答概率 pk;首次作答落在第 k 帧的概率写成 p̄k=pk∏j<k(1−pj),在对数空间计算。soft-argmax 得到期望时刻 t̂ans,若总质量低于 10^{-4} 则回退到最后一帧。损失为 λtime·wτ·Huberδ((t̂ans−tans)/T),δ=0.2,λtime=3.0。类型权重只给必须等待的 current-ask-future:wfut=1,wcur=wpast=0。总目标是 Lfocal+Ltime。
- 流式基准保留 VSTI-Bench 与 VSI-Bench 的原问答,场景来自 ScanNet、ScanNet++ 与 ARKitScenes。管线先从 .sens 与实例标注重建相机与有向包围盒,投影到图像后用面积比、包含比、距离和深度遮挡做几何可见性;再用 Qwen2.5-VL-7B 在可见帧上复核物体是否可识别。500 个可见物体–帧对的人工一致率为 84.4%。按题型规则选定 tans:计数取各实例首次可见的最晚帧,关系题取相关物体都出现的最早帧,房间尺寸与路线规划默认末帧。再把问句相对 tans 摆成 current-ask-current、current-ask-past 与 current-ask-future 三种变体。
逐图理解论文
评测缺口
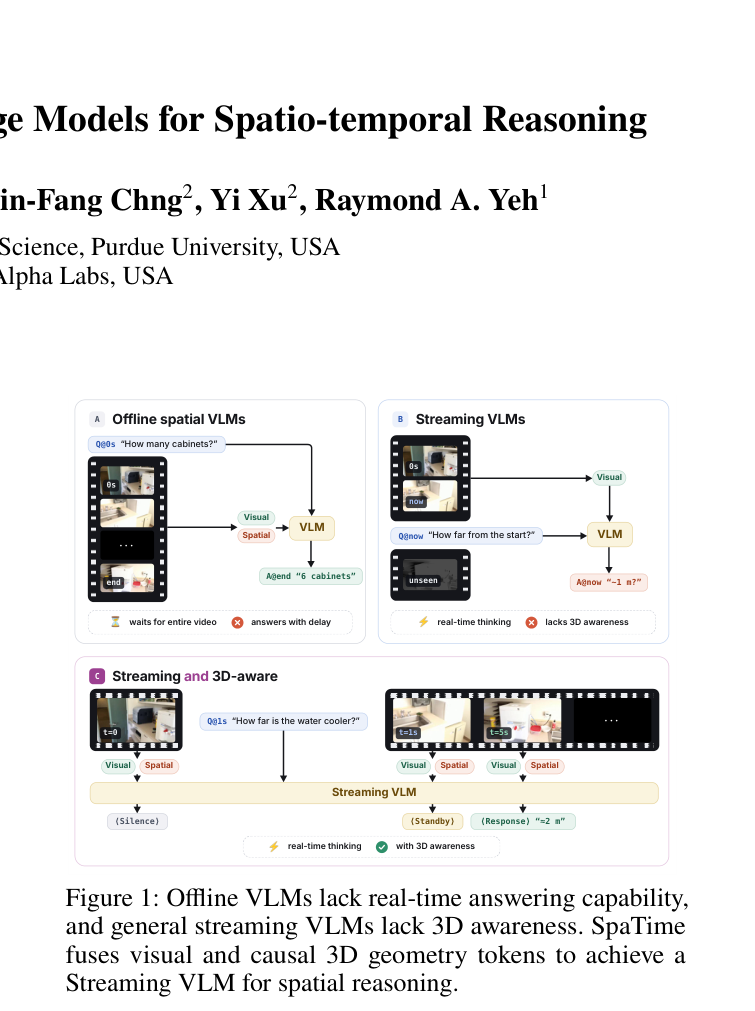
图1是首页问题对照,宜作特色图。裁切顶部残留英文标题与作者行,讲图时可忽略。A Offline spatial VLMs:胶片从 0s 厨房到 end,问 How many cabinets?,Visual 与 Spatial 一并进入 VLM,要到片尾才答 6 cabinets,底栏写 waits for entire video、answers with delay。B Streaming VLMs:胶片标 now 与淡化的 unseen,只走 Visual,问 How far from the start?,立即给出约 1 m?,底栏 real-time thinking 但 lacks 3D awareness。C Streaming and 3D-aware:t=0 厨房同时出 Visual 与 Spatial,问句 How far is the water cooler? 在约 1s 到达,t=1s 与 t=5s 继续双路输入黄色 Streaming VLM 条;t=0 发 ⟨Silence⟩,随后 ⟨Standby⟩,最后 ⟨Response⟩ ≈2 m,底栏同时勾选 real-time thinking 与 with 3D awareness。图内距离与柜数是示意,定量结果见表。
几何融合
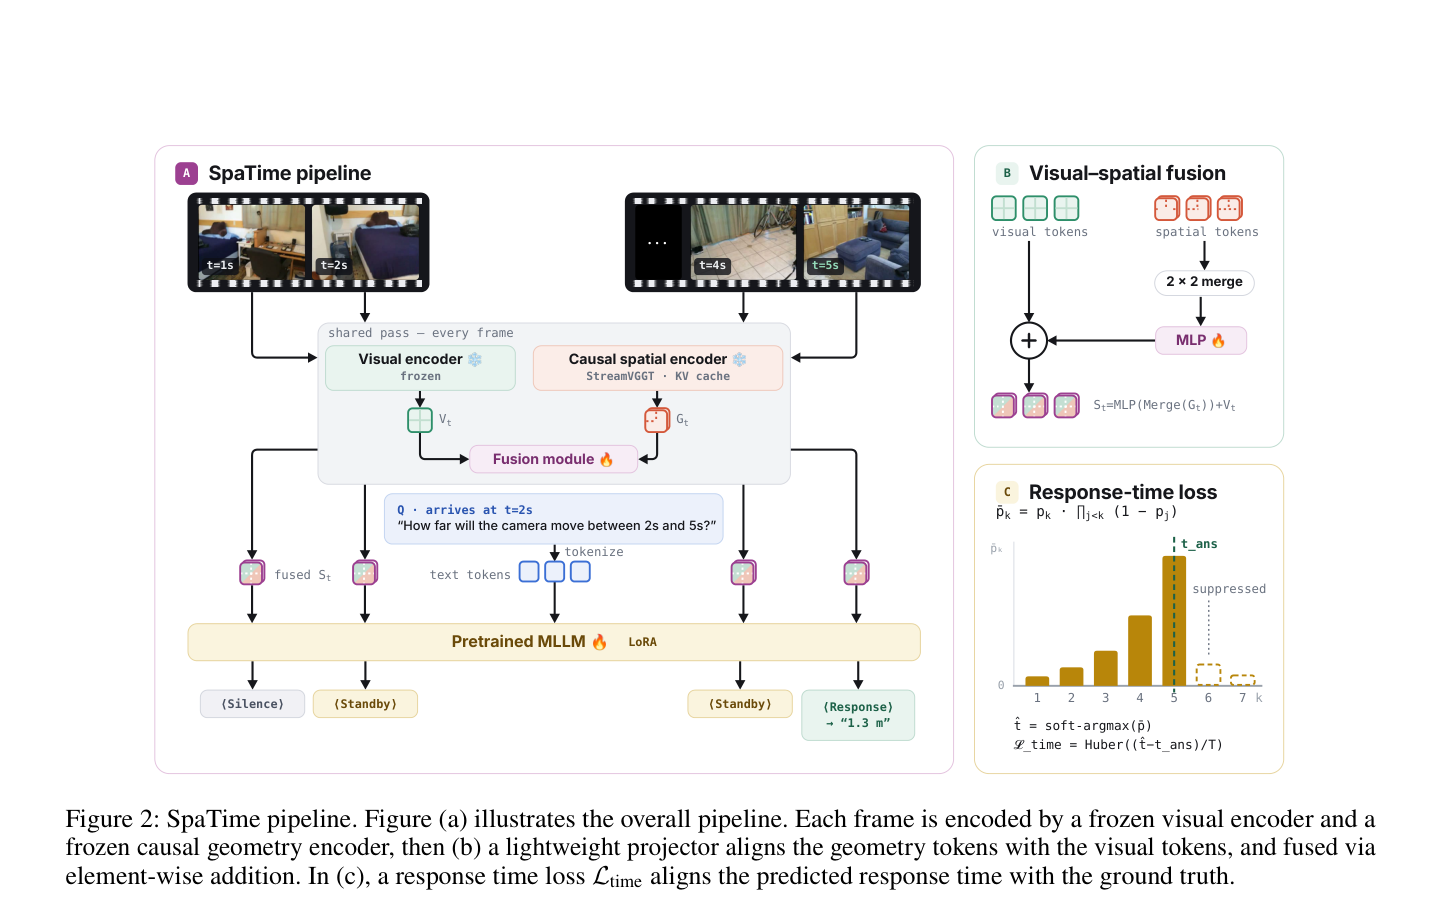
图2是 SpaTime 方法。A 上沿室内帧 t=1s、t=2s 与更晚 t=4s、t=5s 进入 shared pass:冻结 Visual encoder 出绿色 Vt,冻结 Causal spatial encoder(标注 StreamVGGT·KV cache)出橙色 Gt,火焰 Fusion module 合成粉紫 fused St。问句在 t=2s 到达:How far will the camera move between 2s and 5s?。St 与文本 token 进入带 LoRA 的 Pretrained MLLM,四帧依次输出 Silence、Standby、Standby、Response→1.3 m。B Visual–spatial fusion:绿色 visual tokens 与橙色 spatial tokens 经 2×2 merge 和火焰 MLP 后与视觉相加,公式写 St=MLP(Merge(Gt))+Vt。C Response-time loss:p̄k=pk∏j<k(1−pj),柱状图在 k=5 对齐虚线 t_ans,k=6、7 标为 suppressed,下方 t̂=soft-argmax(p̄),L_time=Huber((t̂−t_ans)/T)。图中 1.3 m 为示例答案。
时机监督与基准
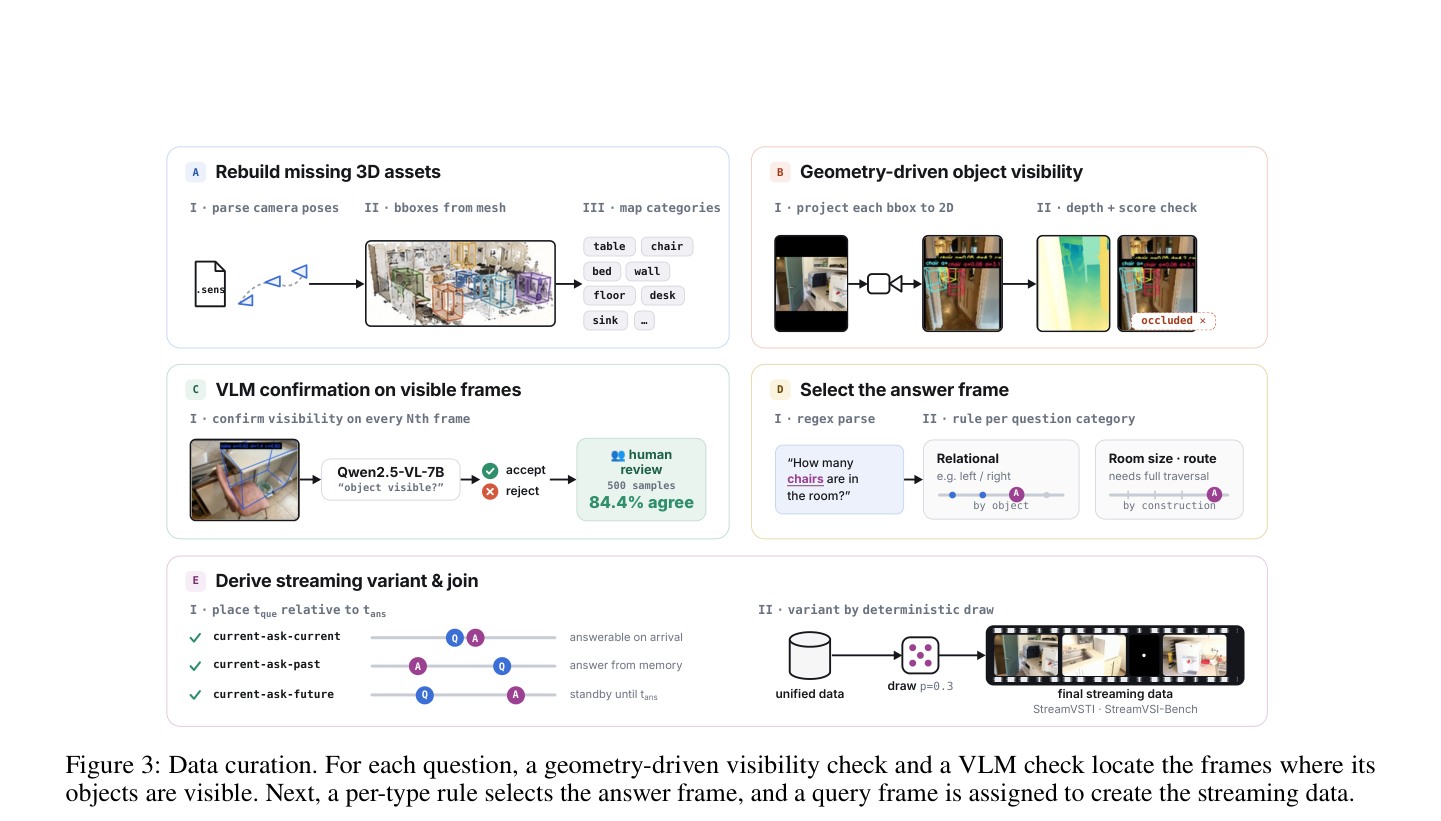
图3是流式数据管线。A 从 .sens 解析相机,在网格上画出彩色三维框并映射到 table/chair/bed 等统一类别。B 把包围盒投到二维后做深度与分数检查,一例柜门被标 occluded。C 把可见帧上的线框送给 Qwen2.5-VL-7B 问 object visible?,accept 或 reject,旁注 human review 500 samples 84.4% agree。D 用正则解析 How many chairs are in the room?,关系题按物体出现取 tans,房间尺寸与路线规划按构造取全程。E 把 tque 相对 tans 摆成三种变体:current-ask-current 问到即可答,current-ask-past 从记忆答,current-ask-future 等到 tans;右侧以 p=0.3 从 unified data 抽到 StreamVSTI / StreamVSI-Bench。
实验如何设计?
- 所有流式模型只在 StreamVSTI-Bench 训练分割上微调。该集 132,568 条、1,201 个 ScanNet 场景,1% 作验证;测试 6,042 条、312 个不相交场景,每条平均 71.6 帧(约 72 秒、1 fps)。时序通道分布为训练 future/current/past = 41,196 / 22,268 / 69,104。StreamVSI-Bench 提供 4,726 条测试、288 段视频,题型在训练中未见。
- 选择题看预测首 token 是否精确匹配;数值题用 VSI-Bench 的 MRA,阈值 θ∈{0.50,…,0.95}。总体是两类准确率的未加权平均。严格模式只评分最早一次 ⟨Response⟩,缺失记零。慈善模式在从未响应时于末帧强制解码,用来把空间能力与时机失败分开。∆t 是预测与真值作答时刻的平均绝对误差,缺失则记到视频末尾。离线模型看完整视频,∆t 记为 N/A。
- 对照包括 InternVL2-8B、LLaVA-Video-7B、LLaVA-OneVision-7B、GPT-4o、Gemini-2.5-Pro 等离线通用模型,VG-LLM-8B 与 VLM-3R-7B 等离线空间模型,以及同数据微调的 VideoLLM-online、Dispider、Streamo。训练在 4×GH200 上、AdamW、bf16,评测在 RTX A6000、1 fps。超参见附录 Table A1:LoRA rank 128、α 256,λtime=3.0,几何输入 518×518。
关键结果与论文证据
- Table 1 慈善模式上,SpaTime 总体 49.20%,高于 VideoLLM-online 的 48.40%、Dispider 的 47.25% 与 Streamo 的 44.05%。∆t 为 0.12 秒,Streamo 为 0.35 秒,相对缩短约 66%。作者在正文写明:相对最强流式基线,严格平均高 4.8 个百分点、慈善高 0.8 个百分点;相对 Streamo 的慈善差距约为 5.1 个百分点。离线 VLM-3R-7B 仍为 58.8%,SpaTime 在因果解码下距其约 9.6 个百分点。
- 严格模式把时机失败直接记零。Table 4 中 SpaTime 在 StreamVSTI / StreamVSI 为 48.80% / 29.44%,与慈善接近;VideoLLM-online 掉到 6.22% / 4.94%,Dispider 为 23.39% / 0.63%,Streamo 为 43.99% / 21.09%。说明基线里不少答案来得太晚或根本没有 Response。
- Table 2 上,训练未见的 StreamVSI 题型,SpaTime 慈善 29.83%,三个流式基线约为 24.14–25.92%。作者称相对流式基线平均高 4.7 个百分点。明显短板是房间尺寸 0.00% 与物体尺寸 3.49%,其他流式模型同样接近零。作者认为这是训练模板未覆盖绝对度量尺度,不是几何先验必然无效,并指出管线可以自动合成尺寸题作为后续方向。
- Table 3 从微调 Streamo 累加模块:几何 token 把严格/慈善/∆t 从 43.99 / 44.05 / 0.35 提到 47.93 / 48.37 / 0.18;再加响应时刻损失到 48.80 / 49.20 / 0.12。Table 5 显示全体 ∆t 只从 0.18 降到 0.12 秒,但 future-only 从 0.52 降到 0.35 秒,与损失只监督等待题的设计一致。附录 Table A3 进一步表明 current/past 选择题几乎总在真值回合开口(精确回合 98.7–100%),时机难度集中在 future 通道。
阅读时需要注意
- 房间尺寸与物体尺寸在 StreamVSI 上接近失败,说明几何融合不能自动补上训练里没见过的答题格式。作者承认应用自动合成尺寸题来补数据,但本文没有做。
- 即便在 StreamVSTI 上,慈善总体仍低于离线 VLM-3R-7B 的 58.8%。流式因果解码与看完整视频之间仍有差距;本文也没有报告端到端时延或与同期 Stream3D-VLM 的直接对比。
- 评测场景限于室内 RGB-D 数据集 ScanNet、ScanNet++ 与 ARKitScenes。可见性阈值、深度遮挡规则和人工 84.4% 一致率都绑定这些源域,不能直接外推到户外驾驶或更长时域。
- Table 1/2 中大量离线数字转引自既有论文(标 †),不是在同一流式协议下复现。慈善模式会在无 Response 时强制解码,阅读总体准确率时必须同时看严格模式与 ∆t。预印本尚未同行评审。
关联工作
- 离线空间路线包括把点云或重建场景写入 LLM,以及只从二维观察推理、不建全局三维。与本文最近的是 VG-LLM 的 VGGT token 加性融合和 VLM-3R 的 CUT3R 特征融合;SpaTime 把前者搬到因果设定。VSTI-Bench 把评测扩到相机与物体运动,但仍要求完整视频。
- 流式路线由 VideoLLM-online 的在线对话范式开始,Flash-VStream 用压缩记忆,Dispider 解耦感知、决策与反应,Streamo 加入三状态与 focal 损失。SpaTime 保留逐帧决策,并把几何写进同一条状态链。
- 在线三维方面,DUSt3R/MASt3R、Spann3R、VGGT、CUT3R 等提供稠密几何,但全局注意力天然离线。StreamVGGT 把 VGGT 蒸馏成因果编码器,是 SpaTime 的直接底座。同期 Stream3D-VLM 同样使用冻结 StreamVGGT,但融合为堆叠交叉注意力,并把时机写成两个决策 token 的加权词级损失。