快速导读:DepthWorld 用重标定的度量深度与空间潜变量拼接,让动作条件视频世界模型同时生成多视图 RGB 与一致的三维几何。
视频世界模型正在替代传统仿真器,去做机器人操作的策略评估、改进和规划。这些用途都要读 rollout 里的几何:杯子还在不在、门是开着还是实心、夹爪有没有伸进空隙。现有模型多在 RGB 上微调预训练视频扩散骨干,单帧看起来对,跨视角深度却对不齐,接触和遮挡也站不住。DepthWorld(arXiv:2610.08780,Czech Technical University in Prague)同时做两件事:把 DROID 重标成带度量深度的 DROID-3D,以及用空间潜变量拼接在不改预训练 VAE 的前提下联合预测多视图 RGB 与深度。项目页为 https://www.jaibardhan.com/depthworld 。选稿注释称 Accepted at CoRL 2026,正文首页未写会议接收,仍按预印本解读。
同样训练预算下,联合深度监督把外置视角 RGB PSNR 相对同结构 RGB-only 基线提高 1.48 dB,并给出可下游使用的度量深度。标定侧,联合因子图在约一千个评测场景上把外置–外置中位重投影从 5.84 px 降到 0.25 px。预印本的闭环规划实验尚未展开。
英文题目:DepthWorld: 3D World Model for Robot Manipulation
论文出处:arXiv 每日论文精选 · arXiv:2610.08780
原始论文:PDF / 论文页面
这篇论文解决什么问题?
世界模型若只优化像素似然,三维歧义不会被解开。作者在引言里指出三类失败:同一场景不同视角的预测深度互相矛盾;遮挡与接触的几何推理弱(图4衣柜门被当成实心墙);物体形状和身份在 rollout 中退化(图1餐具消失)。对要读几何的下游任务,这种内部不一致才是瓶颈。
直接把几何基础模型的配方搬过来有两道坎。第一,DROID 这类遥操作数据有外观和动力学,几何标注却不够监督级:无纹理桌面和反光机械臂让传统立体 SDK 失败;相机组就算内部自洽,也可能和机器人坐标系脱节,切断本体感觉与末端动作。第二,Ctrl-World 所依赖的 SVD 先验很脆,扩 VAE 通道或加并行深度 U-Net 会破坏权重迁移。
核心创新
- 提出把学习式立体深度与联合因子图结合的标定管线,把 DROID 做成带度量深度与机器人接地外参的 DROID-3D。
- 用空间潜变量拼接在不改预训练 VAE 的前提下联合预测多视图 RGB 与深度。
- 用机器人坐标系点图头把跨视角一致性写成显式几何监督。
方法概览
作者先提出面向已知 URDF 的多视图立体遥操作标定管线。Stage 1 用 S2M2 从每对立体相机恢复逐视角度量深度,再用 RoMa v2 稠密匹配做两遍束调整:先对齐两台外置相机,再把腕部相机按正运动学固定、把外置相机组放入机器人坐标系。Stage 2 把 URDF 渲染进外置视图,用 LoMA-G 提取二维–三维对应,并在同一台机器人的全部回合上建联合因子图:逐场景优化外置相机 SE(3) 修正,同时共享手眼修正与七维关节编码器偏置。在 DROID 的 71k 轨迹上得到 DROID-3D,覆盖 28 台机器人、13 个实验室、71,100 个场景。DepthWorld 初始化自 Ctrl-World 的 SVD 检查点,输入三路 192×320 的 RGB 与深度,经未改动的 VAE 编码后按视角纵向、RGB/深度横向铺成 72×80 潜变量网格,U-Net 在 11 帧(6 历史+5 未来、5 Hz)上联合去噪。未来潜变量再经 VGGT 初始化的 DPT 点图头,在机器人基座坐标系预测 X,Y,Z 与置信度,用置信度加权的稳健几何损失监督。训练分两段:先 40,000 步只做联合 RGB–深度去噪,再 50,000 步加入点图损失。
- DROID-3D 标定分两段,如图2。输入是两台桌面 ZED 2、一台腕部 ZED Mini 的立体、URDF 和关节编码器。Stage 1 用学习式全局匹配网络 S2M2 从已知基线恢复度量深度 z=fb/d,再用 RoMa v2 稠密对应做两遍优化:先把外置相机 E1、E2 用 Cauchy 光度残差对齐,再固定腕部正运动学与出厂手眼先验,给外置相机组求一个全局 SE(3),使其解释腕–外对应。此时相机组只是大致落在机器人基座系,仍带着系统手眼误差和关节偏置。
- Stage 2 把机械臂按 URDF 渲染进外置视图,用 LoMA-G 把渲染表面点与真实像素对应起来,得到不依赖跨视角光度的机器人坐标系锚。随后在同一台机器人的全部回合上建一张因子图:每个回合优化两台外置相机的 6-DoF 修正,所有回合共享 6-DoF 手眼修正和 7-DoF 关节偏置。腕部相机由运动学链完全决定,没有逐回合自由度。目标函数把腕–外二维重投影、三维度量提升、URDF 重投影、外置相机一致性和特征度量对齐放进 Cauchy 稳健损失,并用 GPU 加速的 Schur 补把逐场景块消掉,典型墙钟约 12.5 分钟/机器人组。过滤损坏元数据后,管线跑过 28 台 Franka Panda、13 个实验室、71,100 个场景。
- DepthWorld 把这份几何当成训练信号。三路相机、两种模态各编码成 24×40 潜变量,RGB 与深度横向拼接、三视角纵向堆叠,得到每时刻 72×80 的联合网格;U-Net 把它当作一张更宽的视频张量去噪,时间窗 11 帧(6 历史+5 未来)5 Hz。网络侧只扩展空间位置编码,VAE 权重不动。未来潜变量再送进从 VGGT 初始化的轻量 DPT 头,在机器人基座系预测点图与置信度,用 DUSt3R/MapAnything 风格的对数空间稳健损失。训练先 40,000 步只做去噪,再 50,000 步加入点图项 λpm=0.005。动作条件与 Ctrl-World 相同,为逐帧末端位姿。
逐图理解论文
几何缺口
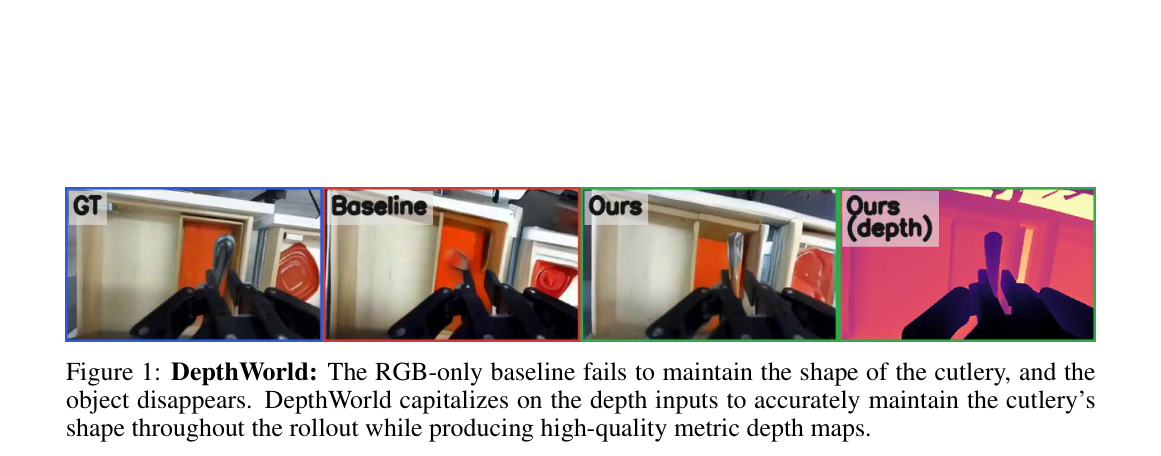
图1是首页定性对照,宜作问题直觉图。四格从左到右:蓝框 GT 是抽屉里的橙色隔板与黑色夹爪,餐具轮廓清楚;红框 Baseline 里餐具糊成一团、几乎消失;绿框 Ours 保住细长餐具形状,并与夹爪空间关系一致;最右 Ours (depth) 是品红–黄伪彩度量深度,夹爪与餐具边缘对齐。图注写明 RGB-only 保不住 cutlery 形状,DepthWorld 靠深度输入在整个 rollout 中维持形状。裁切含图题,讲图时忽略。
DROID-3D 标定
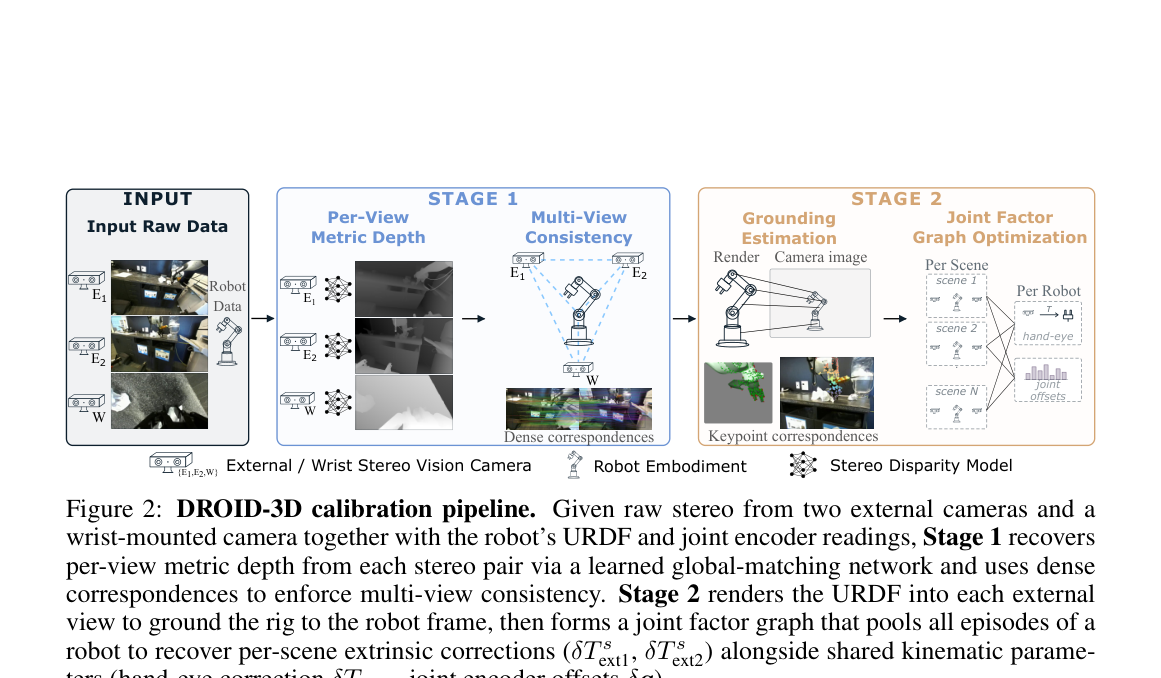
图2是 DROID-3D 标定管线,宜作方法总览。左栏 INPUT 给出外置 E1、E2 与腕部 W 的原始立体及机器人数据。蓝色 STAGE 1 先对三路做 Per-View Metric Depth(灰度深度图),再画 E1–E2–W 三角做 Multi-View Consistency,底部 Dense correspondences。橙色 STAGE 2 左侧 Grounding Estimation 把绿色 URDF 渲染臂叠到真实相机图上,右侧 Joint Factor Graph Optimization 把 scene 1…N 的逐场景外参接到共享的 hand-eye 与 joint offsets。底部图例区分立体相机、机器人本体与立体视差模型。
空间拼接结构
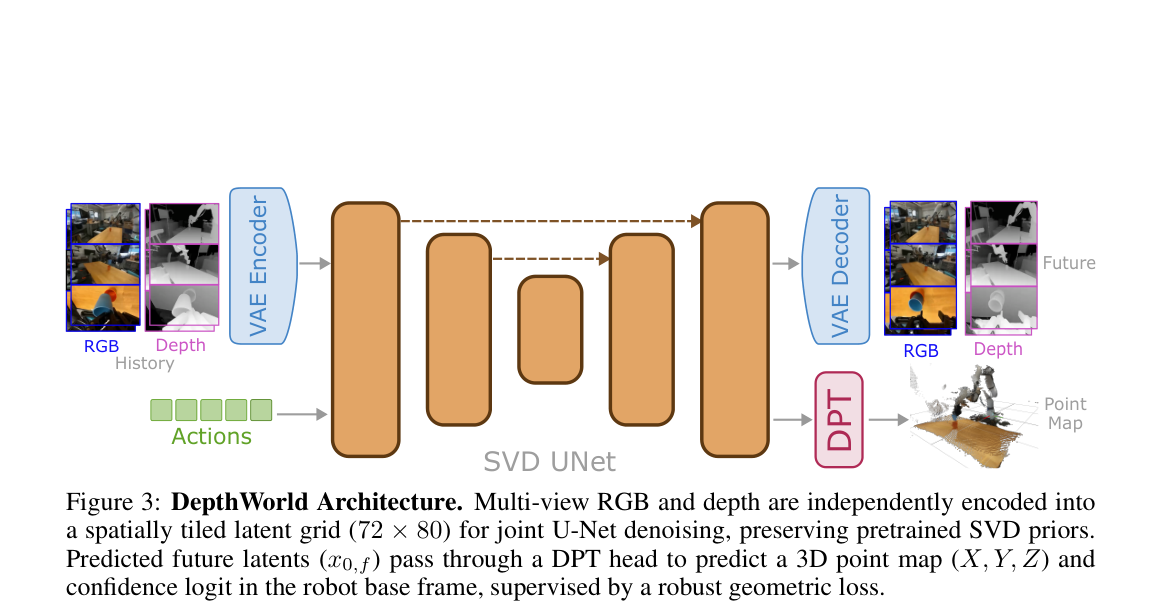
图3是 DepthWorld 结构,宜作特色图。左侧 History 把多视图 RGB(蓝框)与 Depth(紫框)送进未改动的 VAE Encoder,绿色 Actions 方块并行进入。中间橙色 U 形为 SVD UNet,虚线跳跃连接保留。右侧 VAE Decoder 输出未来 RGB 与 Depth;粉红 DPT 头把未来潜变量解成机器人基座系 Point Map,图中可见桌面点云与白色机械臂。图注标明联合潜变量网格为 72×80,点图监督 X,Y,Z 与置信度 logit。
关键证据
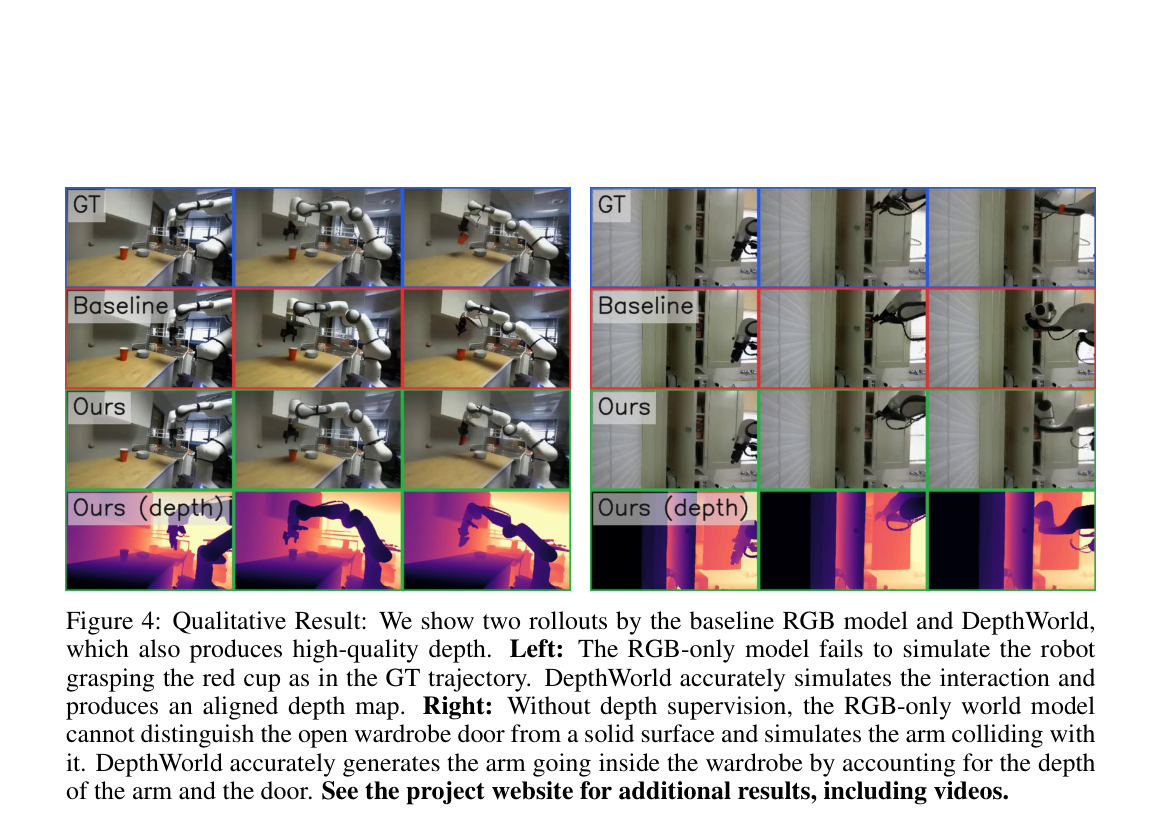
图4是两组定性 rollout。左组抓红杯:GT 蓝框三帧手臂伸向桌面红杯;Baseline 红框手臂抬起却抓空、杯子关系错;Ours 绿框跟住抓取,底部 Ours (depth) 给出桌面与手臂的对齐深度。右组衣柜:GT 手臂伸进打开的柜门;Baseline 把柜门当实心,手臂撞上白色条纹门板;Ours 生成手臂进柜,深度图把门缝与臂部分开。图注指向项目页视频。
实验如何设计?
- 标定评测覆盖 5 个 DROID 实验室约 1,000 个场景。基线模仿 PointWorld:VGGT 初始化外参后逐场景相对机器人深度优化,深度源换成同一套 S2M2。指标包括 MAGSAC 金内点上的外置–外置与腕–外重投影、S2M2 与 URDF 渲染深度的误差、以及 URDF 掩码对 RoboEngine 分割的 IoU。作者还在自己实验室用 ChArUco 记录 5 组相机真值与关节偏置,并在 REALM 仿真 50 个构型上测位姿。
- 世界模型在 256 条留出轨迹上做 10 次连续自回归 rollout。三个变体:RGB 即 Ctrl-World 多视图骨干;RGB+D 为空间拼接联合模型;RGB+D PM-DPT 再加点图头。RGB 报 PSNR/SSIM/LPIPS,深度报 AbsRel/RMSE/δ1,外置与腕部分开。深度对照来自第 3 节标定结果。对照还包括改成动作条件、在同一 DROID 划分上训练的 TesserAct,以及输出点云的 PointWorld。
关键结果与论文证据
- Table 1 上差距很大:全量 995 个场景中,EE 中位从 5.84 px 降到 0.25 px(约 23 倍),WE 从 13.19 到 1.03 px(约 13 倍),RD 从 111.3 mm 到 14.0 mm(约 8 倍),IoU 从 0.440 升到 0.810。即便只看基线收敛的 815 个场景,优势仍在。基线约 18% 场景不收敛,联合优化没有对应的逐场景失败模式。实验室真值上,本文外参中位 4.9 mm/0.39°、手眼 3 mm/0.3°、关节 0.14°,PointWorld 式基线为 72 mm/3.0°。
- Table 2 显示联合深度目标本身就提升 RGB:外置 PSNR 22.63→24.09(+1.48 dB),腕部 16.98→17.96(+1.02 dB),SSIM 与 LPIPS 同步变好。点图头主要 refinement 深度,尤其是腕部 AbsRel 0.2230→0.2182、δ1 0.8182→0.8210,RGB 基本不掉。跨视角把一台生成外置视图按真值几何翘到另一台,RGB+D 比 RGB 高 1.0 dB(17.60 vs 16.60);PM-DPT 再把外置投影深度分歧降 2.6 mm。
- 图1里 RGB-only 把抽屉里的餐具糊掉,DepthWorld 保住形状并给出对齐的度量深度。图4左:基线抓不住红杯子,本文跟住真值交互;右:基线把打开的衣柜门当成墙,手臂撞上去,本文根据手臂与门的深度把臂伸进去。同设置 TesserAct 外置 PSNR 19.43、AbsRel 0.154,本文约 24.07 与 0.074。深度质量仍高度视点依赖:外置 δ1 高于 0.94,腕部约 0.82。
阅读时需要注意
- 作者在 Limitations 写明:自回归 rollout 继承曝光偏差与质量下降;PersistWorld 一类 RL 后训练或可改善稳定性,但本文未做。腕部深度因快速运动、近距离和自遮挡明显更弱。世界模型深度指标对照的是标定管线产物,不是独立传感器真值。
- 文中没有把生成深度接到策略评估、改进或规划的闭环数字。DROID-3D 打开了几何奖励设计的可能,但仍是前瞻。预印本,会议接收以注释为准。
关联工作
- 动作条件视频模型(Ctrl-World、IRASim、TesserAct)把预训练扩散当仿真器,但大多只训 RGB。几何基础模型(DUSt3R、VGGT、MapAnything)能回归度量几何,训练分布却不是真实操作里外置–腕部的极端视差。Marigold 证明图像扩散 VAE 能编码深度,DepthCrafter 把它做到视频;通道扩展与双分支则会破坏 SVD 权重。DepthWorld 用空间拼接走第三条路。
- 机器人大数据里,Open X 多为单目 RGB,Bridge 为单路 RGB-D,DROID 少见地提供同步多视图立体、已知基线与公开 URDF。PointWorld 用 VGGT 初始化再逐场景相对机器人深度精修,是本文标定基线。仿真语料几何完美,但过不了 sim-to-real,这也是要在真实数据上训世界模型的原因。