快速导读:DistScene 在共享场景坐标里联合生成环境与独立物体,再用局部精修恢复细节,并通过物体到场景蒸馏把预训练物体生成器变成可扩展的场景监督。
从一张图恢复可编辑的三维世界,既要有房间或街道这样的环境,也要有可分开拿起来的椅子、车辆。现有方法要么把分割、布局、物体生成串成容易传错的级联,要么只生成一堆物体、不把环境当成组件。DistScene(arXiv:2610.06960,香港科技大学与中国电信 TeleAI)在共享场景坐标里联合生成环境与独立物体,再在局部坐标精修细节,并用物体到场景蒸馏把 TRELLIS.2 的物体先验变成可扩展监督。项目页为 https://coolbeam.github.io/DistScene/ 。
合成引擎给出约 12.5 万场景。MIDI-test 上场景倒角距离从 3D-Fixer 的 0.1295 降到 0.0877(相对改进 32.2%),场景 F-score 从 65.08 升到 71.59;UrbanScene3D 上 CD-L1 为 0.0772、F@0.05 为 0.722。43 人用户研究平均偏好 65.41%。预印本尚未同行评审。
英文题目:DistScene: Object-to-Scene Distillation for 3D Scene Generation
论文出处:arXiv 每日论文精选 · arXiv:2610.06960
原始论文:PDF / 论文页面
这篇论文解决什么问题?
组合式场景生成要同时解决三件事:哪些东西是独立物体、它们相对环境怎么摆、几何是否完整。级联管线用分割或检测切物体,用深度或布局放位置,再用物体生成器补网格。每一步都可能错:掩码裁掉支撑面,布局估错尺度,后面的生成器无法回头。
前馈方法减少了外部模块,但 MIDI 等仍以物体实例为中心,环境常常缺席。没有墙、地面作为几何上下文,物体容易悬空、比例失调或互相穿透。物体生成器本身在规范立方体里很强,却不携带场景坐标。带完整分解网格的真实场景数据又少,3D-FUTURE 一类家具库覆盖有限。DistScene 因此把环境提升为第 N+1 个生成槽,并用程序化拼装补监督。
核心创新
- 把环境写成显式组件,与物体在共享场景坐标里联合生成,保留可分解性与空间关系。
- 物体中心精修在局部体素栅格恢复细节,并用场景上下文保持原摆放。
- 物体到场景蒸馏自动拼装物理合理的合成场景,把物体先验变成场景监督。
方法概览
Object-to-Scene Distillation 用大语言模型写物体与空环境描述,TRELLIS.2 分别生成完整网格,再经接触与碰撞检查放入环境,渲染全物体可见的条件图。据此得到约 12.5 万合成场景(7 万物体、4.6 万空环境;室内 10.6 万、室外 1.8 万),训练分辨率 512。推理分两段:Scene-Frame Generation 为 N 个物体加一个环境初始化噪声潜变量,拼接后由稀疏 DiT 联合去噪,先预测稀疏占据再生成几何潜变量;Object-Centric Refinement 把每个物体平移缩放到规范空间,在标记后的场景潜变量与输入图像条件下精修,再逆变换放回。生成器与精修都用 LoRA 微调流匹配目标。主实验在 1024 分辨率推理。
- 蒸馏引擎分三步。大语言模型写出场景里有哪些物体及大致尺寸,以及空环境描述;同一套 TRELLIS.2 既生成物体网格,也生成带几何细节的环境,而不是空白盒子。随后把物体随机放入环境,用接触、互碰与环境碰撞迭代调整,直到约束 C(S)=1。接受的场景渲染多视图,只保留全部物体可见的图像作为条件,并把放置后的组件重新编码到共享场景坐标。作者称约 125k 场景来自 70k 物体与 46k 空环境,其中室内 106k、室外 18k,全部以 512 分辨率生成。训练最多 30 个组件并随机填充空槽,推理默认 20 槽、空支撑丢弃。
- Scene-Frame Generation 把环境与 N 个物体写成统一稀疏体素。输入图像后初始化 N+1 个噪声潜变量,环境潜变量锚定其余物体的位置与尺度。各潜变量展平后沿 token 维拼接,加上可学习的物体/环境类型嵌入,稀疏 DiT 在整段序列上自注意力,使组件在去噪中交换信息。生成遵循物体生成器的三阶段:稀疏占据、几何潜变量、外观潜变量。公式上 S=G(I)={O1,…,ON,E}。
- 物体在全局栅格里往往只占少量体素,细节会糊。Object-Centric Refinement 取出每个物体,平移缩放到规范空间,在更高有效分辨率上精修。精修器同时看输入图像和场景潜变量,并用标记嵌入指出当前物体对应的区域,从而在恢复局部几何时保持与场景的对应。精修结果再按逆变换放回,环境组件保持不动。粗到精训练对不需要人工标注:高质量潜变量经下采样、VAE 再上采样得到退化输入,流匹配学习还原。
- 网络从 TRELLIS.2 初始化,骨干冻结,LoRA rank 32。场景损失对每个物体潜变量与环境潜变量分别做流匹配;精修损失同样是条件速度匹配。附录图7画出三模块:左侧 flow transformer 联合生成结构潜变量并解码为场景体素支撑,中间稀疏 transformer 在支撑上生成形状 SLAT,右侧把目标物体归一化后在固定场景潜变量条件下精修。雪花为冻结权重,火焰为 LoRA。主文实验在 1024 分辨率跑场景生成与精修,尽管只在 512 上训练。
逐图理解论文
物体到场景蒸馏
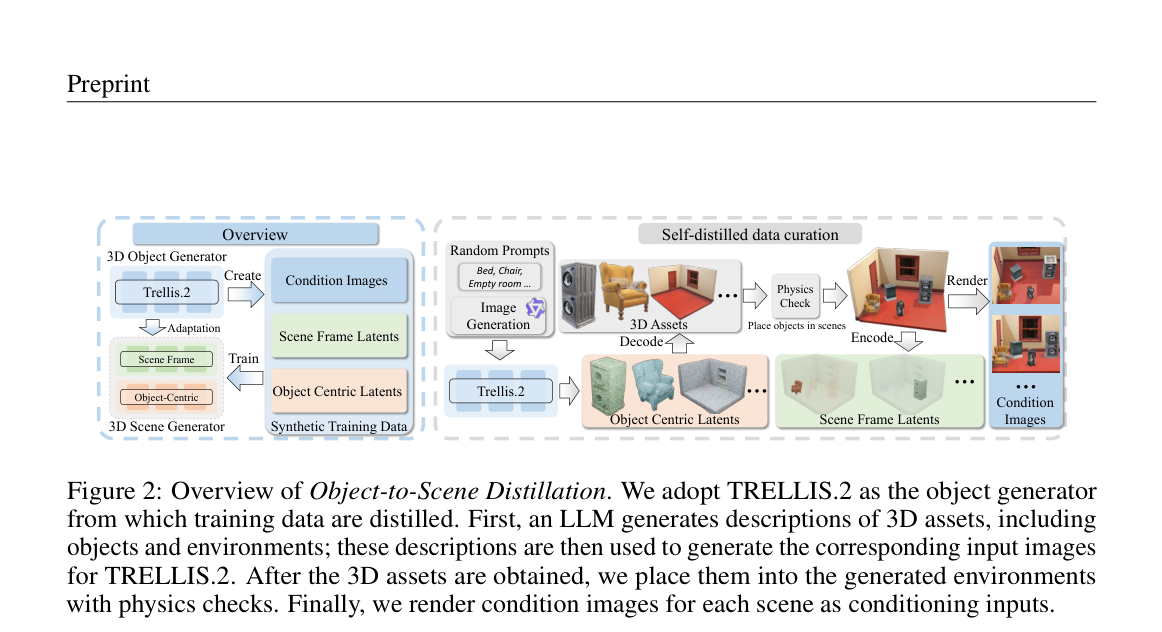
图2是 Object-to-Scene Distillation。左栏 Overview:3D Object Generator 中的 Trellis.2 经 Adaptation 训练 3D Scene Generator 的 Scene Frame 与 Object-Centric 分支,监督来自 Synthetic Training Data 的 Scene Frame Latents 与 Object Centric Latents。右栏 Self-distilled data curation:Random Prompts 写 Bed, Chair, Empty room 等,经 Image Generation 得到条件图,Trellis.2 生成 3D Assets,Physics Check 后 Place objects in scenes,再 Render 出 Condition Images。下排 Decode/Encode 把物体中心潜变量与场景坐标潜变量对齐。顶部有 Preprint 页眉。
联合生成与精修
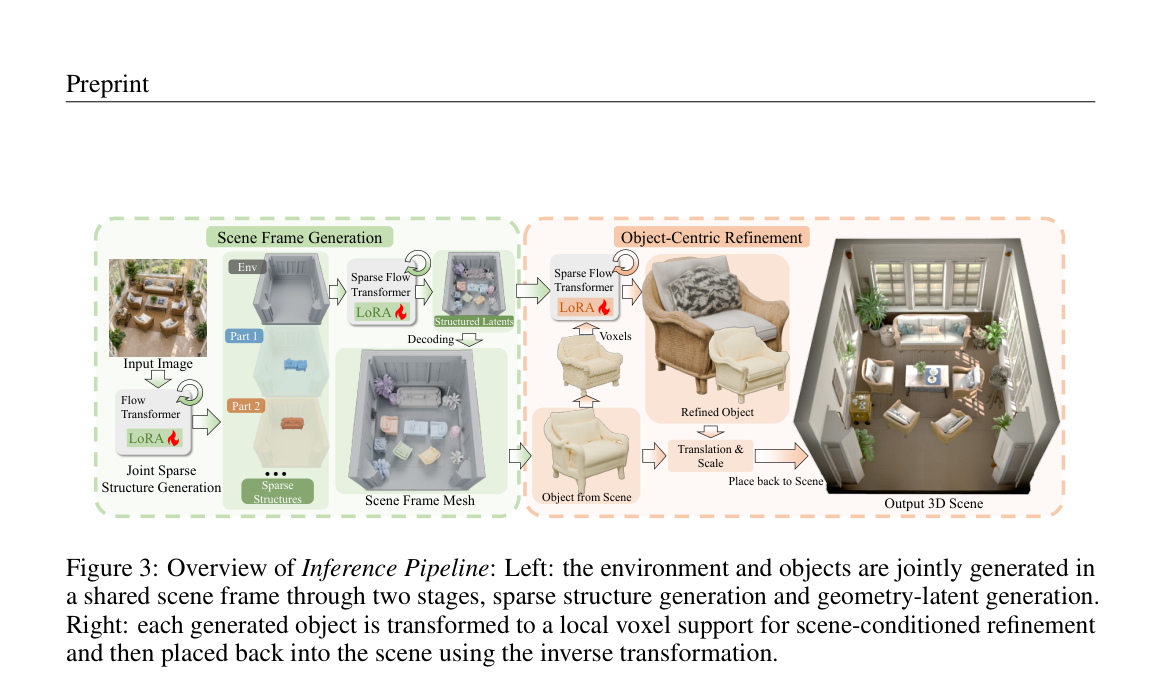
图3是推理管线。左绿框 Scene Frame Generation:俯视客厅输入经带 LoRA 火焰的 Flow Transformer 做 Joint Sparse Structure Generation,得到 Env 开口房间、Part 1 蓝沙发、Part 2 棕沙发等 Structures,再经 Sparse Flow Transformer 解码 Structured Latents,输出 Scene Frame Mesh。右橙框 Object-Centric Refinement:从场景取出藤编扶手椅,经 Sparse Flow Transformer LoRA 得到更清晰的 Refined Object,再 Translation & Scale Place back to Scene,右侧 Output 3D Scene 为带沙发、茶几、绿植与落地窗的完整房间。火焰图标表示可训练 LoRA。
Figure 1: Diverse 3D scenes generated by DistScene from images
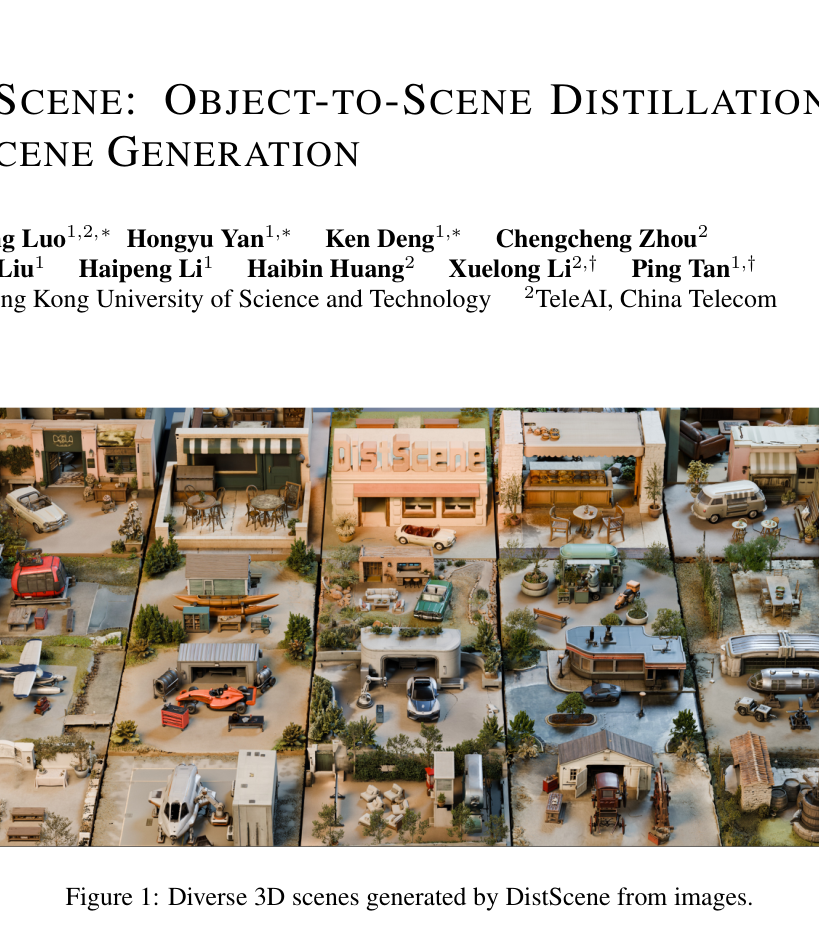
图1是首页效果拼贴,宜作特色图。裁切含标题 DISTSCENE: OBJECT-TO-SCENE DISTILLATION 与作者单位(HKUST、TeleAI),讲图时忽略。画面是多块倾斜缩略的三维场景:左上露天咖啡座与白色敞篷车,绿雨棚餐桌,中上店面墙书写 DistScene 字样并停白色轿车,蔬果摊与粉色客厅;下层有船与橙色跑车的车间、白色跑车车库、未来感餐厅、挂装甲罐的机库、屋顶白面包车与木马车酒桶。图注写 Diverse 3D scenes generated by DistScene from images,展示室内外与多种物体组合,不是定量排行。
实验如何设计?
- 室内跟随 3D-Fixer 的协议,在 MIDI-test 与 Gen3DSR-test 上报告场景级倒角距离与 F-score(阈值 0.1,百分数)。MIDI-test 另报物体级 CD/F-score 以及场景坐标系包围盒 IoU。由于 MIDI-test 原图缺少 DistScene 需要的完整背景,作者用提供的三维几何重渲染地面、墙与物体,并为需要辅助输入的方法渲染对齐掩码与深度;真值几何与评测协议不变。室外跟随 Extend3D,在 UrbanScene3D 上报告 CD-L1 与 F@0.05。
- 对照包括重建式 Gen3DSR、SAM3D,前馈 MIDI、SceneGen、3D-Fixer,以及物体生成器 TRELLIS.2、Hunyuan3D 2.1、EvoScene、Extend3D。用户研究:43 名被试、20 张随机文生图输入,匿名随机顺序,分别选出图像一致性、几何质量、外观质量最好的结果,再报获胜比例。消融默认 1024:去掉环境、用 MIDI 数据训练无环境变体、精修时去掉场景上下文,以及 512/1024 的耗时与显存。LoRA 用 AdamW、学习率 1×10⁻⁴、全局 batch 64、各模块 20,000 次迭代。
关键结果与论文证据
- Table 1 室外:DistScene CD-L1 0.0772、F@0.05 0.722,优于 Extend3D 的 0.0832 / 0.680 与 TRELLIS.2 的 0.0831 / 0.701。Table 2 室内:MIDI-test 场景 CD 0.0877、F-score 71.59,相对 3D-Fixer 的 0.1295 / 65.08,倒角距离相对改进 32.2%,F-score 升 6.51 个百分点;物体 CD 0.1529、F-score 51.64、IoU 0.3688 均为表内最高。Gen3DSR-test 场景 CD 0.0958、F-score 79.68%,对照 3D-Fixer 为 0.1027 / 77.97%。图4中 3D-Fixer 与 MIDI 常缺块或布局错位,SAM3D 缺环境,本文保留墙面、支撑与家具关系。
- Table 3 用户研究平均 65.41%,三项分别为 61.95%、67.80%、66.46%,次高 Extend3D 平均 22.52%。图5显示文生图输入在视角和物体组合更杂时,仍能生成对应环境与物体。Table 4:加上环境后 MIDI 物体 F-score 从 29.98 升到 40.98,IoU 从 0.1798 升到 0.2544;Gen3DSR 场景 CD 从 0.1367 降到 0.1096。用自蒸馏数据训练的无环境模型,在作为域外的 Gen3DSR 上场景 CD 0.1367、F-score 62.04,优于用 MIDI 训练的 0.1936 / 46.68。完整精修再把 MIDI 物体 F-score 推到 51.64、IoU 0.3688;去掉场景上下文则全面回落。
- Table 5:512 加精修已能把 MIDI 场景 F-score 做到 68.35,耗时场景 5.7 秒、每物体 3.3 秒、峰值 18.0 GB;1024 完整模型最好,但场景 36.4 秒、精修 38.5 秒/物体、21.8 GB。图6定性显示:无环境时椅子几何变差、台灯消失;有环境但无精修时布局对、局部糊;完整模型两者兼顾。
阅读时需要注意
- 附录 A.5:室内空环境很难从物体生成器得到带天花板的封闭房间,训练资产普遍无顶,推理可能把封闭室内建成敞口。室外大范围场景把有限体素摊薄,细结构与薄件会丢,还可能出现空洞;室外 18k 场景也远少于室内 106k。
- 训练最多 30 组件、推理默认 20 槽,极拥挤场景会受槽位限制。MIDI-test 使用重渲染输入,和只吃原始 RGB 的论文对比时要标明设定。蒸馏数据继承 TRELLIS.2 的类别与几何偏差,物理检查也不能覆盖全部真实支撑关系。
- 预印本未同行评审。失败例见图10。项目页为 https://coolbeam.github.io/DistScene/ 。
关联工作
- 组合式场景生成长期走重建拼装:SAM 系分割、位姿估计、单目几何,再把物体网格摆进场景。CAST 与 SAM3D 是这一路的代表。前馈扩散则把多实例放进一次去噪,MIDI 与 SceneGen 减少外部模块,但环境仍常缺席。
- 物体生成已从 vecset、结构化潜变量发展到可分件的 PartCrafter。DistScene 不把物体生成器当推理时的级联模块,而是当教师:生成规范空间资产,再程序化放到带几何的环境里,得到组件对齐的场景监督。TRELLIS.2 直接吃多物体图时,会把所有东西融成一个物体中心表示,相对位置与小物体细节都差。
- Extend3D 用输入外观与深度一致性优化室外重建,可见区像,但遮挡区弱,也没有可独立编辑的组件。3D-Fixer 做就地补全,室内定量强,却仍可能缺环境和完整物体关系。DistScene 的可分解输出同时服务重建指标与后续编辑。