快速导读:PlaySuite 从 itch.io 与 PyWeek 筛出 5,734 款异构游戏,用统一键盘鼠标闭环和视频裁判测量开源视觉模型能否把感知变成持续进展。
静态多模态基准可以衡量看图与答题,却很难回答另一个问题:模型能不能在动态环境里根据反馈持续行动。PlaySuite(arXiv:2610.07127,University of Amsterdam、TU Eindhoven 与 Universität Tübingen)把评测搬到 5,734 款开源视频游戏上,覆盖 itch.io 5,630 款与 PyWeek 104 款,引擎包括 Pygame、HTML5、Godot 与 Unity。候选来自约 1.7M 目录,经自动过滤与沙箱后约 17.5K 可启动,本轮只用其中 5,734 款。
作者搭建统一键鼠闭环与 Video-LLM-as-a-judge,把可见里程碑映射为 None 到 Completed 五级进度,并评了 14 个开源 VLM、CUA 与 VLA。无历史设定下,最强的 Qwen3-Omni 在 itch.io 平均进度仅 0.84,Partial+ 为 19.5%。预印本尚未同行评审;首页有 GitHub 与 Hugging Face 图标和邮箱 d.varghese@uva.nl,正文未写出可核验的完整仓库地址。
英文题目:PlaySuite: A Large-Scale Benchmark for Interactive Visual Intelligence
论文出处:arXiv 每日论文精选 · arXiv:2610.07127
原始论文:PDF / 论文页面
这篇论文解决什么问题?
引言把核心问题写成:当前多模态模型把感知和推理转化成目标导向交互的能力有多强。界面 Agent 与具身模型已经能点按钮、分解步骤,但评测仍常停在静态图文;游戏需要空间、时间与错误恢复,却长期集中在少量热门标题,成功也可能来自记忆攻略。
Table 1 对比显示,既有游戏基准多为 5–23 款,且很少同时覆盖 VLM、VLA、CUA 与 HPC 动态评测。PlaySuite 用 5,734 款、自动化裁判和集群闭环补这个规模缺口,而不是再做一个需要手工奖励的小型模拟器。
核心创新
- 把可评游戏规模做到五千以上,比既有多游戏基准高出两个数量级。
- 用 HPC 上的沙箱 worker 加共享 vLLM,对异构引擎做统一键鼠闭环。
- 用可见里程碑的 Video-LLM 裁判,在没有共用奖励时给出可比进度。
方法概览
质量门限为社区评分高于 3.0/5.0 且至少 5 个评分,只保留 Linux 或 Web、键鼠控制、非 NSFW,并做病毒与结构风险分诊。itch.io 评 5,630 款,PyWeek 经 Python 2 剔除与 Pygame 干跑后剩 104 款。九类类型为 Action、Adventure、Puzzle、Shooter、Simulation、Survival、Strategy、Fighting、Racing。Agent 每步看到统一提示、当前帧和可选历史,输出 Observation / Reasoning / Action;动作含按键、组合、按住、绝对/相对鼠标、点击与滚轮,不支持拖拽。游戏在模型推理时暂停。多个沙箱 worker 共享一个 vLLM 策略进程。裁判默认 Qwen3.5-9B,视频 1 fps,把加分、进新区、检查点、通关等事件映射为 None 到 Completed。人工对照 60 条视频:裁判与人相差不超过一级占 90.4%,人与人 93.0%。
- 数据策展先保留评分高于 3.0/5.0、至少 5 个评分、Linux 或 Web、键鼠可玩、非 NSFW 的游戏,再做内容与结构风险分诊:高风险包隔离,其余在断网沙箱运行。PyWeek 去掉 Python 2 与非 Pygame、再干跑剔除坏资源,剩 104 款。九类类型来自社区标签与文献交叉;itch.io 用元数据,PyWeek 用大模型读 README 与源码说明。
- 交互形式化为 π(O_t | p, o_t, h_t)。提示提供标题、类型、开发者说明(若有)和当前帧,不给通关策略;有文档就要求遵循控件,没有就靠探索与后备键鼠启发式。结构化输出含 Observation、Reasoning、Action。动作语法包括按键、组合、按住、鼠标移动、点击与滚轮;拖拽不支持,因此拖拽-only 游戏被排除。推理期间游戏暂停,避免把显存延迟算进反应。
- 执行上,一节点跑多个带独立虚拟显示器的 worker,帧与提示经 Unix socket 送给共享 vLLM,解析后再注入键鼠。Qwen3-VL-8B 在一块 H100 上,8 worker 把吞吐从每 GPU 小时 6.7 次提到 42.4 次。评测用 Qwen3.5-9B 看 1 fps 视频,抽取加分、进新区或关卡、完成中间目标、通关等证据,再按固定规则映射到 0–4。Partial 需要新区/新关或加分;Substantial 需要中间目标或两类进展同时出现;Completed 需要明确通关画面;Minimal 需要至少两次可辨控制。
逐图理解论文
基准设计
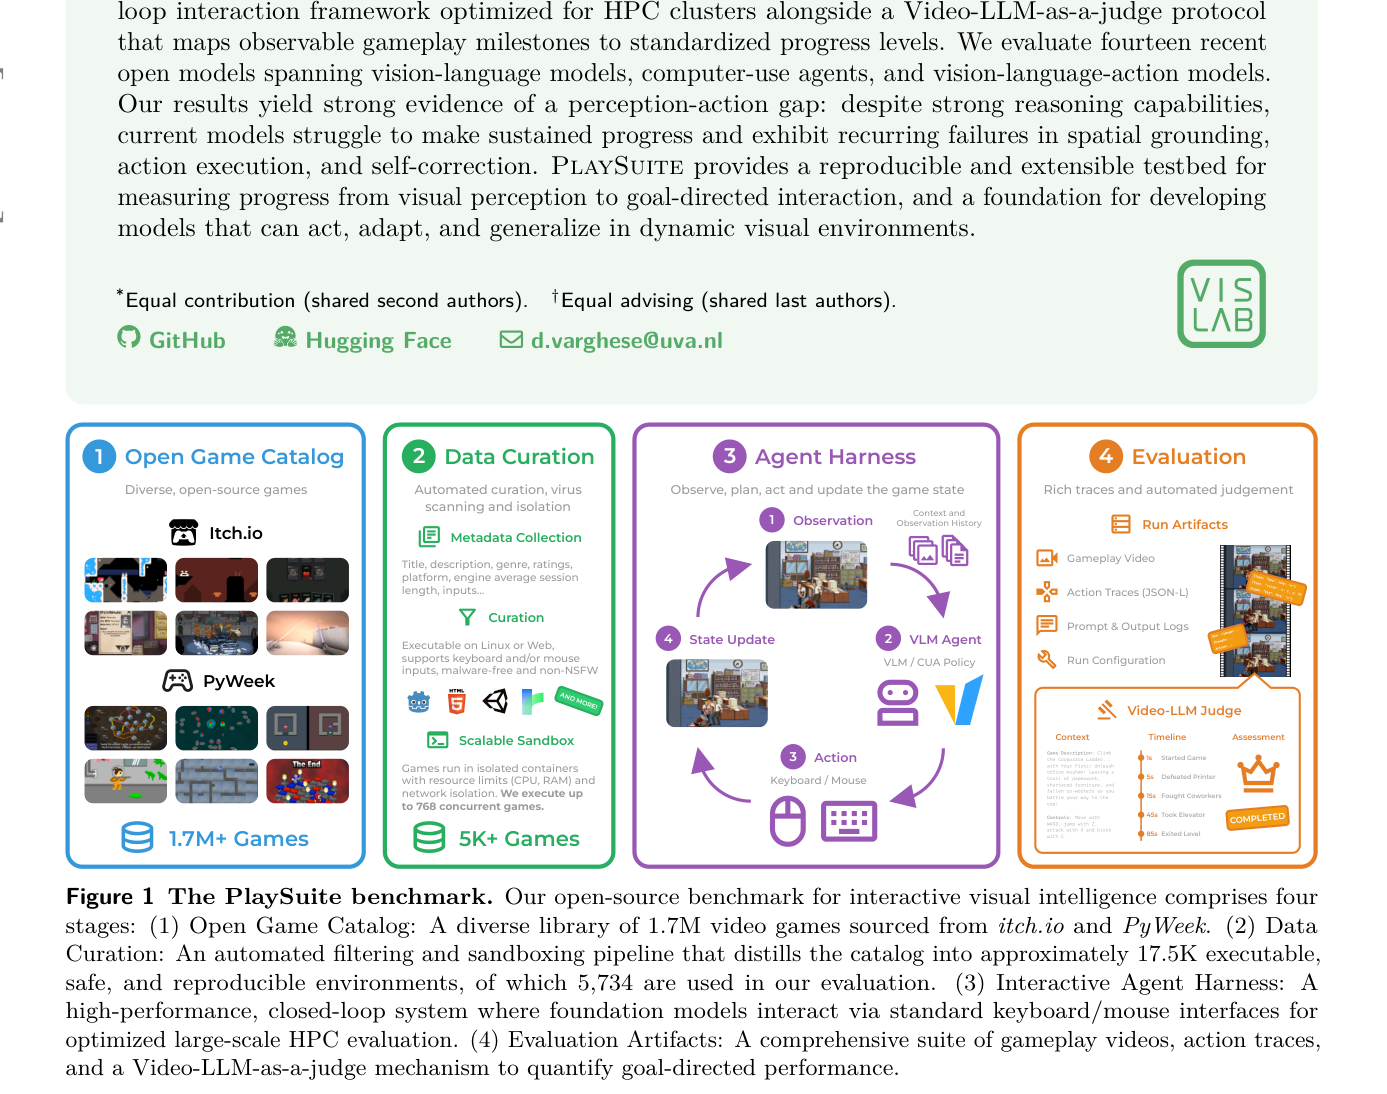
图1是首页四阶段总览,宜作特色图。裁切上沿残留摘要与 VIS LAB 标志、GitHub / Hugging Face / 邮箱。(1) Open Game Catalog:itch.io 与 PyWeek 截图拼贴,底部 1.7M+ Games。(2) Data Curation:Metadata Collection、Curation(Linux 或 Web、键鼠、无恶意软件、非 NSFW)、Scalable Sandbox,底部 5K+ Games。(3) Agent Harness:Observation → VLM / CUA Policy → Keyboard/Mouse Action → State Update 的闭环,旁有观察历史。(4) Evaluation:Gameplay Video、Action Traces、Prompt & Output Logs,以及 Video-LLM Judge 卡片,右下金色王冠标 COMPLETED。这是管线示意,进度皇冠不代表模型已普遍通关。
关键证据
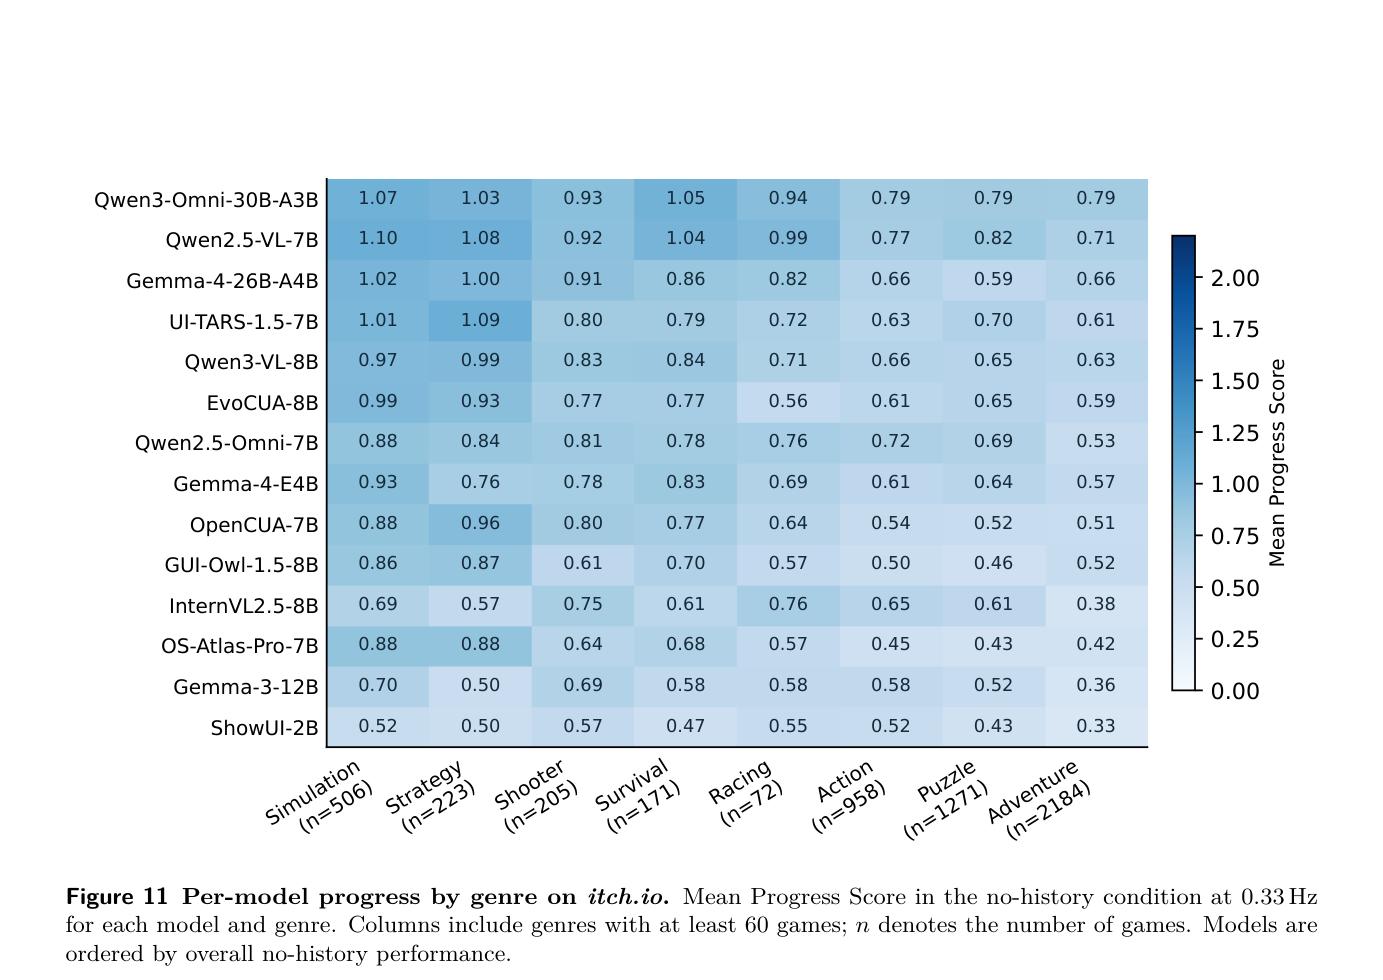
图11是附录中 itch.io 无历史、0.33 Hz 的模型×类型热力图,按总体表现排序。列是 Simulation (n=506)、Strategy (223)、Shooter (205)、Survival (171)、Racing (72)、Action (958)、Puzzle (1,271)、Adventure (2,184)。Qwen3-Omni 在 Simulation 为 1.07、Adventure 为 0.79;最底行 ShowUI-2B 多在 0.33–0.57。色标为 Mean Progress Score 0–2,整图偏浅,说明即使最强开源模型也远未接近 Completed=4。主文总排行仍以 Table 2 为准。
失败机制
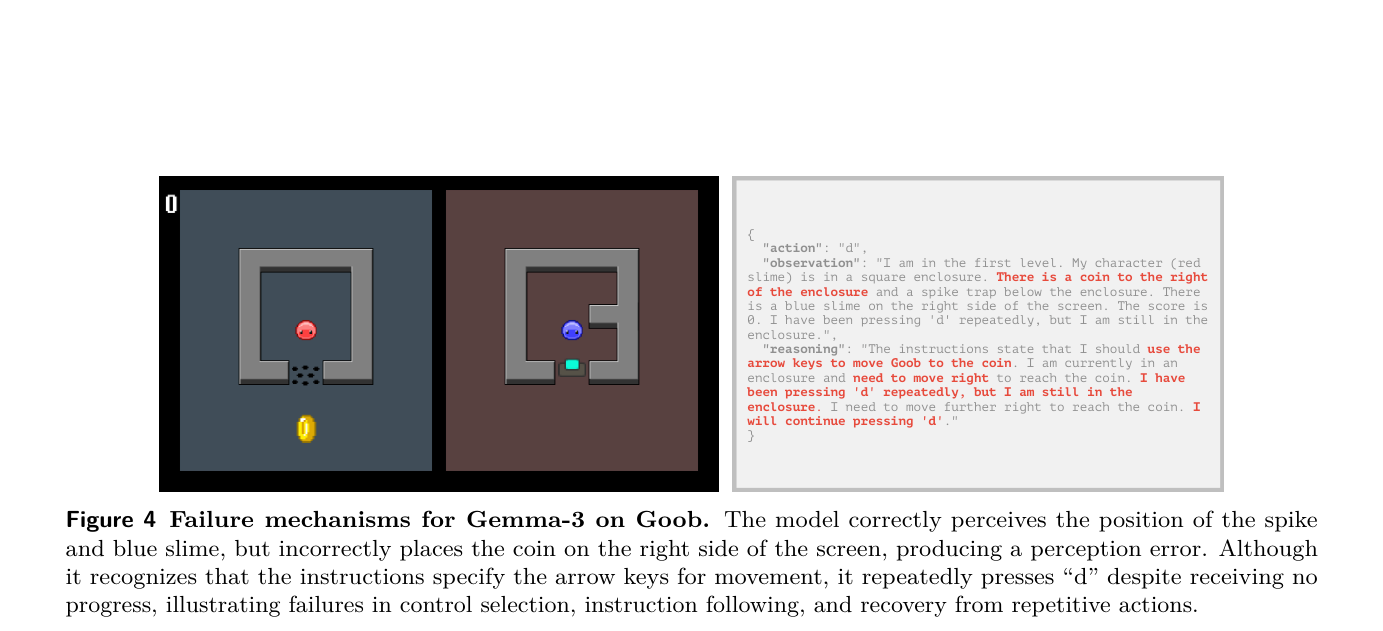
图4用 Goob 上的 Gemma-3 展示失败机制。左两帧:红史莱姆在方形围栏里,黄金币在围栏外下方,底部有刺,分数为 0;另一帧出现蓝史莱姆与青色方块。右侧 JSON 被标红:模型把金币说成在屏幕右侧,承认说明书要求方向键,却反复输出 action d,并写 I will continue pressing d。作者指出感知、控件选择、指令遵循和重复动作恢复可以在同一条轨迹里同时坏掉。
实验如何设计?
- 14 个开源模型包括 Gemma-4、Qwen3-Omni、Qwen3-VL、Qwen2.5-VL、InternVL2.5、Gemma-3 等 VLM,UI-TARS、EvoCUA、OpenCUA、GUI-Owl 等 CUA,以及 OS-Atlas-Pro 与 ShowUI 等 VLA。温度 0.5、最大 512 token。主文报 k=0 与 k=3,动作频率 0.33 Hz;历史长度另在 PyWeek 与 200 款 itch 子集上扫到 k=10。
- 裁判在 60 条视频(45 itch.io + 15 PyWeek,覆盖 14 个预设与两种历史)上对照六名标注者:人内 Krippendorff α=0.624,加入裁判为 0.605;与人相差不超过一级 90.4%,人人 93.0%。Qwen3.5-27B 达 91.6%,仍选 9B 做默认大规模裁判。不评 Cradle、SIMA 2 等闭源系统。
关键结果与论文证据
- Table 2 显示有意义进展只出现在少数游戏。无历史时 Qwen3-Omni 最高:itch.io 0.84 / Partial+ 19.5%,PyWeek 1.26 / 37.0%。加上 k=3 历史后,Gemma-4-26B 升到 itch.io 1.02、PyWeek 1.37,但许多模型平均值反而下降。作者的结论是:家族标签不能干净分开强弱,CUA 能接近同规模 VLM,而所评 VLA 整体落后。
- Table 3 与 Figure 11 一致:Simulation、Strategy 相对高,Adventure、Puzzle 最低。类型内模型排序与总分的 Spearman ρ 在 0.88–0.99。Figure 4 用 Goob 上的 Gemma-3 说明同一轨迹里可并存感知错误(金币位置)、控件选错(说明写方向键却连按 d)和无法从重复动作恢复。抽样实验表明几百款就能稳住粗排序,要分出前三名仍需大样本:200 款只在 26.0% 的抽样中找回完整前三。
- 平均而言无历史最好,把历史加到 10 步还会再降。PyWeek 把动作频率从 0.33 Hz 提到 3 Hz,平均进度从 0.862 到 0.926,帮助有限。成本上 Qwen3-Omni 每 1,000 款约 105.5 个 H100 GPU 小时,高于 Qwen2.5-VL 的 59.9。这些数字描述的是零样本开源模型,不是通关率。
阅读时需要注意
- 局限段写明:只测开箱零样本,不是微调或 RL 后的上限;闭环去掉了推理延迟,故不测实时手速;里程碑不直接衡量策略效率或机制掌握;公开游戏无法排除污染,新游戏只能降低风险。
- 动作语法不含拖拽;多人和手柄游戏被排除。裁判与人相差一级仍有约一成,进度是可见事件的代理指标。平均 Progress Score 更不能读成“会玩游戏的比例”。
关联工作
- GUI 与网页 Agent 基准评的是工具使用;具身基准评的是原子物理交互。游戏被当作高频视觉动态的试验场,但早期套件偏 2D 网格,近期 3D 套件又常停在个位数标题并依赖手工奖励。
- PlaySuite 把模块化 harness 与 LLM/VLM-as-a-judge 接到五千以上环境,并明确对开源 VLM、CUA、VLA 用同一键鼠接口。它重提 Universe 的广环境理想,但对象已变成可零样本部署的预训练多模态 Agent。