快速导读:MedCORE 把诊断拆成临床判据,在冻结的 BioMedCLIP 上做空间定位、多尺度编码、图注意力与不确定性加权,而不是像素直接映射标签。
临床读片通常是结构化推理:先找有名字的形态与纹理证据,再综合判断。许多深度学习模型却把像素直接映射到疾病标签,既难说明依据,也难检查某条证据是否不可靠。MedCORE(Medical Criteria-Oriented Reasoning and Evidence,arXiv:2610.08528,Khalifa University 的 Asim Khan、Samee Ullah Khan、Dwarikanath Mahapatra)把诊断拆成数据集相关的临床判据,在冻结的 BioMedCLIP ViT-B/16 上做空间定位、多尺度编码、图注意力关系推理,再按不确定度加权汇总。
作者在 ISIC 2018 皮肤镜七分类、BUSI 乳腺超声三分类、IDRiD 糖尿病视网膜病变五级分级上评测。Table 3 报告平均 Macro-F1 87.0%,三项分别为 85.7%、95.2%、80.2%,均高于 CNN、Transformer、BioMedCLIP 微调、概念瓶颈与 ProtoPNet。必须同时记住边界:这是公开基准上的研究预印本,不是临床产品,不得外推为临床可用。
英文题目:MedCORE: Criteria-Grounded Clinical Reasoning for Interpretable Medical Image Diagnosis
论文出处:arXiv 每日论文精选 · arXiv:2610.08528
原始论文:PDF / 论文页面
这篇论文解决什么问题?
引言指出,高风险场景需要模型说明预测了什么、依据哪些判据、证据出现在何处、以及每条证据有多可靠。皮肤科会看不对称、边界不规则、颜色变化、皮肤镜结构与血管;超声与眼底同样依赖空间局部、相互关联的体征。直接分类能出分,但对不上这种证据链。
图文预训练给出了语言对齐的医学表示,概念模型又插入了中间变量,但仍有三处缺口:判据缺少显式空间锚定;判据常被当成独立分数;汇总时常忽略判据级不确定度。MedCORE 的设计就是把这三件事写进同一条推理路径,而不是再训练一个端到端黑盒分类器。
核心创新
- 把诊断写成有空间定位的临床判据推理,而不是全局特征直接分类。
- 用多尺度编码与图注意力同时捕捉宏观/微观证据和判据依赖。
- 用不确定性加权汇总,并配合语言对齐与类别原型约束判据特征。
方法概览
输入图像经冻结 BioMedCLIP ViT-B/16 得到稠密 token;每条判据用可学习查询对 token 做注意力,得到区域描述,无需像素级标注。随后分别编码宏观结构与峰值邻域微纹理并融合。全连接判据图上用四头 GAT 让相关体征互相强化。冻结文本编码器给出临床描述,用对称 InfoNCE 对齐视觉判据向量。每条判据维护类别原型,以余弦相似度做原型分类损失。不确定性头输出标量,按 exp(-u) 归一化权重汇总分类。总损失为交叉熵加语言对齐与原型项,λ 均为 0.1。默认每个数据集 K=5。ISIC 用对称性、边界不规则、颜色变化、皮肤镜结构与血管模式;BUSI 用形状、边缘、内部回声、后方声影与方位;IDRiD 用微动脉瘤密度、出血、硬性/软性渗出与新生血管。
- 每个数据集使用 K=5 条作者定义的判据。ISIC 对应 ABCD 风格线索,BUSI 对应 BI-RADS 风格的形状、边缘、内部回声、后方特征与方位,IDRiD 对应微动脉瘤、出血、硬性/软性渗出与新生血管。图像缩到 224×224 后进入冻结视觉骨干,只优化判据查询、多尺度编码器、图模块、原型、不确定性头与分类器。
- 判据查询对稠密 token 做 softmax 注意力,得到区域描述,无需像素级监督。宏观分支对区域做全局池化,微观分支在注意力峰值邻域用深度卷积编码局部纹理,再线性融合。全连接判据图上的四头 GAT 让相关体征互相强化,例如不对称与不规则边界、微动脉瘤与硬性渗出。
- 每条判据配一句临床文本,由冻结 BioMedCLIP 文本编码器得到锚点,用对称 InfoNCE 把视觉向量拉向对应描述。类别原型按指数滑动平均更新,原型交叉熵强化类内紧、类间分。不确定性头输出标量 û_k,权重为 softmax(−û),高不确定度的判据在最终 logits 里被压低。总损失为 L_CE + 0.1 L_VL + 0.1 L_proto;不确定度没有单独标注,靠分类梯度隐式学习。
逐图理解论文
方法结构
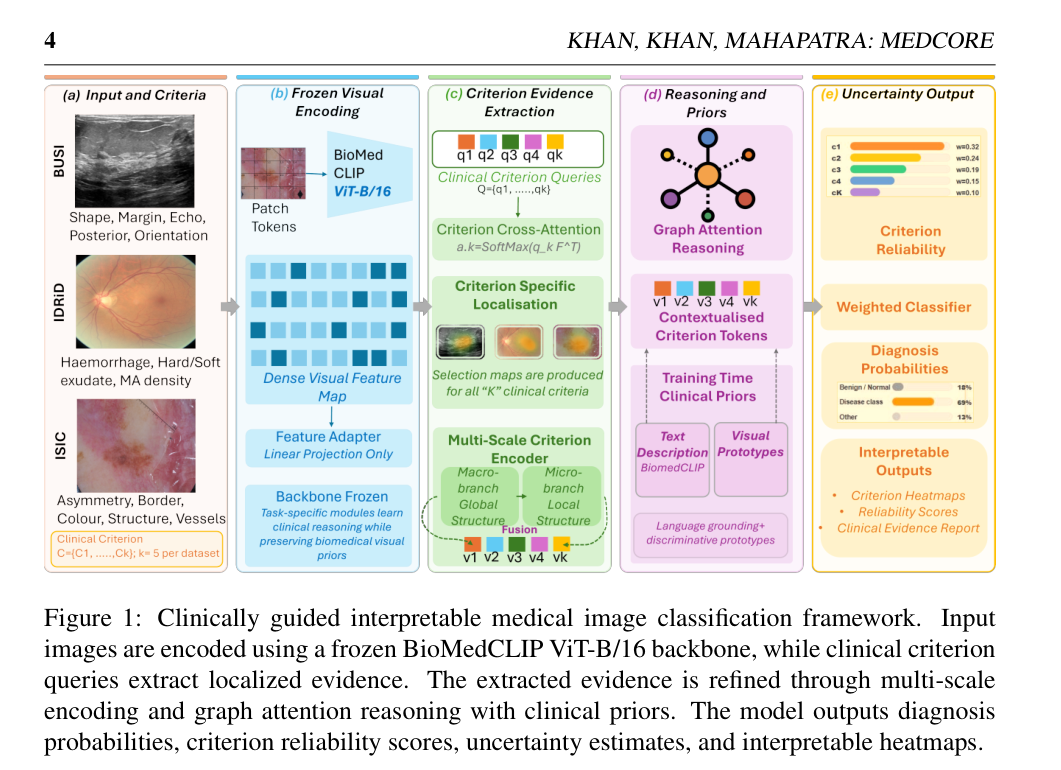
图1是第4页方法总览,宜作特色图。五列从左到右为 (a) Input and Criteria、(b) Frozen Visual Encoding、(c) Criterion Evidence Extraction、(d) Reasoning and Priors、(e) Uncertainty Output。(a) 给出三张输入:BUSI 超声旁标注 Shape, Margin, Echo, Posterior, Orientation;IDRiD 眼底旁标注 Haemorrhage, Hard/Soft exudate, MA density;ISIC 皮肤镜旁标注 Asymmetry, Border, Colour, Structure, Vessels;底部写 k=5 per dataset。(b) 冻结 BioMedCLIP ViT-B/16 把图像编成 Patch Tokens 与 Dense Visual Feature Map,Feature Adapter 只做线性投影。(c) 可学习查询 q1…qk 做 Criterion Cross-Attention,生成每条判据的定位图,再经 Macro-branch Global Structure 与 Micro-branch Local Structure 融合为 v1…vk。(d) 中心节点的 Graph Attention Reasoning 得到 Contextualised Criterion Tokens,下方是训练期临床先验:Text Description(BioMedCLIP)与 Visual Prototypes。(e) Criterion Reliability 条形示意 c1=0.32 到 ck=0.10,饼图给出 Benign/Normal 18%、Disease class 69%、Other 13%,并列出 Criterion Heatmaps、Reliability Scores、Clinical Evidence Report。页眉含论文标题,讲图时忽略。这是方法示意图,不是临床界面。
关键证据
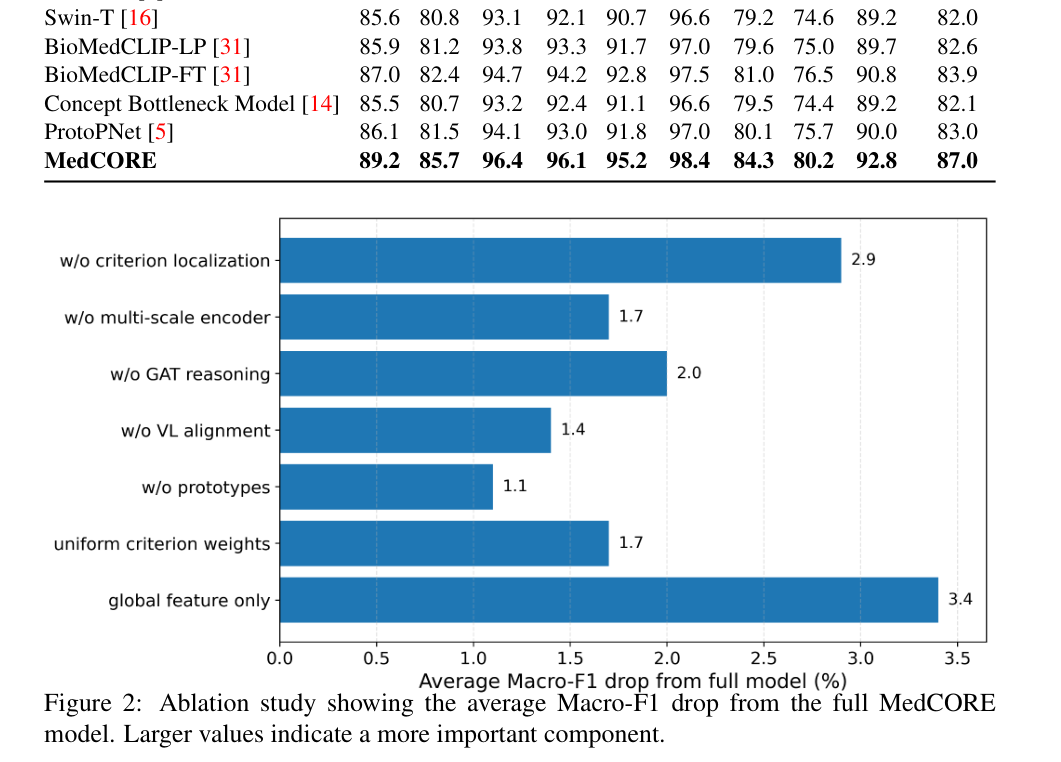
图2是第10页消融条形图,横轴为相对完整模型的平均 Macro-F1 下降(%)。可见七根蓝色横条:w/o criterion localization 2.9、w/o multi-scale encoder 1.7、w/o GAT reasoning 2.0、w/o VL alignment 1.4、w/o prototypes 1.1、uniform criterion weights 1.7、global feature only 3.4。裁切顶部残留 Table 3 末行数字,包括 MedCORE 的 89.2、85.7、96.4、96.1、95.2、98.4、84.3、80.2、92.8、87.0,那是对照表而不是消融图本身。条越长表示该模块越重要,与正文“临床分解是核心”一致。
校准观察
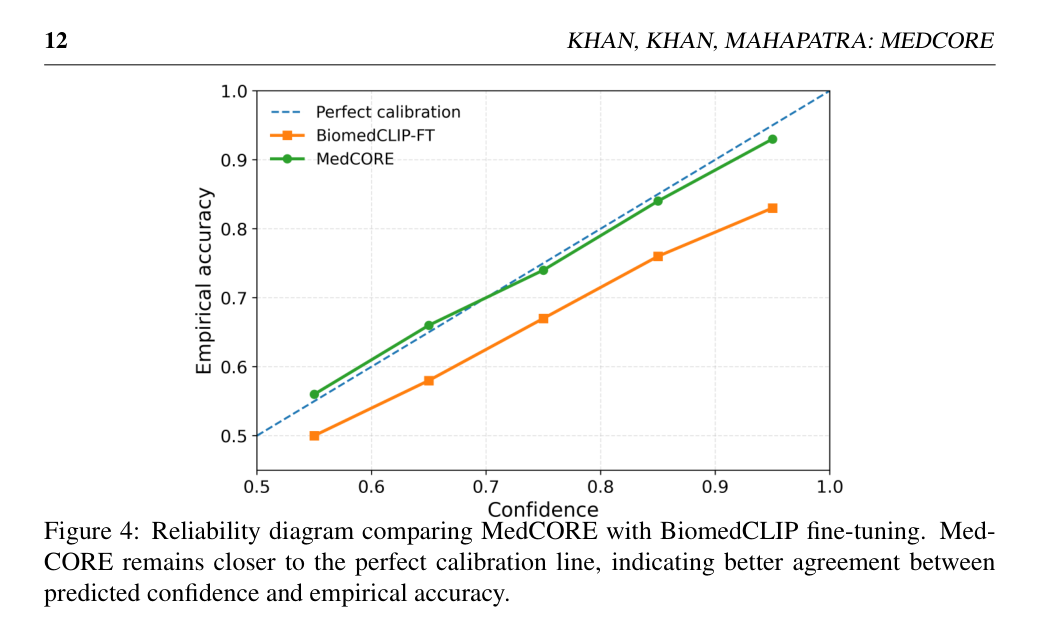
图4是第12页可靠性图。横轴 Confidence,纵轴 Empirical accuracy,范围约 0.5–1.0。蓝色虚线是 Perfect calibration;橙色 BiomedCLIP-FT 全程低于对角线;绿色 MedCORE 贴近虚线,高置信端约 0.93,对照约 0.83。页码 12 在左上角。图内没有画出 ECE 数值,8.2% 与 1.2% 的平均间隙来自正文按各档等高权计算,讲图时不要把图内折线误当成临床校准证书。更好的基准校准仍不等于临床可用。
实验如何设计?
- 对照包括 DenseNet-121、ResNet-50、EfficientNet-B0、ViT-B/16、Swin-T,以及 BioMedCLIP 线性探测与微调、Concept Bottleneck 与 ProtoPNet。预处理与划分对所有方法一致。优化器用 AdamW,学习率与权重衰减均为 1×10⁻⁴,batch 32,最多 100 轮,按验证 Macro-F1 早停。
- 主指标因类别不平衡取 Macro-F1,同时报准确率与 one-vs-rest AUC。校准看可靠性图与 ECE。消融在三数据集平均 Macro-F1 上比较;K 的扫描覆盖 1 到 9。这些设置只说明公开测试集上的相对贡献,不能代替临床评价。
关键结果与论文证据
- Table 3 中 MedCORE 三项全最高:ISIC 准确率 89.2%、Macro-F1 85.7%、AUC 96.4%;BUSI 96.1%、95.2%、98.4%;IDRiD 84.3%、80.2%、92.8%。相对 BioMedCLIP 微调,Macro-F1 分别高 3.3、2.4、3.7 个百分点,作者据此认为增益不只来自生物医学骨干。IDRiD 绝对提升最大,与需要多种病灶共同分级的设定一致;BUSI 绝对分数最高,作者认为 BI-RADS 风格判据更贴超声模式。
- Figure 2 / Table 4:去掉全局特征替代判据推理下降 3.4 个百分点,去掉空间定位 2.9,去掉 GAT 2.0,去掉多尺度或改均匀权重各 1.7,去掉语言对齐 1.4,去掉原型 1.1。Figure 3 在 K=5 达到 87.0%,K=1 为 83.6%,K=9 回落到 85.9%,支持使用紧凑临床判据集而不是堆更多潜概念。
- Figure 4 上 BioMedCLIP 微调整体低于对角线,置信度 0.95 时经验准确率仅 0.83;MedCORE 约 0.93。按图中各档等高权平均,校准间隙约 8.2% 对 1.2%。这与不确定性加权的设计一致,但仍是基准校准,不是临床可靠性证明。
阅读时需要注意
- 结论写明后续才计划更大的多中心数据、专家核验的判据标注,以及真实临床决策支持中的校准与可用性研究。当前没有临床试验、没有外部医院队列、也没有读者研究证明热图能帮助医生。
- 判据是数据集级模板,不是逐图像的专家金标准;热图没有像素级监督,不能当分割或病灶计数。骨干冻结、分辨率 224,细小病灶与设备差异都可能被压缩。
- MedCORE 不是临床产品,不得把 ISIC、BUSI、IDRiD 测试集上的分数外推为临床可用,也不得当作诊断器械或筛查系统宣传。预印本尚未同行评审。
关联工作
- 医学图文预训练(GLoRIA、BioViL、MedKLIP、KAD、BioMedCLIP)解决的是表示,不一定强迫分类器走具名判据。概念瓶颈及其医学变体插入可解释中间量,但 MedCORE 额外要求定位、关系与不确定度。
- 原型网络用“这看起来像那”解释决策;本文把原型降为判据级记忆,对外解释仍按临床判据、可靠性分数与热图组织。SAM / MedSAM 说明空间先验有用,但分类需要的是判据级证据而不是通用掩码。