快速导读:PEA-DPO 提出视觉不敏感性(Across-Image 与 Within-Image)的理论刻画,并通过 CLIP 引导构造感知增强偏好数据与联合优化目标,显著降低 MLLM 幻觉。
PEA-DPO 针对多模态大模型对齐中的一个根本性问题:当 DPO 从纯文本扩展到多模态场景时,图像通常只被当作条件,偏好信号完全来自响应文本。这种设计导致模型对视觉上下文不敏感,表现为无法区分不同图像,也无法在图像内区分关键线索与无关线索。论文将这两种失效模式形式化为 Across-Image Insensitivity 与 Within-Image Insensitivity,并提出感知增强偏好数据构造与联合优化目标来同时缓解它们。
方法的核心思路是:用 CLIP 引导的随机掩码策略构造 rejected image,使被移除的恰好是最关键的视觉上下文;然后在损失函数中同时优化响应质量偏好与视觉上下文偏好。实验在 LLaVA-v1.5 的 7B 和 13B 模型上进行,覆盖 MMHalBench、Object HalBench 和 AMBER 三个幻觉基准,并通过消融、归因分析和通用能力评估验证了方法的有效性。
英文题目:PEA-DPO: Perception-Enhanced Alignment Direct Preference Optimization for MLLMs Alignment
论文出处:arXiv 每日论文精选 · arXiv:2608.19598
原始论文:PDF / 论文页面
这篇论文解决什么问题?
多模态 DPO 的默认做法是:给定一张图像和一个提示,模型生成两个响应,人类或 AI 标注哪个更好,然后用这个偏好对来优化模型。在这个框架里,图像只是条件,偏好信号只来自响应文本。这意味着模型可以学会生成看起来合理的文本,却完全忽略图像内容。
论文通过 Figure 2 展示了两种具体的失效模式。Across-Image Insensitivity 指的是模型对不同图像赋予几乎相同的偏好分数,例如户外阅读和野餐两个场景,模型无法捕捉到判别性的视觉上下文。Within-Image Insensitivity 指的是模型在同一张图像内无法区分语义关键线索与无关线索,例如把螺丝刀误认为马桶刷或皮搋子。
现有方法试图解决这个问题,但都存在缺陷。mDPO 和 V-DPO 在优化目标中引入了视觉信号,但它们构造的 rejected image 要么是完全无信息的图像,要么是粗粒度变换,无法精确移除关键视觉上下文。OPA-DPO 强调 on-policy 偏好数据构造,但同样没有显式建模视觉偏好。CHiP 依赖重型模型构造跨模态层次化偏好数据,计算开销大。
论文的理论分析(第 3 节)给出了定理 3.3 和 3.4,刻画了两种视觉不敏感性与图像级边际、响应级边际之间的关系。这为后续的方法设计提供了理论依据:要缓解视觉不敏感性,必须同时扩大图像级边际和响应级边际。
核心创新
- 首次形式化多模态 DPO 中的视觉不敏感性,分解为 Across-Image Insensitivity 与 Within-Image Insensitivity 两种失效模式,并给出定理 3.3 与 3.4 的理论刻画。
- 提出基于 CLIP 相似度选择的感知增强偏好数据构造方法,通过随机掩码与语义相似度最低选择精确移除关键视觉上下文。
- 提出联合优化目标 mPEA-DPO,同时扩大图像级边际 G_m 与响应级边际 G_r,理论上可证明同时缓解两种视觉不敏感性。
- 借鉴 RePO 设计,用 ReLU 替代 sigmoid、长度归一化替代参考模型、目标边际替代温度参数,实现可控且低开销的偏好优化。
方法概览
PEA-DPO 包含两部分:(1) 感知增强偏好数据构造:对原图施加随机掩码生成 n 个扰动图像,用 CLIP 嵌入计算与原图的语义相似度,选择相似度最低者作为 rejected image;(2) 联合优化目标:同时优化响应质量偏好(mRPO)与视觉上下文偏好(mVPO),采用 ReLU 激活、长度归一化对数概率与目标边际 {γ_r, γ_m},权重 α 控制视觉偏好强度。
- 感知增强偏好数据构造:对原图施加随机掩码生成 n 个扰动图像,用 CLIP 计算每个扰动图与原图的语义相似度,选择相似度最低者作为 rejected image。这样被移除的恰好是最关键的视觉上下文,而不是随机噪声。
- 联合优化目标 mPEA-DPO:损失函数包含响应质量偏好项(mRPO)和视觉上下文偏好项(mVPO),权重 α 控制视觉偏好的强度。
- 借鉴 RePO 设计:用 ReLU 替代 sigmoid 激活,用长度归一化对数概率替代参考模型,用目标边际替代温度参数,实现可控且低开销的偏好优化。
- 目标边际设置:响应级边际 γ_r 和图像级边际 γ_m 分别控制两个偏好项的区分度,论文在 LLaVA 框架上调优了这些超参数。
- 训练配置:使用 RLAIF-V 的 22K 偏好数据(13K 图像),掩码比例 9%,n=30,γ_r=1.5,γ_m=4.5,α=0.2,全参数微调 5000 步。
- 与 mDPO 的关键区别:mDPO 使用完全无信息的图像作为 rejected image,而 PEA-DPO 通过 CLIP 相似度最低选择精确移除关键视觉上下文,使 rejected image 仍然保留大部分视觉信息但缺失最关键的线索。
逐图理解论文
失效案例
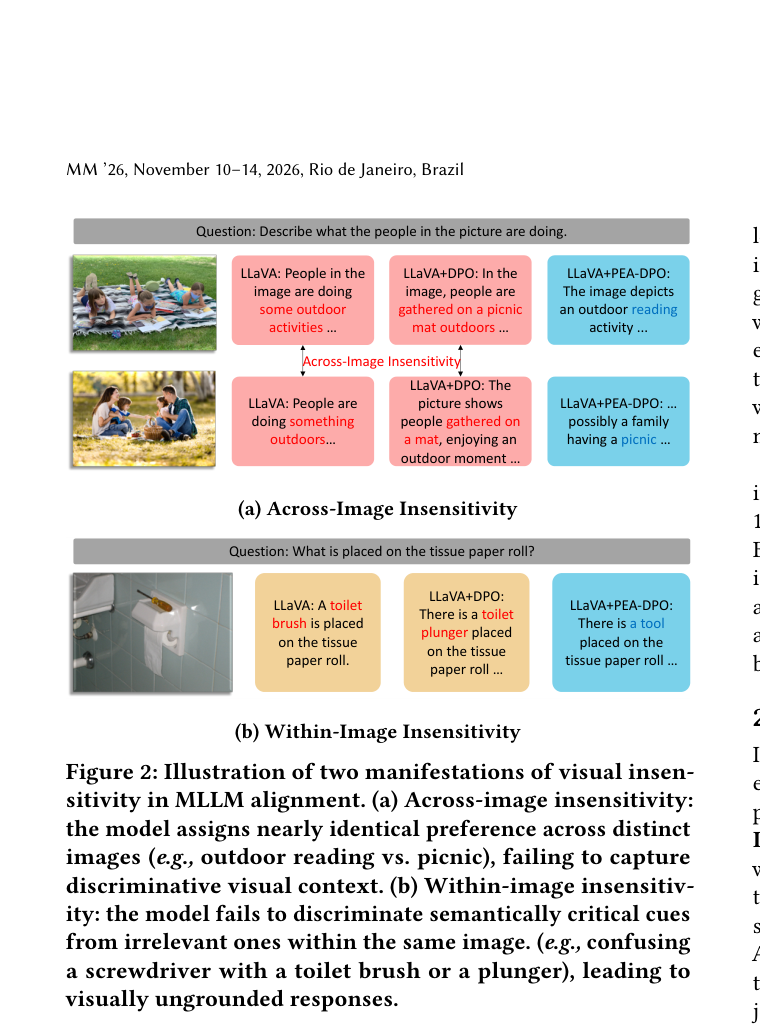
该图直观展示了两种视觉不敏感性的具体表现。左半部分显示模型对不同图像赋予几乎相同的偏好分数,右半部分显示模型在同一图像内混淆语义关键线索与无关线索。这是理解论文问题动机的核心图示。
研究缺口
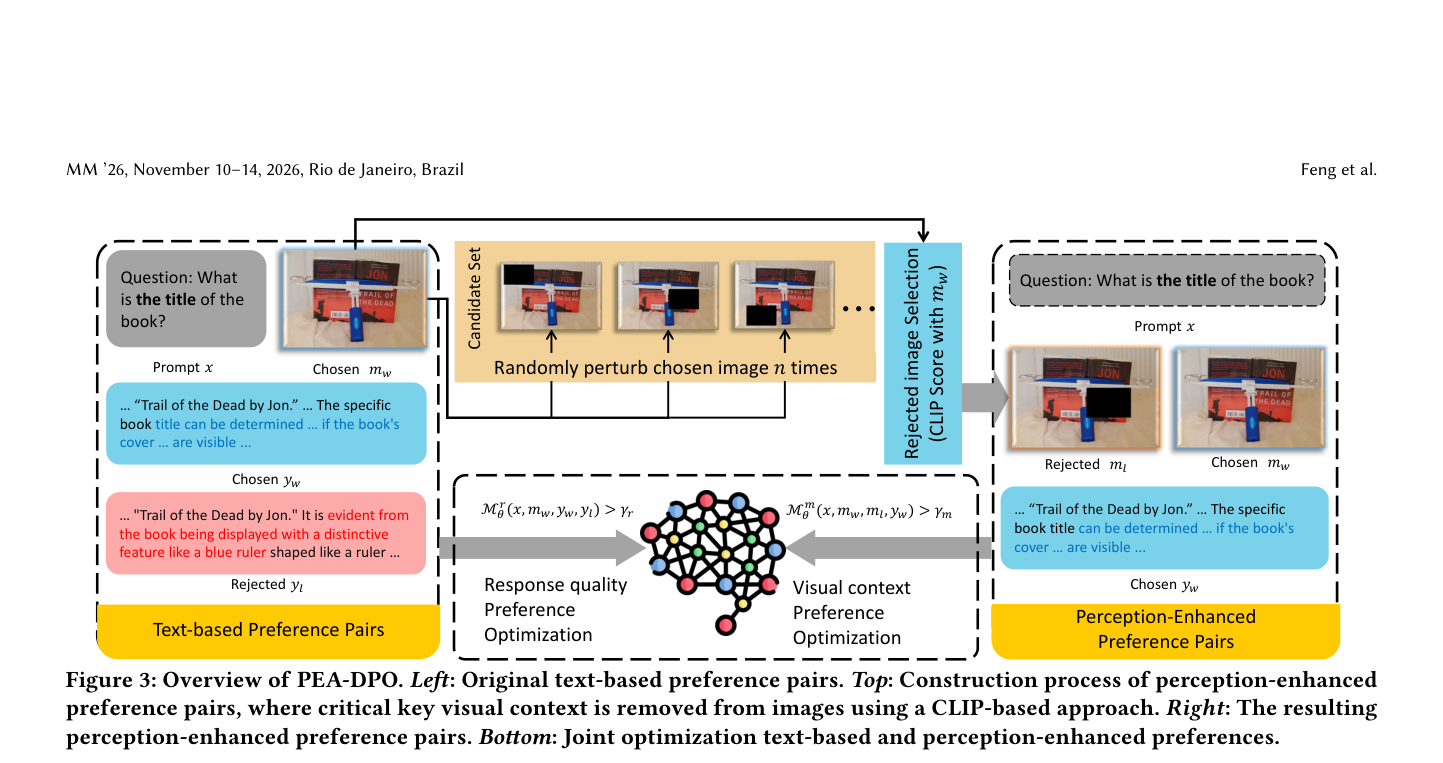
该图展示了 PEA-DPO 的完整流程:左侧是原始文本偏好对,上方是 CLIP 引导的感知增强偏好数据构造过程,右侧是构造结果,下方是联合优化目标。应重点关注 rejected image 的构造方式与联合优化的结构。
验证与消融
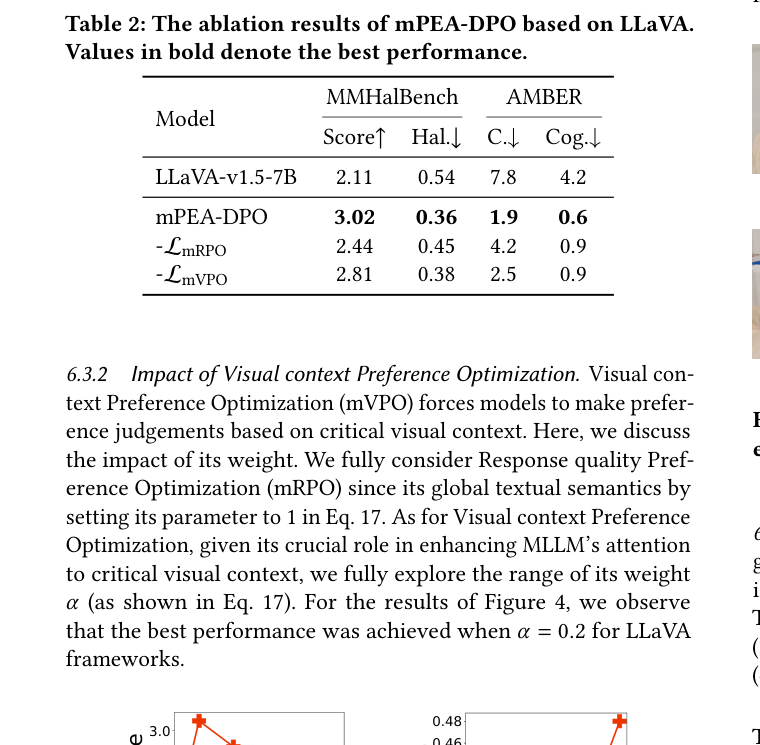
该表是消融实验结果,对比了仅 mRPO、仅 mVPO 和完整 mPEA-DPO 的性能。应关注两个组件单独使用时的性能差距,以及联合使用时的提升幅度。
结论与意义
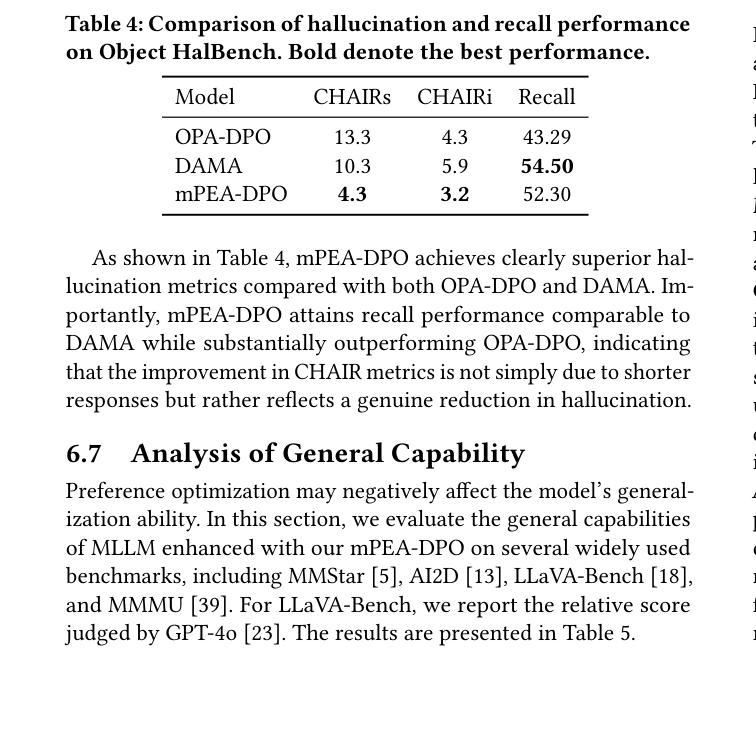
该表是幻觉归因分析结果,对比了 CHAIRs、CHAIRi 和 Recall。应关注 mPEA-DPO 的 Recall 是否与 DAMA 相当,以排除短回复作弊的可能。
实验如何设计?
- 基座模型:LLaVA-v1.5-7B 和 LLaVA-v1.5-13B,全参数微调。
- 偏好数据:RLAIF-V 发布的 22K 偏好数据,包含 13K 图像。
- 评估基准:MMHalBench(多模态幻觉问答)、Object HalBench(对象幻觉)、AMBER(无 LLM 的多维幻觉评估)。
- 对比基线:GPT-4V、Gemini-2.5-Pro 以及多种 RLHF/RLAIF 基线,包括 OPA-DPO、DAMA、RLAIF-V 等。
- 消融维度:mRPO 与 mVPO 组件贡献、α 权重(0 到 1.8)、rejected image 构造策略(Blockwise、Rotation、Crop、Blackness、Ours)、数据规模(2.8k 到 22.6k)。
- 归因分析:在 Object HalBench 上对比 CHAIRs、CHAIRi 与 Recall,排除短回复作弊的可能。
关键结果与论文证据
- LLaVA-v1.5-7B + mPEA-DPO 在 MMHalBench 上 Score 3.02、Hal. 0.36,优于 RLAIF-V(3.00/0.38)、OPA-DPO(2.83/0.45)和 DAMA(2.76/0.41)(第 6 页 Table 1)。
- LLaVA-v1.5-13B + mPEA-DPO 在 MMHalBench 上 Score 3.16、Hal. 0.31,优于 OPA-DPO(3.07/0.39)与 DAMA(2.89/0.43)(第 6 页 Table 1)。
- 在 Object HalBench 上,7B 模型的 CHAIR_s 从基座的显著水平降至 4.3,CHAIR_i 降至 3.2,优于 OPA-DPO(13.3/4.3)与 DAMA(10.3/5.9)(第 6 页 Table 1)。
- 消融实验显示完整 mPEA-DPO 在 MMHalBench Score 3.02/Hal. 0.36,优于仅 mRPO(2.44/0.45)与仅 mVPO(2.81/0.38),证明两个组件缺一不可(第 7 页 Table 2)。
- α=0.2 时在 MMHalBench 与 AMBER 上取得最佳 Score、CHAIR 与 Hallucination Rate,过大或过小的 α 都会损害性能(第 7 页 Figure 4)。
- rejected image 构造策略对比中,CLIP 相似度最低选择在 MMHalBench Score 3.03/Hal. 0.36,优于 Blackness(2.90/0.41)、Crop(2.69/0.42)、Blockwise(2.64/0.42)和 Rotation(2.47/0.46)(第 7 页 Table 3)。
- 幻觉归因分析显示 mPEA-DPO 在 Object HalBench 上 Recall 52.30,与 DAMA(54.50)相当且显著优于 OPA-DPO(43.29),说明 CHAIR 改善并非因短回复(第 8 页 Table 4)。
- 通用能力评估显示 LLaVA-v1.5-7B + mPEA-DPO 在 MMStar 32.8、AI2D 51.9、LLaVA-Bench 86.5,均优于基座模型(30.3/49.1/82.3),MMMU 基本持平(第 8 页 Table 5)。
阅读时需要注意
- 构造感知增强偏好数据需要额外计算生成与评估扰动图像,增加了训练前的数据准备开销。
- 因计算资源限制,未在最新 MLLM(如 Muffin)上测试,方法的泛化性有待进一步验证。
- mPEA-DPO 略微降低覆盖率指标,反映模型倾向于保守生成、避免不确定输出,这可能是幻觉降低的副作用。
- α、γ_r、γ_m 等超参数在 LLaVA 框架上调优,迁移到其他 MLLM 时需重新验证。
关联工作
- DPO 是本文方法的基础偏好优化框架,PEA-DPO 在其上扩展视觉上下文偏好项(第 2 页)。
- mDPO 将视觉信号纳入优化目标,但使用完全无信息图像作为 rejected image,本文指出其粗粒度缺陷(第 2 页)。
- V-DPO 是视觉引导的 DPO 变体,同样在优化目标中引入视觉信号,但未精确建模关键视觉上下文(第 2 页)。
- OPA-DPO 强调 on-policy 偏好数据构造,作为主要对比基线之一(第 2 页)。
- DAMA 是数据与模型感知的自适应对齐方法,作为主要对比基线之一(第 2 页)。
- RePO 是本文 mPEA-DPO 损失设计(ReLU、长度归一化、目标边际)的灵感来源(第 4 页)。
- SimPO 提供长度归一化对数概率的参考方法,用于防止长度偏差(第 5 页)。
- MFPO 和 LPOI 通过预定义变换构造 rejected image,本文指出其无法精确移除关键视觉上下文(第 2 页)。