快速导读:CogCanvas 提出首个同时覆盖身份、物体/服饰、背景参考及交互与空间推理的多主体参考图像生成基准,并揭示现有方法在 3 人以上场景中属性绑定全面崩溃。
CogCanvas 是一个面向多主体参考图像生成的评测基准,其核心贡献在于首次将身份保持、逐人属性绑定、背景一致性、交互正确性与空间合理性五个维度纳入同一评测框架。与以往只关注单一维度的基准不同,CogCanvas 通过 1,952 张参考图像和 1,361 条组合提示,构建了一个更接近真实应用场景的测试环境。
论文的核心发现是:现有方法在两人场景中尚可维持基本性能,但当主体数量增加到三人及以上时,属性绑定能力急剧退化,DINO-Sim 和 Attr-VQA 指标几乎归零。这一发现将多主体生成的研究焦点从'能否生成'转向'能否正确绑定',为后续方法设计提供了明确的方向。
英文题目:CogCanvas: A Benchmark for Evaluating Multi-Subject Reference-Based Image Generation
论文出处:arXiv 每日论文精选 · arXiv:2606.15867
原始论文:PDF / 论文页面
这篇论文解决什么问题?
扩散模型在单主体个性化任务上已经相当成熟,FLUX、Stable Diffusion、SeedDream 等方法能够高质量地保持单个身份或物体的外观。然而,当场景中同时出现多个身份、多个物体和特定背景时,模型需要同时解决身份保持、属性绑定、空间布局和交互一致性等多个相互耦合的问题。
现有基准存在明显的覆盖缺口。DreamBench 和 DreamBench++ 仅评估单主体个性化;T2I-CompBench 的空间关系检查是二值的,不涉及身份特定生成;XVerseBench 最多只支持三个主体,且没有交互正确性评测;MultiHuman-Testbench 虽然面向多人生成,但缺少属性绑定评测,提示也仅包含简单的群体动作。
CogCanvas 的定位正是填补这一空白:它要求模型同时接收人类参考、物体/服饰参考和背景参考,并生成符合交互图和位置图约束的图像。这种三参考设置比以往任何基准都更接近实际应用中的'合成场景'需求。
核心创新
- 首个同时覆盖人类参考、物体参考、HOI、背景参考与空间合理性五维的多主体参考生成基准
- 引入两个新指标:BG-Sim(SAM 3 前景掩码 + DINOv3 背景保真度)与 Attr-VQA(Gemma4 对属性绑定与交互图的结构化验证)
- 自动派生结构化交互图与位置图作为细粒度评测真值,覆盖 N! 空间排列
- 提出训练无关基线 SRI,逐主体顺序修复以抑制跨主体参考泄漏
方法概览
CogCanvas 构建 1,952 张参考图像(100 身份、80 物体、35 服饰、29 背景)与 1,361 条 2–5 人组合提示,自动派生交互图与位置图作为真值;定义六轴评测(ID-Sim、DINO-Sim、CLIP-T、BG-Sim、Aesth.、Attr-VQA),并贡献训练无关基线 SRI(Sequential Reference Inpainting),通过逐主体掩码修复抑制跨主体特征泄漏。
- 数据管线:CogCanvas 从三个不相交的参考池中独立采样——CelebA-HQ 中的 100 个身份、通过网络爬取并经 DINOv2 去重和两阶段过滤的 80 个物体与 35 件服饰、以及 29 个背景场景。
- 提示合成:对每个组合提示,采样 N∈{2,…,5} 个身份,为每人分配物体/服饰参考,选择一个背景场景,定义成对交互关系,并指定覆盖所有 N! 排列的空间布局。
- 结构化真值:每条提示自动派生交互图(编码人物间及人物与物体间的成对关系)和位置图(编码主体间相对空间排列),作为属性绑定和空间合理性评测的真值监督。
- 六轴评测体系:ID-Sim 基于 ArcFace 测量身份相似度,DINO-Sim 基于 DINOv2 测量物体/服饰属性相似度,CLIP-T 测量文本-图像对齐,BG-Sim 使用 SAM 3 前景掩码加 DINOv3 测量背景保真度,Aesth. 评估美学质量,Attr-VQA 使用 Gemma4 对属性绑定和交互图进行结构化验证。
- SRI 基线:Sequential Reference Inpainting 是一种训练无关的方法,先生成带主体占位符的场景布局,再分割人脸/物体区域,然后逐区域按对应参考进行修复,以减少跨主体特征泄漏。
- 匈牙利匹配:在计算 ID-Sim 时,使用 Hungarian matching 将生成的人脸与参考身份进行最优对齐,避免因主体顺序不同而低估相似度。
逐图理解论文
失败案例与直觉
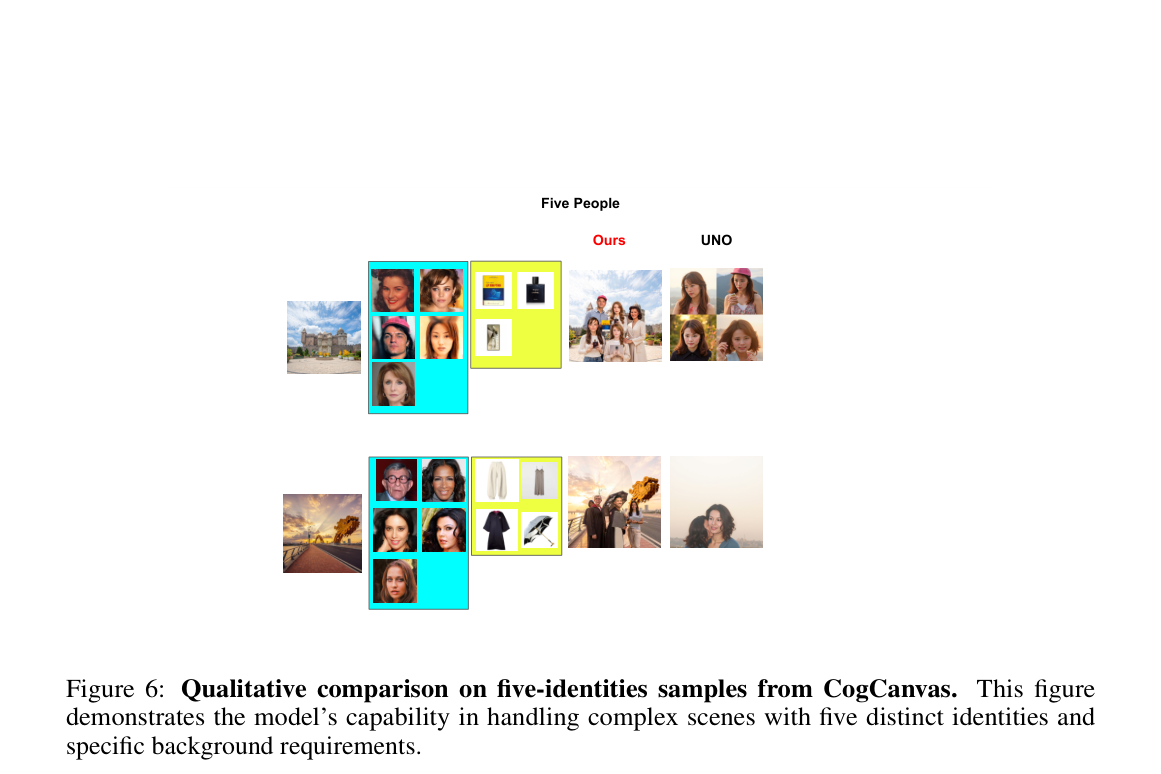
图 6 聚焦五人场景,这是最具挑战性的设置。OmniGen2、DreamO、XVerse 和 MOSAIC 均出现部分或错误归属,而 SRI 维持了逐主体保真度。
研究空白
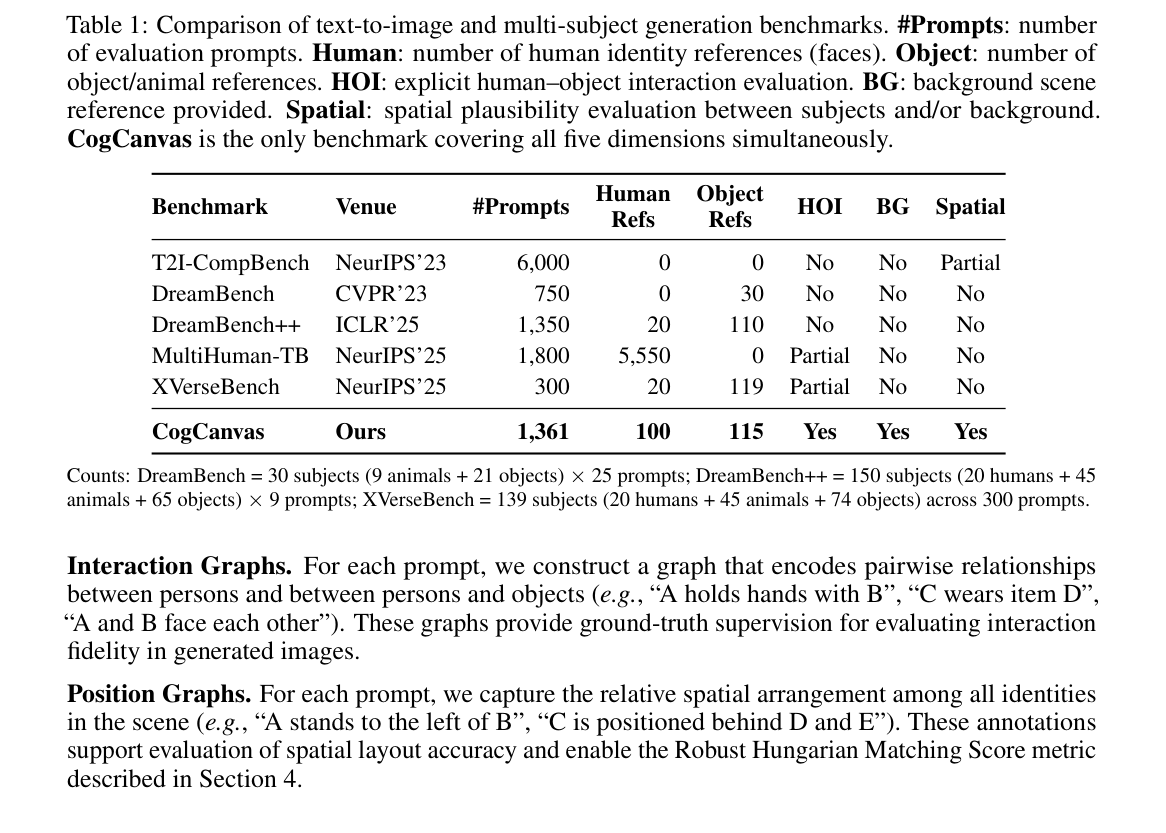
表 1 将 CogCanvas 与现有基准逐维对比,CogCanvas 是唯一同时覆盖人类参考、物体参考、HOI、背景参考和空间合理性五个维度的基准。这个表格直接支撑了论文的'研究空白'论证。
方法贡献与评测设计
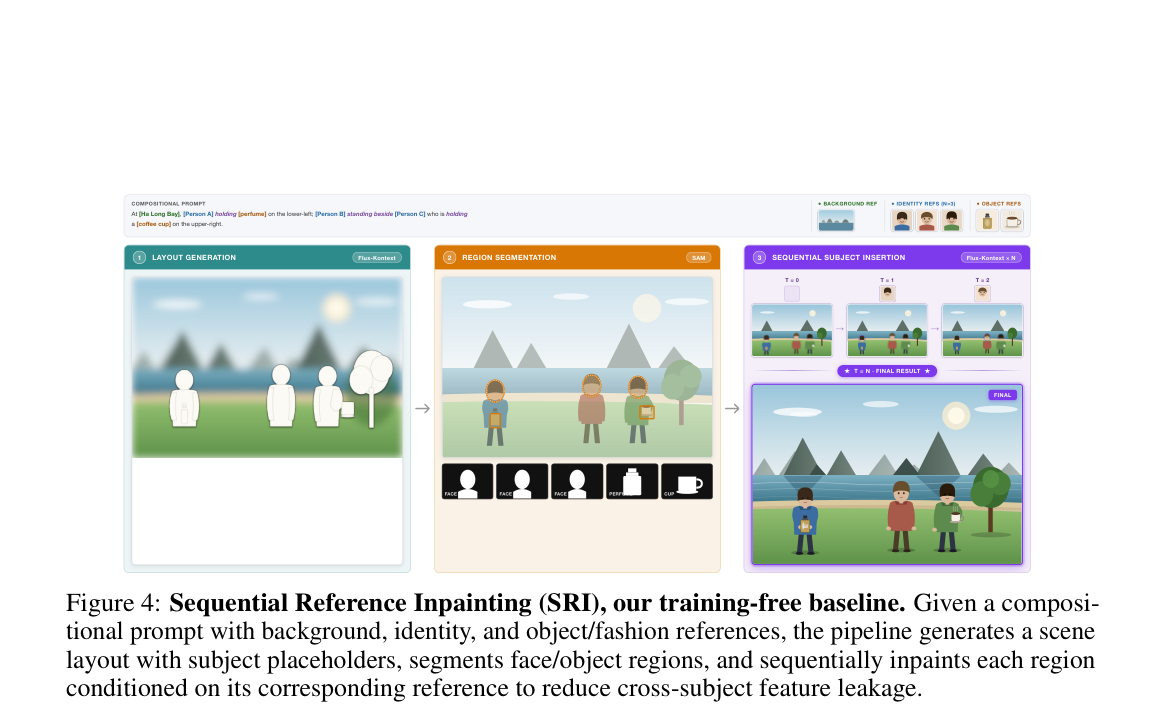
图 4 展示了 SRI 的流程:先生成带占位符的场景布局,再分割区域,然后逐区域按参考修复。关键设计是顺序修复而非联合生成,这是抑制跨主体特征泄漏的核心机制。
核心发现
评测结果揭示了一个清晰的模式:SRI 在身份保持和属性绑定上全面领先,但优势特定于参考接地,而非整体图像质量。更关键的是规模效应——当 N 从 2 增加到 5,所有方法的 DINO-Sim 和 Attr-VQA 都急剧下降,四人时除 UNO 外所有先前方法的 DINO-Sim 已低于 2.63,五人时几乎归零。这说明属性绑定崩溃不是某个方法的弱点,而是当前多主体生成范式的系统性瓶颈。
实验如何设计?
- 在 CogCanvas 上对比 SRI 与五种 SOTA 方法:OmniGen2、UNO、DreamO、XVerse、MOSAIC,按 N=2 到 N=5 分组评测六轴指标。
- 定性对比 2–5 人场景的生成结果,重点分析身份保持、属性泄漏和背景回归三类失败模式。
- 数据管线中 MLLM 验证的拒绝率分别为 9.4%、6.1% 和 3.7%,表明提示质量经过了多轮过滤。
- BG-Sim 仅对 SRI 报告,因为其他方法没有背景参考条件通道,无法公平比较。
关键结果与论文证据
- SRI 在 N=2 时 Attr-VQA 达 53.41,最佳先前方法 UNO 为 35.12;N=3 时 SRI 为 37.18,UNO 为 14.65,差距达 2.5 倍(第 8 页)。
- N=4 时除 UNO 外所有先前方法 DINO-Sim 降至 2.63 以下,N=5 时降至 0.46 以下;SRI 在 N=4/5 保持 19.48/16.72(第 8 页)。
- UNO 在 N=5 时 Attr-VQA 降至 7.27;SRI 自身也从 N=4 的 35.52 降至 N=5 的 9.48,说明即使是最强基线也未能解决规模扩展问题(第 8 页)。
- SRI 在 N=2 时 ID-Sim 为 45.28(XVerse 42.33 次之),N=3 时 32.61(XVerse 27.21 次之),在身份保持上持续领先(第 9 页)。
- CLIP-T 在 N≥4 时 UNO 反超 SRI(N=4 差 −2.70),Aesth. 各 N 下 SRI 与 UNO 差距不超过 1.2 分,说明 SRI 的优势特定于参考接地而非整体图像质量(第 8 页)。
- SRI 的 BG-Sim 为 0.732/0.633/0.611/0.610(N=2/3/4/5),但该指标仅对 SRI 报告,无法与其他方法比较(第 9 页)。
- 定性分析(第 15–17 页)显示,OmniGen2、DreamO、XVerse 和 MOSAIC 在五人场景中产生部分或错误归属的输出,而 SRI 能维持逐主体保真度。
阅读时需要注意
- CelebA-HQ 身份与网络抓取品牌物体可能与生成器预训练数据重叠,ID-Sim 和 DINO-Sim 可能部分反映记忆而非参考接地。
- 提示合成/验证与 Attr-VQA 均依赖同一 MLLM 家族(Gemma4),测试集与该 MLLM 的盲区耦合,存在系统性偏差风险。
- 身份池经人工审计仍存在残余人口统计偏差。
- 少量物体/服饰参考并非纯像素(如目录照片中模特穿着),不是严格意义上的单实体参考集。
关联工作
- MultiHuman-Testbench 是最接近的多人生成基准,但缺少属性绑定评测,提示仅含简单群体动作。
- XVerseBench 是多主体基准(最多 3 主体),无交互正确性与复杂空间配置评测。
- DreamBench/DreamBench++ 是单主体个性化基准,不涉及多主体场景。
- T2I-CompBench 的组合文本到图像基准中,空间关系仅为二值检查,无身份特定生成。
- 被评测的 OmniGen2、UNO、DreamO、XVerse、MOSAIC 均无背景参考条件通道,这是它们背景回归失败的结构性原因。