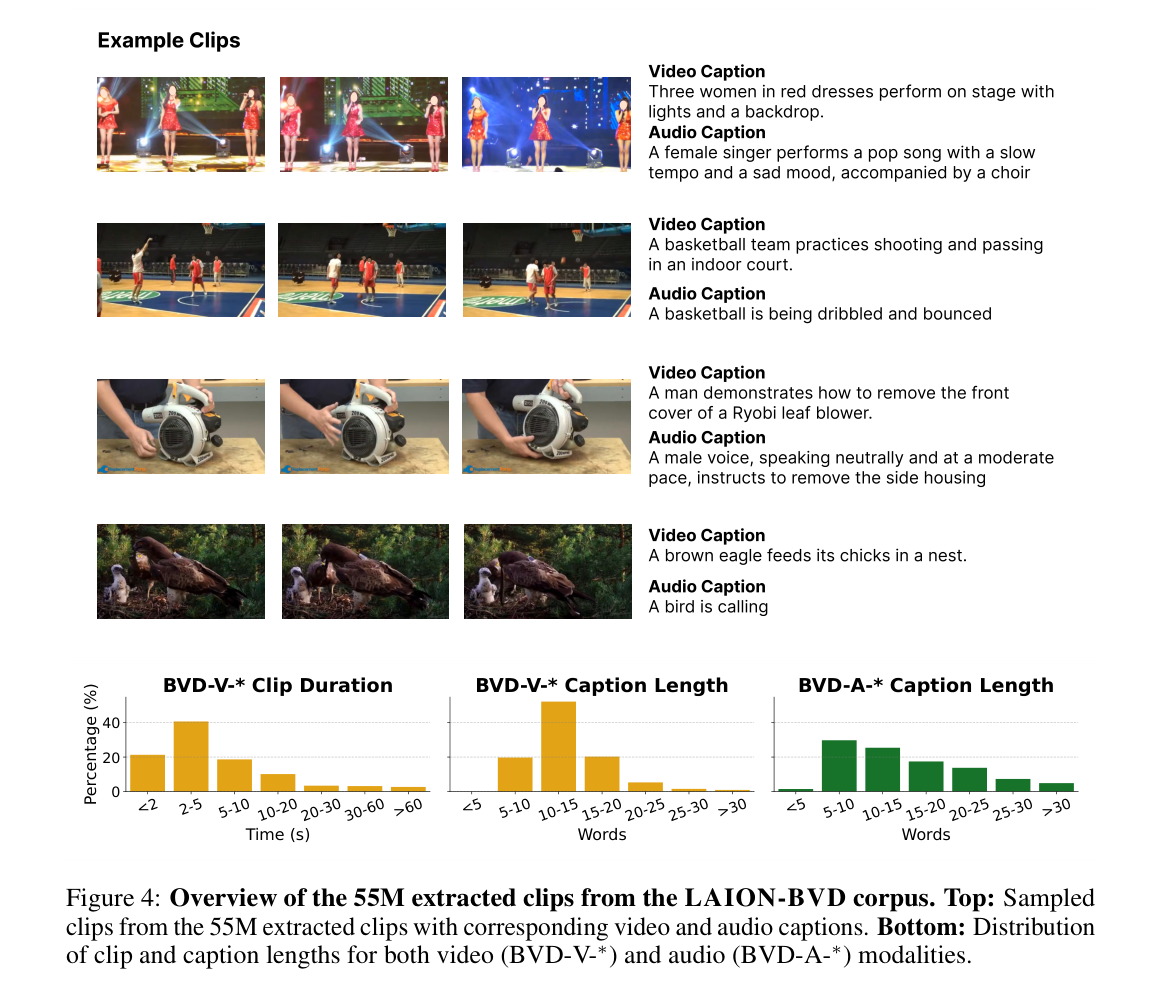
快速导读:LAION-BVD 是一个包含 10M 视频小时、55M 视频/音频片段和 300M 帧-文本对的开放多模态预训练数据集,在视频-文本、音频-文本和图像-文本任务上均展现出有竞争力的性能与扩展性。
LAION-BVD 是 LAION 社区发布的一个大规模开放视频数据集,包含约 10M 视频小时、80M 个视频、1.3B 个平台视频 URL,以及从中抽取的 55M 视频/音频片段和 300M 场景切换帧-文本对。论文的核心主张是:开放视频数据长期落后于图像-文本和文本语料的规模,而 LAION-BVD 通过 CommonCrawl 来源的规模化采集与自动化标注,首次在视频、音频、图像三条模态上同时验证了开放视频数据的预训练价值。
与以往视频数据集不同,LAION-BVD 不是单纯扩大视频数量,而是把视频当作一个多模态信号源:同一批视频既可以切片段做视频-文本对比学习,也可以提取音频做音频-文本训练,还可以抽帧做图像-文本训练。这种'一源三用'的设计使论文的贡献超越了单一模态的数据集发布,指向一个更一般的结论——开放视频是尚未充分利用的多模态预训练资源。
英文题目:LAION-BVD: A 10-Million-Hour Open Video Dataset for Multimodal Pre-training
论文出处:arXiv 每日论文精选 · arXiv:2608.24845
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在 LAION-BVD 之前,开放图像-文本数据集如 LAION-5B、DataComp-1B 已经支撑起有竞争力的 CLIP 类模型,文本语料更是以万亿 token 计。但视频-语言数据集的规模明显落后:此前最大的公开视频-文本数据集 InternVid 仅约 7M 视频,而 Panda-70M、HD-VILA-100M 等数据集虽然规模更大,但在可访问性、许可或实际可用性上存在限制。
视频数据收集的瓶颈来自多个层面。平台 API 的访问限制使研究者难以批量获取视频元数据;下载和存储 10M 小时级别的视频需要分布式基础设施;更重要的是,原始视频没有自然对应的文本描述,必须依赖自动标注流水线生成训练信号。这些工程与计算开销使大规模开放视频数据集长期停留在'想做但难做'的状态。
论文指出的一个关键直觉是:视频同时包含视觉和音频信号,理论上一个视频数据集可以同时服务视频-文本、音频-文本和图像-文本三种预训练任务。但此前没有工作在同一数据源上系统验证这一点。LAION-BVD 的贡献正是填补了这个空白——不是提出新的模型架构,而是用数据规模的实证结果回答'开放视频数据到底值不值得做'。
核心创新
- 发布 LAION-BVD:10M 视频小时、80M 视频、1.3B URL 的开放视频数据集,规模远超现有公开视频数据集
- 提出可扩展的多模态标注流水线,同时生成片段级视频描述、音频描述和帧-文本对
- 发布 55M 视频/音频片段(BVD-V-55M/BVD-A-*)和 300M 场景切换帧(BVD-I-300M)
- 验证视频帧作为图像-文本数据新来源,其视觉分布与网页图像语料显著不同(FID=33.92)
方法概览
从 CommonCrawl 提取 1.3B 平台视频 URL,下载 80M 视频(10M 小时);随机采样 2.4M 视频,用 PySceneDetect 场景检测切分为 55M 片段,分别用 Qwen3-VL-2B-Instruct 生成视频描述、Audio Flamingo 3 生成音频描述;另提取 300M 场景切换关键帧并用 DeepSeek-VL2-tiny 重新描述,用于图像-文本训练。
- 数据来源与规模:从 CommonCrawl 网页爬取中提取平台视频 URL,过滤后得到 1.3B 高质量候选视频,最终成功下载约 80M 个视频、总计 10M 视频小时。视频来源覆盖 YouTube、Vimeo 和 Dailymotion,平均时长 7.7 分钟,时间跨度近二十年。
- 场景检测切分:从完整语料中随机采样约 2.4M 个视频,使用 PySceneDetect 进行场景检测,将视频切分为语义一致的片段,最终得到 55M 个视频/音频片段。这一步骤保证每个片段内部视觉内容相对连贯,适合作为对比学习的训练单元。
- 视频描述生成:使用 Qwen3-VL-2B-Instruct 对每个片段生成简短的视频描述。选择小型模型的原因是控制标注成本,使 55M 片段的标注在可接受的计算预算内完成。
- 音频描述生成:使用 Audio Flamingo 3 对同一批片段生成音频描述,形成 BVD-A-* 子集。音频描述与视频描述共享片段边界,但关注不同的信号模态。
- 帧-文本对构建:从视频中提取 300M 个场景切换关键帧,使用 DeepSeek-VL2-tiny 重新描述,形成 BVD-I-300M 图像-文本子集。关键帧选择基于场景切换点,保证帧与帧之间视觉差异较大。
- 去污染分析:论文检查了 BVD-V-55M 与 K400、MSR-VTT、MSVD 评估集的 YouTube ID 重叠,并报告去污染后检索性能变化极小,说明数据集的性能优势不是来自评估集泄漏。
逐图理解论文
规模落差与直觉
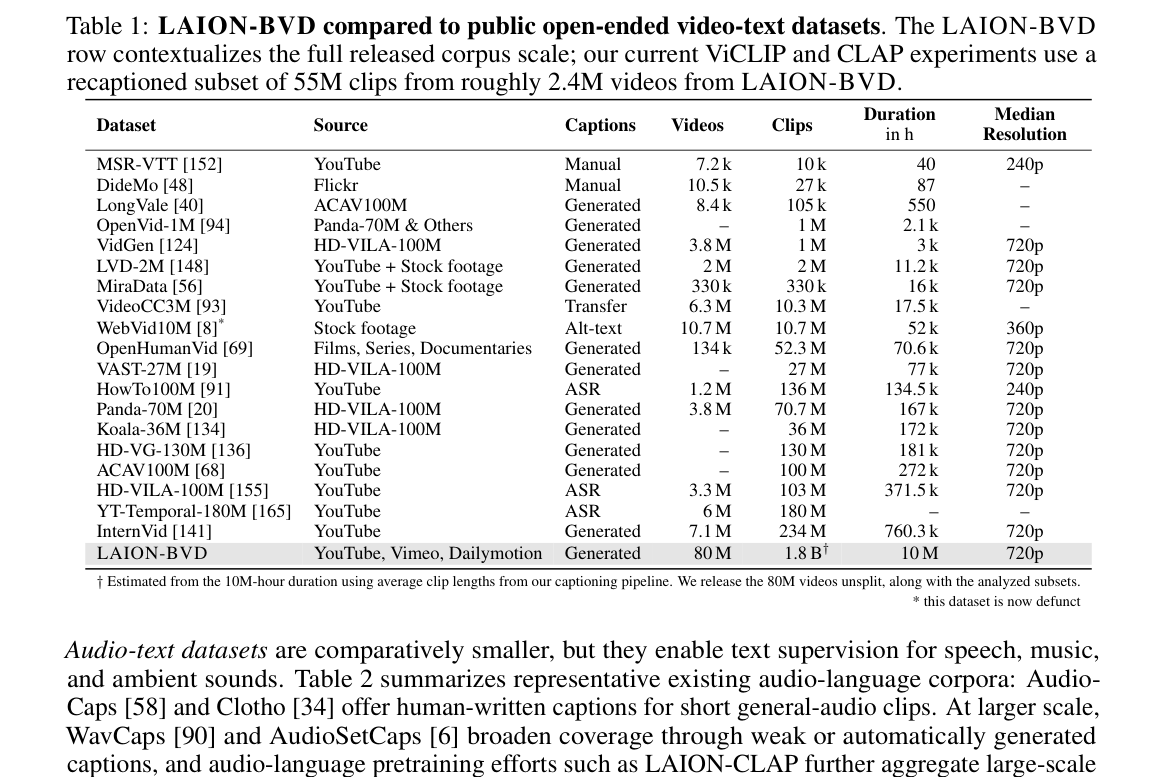
先看一个直观的落差:图像-文本数据集已经做到数十亿规模,但此前最大的公开视频数据集 InternVid 只有大约七百万个视频。视频数据难收集,平台限制多,下载和存储成本高,而且原始视频没有现成的文本描述。但视频有一个被忽视的优势——它同时包含画面和声音,理论上一个数据集可以同时服务三种预训练任务。问题在于,从来没有人用同一批开放视频数据系统验证过这一点。
研究空白
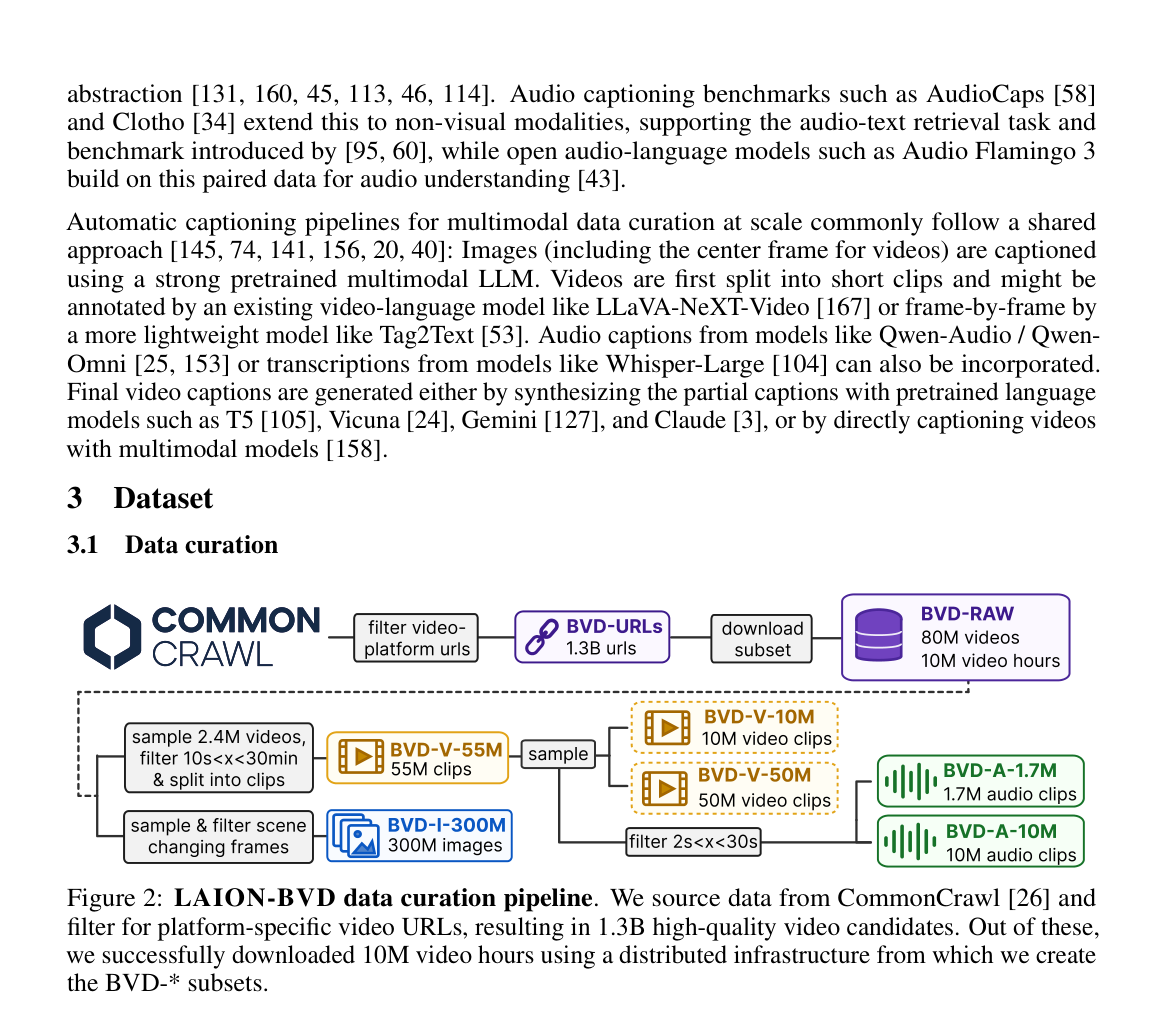
该图展示从 CommonCrawl 到最终 BVD-* 子集的完整数据策展流水线,重点观察 1.3B URL 到 10M 视频小时的过滤比例,理解大规模视频采集的工程挑战。
最强结论
最强的结论是:视频数据在视频-文本任务上超过了 InternVid,在音频-文本任务上超过了 LAION-Audio,在图像-文本检索上超过了 DataComp 和 Re-LAION。三种模态,同一个数据源,全部取得有竞争力的结果。这说明开放视频不是某个模态的替代品,而是一个被长期低估的多模态预训练资源。
意义与局限
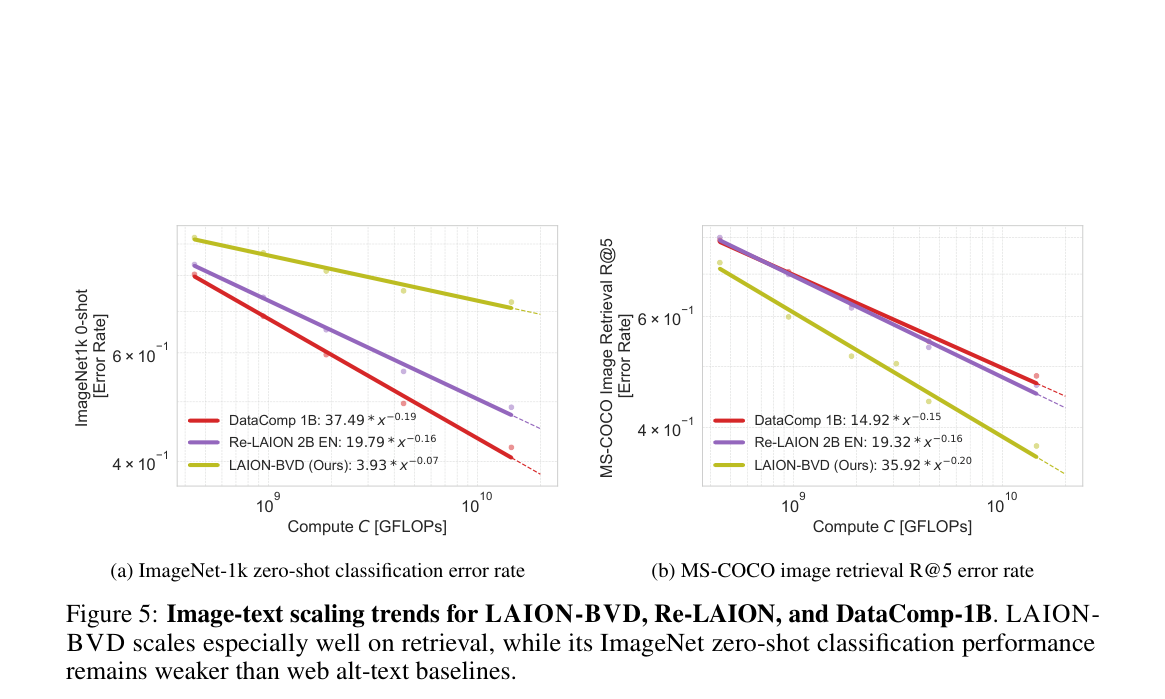
该图对比 LAION-BVD、Re-LAION 和 DataComp-1B 的图像-文本扩展趋势,重点观察检索性能随样本数增长的斜率差异,以及 ImageNet 分类曲线的相对位置,理解视频帧数据的优势与局限。
实验如何设计?
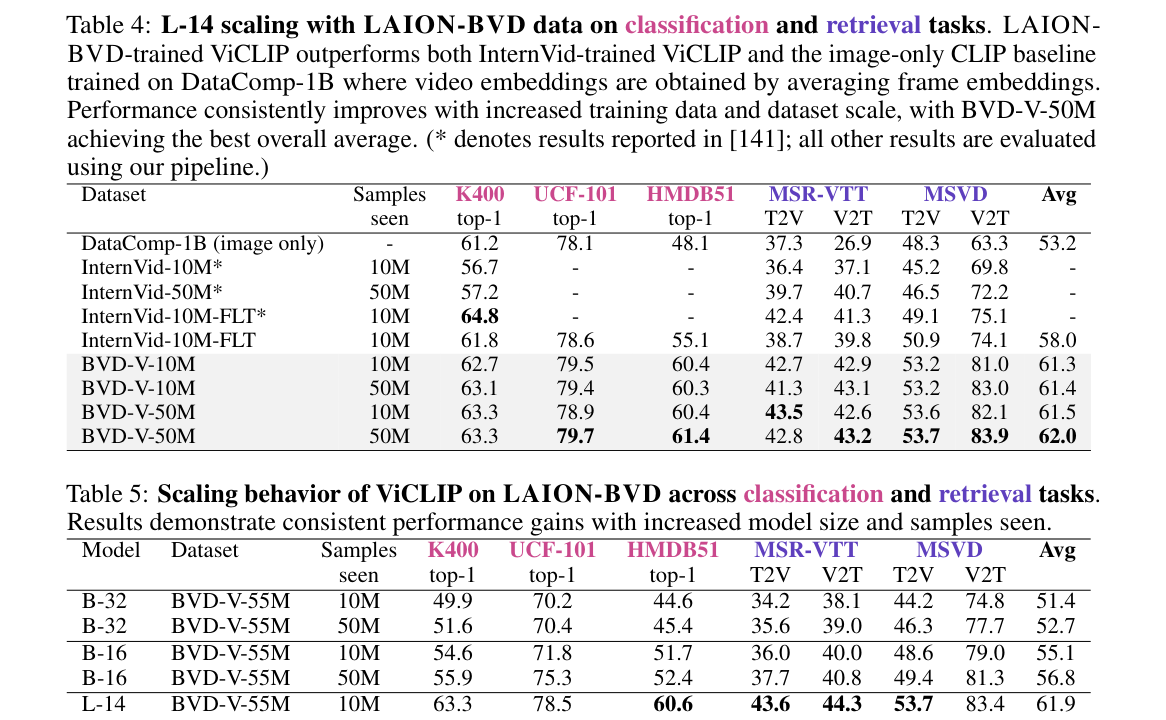
- 视频-文本实验:使用 ViCLIP 框架,在 BVD-V-10M 和 BVD-V-50M 子集上训练 L-14 模型,与 InternVid-10M-FLT 对比,评估 K400、UCF-101、HMDB51 分类和 MSR-VTT、MSVD 检索。
- 音频-文本实验:使用 CLAP 框架,在 BVD-A-1.7M 和 BVD-A-10M 上训练,与 LAION-Audio、AudioSet 对比,评估 UrbanSound8K 分类和 AudioCaps、Clotho 检索。
- 图像-文本实验:使用 CLIP ViT-B/16,在 BVD-I-300M 上训练,与 DataComp-1B、Re-LAION 对比,评估 ImageNet-1k 分类和 MS-COCO 检索。
- WiSE-FT 分析:对 ViCLIP 模型应用 checkpoint merging,比较预训练与微调 checkpoint 加权平均对性能的影响,并解释 InternVid 论文报告值与作者复现值之间的差异。
- 固定计算量对比:在 50M samples seen 的固定训练计算下,比较 BVD-V-10M 与 BVD-V-50M 的差异,用五次随机种子运行报告均值和置信区间。
关键结果与论文证据
- BVD-V-50M 在 ViCLIP L-14 上平均分 62.0,比 InternVid-10M-FLT 的 58.0 高 4.0 个百分点(Table 4, p.8);即使只看 10M samples seen,BVD-V-10M 的 61.3 也高出 3.3 个百分点。
- WiSE-FT checkpoint merging 后,BVD-V-50M 平均分提升至 62.6,BVD-V-10M 提升至 62.3(Table 6, p.9),说明权重合并对两类数据都有稳定增益。
- BVD-A-10M 在 431M 参数 CLAP 模型上平均分 46.8,超过 LAION-Audio 的 44.8,但低于加入 AudioSet 的 LA+AS 组合 56.6(Table 7, p.9);在 110M samples seen 时 BVD-A-10M 达到 48.7(Table 9, p.10)。
- BVD-I-300M 在 MS-COCO 检索上明显优于 Re-LAION 和 DataComp(T2I R@5=0.63 vs 0.53/0.52),但在 ImageNet-1k 分类上明显落后(0.28 vs 0.58/0.51)(Table 10, p.11)。
- LAION-BVD 帧与 Re-LAION 的 FID=33.92,而 Re-LAION 内部两样本 FID=0.16(p.7),说明视频帧的视觉分布与网页图像语料差异显著,两者具有互补性。
- 去污染分析显示 BVD-V-55M 与评估集的 YouTube ID 重叠率极低,移除重叠样本后 MSR-VTT 和 MSVD 检索性能变化极小(Table 15-16, p.27),排除了数据泄漏解释。
- 固定计算量下,BVD-V-50M 相比 BVD-V-10M 的增益主要集中在检索任务和 HMDB51 分类,K400 和 UCF-101 的差异在置信区间内(Table 12, p.26)。
阅读时需要注意
- 所有描述均由小型模型自动生成且刻意简短,可能引入系统性错误或偏差,且未经过人工质量审核。
- 评估仅覆盖对比式训练范式(ViCLIP/CLAP/CLIP),未验证生成式范式(如视频扩散模型或自回归多模态模型)在该数据上的表现。
- 未训练联合音视频模型,跨模态统一表征能力未得到验证。
- 数据仅经平台审核、无额外安全过滤,可能包含偏见、刻板印象或语言/地区/主题分布不均。
- BVD-I-300M 在 ImageNet 分类上明显弱于网页图像数据集,说明视频帧的合成描述与 ImageNet 类别分布对齐较弱,不适合直接替代网页 alt-text 数据做分类导向的预训练。
关联工作
- InternVid 是此前最大的公开视频-文本数据集(7.1M 视频),LAION-BVD 在规模上超过其一个数量级,并在相同训练设置下取得更好的下游性能。
- LAION-5B 和 DataComp-1B 代表大规模开放图像-文本数据集的成熟路线,LAION-BVD 的图像-文本子集在检索任务上超越它们,但在分类任务上落后,揭示了视频帧与网页图像在语义分布上的本质差异。
- LAION-CLAP 和 LAION-Audio-630K 是开放音频-文本预训练的代表性数据集,BVD-A 子集在纯数据对比中超过 LAION-Audio,但加入 AudioSet 后仍有明显差距,说明人工策展的音频数据仍不可替代。
- Panda-70M、HD-VILA-100M、ACAV100M 等大规模视频数据集在规模上与 LAION-BVD 可比或更大,但论文将其列为规模对比对象而非训练对比对象,暗示开放性和可复现性是 LAION-BVD 的差异化优势。