快速导读:Vidu S2 提出了支持实时 720p 交互数字人生成(Vidu S2-Avatar)和实时视频流编辑(Vidu S2-Editing)的模型,并探索了实时空间视频生成,在多项基准测试中优于现有基线。
Vidu S2 是 Vidu 系列视频的新一代模型,旨在解决实时交互视频生成中的分辨率、动态参考和编辑能力问题。它包含 Vidu S2-Avatar 和 Vidu S2-Editing 两个核心模块,分别针对数字人生成和视频流编辑。
该模型通过引入 Self-Replay Forcing 和轻量级 Refiner,在保持实时性的同时提升了生成质量。此外,它还支持动态参考更新和空间视频生成,为实时交互视觉内容提供了更全面的解决方案。
英文题目:Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.11638
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视频生成模型多为离线一次性生成,缺乏实时交互能力。Vidu S1 虽支持实时交互,但分辨率低、参考图固定,难以处理大幅肢体运动且不支持视频流编辑。
随着用户对实时交互视觉内容需求的增长,实时视频生成成为重要方向。Vidu S2 旨在突破这些局限,提供更高分辨率、动态参考和编辑能力。
实时视频生成面临的主要挑战包括误差累积、分辨率与实时性的平衡,以及动态参考的更新。Vidu S2 通过技术创新解决了这些问题。
此外,实时视频流编辑需要保持运动和时间同步,这对模型架构和推理效率提出了更高要求。
核心创新
- Self-Replay Forcing (SRF):一种 on-policy DMD 训练策略,通过重放自生成轨迹并保留跨块梯度流,提升长序列生成的稳定性。
- 实时 720p 生成:结合轻量级 Refiner 和高效推理基础设施(如 SageAttention, W8A8 GEMM),在保持实时性的同时提升分辨率。
- 动态参考交互:支持在视频流生成过程中随时更新参考图像(如更换服装、背景或手持物体),并通过 VLM Agent 优化提示词生成。
- 实时视频流编辑:Vidu S2-Editing 支持对输入视频流进行实时编辑,保持运动和时间同步,覆盖多种编辑任务。
- 实时空间视频生成:将单目生成或编辑结果转换为同步的左右眼视图,支持 VR 头显沉浸式体验。
方法概览
Vidu S2 包含两个主要模块:Vidu S2-Avatar 采用音频-视觉联合 Diffusion Transformer,引入 Self-Replay Forcing (SRF) 以解决自回归生成中的误差累积问题,并通过轻量级 Refiner 实现 720p 实时生成;Vidu S2-Editing 采用 DiT 架构,利用帧对齐注意力机制实现实时视频流编辑(风格迁移、虚拟试穿、主体替换、背景替换)。此外,系统集成了 VLM Agent 以增强指令遵循和参考图交互能力,并支持将单目视频转换为实时空间视频(左右眼视图)。
- Vidu S2-Avatar 采用音频-视觉联合 Diffusion Transformer,引入 Self-Replay Forcing 解决自回归生成中的误差累积问题。
- 通过轻量级 Refiner 实现 720p 实时生成,结合 SageAttention 和 W8A8 GEMM 提升推理效率。
- Vidu S2-Editing 采用 DiT 架构,利用帧对齐注意力机制实现实时视频流编辑,覆盖风格迁移、虚拟试穿等任务。
- 集成 VLM Agent 增强指令遵循和参考图交互能力,支持在视频流生成过程中随时更新参考图像。
- 支持将单目视频转换为实时空间视频,生成同步的左右眼视图,支持 VR 头显沉浸式体验。
- 数据准备阶段引入时间密集描述和专家模型,提升训练数据质量和覆盖范围。
- 推理阶段采用高效加速框架,确保实时生成和编辑的延迟满足交互需求。
- 空间视频生成模块通过深度估计和孔洞填充实现单目到立体的转换,保持视觉舒适度。
逐图理解论文
失败案例
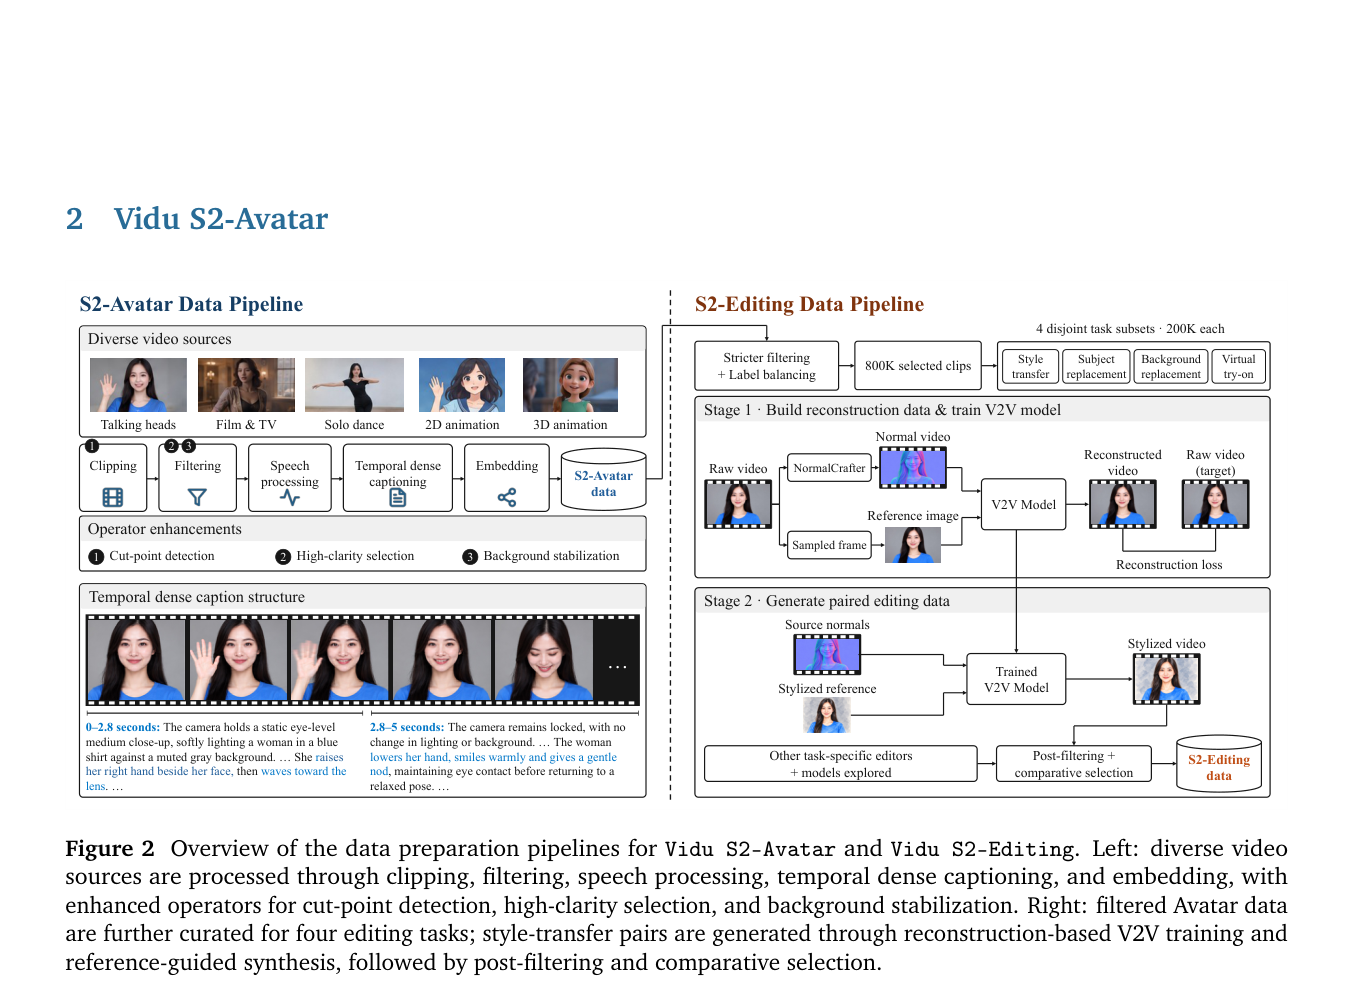
该图展示了 Vidu S2-Avatar 和 Vidu S2-Editing 的数据准备流程。需要关注数据清洗、标注和增强步骤,以理解训练数据的质量如何影响模型性能。
研究缺口
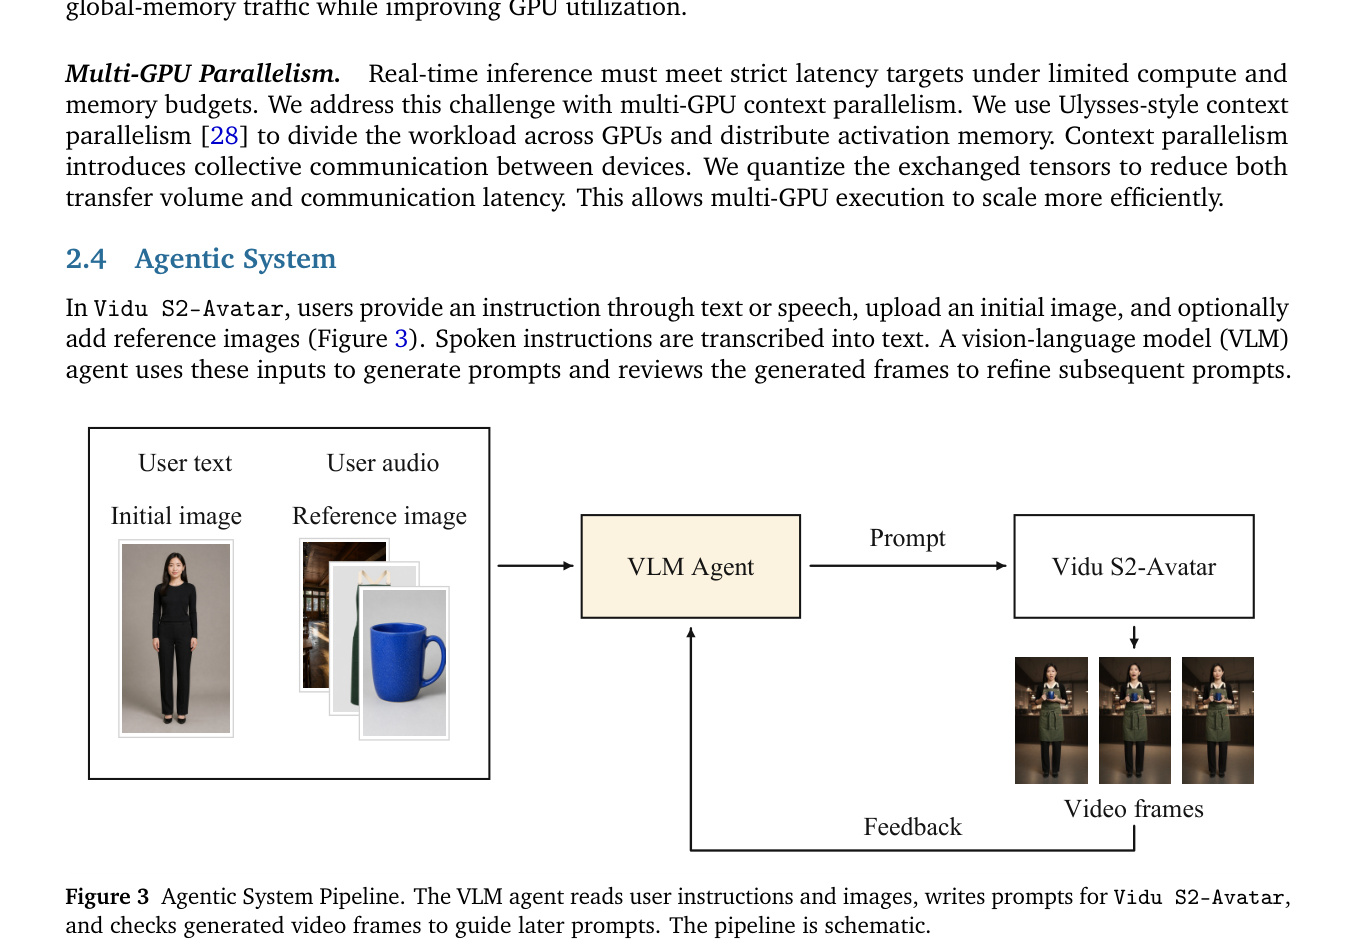
该图展示了 VLM Agent 的工作流程,包括读取用户指令、生成提示词和检查生成帧。需要关注 Agent 如何优化提示词和引导后续生成,以理解动态参考更新机制。
核心贡献
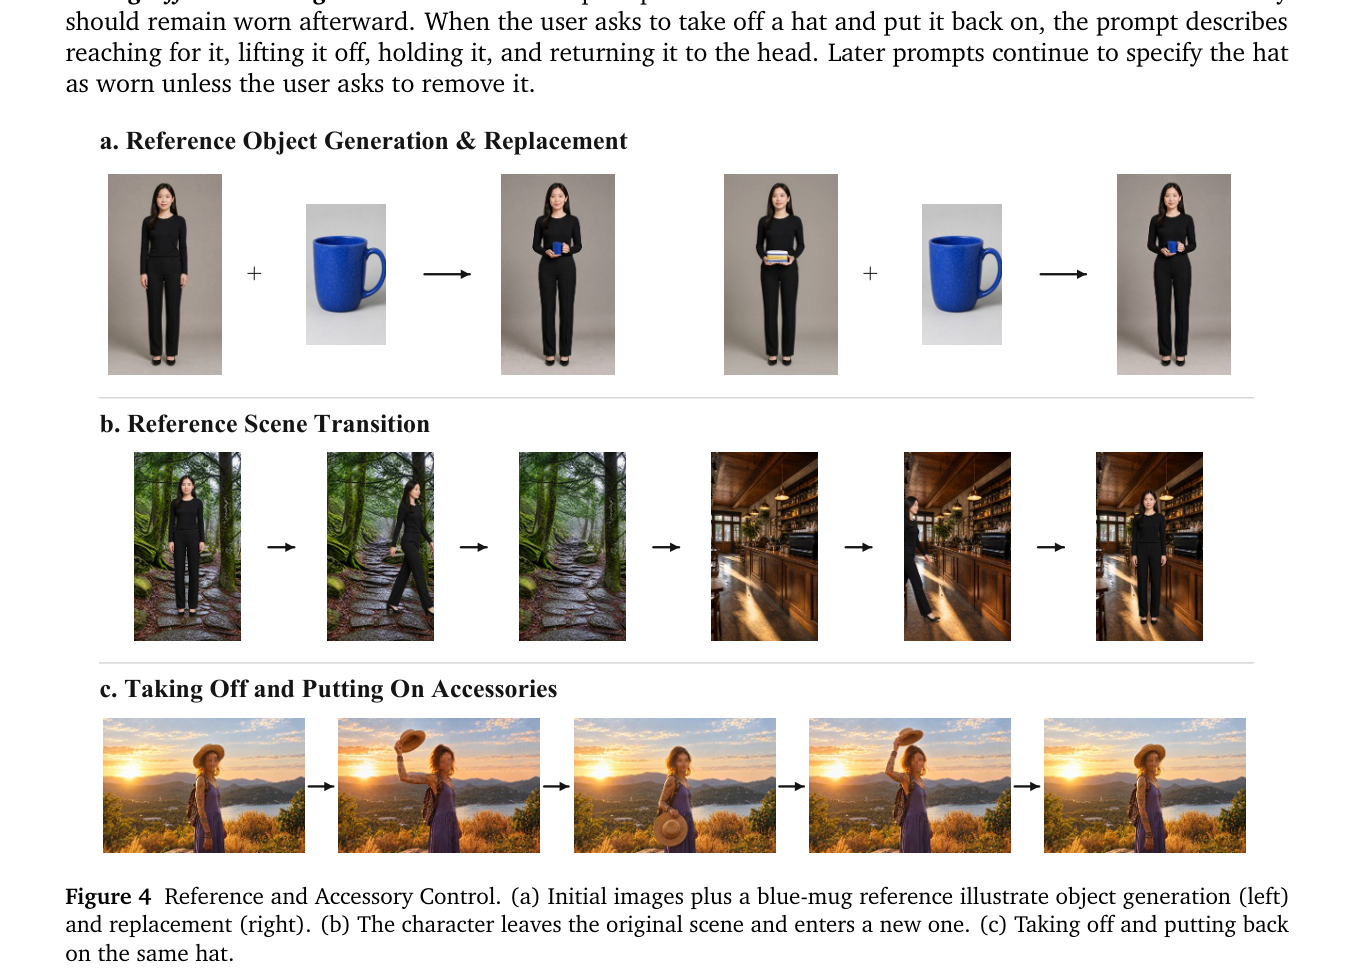
该图展示了参考和配饰控制的案例,包括物体生成、替换和场景切换。需要关注模型如何保持身份一致性和时间同步,以理解动态参考更新的效果。
最强结论
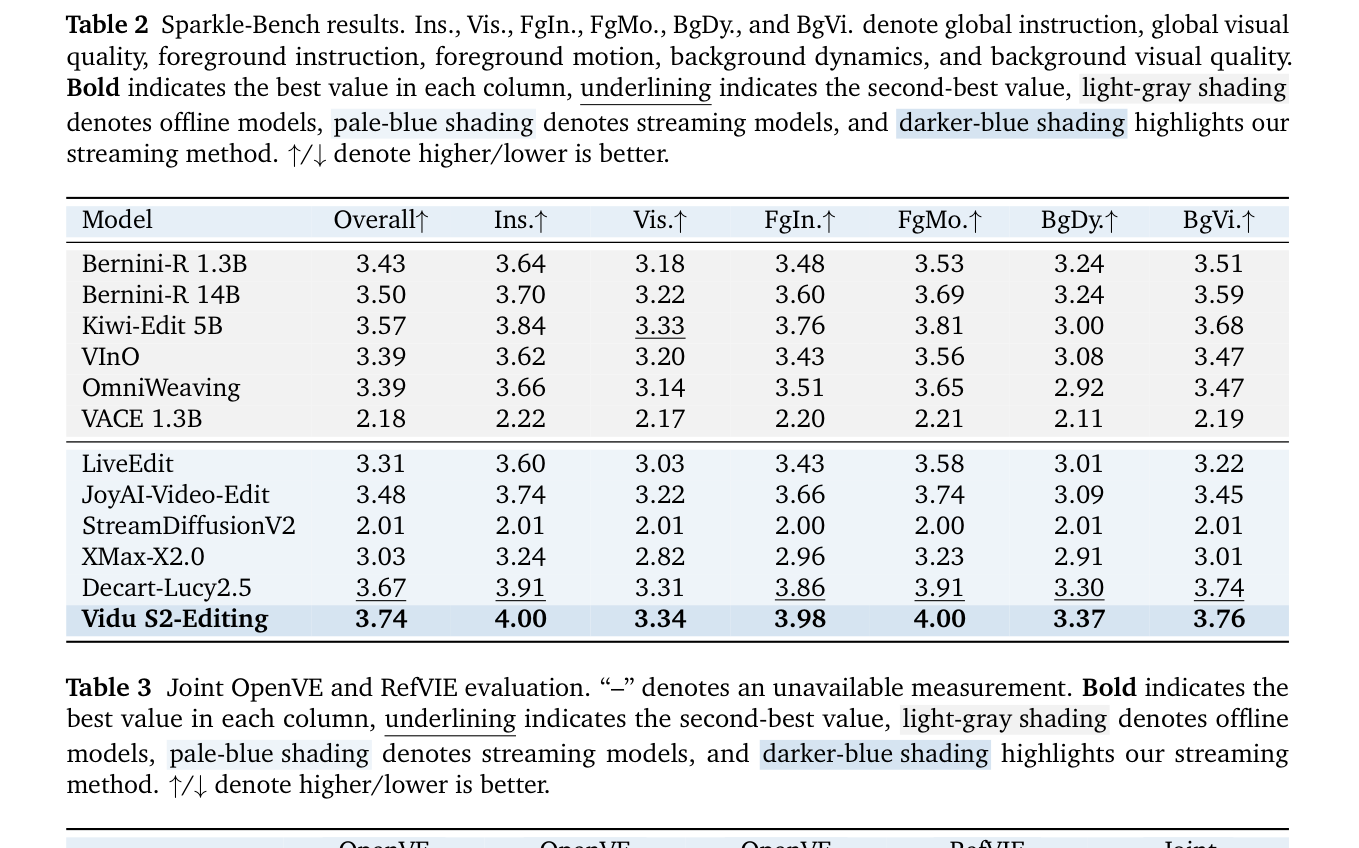
该表展示了 Vidu S2-Editing 在 Sparkle-Bench 上的评估结果。需要关注各编辑任务的具体指标和与其他基线的对比,以理解模型在视频流编辑上的性能。
意义与局限
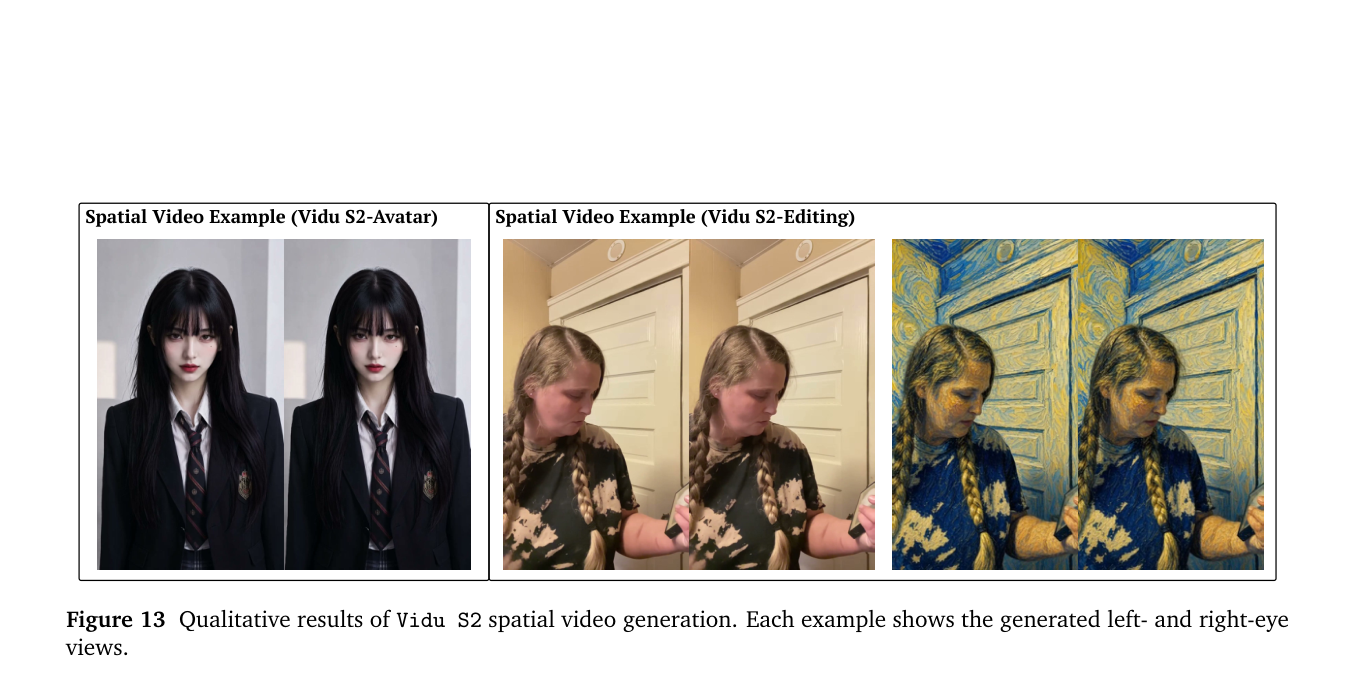
该图展示了 Vidu S2 空间视频生成的定性结果,包括左右眼视图。需要关注视图的同步性和深度信息,以理解空间视频生成的可行性和效果。
实验如何设计?
- 在 StreamAV-Bench 上评估数字人生成,Vidu S2-Avatar 在所有指标上取得最佳成绩。
- 在 Sparkle-Bench, OpenVE-Bench, RefVIE-Bench 和 ViViD 测试集上评估视频编辑,Vidu S2-Editing 在整体得分和特定任务指标上优于基线。
- 内部基准测试中,通过 GSB 人类偏好评估,Vidu S2-Avatar 和 Vidu S2-Editing 在整体质量、运动质量、一致性等方面显著优于商业系统。
- 时长分层评估显示 Vidu S2-Avatar 在 10-90 秒的长序列生成中保持高质量和一致性。
- 空间视频生成部分主要展示可行性,未提供详细的量化延迟和分辨率指标对比。
- 部分基线在 StreamAV-Bench 上部分指标缺失,可能影响全面比较。
关键结果与论文证据
- Vidu S2-Avatar 在 StreamAV-Bench 上 VA 0.687, VQ 3.370, PQ 7.138, AQ 3.286, AVAlign 0.353, AVSync 0.617, AIF 2.985, SC 0.998, BC 0.993 (p.14)。
- Vidu S2-Editing 在 Sparkle-Bench 上 Overall 3.74, Ins. 4.00, Vis. 3.34, FgIn. 3.98, FgMo. 4.00, BgDy. 3.37, BgVi. 3.76 (p.15)。
- Vidu S2-Editing 在 Joint OpenVE and RefVIE 上 Joint Overall 4.26, OpenVE Ovr. 4.42, RefVIE Ovr. 3.78 (p.15)。
- Vidu S2-Editing 在 ViViD 测试集上 VFIDI 9.9515 (p.16)。
- GSB 评估中,Vidu S2-Avatar 在整体质量上对 Runway 偏好率 85.7%,对 PixVerse 和 HeyGen 偏好率 100% (p.17)。
- GSB 评估中,Vidu S2-Editing 在整体质量上对 Decart-Lucy2.5 偏好率 72.7%,对 XMax-X2.0 偏好率 86.7% (p.17)。
- Vidu S2-Avatar 在 10-90 秒的长序列生成中保持高质量和一致性 (p.16)。
- 空间视频生成部分主要展示可行性,未提供详细的量化延迟和分辨率指标对比 (p.21)。
阅读时需要注意
- 空间视频生成需要更高的分辨率和更低的延迟以满足 VR 头显的视觉舒适度和同步要求,目前仍面临技术挑战。
- 实时空间视频编辑在单目输入转换和立体输入联合编辑中,对深度估计和孔洞填充的实时性要求较高。
- 虽然支持动态参考更新,但复杂场景下的多对象交互和长程依赖关系可能仍受限于模型容量和推理速度。
- 论文中部分基线在 StreamAV-Bench 上部分指标缺失,可能影响全面比较。
- GSB 人类偏好评估基于内部基准,样本量和评估者数量可能影响结果的泛化性。
- 空间视频生成部分主要展示可行性,未提供详细的量化延迟和分辨率指标对比。
关联工作
- Vidu S1 是前代模型,Vidu S2 在其基础上提升了分辨率、动态参考和编辑能力 (p.2)。
- Self-Forcing 是 Vidu S2 的 SRF 方法的基础,解决了自回归生成中的误差累积问题 (p.2)。
- Diffusion Forcing 是 SRF 中用于重噪声自生成轨迹的方法 (p.2)。
- TurboDiffusion 和 TurboServe 是 Vidu S1 和 S2 使用的推理加速框架 (p.2)。
- StreamAV-Bench 是用于评估数字人生成的公开基准 (p.13)。
- Sparkle-Bench, OpenVE-Bench, RefVIE-Bench, ViViD 是用于评估视频编辑的公开基准 (p.13)。