快速导读:本文提出跨模态注意力在图像频率域上充当任务条件滤波器,发现冗长提示通过拓宽该滤波器的频率支持范围,显著降低了视觉-语言模型在图像损坏下的预测漂移方差。
视觉-语言模型(VLM)在模糊、JPEG 压缩、噪声等图像损坏下容易发生答案漂移,而现有鲁棒性研究多把模型当黑盒,提示敏感性文献又常把冗长措辞当成需要消除的噪声。本文指出:问题怎么问会以相反方向改写跨模态注意力在图像频率域上的支持范围——礼貌性冗长拓宽滤波器,细粒度语义复杂度则收窄滤波器。
作者把跨模态注意力投影到径向傅里叶域得到任务条件滤波器 Wt(ω),再与损坏频谱 ΔF(ω) 做内积,形成无参数重叠定律。框架在 Qwen3-VL-2B/8B 与 LLaVA-OneVision-0.5B、GQA 与 CLEVR 上验证:冗长改写降低漂移方差,并把“把提示垫长”重新解释为鲁棒性配方。
英文题目:Cross-Modal Attention Acts as a Frequency Filter: Why Verbose Prompts Improve Robustness in Vision–Language Models
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-20139.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLM 已进入助盲描述、放射流程、文档理解和具身智能等关键路径,但输入很少是干净实验室图像。电话快照、扫描件和低分辨率视频会显著扰动视觉识别器,而模型在损坏下往往静默失败,同时继承组合推理上的脆弱性。
频率域工作表明卷积视觉系统依赖高频细节,跨模态注意力可视化则展示语言流看向哪些图像位置,但二者都很少追问:指定任务的提示会不会改变模型使用的空间尺度,从而在行为测试之前预测某一任务-损坏组合会失败到什么程度。
提示敏感性研究(Sclar et al., 2024; Mizrahi et al., 2024)发现语义等价改写会大幅改变输出,却把冗长当作要抑制的扰动。若不把语义复杂度与提示长度拆开,实验里出现“多写几个字有时更好、有时更差”的符号冲突就难以解释。
因此需要在同一张图上拆开推理粒度与措辞长度,并用只依赖内部注意力频谱的预测器,在行为测试前估计任务-损坏风险。
核心创新
- 首次将跨模态注意力解释为任务条件的频率滤波器,并证明其形状受提示词措辞动态控制。
- 提出“重叠定律”,利用模型内部注意力频谱无参数预测扰动敏感度。
- 通过镜像设计分离出两个相反效应:语义复杂度收窄滤波器(增加脆弱性),而提示冗长拓宽滤波器(增加鲁棒性)。
- 发现解码器中滤波器带宽的四阶段轨迹:长度先验、早期层先验擦除、中层语义收窄、深层冗长拓宽。
- 重新解释高频噪声假设:由于滤波器在最高频带仅占3-5%质量,高频扰动实际造成的漂移最小。
方法概览
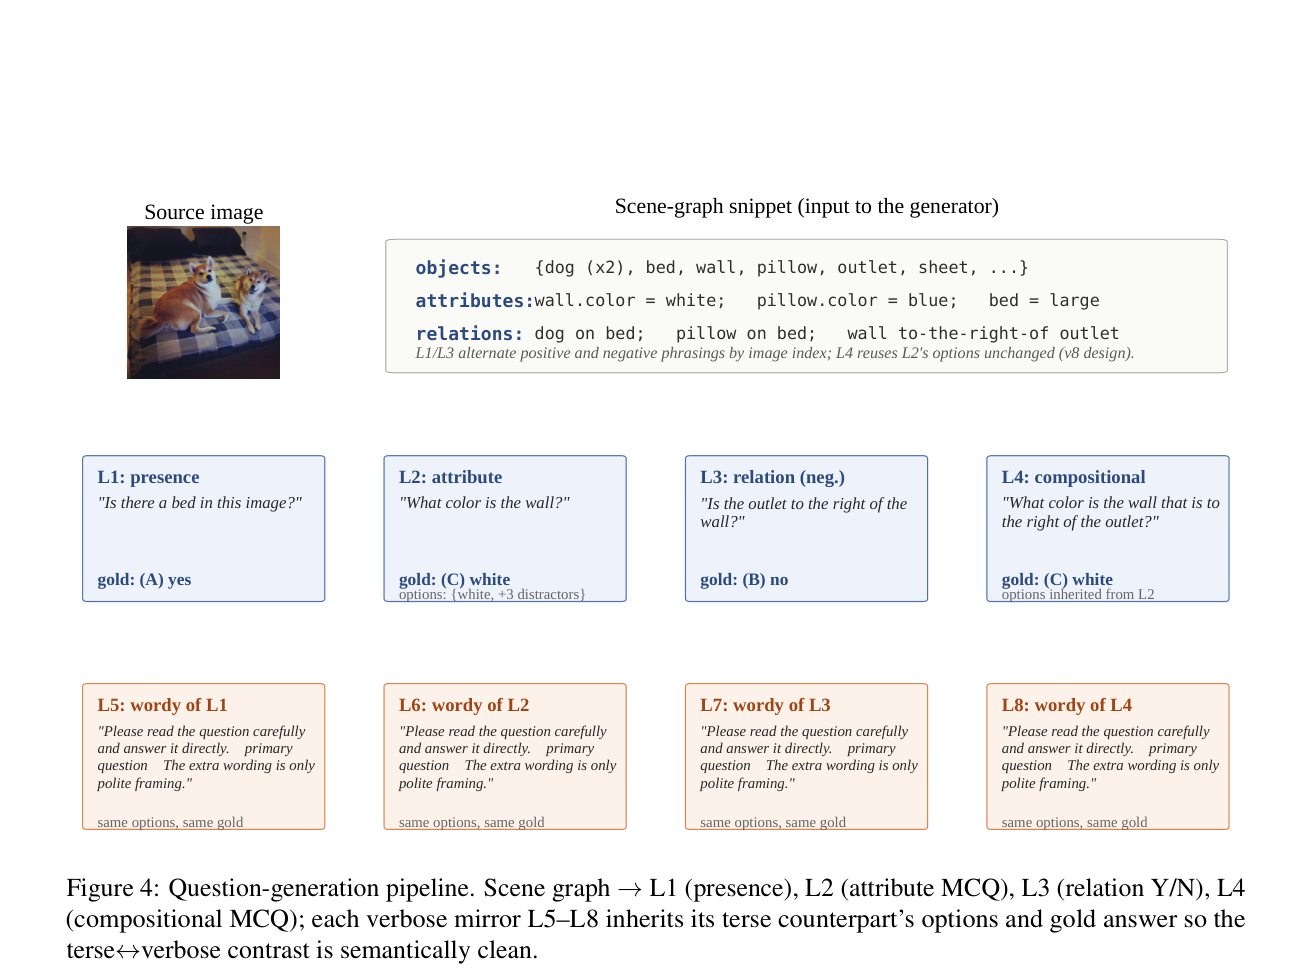
1. 任务条件滤波器 $W_t(\omega)$:将跨模态注意力图投影到2D傅里叶域,径向分箱并L1归一化,得到模型关注的视觉频率分布。2. 扰动频谱签名 $\Delta F(\omega)$:计算损坏图像与原始图像差异的径向功率谱。3. 重叠定律:预测漂移由 $W_t(\omega)$ 与 $\Delta F(\omega)$ 的内积决定。4. 8级镜像设计:构建语义内容相同但措辞长度不同的提示对(简洁 vs 冗长),分离语义复杂度与提示长度的影响。5. 回归分析:使用固定效应回归分离语义复杂度($C_{sem}$)和提示长度($C_{prompt}$)对波动率(Volatility)的影响。
- 任务条件滤波器:将查询到视觉 token 的跨模态注意力按头与文本位置平均,做二维 DFT 后径向分箱并 L1 归一化,得到 Wt(ω)。GQA 的 12×16 patch 网格上 B=7,CLEVR 上 B=9;低频对应粗布局,高频对应细局部。默认用倒数第二层 last_2。
- 带宽用 Inverse Participation Ratio:G(t)=1/Σ Wt(ω)^2。扰动签名 ΔF(ω) 是损坏图与原图灰度差的径向功率谱,与模型无关。重叠定律以 Spred=⟨Wt,ΔF⟩ 预测格子内波动率 Vol=E[|Δ_t|]。
- Csem 统计实体、属性、关系、算子、程序深度与指称歧义;Cprompt 是去停用词后的内容 token 数。二者在自然问句中相关,故用 Frisch–Waugh–Lovell 残差化得到 Cres,再在图像固定效应回归中分离斜率。
- 主结局选波动率而非有符号漂移,因为冗长镜像在干净图上金标准 log p 通常更高,绝对漂移会被天花板效应误导。
- 八级镜像在同一张图上给出 L1–L4 简洁题(存在、属性 MCQ、空间关系、组合 MCQ)与 L5–L8 冗长镜像:语义原子逐字节保留,只加礼貌框架。L4 复用 L2 选项与金标准以隔离关系算子。模板消融表明:等长但加入物体、属性、区域等额外视觉概念的包装不会带来同样的稳定,真正起作用的是非语义语言支持。
逐图理解论文
失败直觉
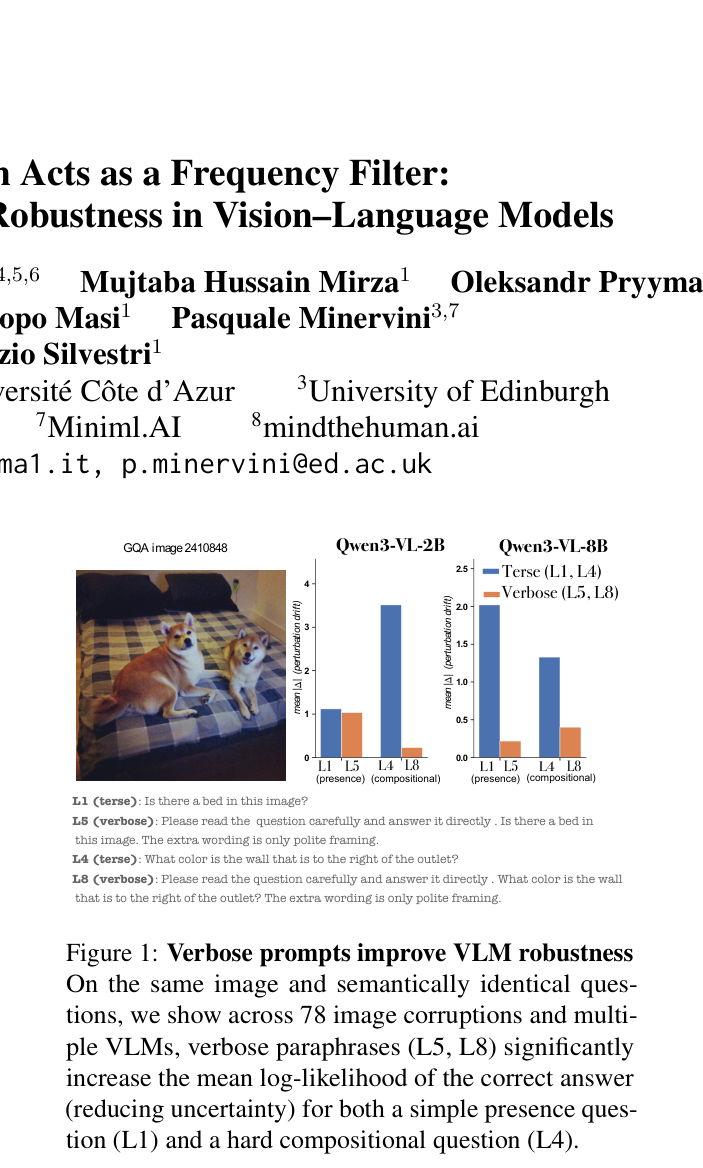
同一张 GQA 图对照简洁题与冗长镜像:左侧柴犬场景,右侧 Qwen3-VL-2B/8B 在 78 种损坏上的平均漂移柱。蓝色 L1/L4、橙色 L5/L8;注意组合题 L4 在 2B 上最高,L8 大幅回落,且图注强调只改礼貌措辞。
研究缺口
提示敏感性研究通常把冗长当成噪声,又没有把语义复杂度与措辞长度拆开,因此无法解释为何多写几个字有时更稳、有时更脆。
关键机制
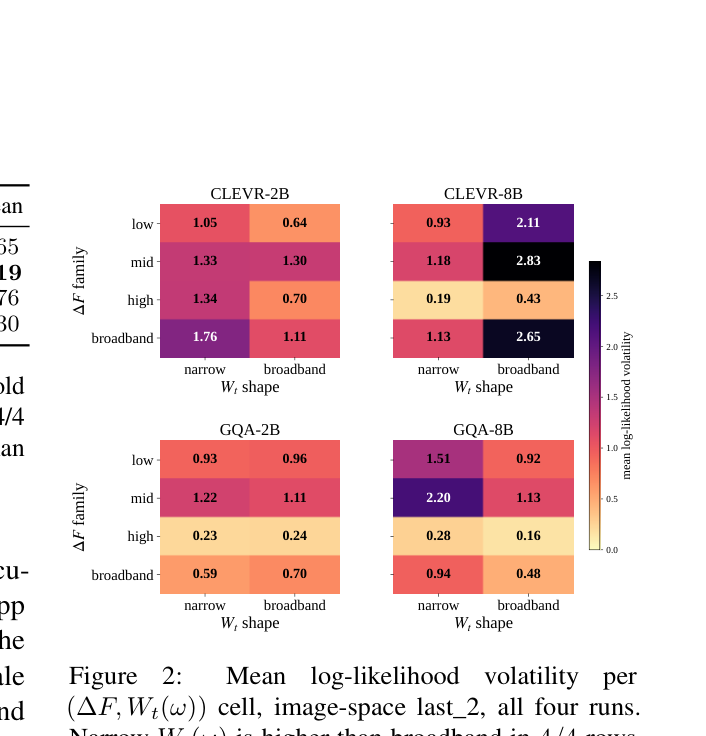
四张热图给出 last_2 上 (ΔF 族 × Wt 形状) 的平均波动率。CLEVR-2B 与 GQA-8B 多为窄带更高;CLEVR-8B 因天花板效应反转。高频行普遍最浅,与高端质量仅 3-5% 一致。
核心结论
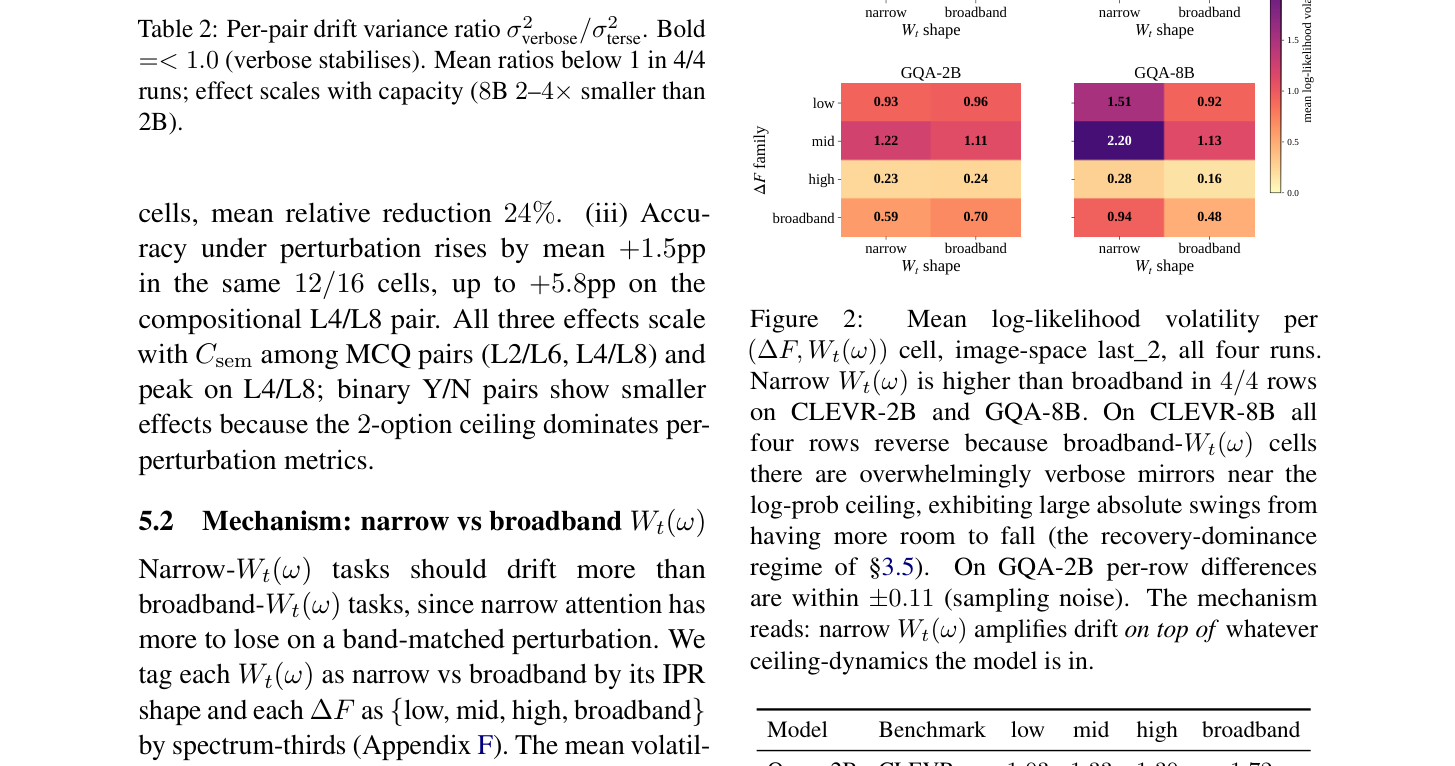
Table 2 给出镜像对的漂移方差比,加粗表示小于 1。8B 上 GQA 平均 0.30、CLEVR 平均 0.19。同页裁剪常叠上 Figure 2 的 GQA 热图,颜色是平均波动率而不是方差比。
实验如何设计?
- 扰动库含几何、光度、遮挡、频谱四类算子,每图 78 个切片。主实验为 {Qwen3-VL-2B-Instruct, Qwen3-VL-8B-Instruct} × {CLEVR, GQA},每格 500 张图,共 312,000 条评分行。
- 计分隐藏选项字母,对选项值做 token 求和对数概率;漂移是干净图与损坏图金标准 log p 之差,波动率对其绝对值取期望。
- 图像内固定效应回归报告 z-score 偏斜率;机制分析按 IPR 把 Wt 标成窄带/宽带,按频谱三分位标记 ΔF,并沿解码器层追踪 G(t)。
- 跨架构核验在 LLaVA-OneVision-0.5B 上重复带宽轨迹、重叠定律、高频截止与边际复杂度效应,并做提示模板消融。
关键结果与论文证据
- 在 8B 模型上,冗长提示将漂移方差降低 70-81%(GQA 平均方差比 0.30,CLEVR 平均 0.19)(第 2 页,Table 2)。
- 干净图像上,冗长改写使金标准答案对数似然中位数提高 11 nats,金标准与最佳干扰项边际扩大约 5 nats,属于判别变锐而非校准平移(第 2 页)。
- 固定效应回归中 β̃_Cres > 0 且 β̃_Cprompt < 0,语义复杂度增加波动、提示长度降低波动,在 4/4 次运行中显著(第 6 页,Table 1)。
- 重叠定律分组 Pearson r 介于 0.26 至 0.42,全部 12 个(运行,聚合尺度)单元格为正;LLaVA-OneVision-0.5B 上分组 r=+0.343(第 8 页,Table 5)。
- 滤波器 Wt(ω) 在最高频带仅携带 3-5% 质量,解释了高频扰动造成最小漂移的现象(第 7 页,Figure 6)。
- 四阶段轨迹在 4/4 次运行成立:长度先验、早期擦除、中层语义收窄、深层冗长拓宽;峰值深度随容量从 2B 的 last_2 移到 8B 约第 16 层(第 8 页,Figure 3)。
阅读时需要注意
- 主结果集中在 Qwen3-VL-2B/8B 与一次 LLaVA-OneVision-0.5B 核验,跨更多模型家族的证据仍然有限。
- 有符号漂移等部分效应只在 8B 上清晰;2B 上存在采样噪声或天花板效应干扰。
- 冗长镜像是程序生成模板,尚未用人类判断的自然改写做对照。
- L4 相对 L1 的效应量为中等(Cohen's d 在 0.45-0.77)。
- Wt(ω) 读自注意力分数,只是因果滤波器的相关性下界,不是直接因果证明。
关联工作
- Yin et al. (2019)、Wang et al. (2020) 指出 CNN 依赖高频细节;本文把频率视角接到 VLM 的提示条件跨模态注意力,并用更细的四带划分说明旧文献的“高频”多落在本文的中频。
- Sclar et al. (2024)、Mizrahi et al. (2024) 把冗长视为提示噪声;镜像设计在题目级给出相反符号,并把防御机制定位到深层滤波器形状。
- Cao et al. (2020)、Frank et al. (2021) 可视化跨模态注意力空间落点;本文将其投影到径向傅里叶基,使无参数行为预测成为可能。
- Hudson and Manning (2019) 的 GQA 与 Johnson et al. (2017) 的 CLEVR 提供组合推理程序与场景图,被用来构造 Csem,并支撑八级镜像的语义对齐。