快速导读:把微调后的 Prithvi-EO-2.0(300M)冻成任务老师,给未标注 Sentinel-2 写监督并蒸馏进 EfficientViT-B0(0.7M);N=2500 时学生水 IoU 0.787 对老师 0.822,INT8 引擎在 Jetson Xavier NX 上 5.57 ms/512²。
地球观测地基模型可以把洪水范围画得很好,却很难塞进救灾现场那些内存很紧的板子。Fraunhofer HHI 的这篇工作把已经在 Sen1Floods11 的 252 张人工景上调好的 Prithvi-EO-2.0(300M)冻住当任务老师,让它去给 GDACS 洪水事件周边的未标注 Sentinel-2 写监督,再跨架构蒸馏进 EfficientViT-B0(0.7M)。人工标注预算固定,训练集却可以长。代码与伪标签池标识在 https://github.com/sycz00/FloodDistill。
匹配的 252 景预算下,老师监督与直接用人标训练有竞争力,并在所测组合上抬高 STURM-Flood;几何对齐对照说明这不完全是“伪标签更好”。把老师监督池扩到 2500 张后,浮点学生在 Sen1Floods11 测试上水 IoU 0.787,老师是 0.822;在作者的 STURM 协议下与老师对齐,WorldFloods-v2 仍低于老师。ReLU6 重训加量化感知训练后,INT8 TensorRT 引擎 1.5MB,Jetson Xavier NX 上 512×512 的 GPU 计算 5.57 毫秒,运行显存约 14MB。两个干净外部基准上,固定阈值 MNDWI 同样有竞争力,所以那两套分数被当成泛化检查,而不是学习模型胜过光谱规则。
英文题目:Cross-Architecture Foundation-Model Distillation for Edge Flood Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2609.20441
原始论文:PDF / 论文页面
这篇论文解决什么问题?
及时的淹没范围图能支持撤离路线、损失评估和救援物流。卫星分割提供不依赖水动力假设的观测。Sentinel-1 穿云,Sentinel-2 有更富光谱;Prithvi 预训练用 HLS 六波段,本文全程同一输入。云遮事件的近实时获取被明确留作未来工作。
部署才是缺口。300M 的 FP32 ViT 不适合内存紧的嵌入式目标;INT8 小模型更现实。Φ-sat 等任务已经在演示星上推理,但研究里最准的模型与现场能跑的模型之间,针对洪水分割仍少人量过。
蒸馏是通路,数据却卡着:Sen1Floods11 训练只有 252 张人工景。直接在这集上训小模型,监督的地理范围被锁死。已经适应任务的老师可以把监督涂到更多未标注影像上——作者从 GDACS 橙/红警报检索 Sentinel-2,不再要新的人工框。
解释必须收窄。合成增益、霾和分波段扰动只当诊断。两套训练源在采集几何上也不一样。因为 MNDWI 在两个外部基准上有竞争力,外部精度只证明紧凑模型能泛化,不证明它优于光谱指数。
核心创新
- 标注预算放大:在同为 252 景时,老师监督可替代直接用人工掩膜训练,并在所测架构-目标组合上抬高 STURM;几何对齐对照表明不能把差值全算到标签来源。
- 突破人工集上限:老师监督可无新标注扩到 N=2500,缩小与老师的分布内水 IoU 差距,并在作者协议下对齐 STURM mIoU,WorldFloods-v2 仍落后。
- 高压缩边缘部署:ReLU6+QAT 得到 1.5MB INT8 TensorRT 引擎,Xavier NX 上 5.57 ms/512²、约 14MB 运行显存,参数量约压缩 430×。
方法概览
四段管线。老师是公开 Hugging Face 检查点 Prithvi-EO-2.0-300M-TL-Sen1Floods11,不再微调;S11 测试上作者测到 0.897 mIoU / 0.822 water IoU。对 GDACS 橙/红警报周围下载 Sentinel-2 L1C 瓦片(事件窗+灾前基线),老师写 argmax 硬掩膜、置信图和 15 维光谱+老师描述子,池中约 23,720 张未标注瓦片。质量预过滤后用最远点采样在特征流形上选多样子集。学生 EfficientViT-B0 四阶段(图中通道 16/32/64/128),各阶段 1×1 卷积+上采样+预测头,用老师伪标签监督四路 OFA 损失;推理丢掉辅助头。硬目标在伪标签设定下是老师 argmax,软目标训练时由冻结老师对增强后图像现场推断。部署:Hardswish 在 TensorRT 8.4 逐张量 INT8 下不可用,故 ReLU6 从零重训再 QAT(W8A8,logits 保持浮点,BN 冻结),LiteMLA MatMul 留 FP16,在 Jetson Xavier NX(JetPack 5.0, TensorRT 8.4)编成静态 1×6×512×512 引擎。
- 老师。使用官方 IBM/NASA Prithvi-EO-2.0-300M-TL-Sen1Floods11,不再微调。作者在 S11 测试上测到 0.897 mIoU、0.822 water IoU,对照原检查点报告的 0.900 / 0.826。此后老师只做推理。ViT-L:14×14 patch、224×224、24 块、宽 1024、16 头,特征取自块 6/12/18/24,接 UPerNet(256 通道、两类)。
- 伪标签池。约 23,720 张 GDACS Sentinel-2 瓦片。每个地点两景:事件窗内与灾前基线,供后文老师语义审计。每张只存硬掩膜、置信图和 15 维描述子;软目标不入库,学生训练时对增强图像做一次冻结老师前向。
- 多样性策展。质量预过滤后,在光谱+老师描述子嵌入的特征流形上最远点采样,去掉冗余、拉开覆盖,得到策展子集。部署操作点 N=2500。
- OFA 学生。EfficientViT-B0 四阶段(图 1 通道 16/32/64/128)。每阶段辅助支路:1×1 卷积 → 上采样 → 预测头 → OFA 损失,拟合老师最终输出而不是中间特征。推理去掉辅助头,参数回到普通 B0。硬目标在伪标签设定下是老师 argmax,在 S11 设定下是人工掩膜;两设定共享老师、目标、架构和 252 景标注出处,差别是影像与硬标签来源。
- 部署。标准 Hardswish 在 TensorRT 8.4 逐张量 INT8 下动态范围恶化。作者用同一伪标签集从零训 ReLU6,再做 W8A8 QAT:QDQ 打在卷积输入与权重、不打在输出,logits 保持浮点;QAT 期间冻结 BN。LiteMLA 的 MatMul 留 FP16。在 Xavier NX 本机编成静态 1×6×512×512 引擎。
- 预处理。六波段反射率按 S11 训练集 μ/σ 标准化。训练缩到 224×224,评测 512×512(STURM 从原生 128 上采样)。增强为二面体翻转加每通道乘性抖动 [0.80,1.20]。
逐图理解论文
研究缺口
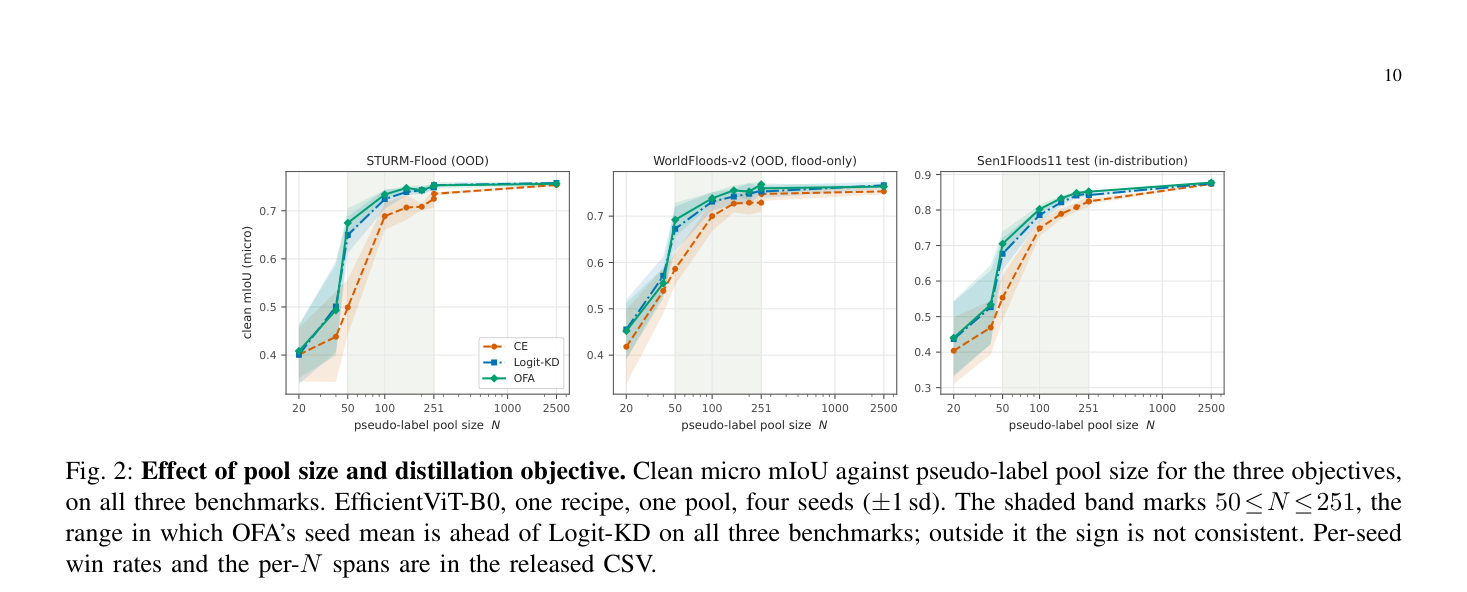
第 10 页三张折线:STURM、WorldFloods-v2、Sen1Floods11。横轴伪标签池 N(20 到 2500),纵轴 clean micro mIoU。橙 CE、虚橙 Logit-KD、青绿 OFA,带 ±1 sd。灰绿阴影 50≤N≤251,作者说这是 OFA 种子均值在三套基准上都领先 Logit-KD 的区间。先看共同的上升-变平,再看阴影带内外符号是否一致。
方法贡献
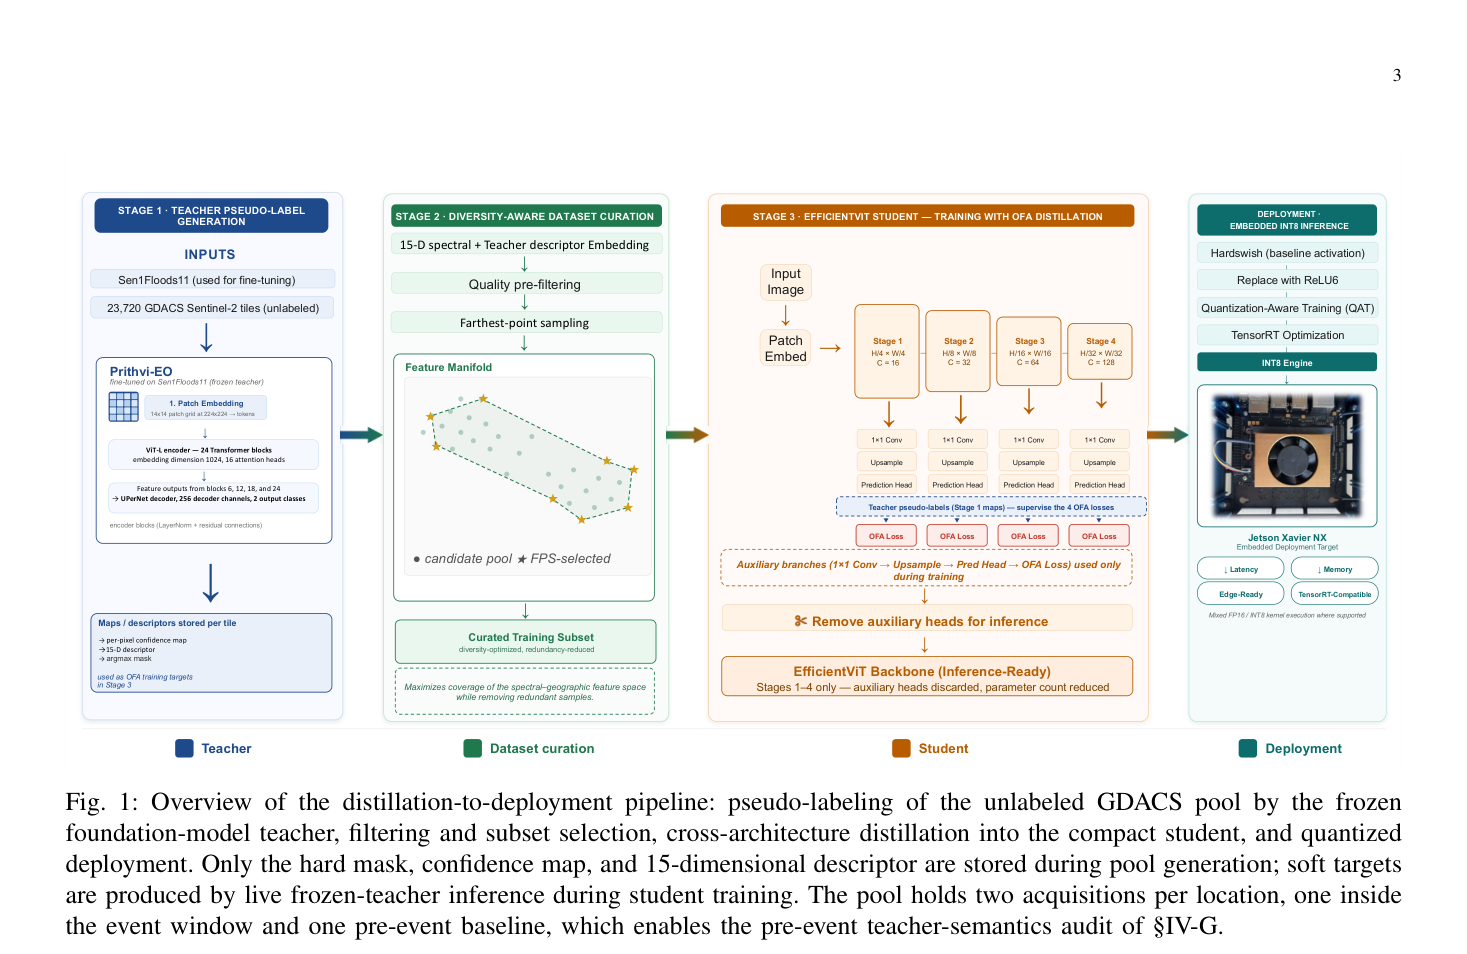
第 3 页四段管线,不要和图 1 的正文裁切 p003-02 搞混。蓝:老师伪标签,23,720 张 GDACS 瓦片进冻结 Prithvi(patch embedding、ViT-L 24 块、UPerNet),每张存掩膜/置信/15 维描述子。绿:质量过滤与最远点采样,流形上圆点候选、星号入选。橙:EfficientViT 四阶段与四路训练专用 OFA 头,推理去掉。青:Hardswish→ReLU6→QAT→TensorRT,右下 Jetson Xavier NX 照片。从左到右读阶段,再看学生块里“仅训练时使用”的辅助头。
关键机制
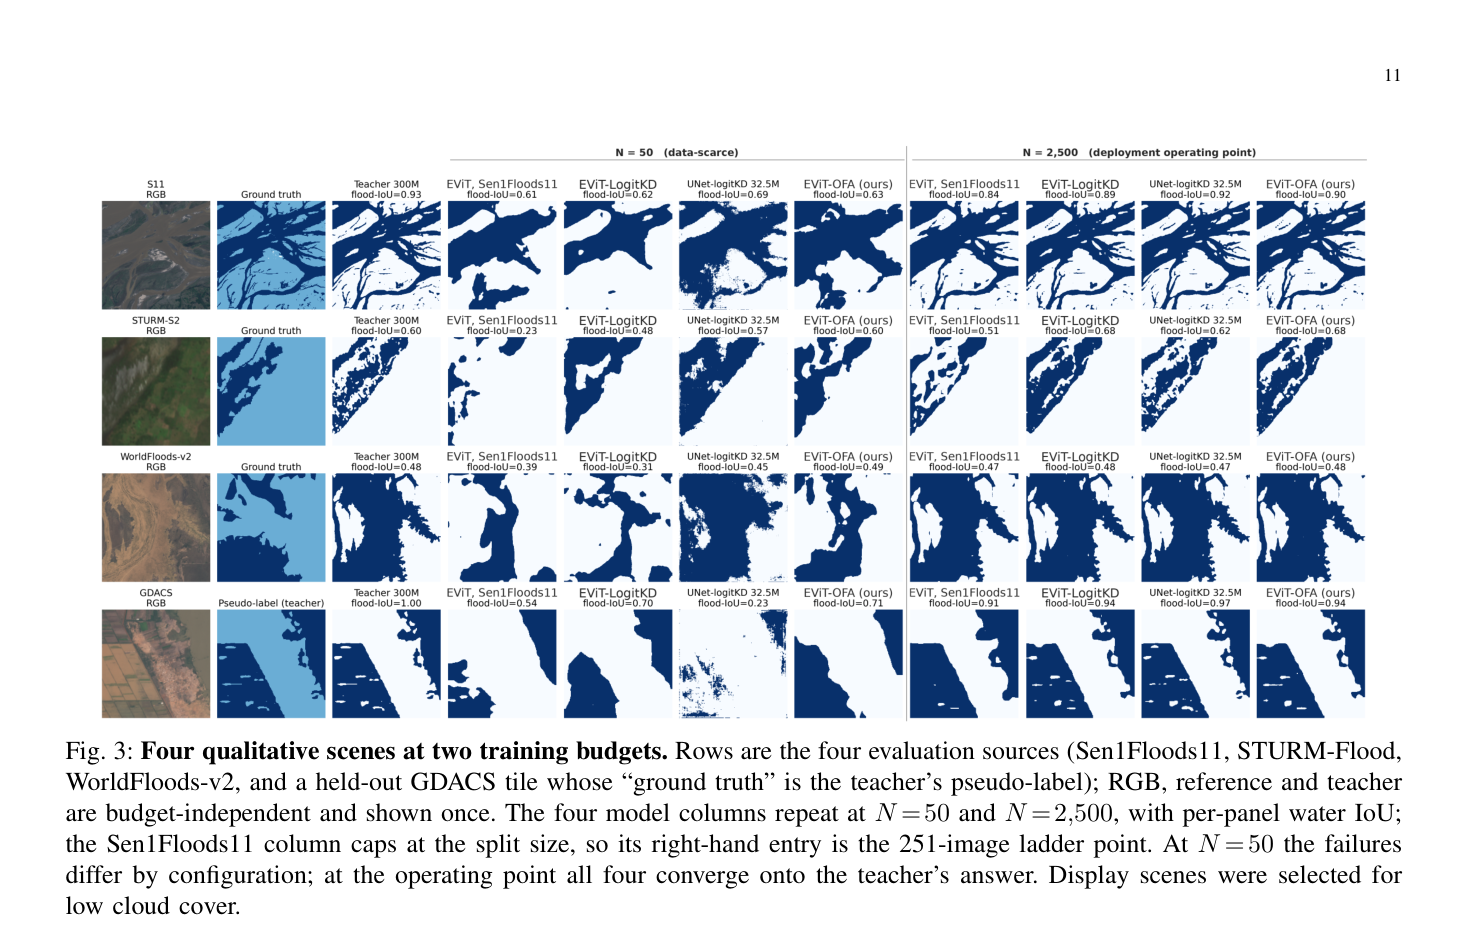
第 11 页四行场景:S11、STURM、WorldFloods、持出 GDACS(其参考是老师伪标签)。左三列 RGB/参考/老师只显示一次;随后模型列在 N=50 与 N=2500 重复,每格有 water IoU。N=50 失败模式各异,操作点上四列都靠向老师。S11 右列实际是 251 张的梯子点。展示景低云,不能当成含云鲁棒性。
实验证据
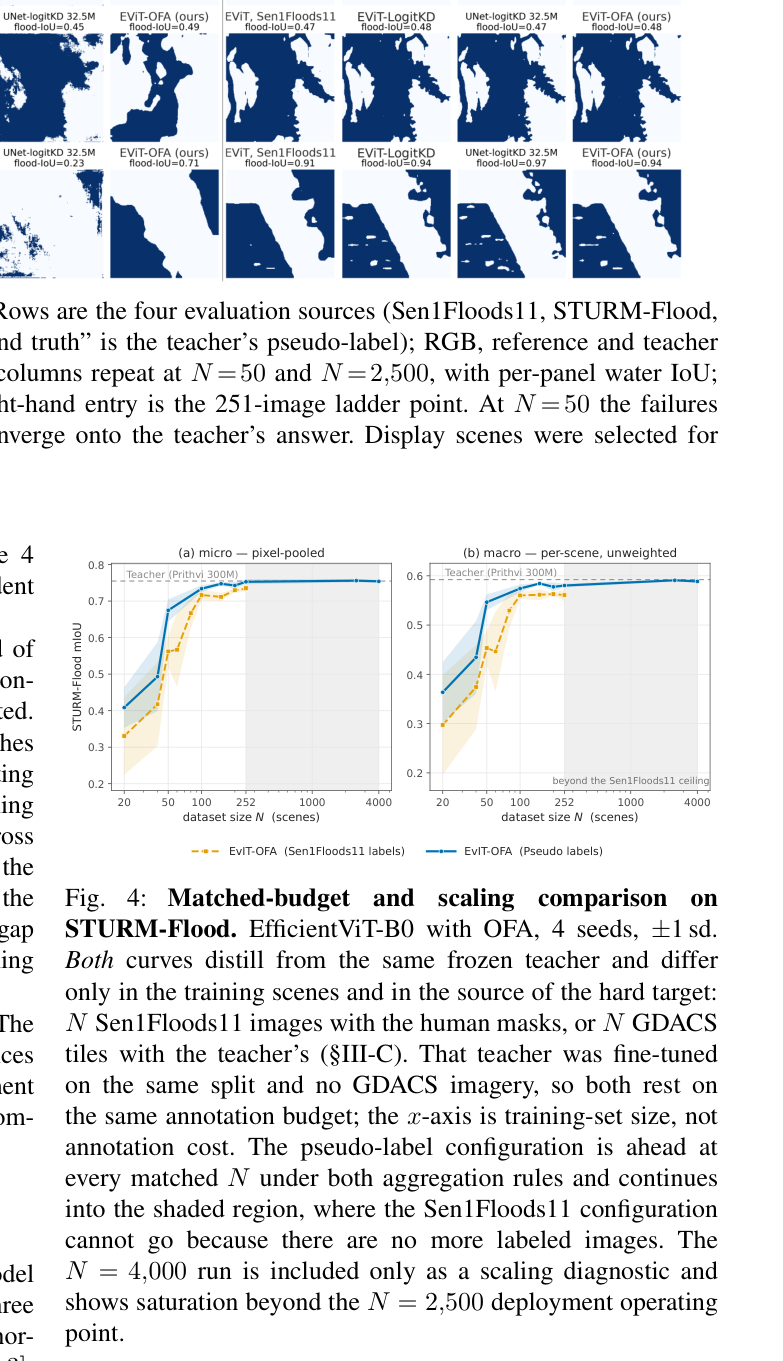
文件是图 4,上沿却残留图 3 的蓝色掩膜和正文。主体是两张 STURM 缩放图:(a) micro pixel-pooled,(b) macro per-scene。虚橙 EvIT-OFA 人标,实蓝伪标签,灰横线老师。蓝线在匹配 N 上更高,并进入人标无法进入的灰阴影(beyond Sen1Floods11 ceiling)。N=4000 只是饱和诊断。读图时忽略上半定性残片。
实验如何设计?
- Sen1Floods11:官方 252/89/90 划分,玻利维亚 15 张留作迁移。表面水标注含永久水体,因此报告的是 water IoU,不是洪水增量。
- STURM-Flood:作者协议下 46 张洪水图、29 个 EMS 事件、2675 块。洪水与河流相关为正类,开阔水/水库/湖泊忽略约 3.3% 像素。这不是 STURM 原文把 1–5 类合成一类的协议,绝对分数不可与已发表基线比。
- WorldFloods-v2:测试 18 个 AOI / 11 事件,785 个原生 512 窗;JRC 永久水忽略,表中 WF-fo。
- 匹配预算 Table I:N=252,四种子,pixel-pooled。部署 Table II:N=2500。图 2 扫池大小与三种目标。图 4/5 把人工臂与伪标签臂画在同一 N 轴上,阴影区是 S11 人工集到顶之后伪标签仍能继续加的部分。
- 设备:Jetson Xavier NX,JetPack 5.0,TensorRT 8.4。Table IV 用 trtexec、200 次、20 warmup,只计 GPU kernel。
关键结果与论文证据
- Table I(第 9 页):老师 S11 0.897/0.822,STURM 0.755/0.643,WorldFloods 0.771/0.641。N=252 时 EfficientViT-B0 OFA 伪标签 S11 0.852/0.743、STURM 0.753/0.640,与同架构人标臂接近,STURM 上伪标签臂更好。UNet-Logit-KD 在 S11 人标上 0.876/0.784,是该表分布内最强,但不是部署对象。
- 软目标步在伪标签匹配预算上:STURM +0.018、S11 +0.017、WorldFloods +0.005。该步同时改软项、权重和温度,不能单独归因于软标签。按 46 张 STURM 图,CE→Logit-KD 可分辨,OFA 再进一步则不能。
- Table II / 正文(第 9–11 页):N=2500 时 OFA 学生 S11 mIoU 0.877,water IoU 从匹配预算的 0.743 升到 0.787(老师 0.822)。STURM 0.756±0.005 对老师 0.755,按图配对差 −0.0012,p=0.46。WorldFloods 仍低 0.007 mIoU(按景 0.023)。三种目标在此预算下差距缩到约 0.004。
- 图 2:三条基准上都随 N 上升后变平。阴影带 50–251 内 OFA 的种子均值在三套基准上都高于 Logit-KD;带外符号不稳定。作者因此把 OFA 当稀缺数据区最强的部署选择,而不是主张它在 2500 仍显著更好。
- 图 3:N=50 时各配置失败模式不同;N=2500(S11 列实际是 251 点)四列都靠向老师。展示景选了低云。
- 图 4:STURM 上伪标签曲线在每个匹配 N 都高于人标臂,并进入人标无法进入的阴影区;N=4000 显示在 2500 之后饱和。图 5 在 WorldFloods 上形状相似,但 pixel-pooled 在 N=200 与 252 人标臂略高 0.010。
- MNDWI 零阈值:STURM 0.747、WorldFloods 0.763,组水平检验无法把学习模型与该规则分开;S11 上指数明显更弱(0.789/0.650)。用 MNDWI 掩膜替换老师硬标签,S11 与 STURM 约掉 0.038 mIoU。
- Table IV(第 13 页):INT8 5.57 ms、p99 5.60、179.2 FPS、1.5MB、3.42/5.83 W;FP16 5.20 ms、2.4MB。INT8 相对 float 导出 STURM −0.011、WorldFloods −0.016。老师未在该板实测。
阅读时需要注意
- §VII:一个老师、一个主学生、光学 Sentinel-2。没有第二老师对照,不能说必须用地基模型预训练。
- 300M 老师未在 Xavier NX 上测,内存论点是参数量而非同机实验;UNet 也能在该设备运行,紧凑学生的优势是引擎体积、时延和功耗。
- 匹配预算的几何与标签来源纠缠。STURM 处理级别、B8 顶替 B8A、评测上采样都会影响绝对分数。
- 干净外部基准上 MNDWI 有竞争力;干场景误报刻画不足,因为预过滤会丢掉全干瓦片。
- 方法在同一批公开基准上打磨。云遮近实时不在范围。预印本。
关联工作
- Prithvi 系列用大规模自监督把多光谱表征迁到未见地理。本文把它当冻结任务老师,而不是再讲预训练本身。
- OFA 为异构老师-学生设计,用多层输出头避开特征匹配;作者还试过中间特征 MSE,没有带来收益。
- InstaGeo 蒸馏到同架构更小模型做云端服务。本文跨架构压缩约 430×,训练数据是老师标的场景,并报告设备端 INT8。
- Garg 等的光学到 SAR 蒸馏解决的是跨模态标签,不是板端内存。
- UNet-ResNet50 是标准洪水分割对照:分布内更准,STURM 部署点上反而更跟老师、更不准,分歧审计里学生-right 只有 44%。