快速导读:IIT Indore 在四个胸片队列、五个固定提示族上审计 BioMedCLIP、CheXficient、MedSigLIP 与 OpenCLIP,表明模型排名、分数可靠性和阈值约束支持不同的可迁移声明,且不能外推为临床就绪。
医学视觉语言模型让人以为换一句提示就能在新医院做胸片结核筛查。IIT Indore 的这篇 arXiv:2609.21763 指出,可迁移的不是 checkpoint 名字,而是一条完整评价设定:模型与预处理器、提示与聚合、队列、阴性定义、患病率假设、阈值和准则。作者审计 BioMedCLIP、CheXficient、MedSigLIP 和通用域 OpenCLIP,四个数据集共一万二千余条图像记录、五个提示族得到二十四万余个分数。
结果按声明类型分开:没有模型在所有队列和可靠性指标上领先;提示族会改 AUROC;健康对照换成患病非结核对照后所有模型的排序能力下降;VinDr-CXR 上医学模型区分 no-finding 明显好于肺炎或肺肿瘤,后两者点估计甚至低于随机;源域百分之九十五灵敏度阈值在十六次迁移里只有四次按点估计保住;源域近乎满分的 ResNet 监督在两个外部队列掉到中等水平。CheXficient 对 VinDr-CXR 有文档化预训练暴露。本文是回顾性单任务审计,明确不估计临床效用,不能写成临床就绪。
英文题目:Beyond Benchmark Scores: Auditing Medical Vision-Language Models for Chest X-Ray Tuberculosis Screening
论文出处:arXiv 每日论文精选 · arXiv:2609.21763
原始论文:PDF / 论文页面
这篇论文解决什么问题?
高 AUROC 只说明当前对照下阳性图分数更高,不说明阴性是正常人、其他病人还是具名疾病,也不说明分数能当概率、阈值能原样搬走。视觉语言模型还把文本原型写进分类器,报一个权重文件等于漏掉一半系统。
已有工作分别看提示、公平、困难鉴别、伪影和 hidden stratification。本文用符号 E=(m,p,C,N,π,τ,r) 把这些条件写进同一条声明,并问四件事:领先者是否随队列和准则而变;提示和阴性谱在图像或阳性固定时改变多少;分数可靠性和源域阈值在新患病率与新队列下是否仍够用;强监督源域验证能否解决迁移,以及对潜在图像重叠有多敏感。
核心创新
- 把可迁移声明拆成模型排名、提示敏感性、阴性谱、分数可靠性、阈值迁移和监督外推,并各自固定其余设定。
- 在阳性样本不变时配对替换健康对照与患病非结核对照,以及 VinDr 上的 named-disease 对照。
- 报告源域灵敏度约束在目标队列上是否按点估计保留,并单独标记 CheXficient 对 VinDr-CXR 的预训练暴露。
方法概览
冻结四个 checkpoint:OpenCLIP ViT-B/32(LAION-2B)、BioMedCLIP(PMC-15M)、CheXficient(含已记录的 VinDr-CXR 预训练暴露)、MedSigLIP-448。五个提示族(Clinical 四对文本平均,Photo/Report/Presence/Normal 各一对)用同一图像嵌入,按公式 (2)(3) 做两类 softmax 分数,不是校准后的患病概率。队列:Montgomery、Shenzhen、TBX11K 训练/验证、VinDr-CXR 3000 张测试,共 12200 条图像记录、244000 个分数。配对分析固定阳性样本只换阴性;患病率标准化只改类权重;阈值迁移把 TBX11K 训练上达到至少 0.95 灵敏度的最高阈值原样带到目标;监督对照是 ImageNet 初始化 ResNet-50 五随机种子;感知哈希筛查后保守剔除候选重叠再重训。CheXficient 的 VinDr 结果只当作集内压力测试。
- 范围:回顾性图像级结核标签,不是跨数据集核实后的独立患者。Montgomery 与 Shenzhen 为结核对正常;TBX11K 官方有标签的训练/验证含健康与患病非结核,排除未标注测试和捆绑的 NLM 副本;VinDr-CXR v1.0.0 的三千张测试用五位放射科医生共识的图像级标签。
- 四个冻结系统见表 2。OpenCLIP 是 LAION-2B 对照。BioMedCLIP 来自 PMC-15M。CheXficient 以 VinDr-CXR 为已记录训练来源,该队列实验是集内压力测试。MedSigLIP 跨专科医学训练,未记录直接使用本评估集,但也不能证明独立。图像统一转 RGB;VinDr DICOM 按固定 VOI/极性规则转 PNG,不做肺分割或按标签调窗。
- 提示见表 3。Clinical 族每类四句文本嵌入平均再归一化;Photo、Report、Presence、Normal 各一对。分数是带模型温度的两类 softmax,不是校准患病概率。MedSigLIP 的共享 logit bias 在归一化中抵消。目标队列不参与主提示或监督 checkpoint 选择。
- 阴性谱:TBX11K 验证用同一二百张结核图分别对八百健康和八百患病非结核。VinDr 用同一百六十四张结核图对 no-finding、肺炎、肺肿瘤。患病率标准化只改类权重。阈值迁移取 TBX11K 训练上灵敏度至少百分之九十五的最高阈值,原样应用到四个目标。
- 监督对照:ImageNet 初始化 ResNet-50,TBX11K 训练按类百分之八十/二十划分优化与选择,五种子,加权 BCE,最多二十轮。感知哈希 Hamming 距离不超过四的跨数据集候选全部剔除后重训,不做是否为重复的人工裁决。
逐图理解论文
失败直觉
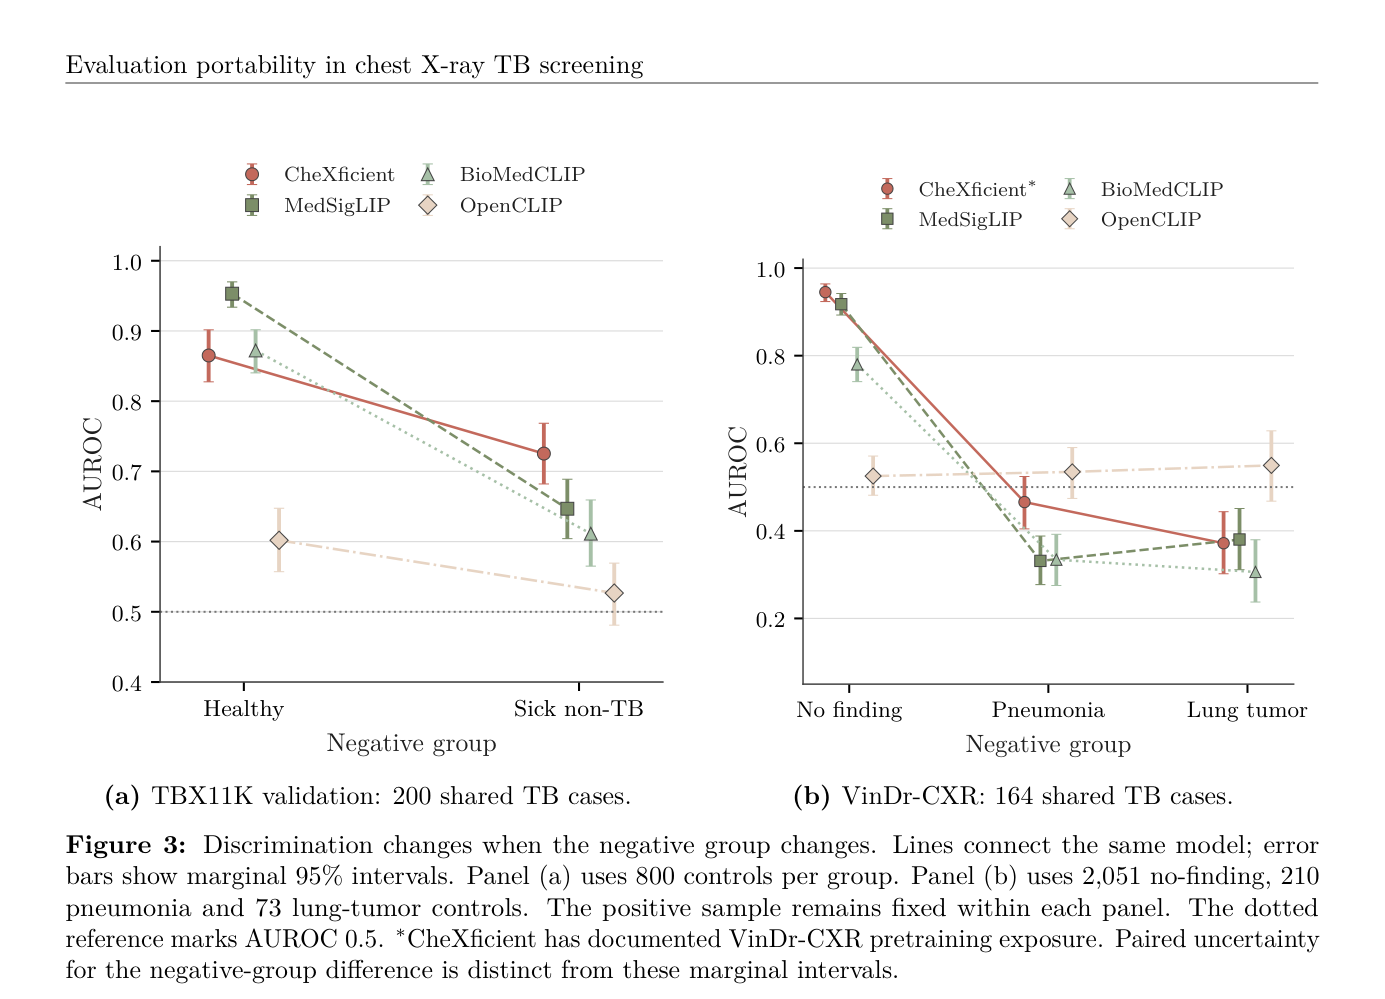
两条折线故事:左边健康对照换成患病非结核,所有模型下降;右边 no-finding 换成肺炎或肺肿瘤,医学模型落到随机附近甚至以下。阳性样本在各自面板内固定。不要用边际误差棒代替配对检验,也不要在看到低于 0.5 之后把分数取反。
研究缺口
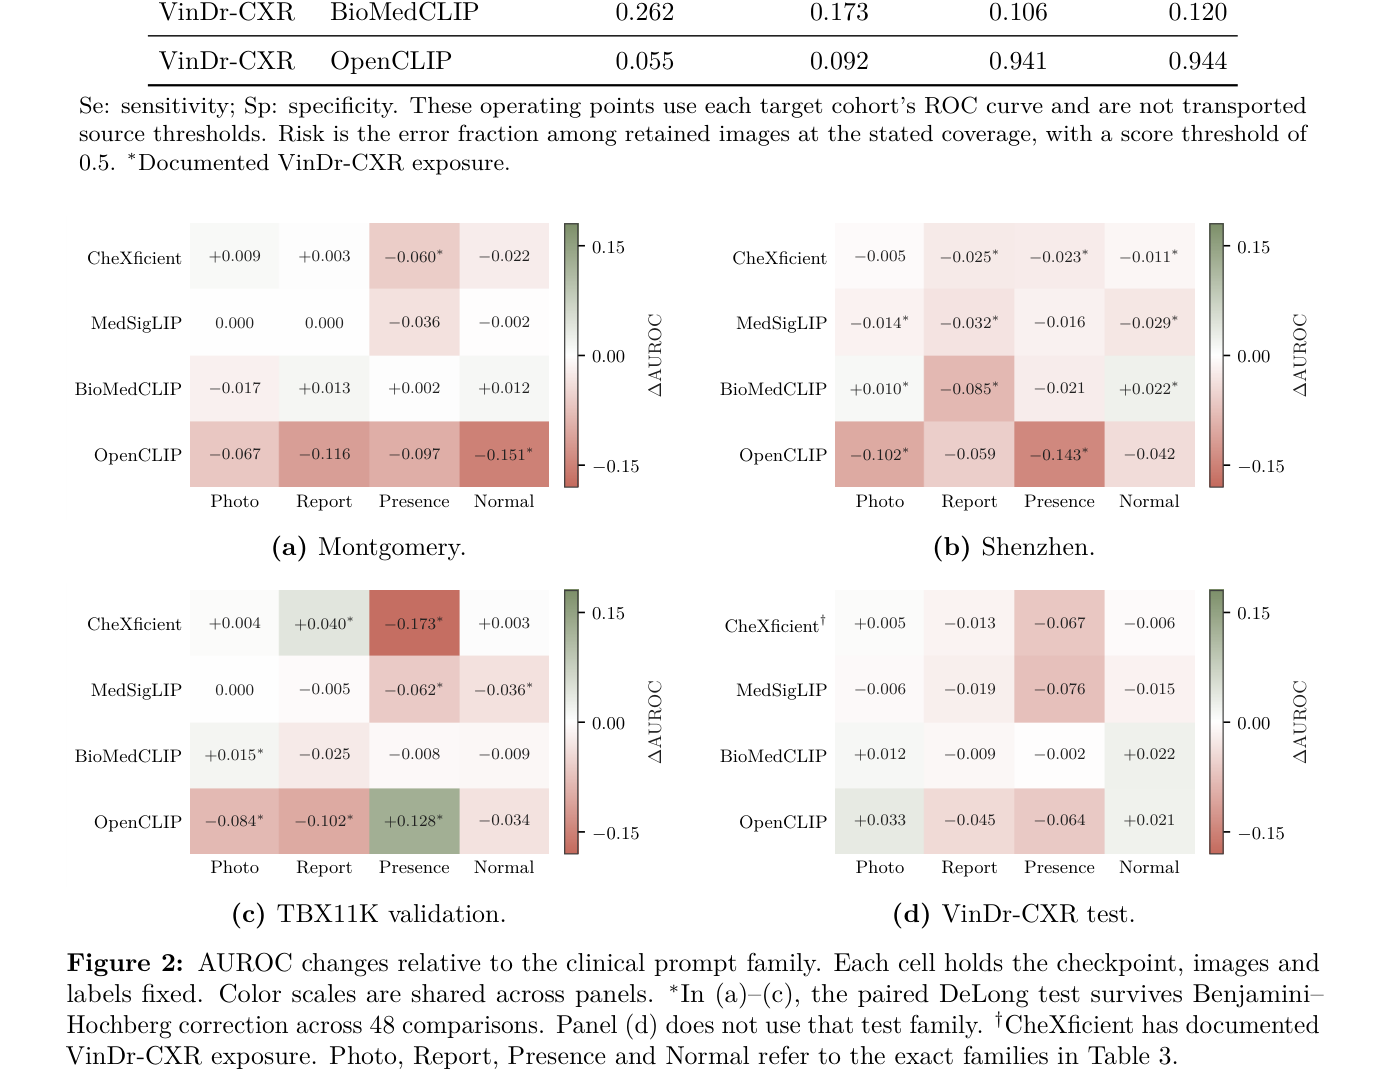
每个格子是换成该提示族后相对 Clinical 的 AUROC 变化,图像和标签不变。先横看同一模型在 Photo/Report/Presence/Normal 上的符号,再换队列看是否翻转。只有 (a)(b)(c) 的星号经过四十八次 BH 校正;(d) 只是描述。
方法贡献
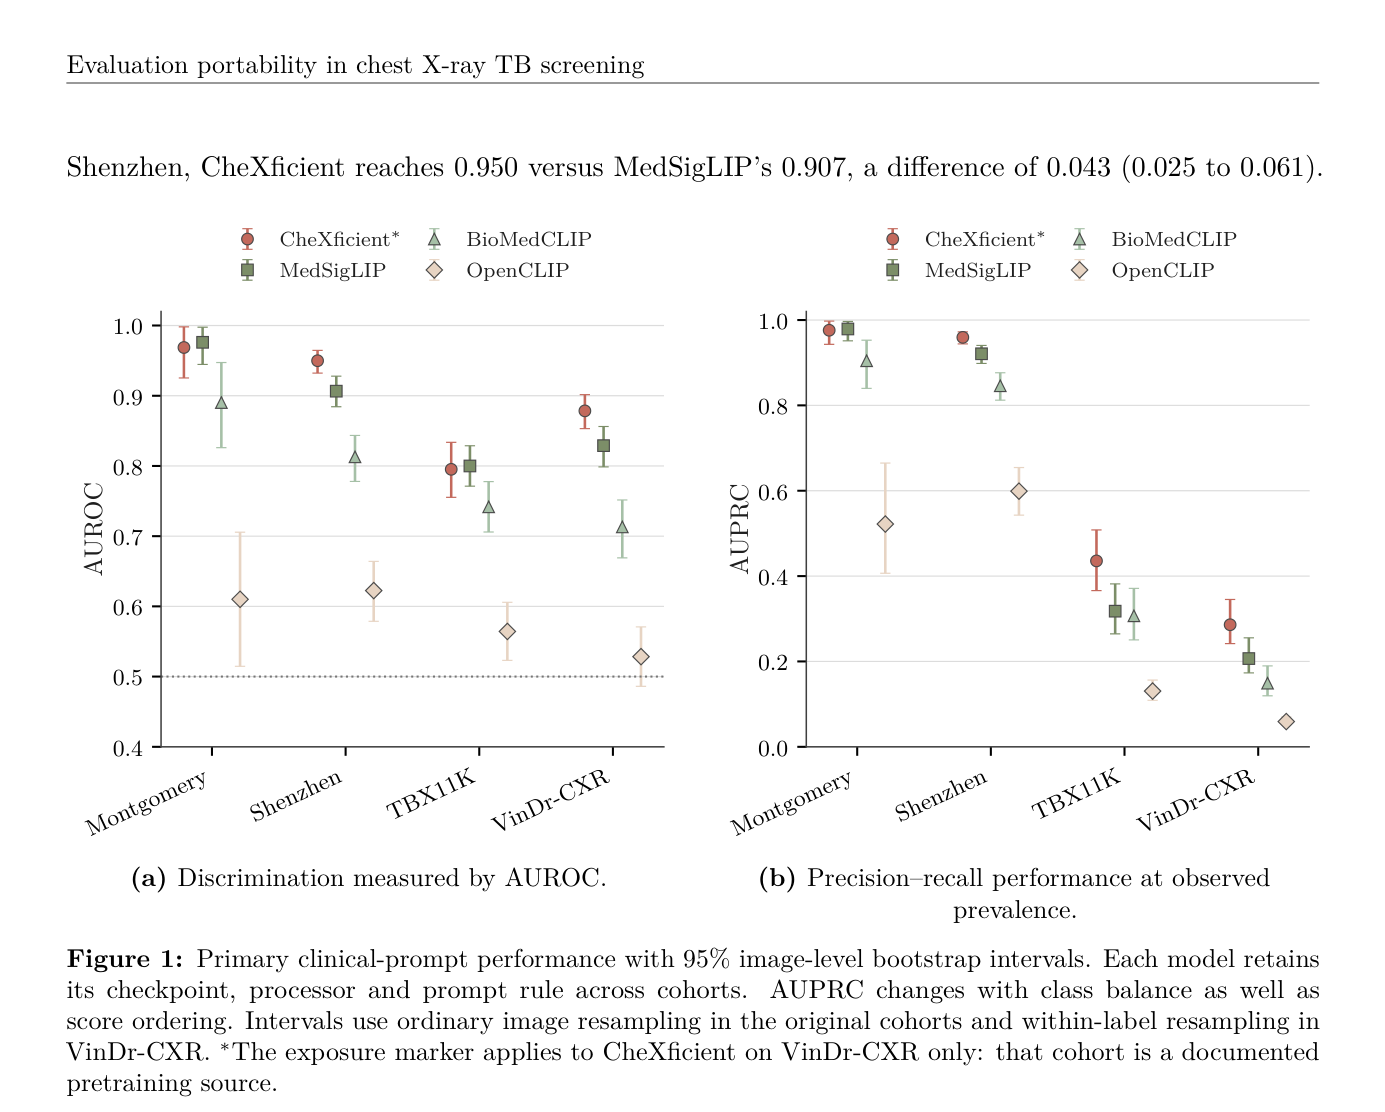
左栏 AUROC、右栏 AUPRC,按四个队列读同一套 Clinical 提示。注意红点在 VinDr 上带星号,表示 CheXficient 有预训练暴露。右栏在 TBX11K 和 VinDr 掉得更狠,因为阳性率低,不能把 AUPRC 差都写成模型变差。图顶残留的 0.950 对 0.907 是 Shenzhen 的正文句子。这张图可作特色图:没有架构图。
核心结论
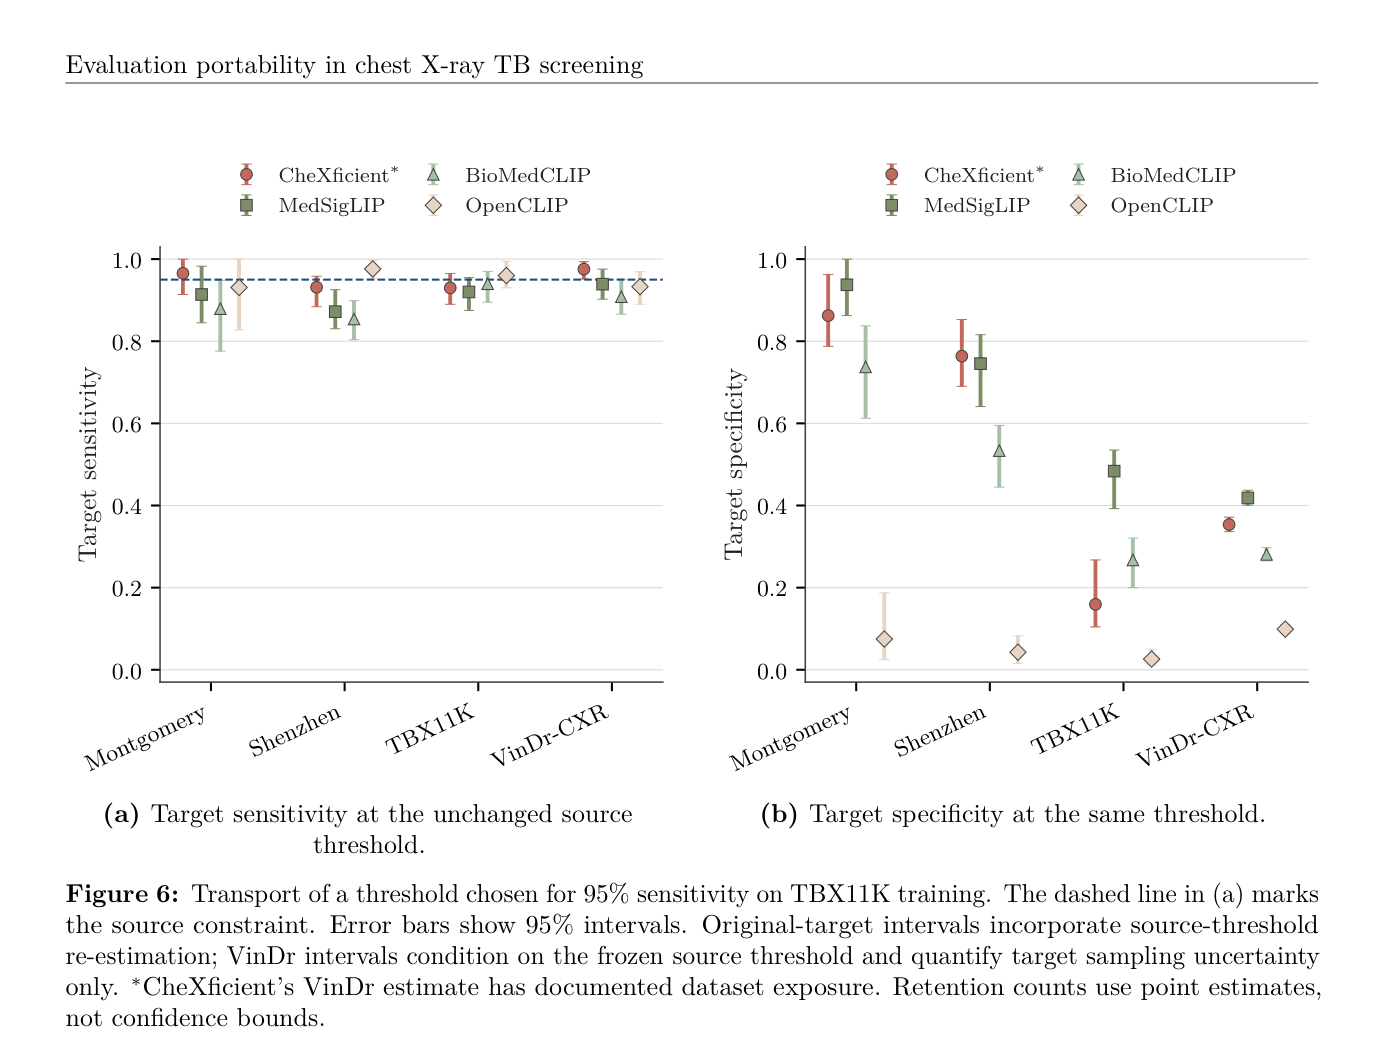
左栏看灵敏度是否还够到源域虚线,右栏立刻看特异度。名义上保住灵敏度的点,可能对应几乎把所有图判成结核。保留与否按点估计计数,不是置信下限。
意义与局限
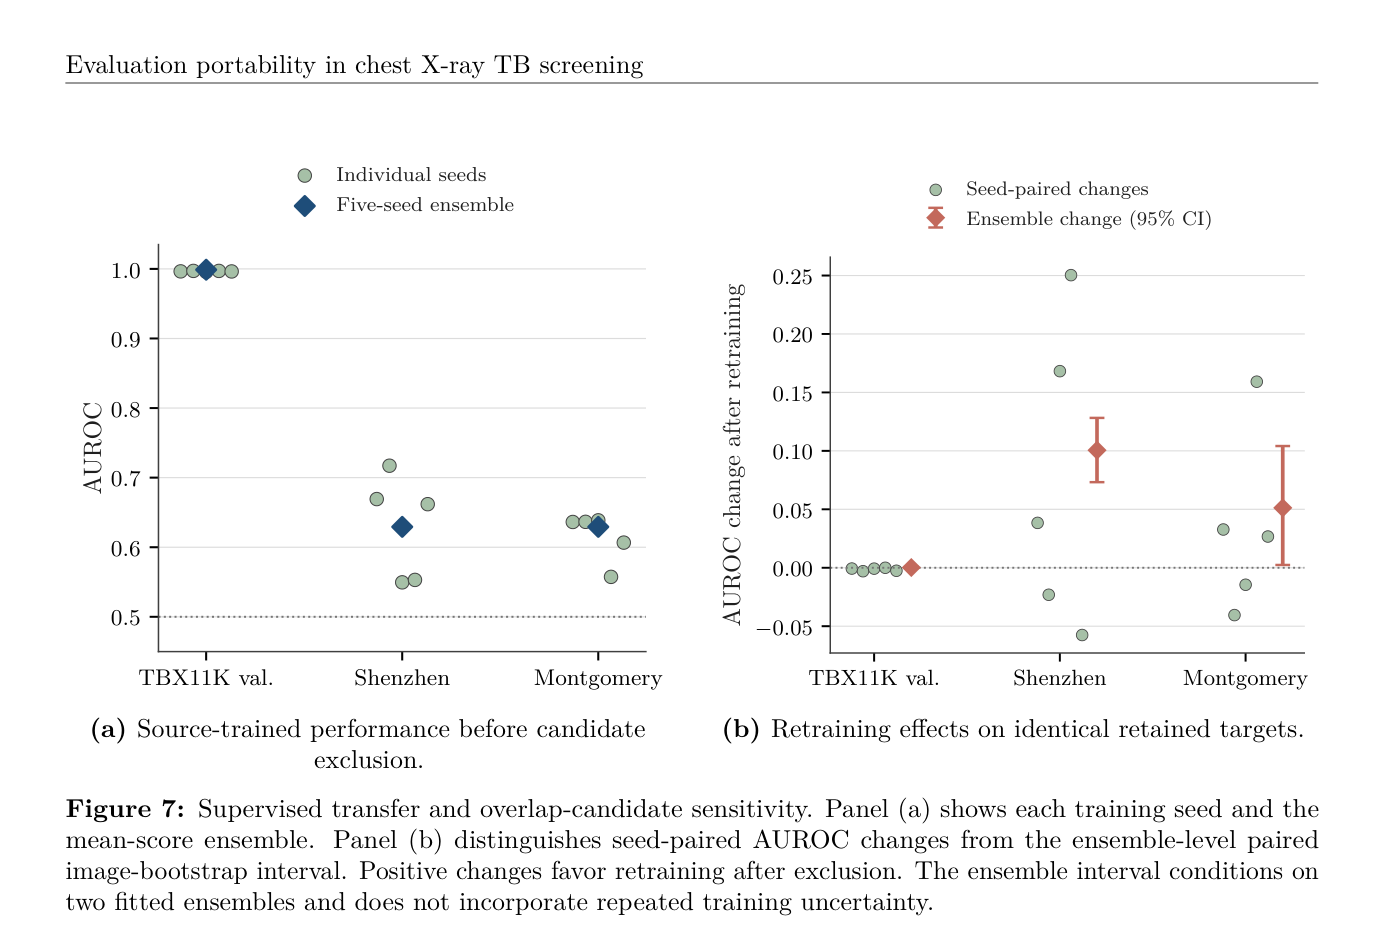
左边种子和集成在源域贴顶、在两个外部队列落到中等;右边重训差的集成区间为正,但多种子为负。去重叠不能被说成已证明泄漏,源-外缺口也没有闭合。
实验如何设计?
- 主零样本比较用 Clinical 提示,在 Montgomery、Shenzhen、TBX11K 验证上进行;TBX11K 训练作复制和阈值源;VinDr 作具名谱扩展。
- 统计:二千次百分位 bootstrap,种子固定。原矩阵用普通图像重抽样,VinDr 用按标签重抽样。四十八个提示对比做 Benjamini–Hochberg;阴性谱用 Holm 校正的置换检验。
- 可靠性同时报 Brier、十五箱 ECE、选择性预测的 AURC。操作点区分“在目标 ROC 上取点”和“搬走源域阈值”。
- 硬件与实现绑定 A100、指定仓库 revision;MedSigLIP 用 Hugging Face PIL resize,不是模型卡上的 TensorFlow/Big Vision 参考。
关键结果与论文证据
- Table 4 与 Fig.1(第 9–10 页):Montgomery 上 MedSigLIP AUROC 0.976、CheXficient 0.969,配对区间不能分辨;Shenzhen 上 CheXficient 0.950 高于 MedSigLIP 0.907。TBX11K 验证两者约 0.80。VinDr 全非结核 CheXficient 0.878,但必须带着预训练暴露来读。OpenCLIP 多在 0.53–0.62。Brier/AURC 会把“领先者”改写:MedSigLIP 在 NLM 队列 Brier 更好,CheXficient 在 TBX11K 验证的 Brier 与 AURC 更好。
- Fig.2:四十八个主提示对比中二十一个通过 BH。BioMedCLIP 的报告体在 Montgomery 升、在 Shenzhen 降。CheXficient 在 TBX11K 验证上 Presence 掉到 0.622,OpenCLIP 反而升到 0.692。五族等权平均不能稳定取消提示依赖。
- Fig.3 与 Table 9–10:健康改患病非结核后 AUROC 下降 0.140、0.306、0.261、0.075。VinDr 上医学模型对肺炎/肺肿瘤点估计低于 0.5,对 no-finding 仍可很高。总体 AUROC 会被两千余张 no-finding 抬高。
- Fig.6 与 Table 15:十六次源域灵敏度迁移只有四次点估计保留约束,其中两次是特异度接近零的 OpenCLIP。换 Shenzhen 作源或改成特异度约束,会得到另一套完全不同的二值分类器。
- Fig.7:监督集成源域 0.999,外部 Montgomery/Shenzhen 均为 0.629。剔除三百余张感知候选后外部升到 0.733/0.678,缺口仍大约 0.27 和 0.32 AUROC,且不是所有种子都受益。
阅读时需要注意
- 只做胸片结核,不能外推到其他疾病、模态或临床动作。
- 标签未统一到微生物学金标准;VinDr 是放射印象,诊断可共现。
- 未评估人口学公平或医师交互。
- 感知哈希漏掉 VinDr,无重复裁决;除 CheXficient 外预训练成员资格不可观测。
- MedSigLIP 的相对 softmax 与 resize 实现不同于开发者参考评测。
- 明确不估计临床效用、人群患病率或患者结局。
关联工作
- 提示敏感性和校准误差是已知现象,本文把它们绑到同一筛查任务里互不相同的可迁移声明。
- hidden stratification 解释为何总体 VinDr 分数可以看起来能用,具名疾病对照却失败。
- OpenCLIP 对照说明:没有医学预训练会更弱,但有医学预训练也不等于阈值和阴性谱可迁移。
- CheXficient 文献自己把 VinDr-CXR 列为训练来源,因此不能把该队列数字当成独立外部验证。