快速导读:DeltaWAM 用稠密锚帧 + 稀疏视觉增量 + 动作三流联合建模,取代稠密未来帧预测,并引入 Streaming Delta Memory 做增量上下文更新,在提升鲁棒性的同时降低训练与推理开销。
世界-动作模型试图把视频生成里的视觉与运动先验搬进机器人控制:一边想象世界怎么变,一边输出动作。但主流做法在训练时仍稠密预测整段未来帧,等于反复编码几乎不变的背景与物体外观,还把动作相关动力学和无关外观抖动绑在一起;推理时每来一帧都要过一遍沉重视频专家,少步动作生成立刻被视觉分支拖慢。
DeltaWAM(arXiv:2609.28811,北大 + AI2 Robotics;项目页 https://aigeeksgroup.github.io/DeltaWAM,代码 https://github.com/AIGeeksGroup/DeltaWAM)改成“稠密锚帧 + 稀疏视觉增量 + 动作”三流联合预测,并配上 Streaming Delta Memory,让大多数控制周期只写增量 KV。目标很明确:双臂操作更稳,训练和推理更省。
英文题目:DeltaWAM: Delta World Action Models for Bimanual Manipulation
论文出处:arXiv 每日论文精选 · arXiv:2609.28811
原始论文:PDF / 论文页面
这篇论文解决什么问题?
稠密未来帧建模有两重代价。计算上,VAE 与视频专家对每帧完整 token 付账;统计上,模型被迫拟合大量与控制无关的外观变化,随机化场景里更容易过拟合纹理而不是接触与运动结构。
推理瓶颈同样尖锐:即使动作头可以少步去噪,只要每次观测都完整跑视频专家,端到端延迟仍由稠密视觉主导。真实双臂任务对这一点更敏感。
因此需要一种表示,既保留预训练视频骨干的稠密空间先验,又把时序建模重心挪到“变了什么”,并让缓存机制与这种增量表示对齐。
核心创新
- 用稀疏视觉增量替代稠密未来帧,把算力集中在帧间变化。
- 提出 Anchor-Shared / Separated / Action-Shared 三种共享架构,系统比较表示与计算共享。
- Streaming Delta Memory 以观测增量增量式更新缓存锚上下文,降低推理 FLOPs 与延迟。
方法概览
DeltaWAM 将世界-动作建模拆成 dense-anchor、sparse-delta 与 action 三股流,并比较 Anchor-Shared、Separated、Action-Shared 三种共享策略。锚帧走 VAE 稠密 token,帧间变化经冻结 Delta Encoder 变成稀疏 delta;动作由可训练 Action DiT 去噪,并与锚/增量流通过层共享自注意力与结构化 mask 交互。Streaming Delta Memory 在推理中多数控制周期只更新 delta KV,周期性刷新完整参考 KV,并支持异步更新。
- 表示:参考/锚帧经冻结 VAE 成稠密 token;相邻帧经冻结 Delta Encoder 得到稀疏 clean history delta,未来增量加噪后与动作一起去噪。动作序列经可训练 Action Encoder 进入 Action DiT。
- 三种架构:Anchor-Shared 让锚网络与 Action DiT 在层间共享自注意力,同时保留流特定变换;Separated 更独立;Action-Shared 更偏向动作侧共享。结构化 attention mask 规定锚、历史增量、未来增量与动作 token 的可见性。
- 训练目标联合未来视觉增量与动作;SDM 训练时采样不同记忆长度 h,使上下文增量只能看锚与更早增量,对齐流式推理可见性。
- 推理:先算一次完整参考 KV;随后多数周期只编码新观测相对上一帧的 delta 并追加 KV;周期性 refresh 重新锚定,避免参考过时;还可在动作执行残余时间内异步更新 SDM,用有界陈旧换端到端延迟。
- 实现上锚骨干等初始化自 Wan2.2-TI2V-5B,并用 LoRA(r=64, α=128)适配;对比 DeltaTok 与 DreamDojo LAM,并在后层插入双流残差专家。
逐图理解论文
稠密代价
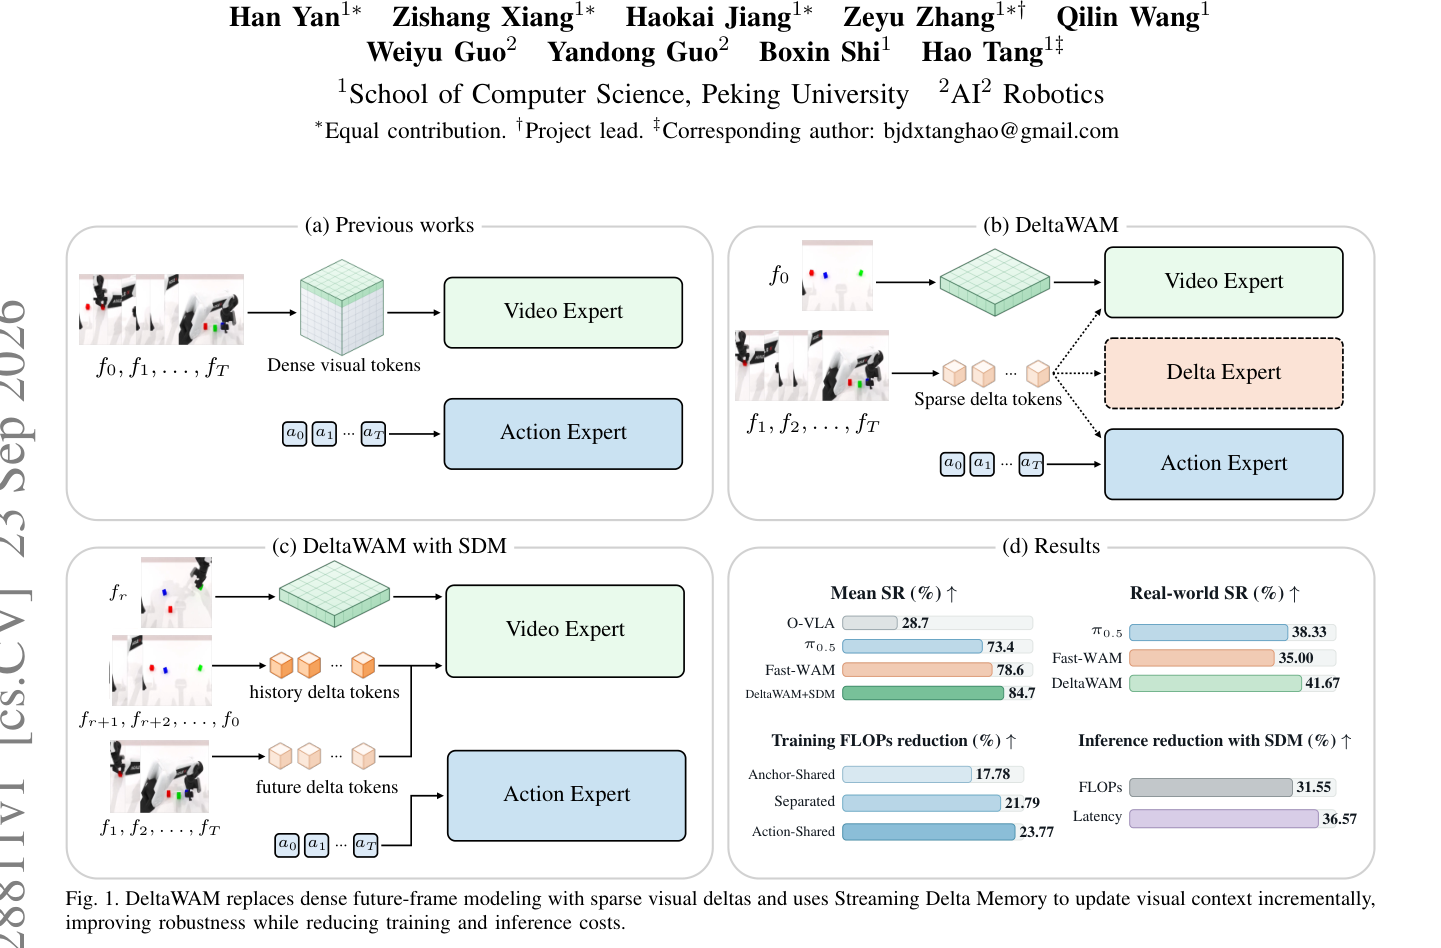
图1对比既往稠密未来帧 WAM、DeltaWAM 稀疏增量,以及带 SDM 的历史/未来增量拆分,并汇总仿真成功率、真实成功率与训练/推理降本条形图。
三流架构
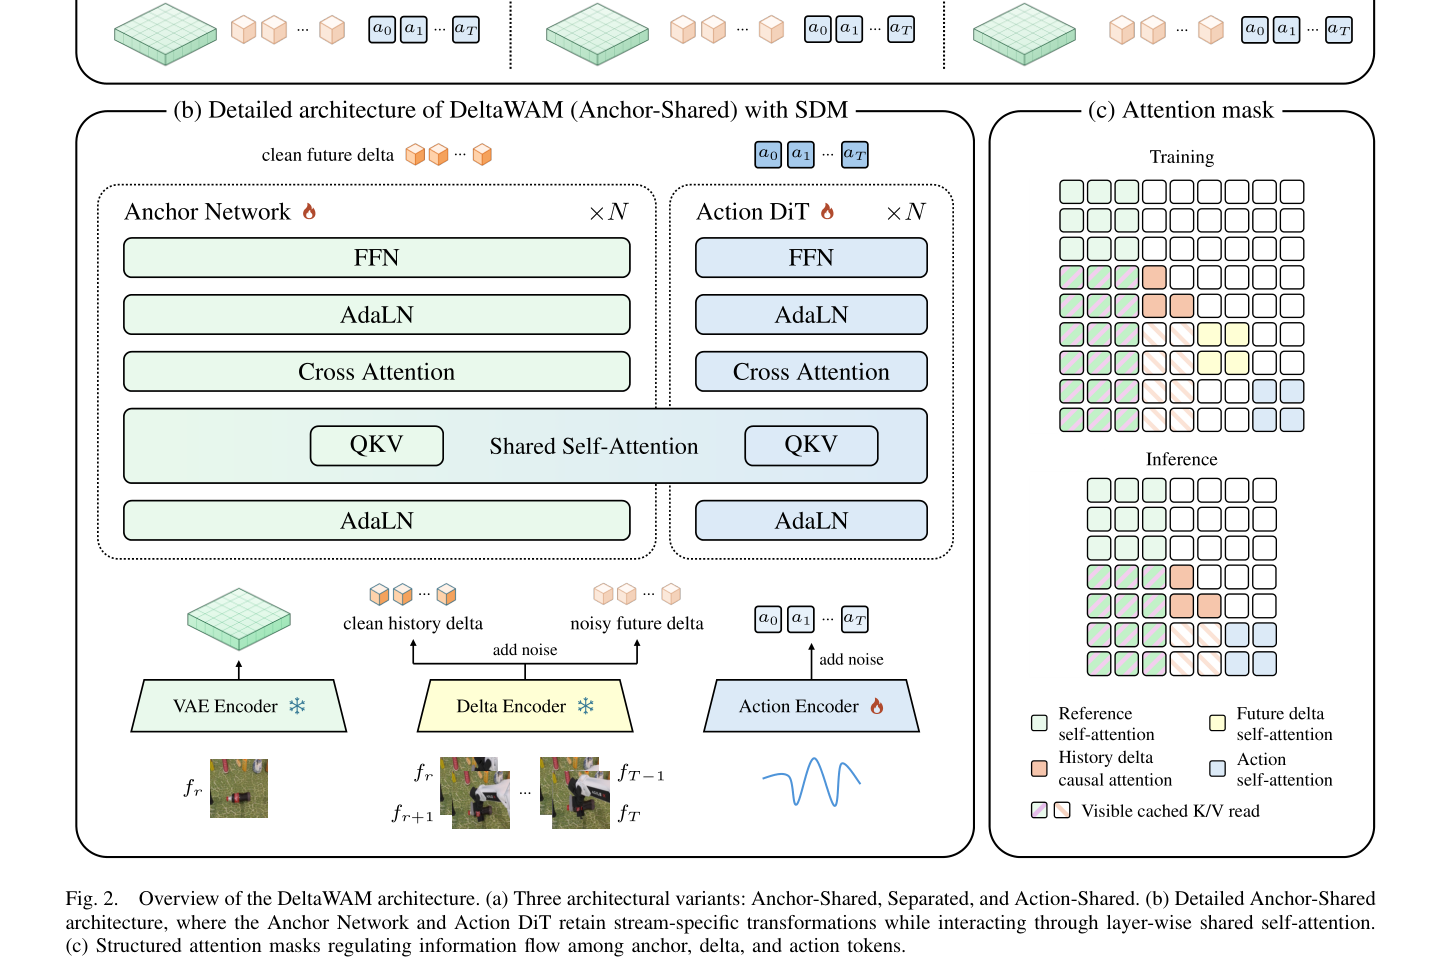
图2给出 Anchor-Shared 详图与训练/推理 attention mask:锚 VAE、Delta Encoder、Action Encoder 如何汇入共享自注意力,以及缓存 KV 在推理 mask 中的复用方式。适合做架构主图。
流式记忆
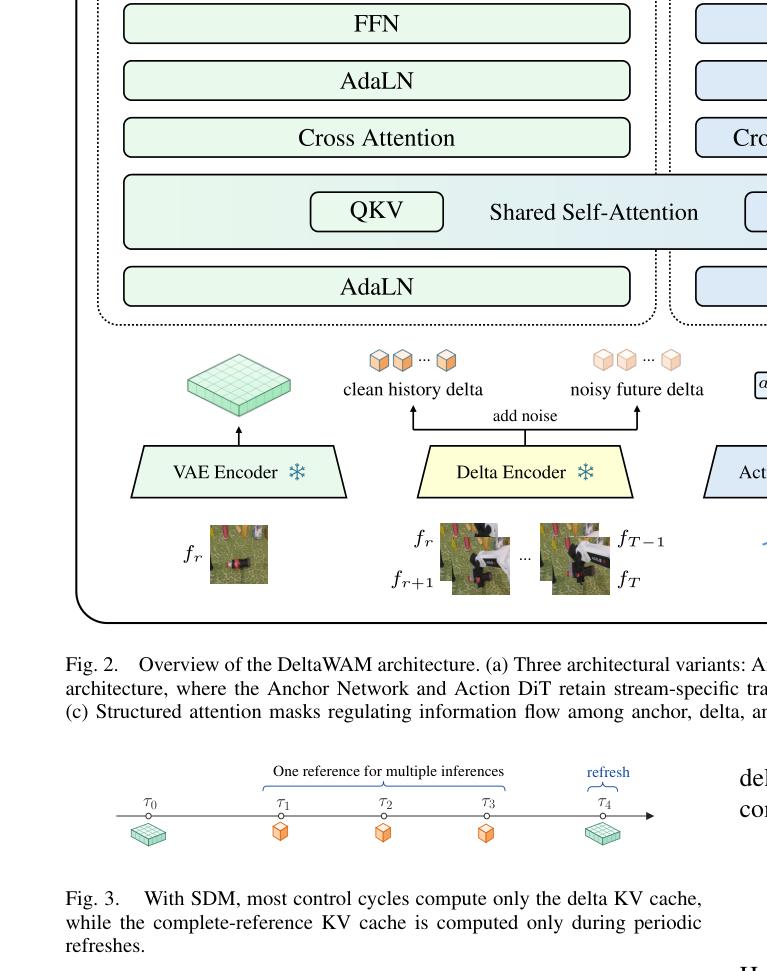
图3用时间轴说明 SDM:τ0 算完整参考,τ1–τ3 只算 delta,τ4 refresh。帮助理解“多数周期只更新增量 KV”。
实验证据
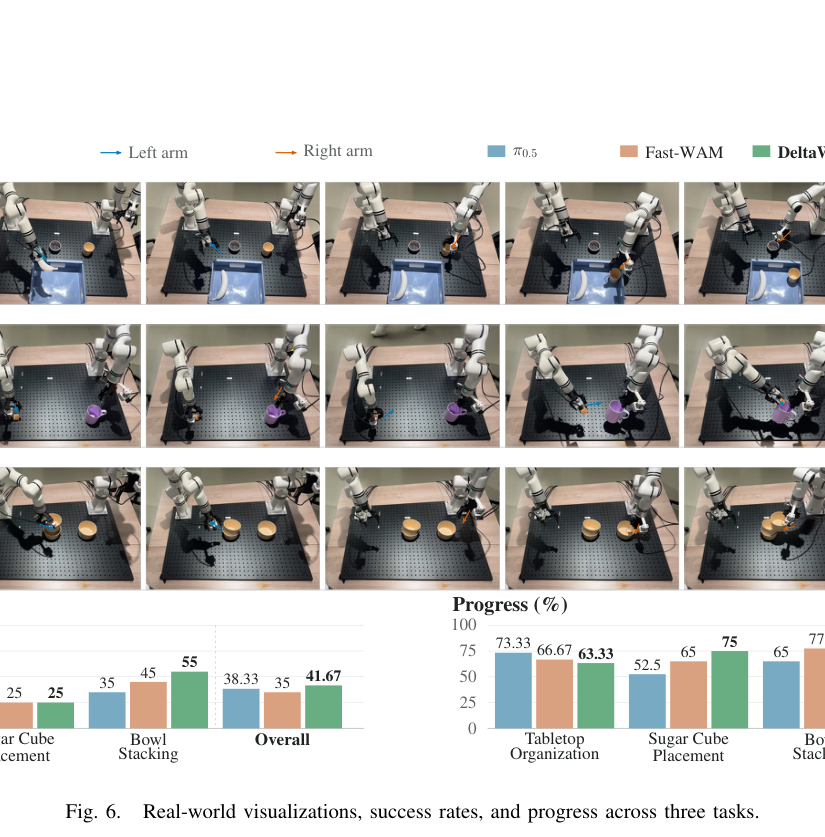
图6展示真实双臂三任务可视化,以及相对 π0.5、Fast-WAM 的成功率与进度柱状图,是落地证据页。
实验如何设计?
- 仿真:RoboTwin 2.0 初始五任务 + 补充五任务,报告 Clean/Random 成功率,对照 OpenVLA、π0.5、Fast-WAM。
- 效率:每样本训练 FLOPs 分解与相对 Fast-WAM 降幅;单步动作去噪设定下的 latency 与 per-chunk FLOPs;不同锚宽度的训练算力曲线。
- 消融:无锚/冻结锚/不同 LoRA;LAM vs DeltaTok;残差专家层数;有无 SDM。
- 真实:桌面整理、方糖放置、碗堆叠等双臂任务,统计成功率与归一化进度(60 trials 量级的总体对比)。
关键结果与论文证据
- 初始五任务上,DeltaWAM 达 86.4%/82.6%(Clean/Random),Random 明显强于 Fast-WAM 的 79.0%;加 SDM 后 Random 进一步到 86.6%,Clean 略降至 82.8%(页6)。
- 训练上三种变体相对 Fast-WAM 节省 17.78%–23.77% FLOPs;Anchor-Shared 综合性能最好。单步推理中 SDM 将 latency/FLOPs 相对 Fast-WAM 降低 36.57%/31.55%(页6)。
- 补充五任务 DeltaWAM+SDM 平均 88.0%/81.2%,高于 Fast-WAM 与 π0.5(页6)。消融显示无锚仅约 32.6%/35.2%,LoRA 适配与 DeltaTok 是关键增益来源(页7)。
- 真实总体成功率 DeltaWAM 41.67%,高于 π0.5 的 38.33% 与 Fast-WAM 的 35.00%;Bowl Stacking 成功率 55% 领先,Sugar Cube Placement 三模型同为 25%(页8)。
- 算力分解表明 VAE 与视频专家分别可降约 85.48% 与 49.42%,但 delta encoder 新增 3.048 TFLOPs,是当前效率上限的主要抵消项(页7)。
阅读时需要注意
- Delta 编码开销限制了净节省,未来需要更轻的增量编码器。
- SDM 对 Clean/Random 的影响方向相反,部署需按域选择是否开启。
- 真实桌面整理进度仍可能不及 π0.5;部分精细放置任务成功率仍低且三者持平。
关联工作
- Fast-WAM 提出“测试时是否还需要未来想象”的问题,是本文直接对照。
- π0.5、OpenVLA、GR-2、RDT、UWM 等构成 VLA/WAM 周边光谱。
- Wan 视频生成骨干与 DreamDojo LAM 提供了锚表示与另一类增量/潜在动作编码选项。