快速导读:PHOSA(ECCV 2026)发布与听障专家共设的多视角中文手语数据集 MVSign,用混合 SMPL-X 拟合与身/头/手解耦高斯表示,做可驱动的逼真手语虚拟人。
手语交流依赖快速变化的手形、方位与面部口型,网格版 SMPL-X 虽能驱动关节,却难提供听障社区更偏好的照片级自然观感。要把可驱动三维虚拟人做真,既缺合适多视角手语数据,也缺能稳住细手势的表示。
PHOSA(arXiv:2609.29292,ECCV 2026,中科大 + UT Austin,项目页 https://naaapi.github.io/PHOSA 。给出数据与方法一整套:MVSign 多视角中文手语基准、混合 SMPL-X 拟合,以及身/头/手解耦的高斯虚拟人管线。
英文题目:PHOSA: Photorealistic 3D Sign Avatar Modeling and Benchmark
论文出处:arXiv 每日论文精选 · arXiv:2609.29292
原始论文:PDF / 论文页面
这篇论文解决什么问题?
通用多视角人体集多拍日常动作,对手部拓扑与表情覆盖不足;手语数据集又常是单目、偏低清,缺少同步环视与精确人体参数,难以做新视角/新姿态的逼真渲染基准。
方法上,把全身高斯揉在一张图里学,网络容易被大幅肢体运动主导,把手部细节平均掉;手语视频还普遍存在运动模糊与大量静止垂手帧,直接均匀采样会伤害训练。
因此需要:覆盖基础手形与连续句子的多视角数据、可靠的手/脸参数标注,以及让手部表示相对独立于身体位姿的建模策略。
核心创新
- MVSign:与听障专家共设、IRB 批准的首个多视角中文手语基准(16 视角、约 115K 帧、2048P,含抠图/分割/关键点/SMPL-X)。
- 混合 SMPL-X 拟合融合多模型优势,并可降级到单目设定。
- 身/头/手解耦表示 + 手部部分运动学解耦,提升复杂手势泛化。
- 运动感知采样抑制运动模糊与静止手势过拟合。
方法概览
采集 16 路同步 2048 分辨率视频并混合 HaMeR、DWPose、VGGSfM 三角化与 INFERNO 表情得到 SMPL-X;建模上把高斯图拆成身/头/手,手部做部分运动学解耦,StyleUNet 预测姿态条件高斯,经 LBS 与可微光栅化渲染;另用运动感知采样过滤模糊并平衡手势分布。
- MVSign:与听障专家按 HamNoSys 要素设计动作,含 109 类基础手形与多样句子;16 台同步 RGB(2048×2448),1 路正面、10 路侧弧、5 路头像特写;5 名母语签署者,约 115K 帧,标注含抠图、部位分割、三维关键点与 SMPL-X,经 IRB 与知情同意。
- 混合拟合:各视角 DWPose 关键点 + HaMeR 精化手部,VGGSfM 标定下三角化得到三维关键点并拟合 SMPL-X;面部再用 INFERNO 替换稀疏关键点难以表达的表情,并用时序初始化与 SmoothNet 平滑。
- 虚拟人:姿态经 LBS 得到身/头/手位置图;手部固定身体关节只留手自由度(部分运动学解耦);三路 StyleUNet 预测姿态条件高斯图,LBS 变形后可微溅射渲染,损失含光度项与手/头区域加权及偏移正则。
- 运动感知采样结合手部置信度、Laplacian 清晰度与参数速度过滤模糊,再按手势距离聚类做类别均衡。
逐图理解论文
MVSign 与拟合
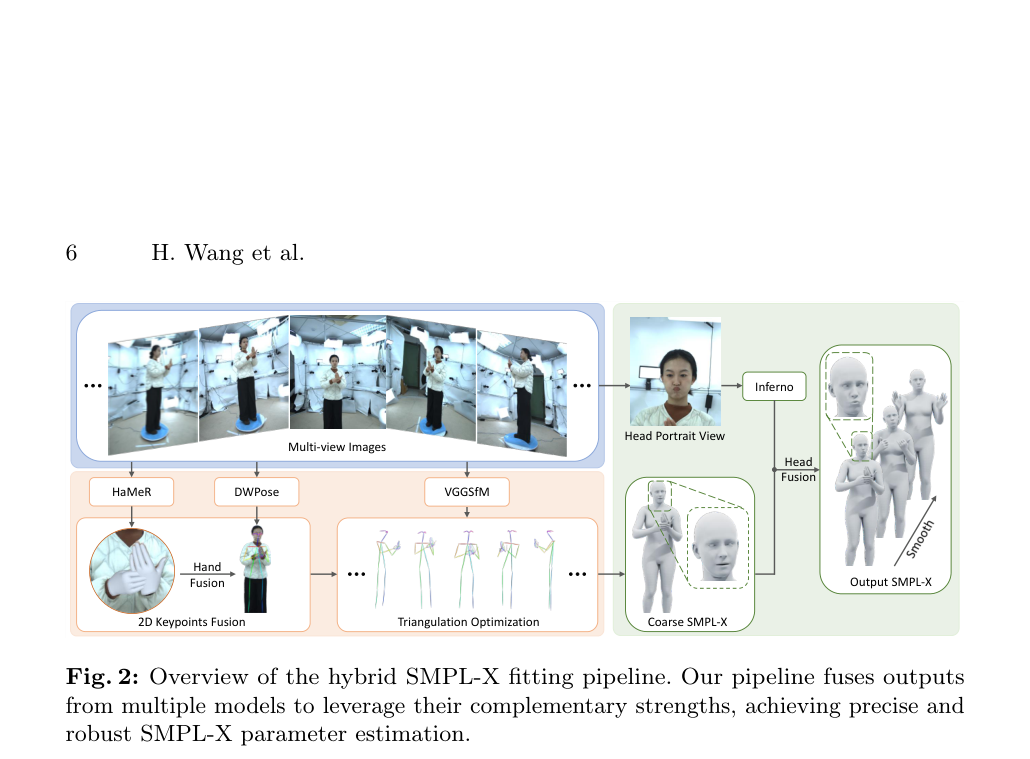
图2展示混合拟合:多视角图像经 HaMeR/DWPose/VGGSfM 做关键点融合与三角化,头像支路经 Inferno 做表情融合,输出平滑 SMPL-X。
解耦表示
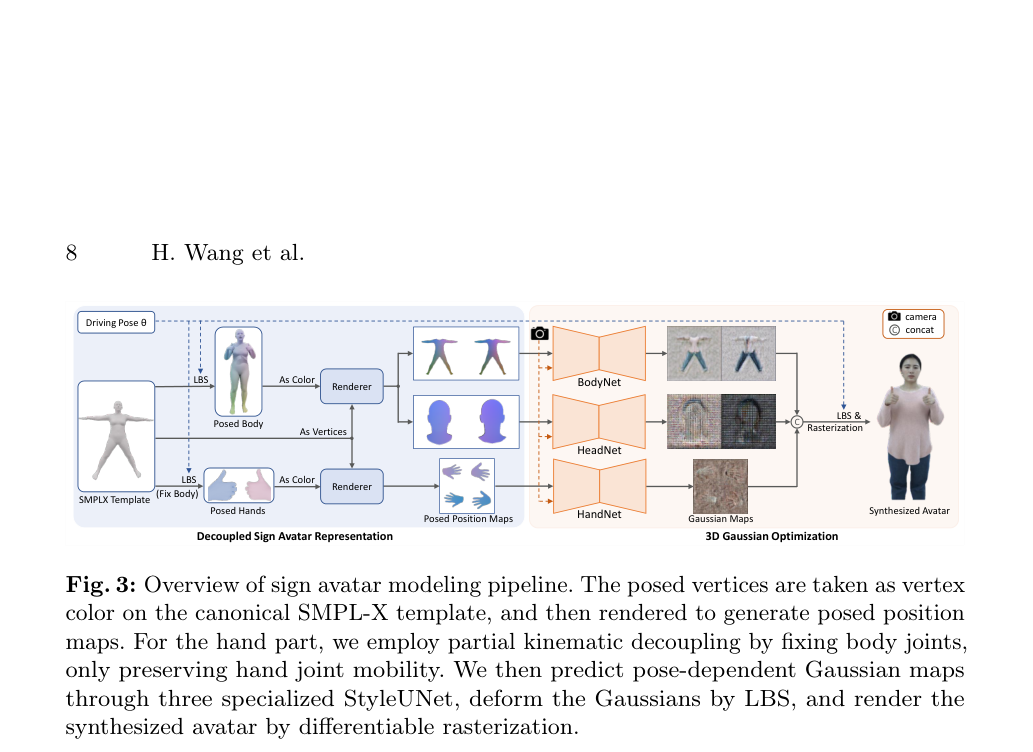
图3是建模主图:驱动姿态生成身/头/手位置图,手部部分运动学解耦后经 Body/Head/HandNet 预测高斯图,再 LBS 溅射得到合成虚拟人。
关键证据
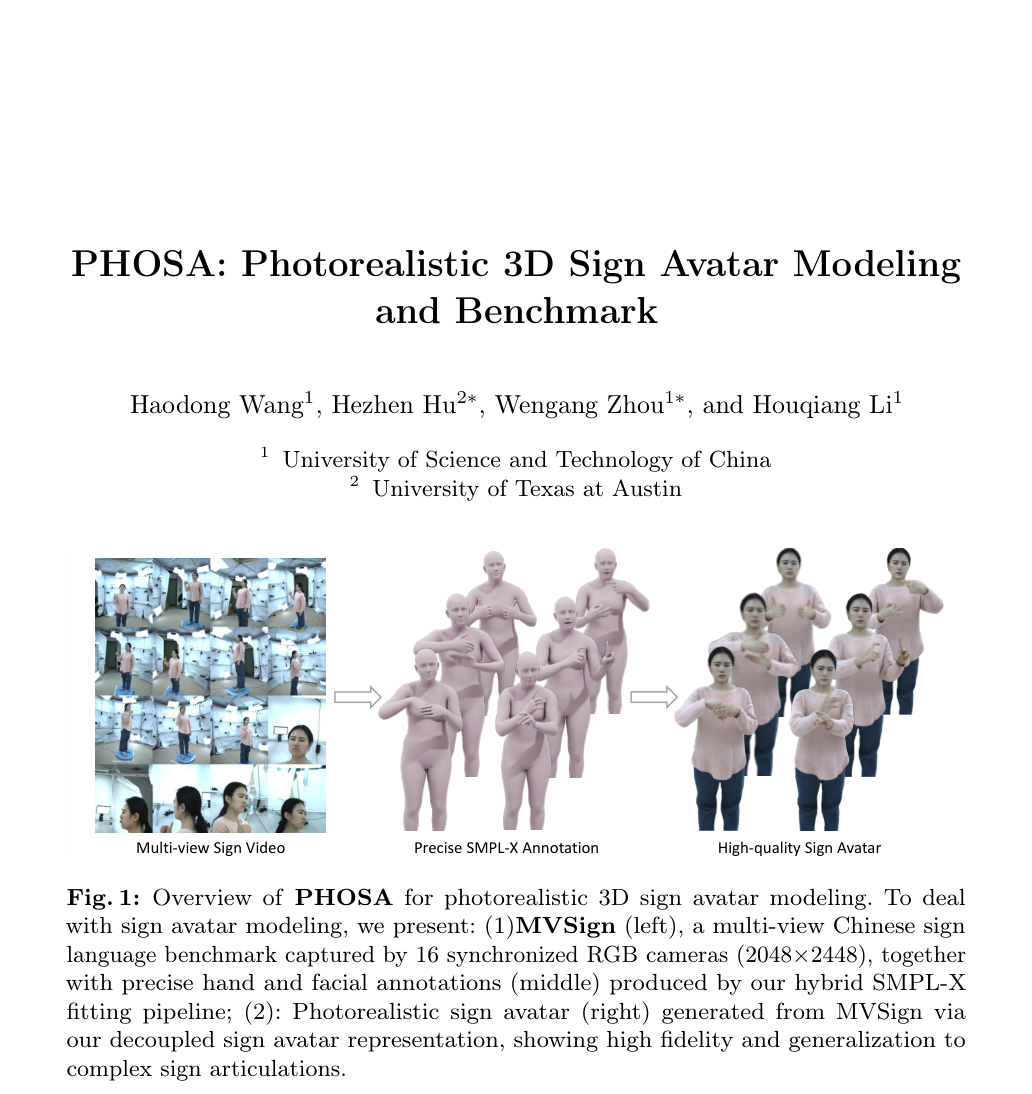
图1总览:左 16 路 MVSign 同步采集,中混合拟合得到的粉色 SMPL-X,右解耦表示渲染的照片级手语虚拟人,适合做特色图与开篇导读。
实验如何设计?
- MVSign 按采样帧前 90% 训练、后 10% 测试,16 视角全用;野外 CC 视频四人、1080p,训练/测试各 150 帧,单目拟合去掉三角化。
- 指标为全身/手/脸的 PSNR、SSIM、LPIPS;基线含 SplattingAvatar、GaussianAvatar、AnimatableGaussians、EVA、Mmlphuman,统一 SMPL-X 驱动与划分。
- 另在 SGNify mocap 比拟合误差;听障社区问卷评可理解性、清晰度、真实感与审美。
关键结果与论文证据
- Table 10:MVSign 上 Ours Full 27.03 / 0.9689 / 0.0393,作者称相对基线 Full/Hand/Face LPIPS 约改进 8.1% / 4.0% / 5.9%;野外单目改进更大(约 15.8% / 11.6% / 12.6%)(页13)。
- 混合拟合显著抬高手/脸保真(Hand LPIPS 0.2987→0.2301);SGNify 集上拟合误差低于 NSA/SGNify(页11)。
- 视角从 1→16,Full LPIPS 0.0425→0.0370,说明多视角对消解手部自遮挡关键(页12)。
- 仅基础手形或仅句子都不如两者混合;运动感知采样与 +PHK 解耦对出手部质量(页12–13)。
- 听障用户研究中,照片级虚拟人相对纯网格在审美等维度更受偏好(约 84%)(页14)。
阅读时需要注意
- 三路 StyleUNet 使推理偏慢,作者指出难实时,轻量化是后续方向。
- 签署者规模与场景多样性仍有限;单目野外受姿态估计噪声约束。
- 与 SignGen 等文本到视频路线任务不同,不能直接当成同一榜单。
关联工作
- 可动画高斯人体工作提供渲染骨架与对照。
- 手语理解/生成数据集与多视角人体集分别缺了对方的关键要素,衬托 MVSign 定位。
- SGNify、Neural Sign Actors 构成手语 SMPL-X 拟合参照。