快速导读:HetA-DiT 用轻量不确定性分支按 token 去噪难度把可靠区域交给局部注意力、困难区域交给稠密注意力,在 DMD 少步视频扩散上用约 20% 稠密计算保持接近基线的质量。
视频 DiT 的自注意力随时空 token 数平方增长,而现有加速几乎都把同一步里的每个 token 一视同仁。实际上天空、静背景等平滑区域很早就能靠局部上下文估稳,运动边界、遮挡、人脸手部等细结构却更久需要全局上下文,并且“谁更难”会随去噪步、提示词与运动变化。
HetA-DiT(Where Compute Matters,arXiv:2609.31050 ,PDF https://arxiv.org/pdf/2609.31050 ,Qualcomm AI Research / University of Bonn)给少步 DMD 视频扩散加了一个轻量不确定性分支:高不确定 token 走稠密全局注意力,更可靠 token 走便宜局部注意力,并用上一去噪步的不确定性在推理时复用路由,不额外再跑一遍 Transformer。大约 20% token 走稠密路径时,仍能在 VBench 系列与人工偏好上贴近稠密基线。
英文题目:Where Compute Matters: Heterogeneous Attention for Efficient Video Diffusion
论文出处:arXiv 每日论文精选 · arXiv:2609.31050
原始论文:PDF / 论文页面
这篇论文解决什么问题?
步数蒸馏(如 DMD)把采样压到极少步,缓存类方法依赖多步冗余,恰恰在低步部署里失效;固定稀疏、可学习稀疏或线性注意力则通常对所有 token 套同一算子。
MoE-DiT 多半只在 FFN 上分流,而视频里注意力才是主开销(文中举例 Wan2.2 约 82% 算力在自注意力)。训练免费自适应稀疏往往省算力但质量可见下滑。
缺口因此很清楚:需要一种注意力级、软性、且与少步 DMD 兼容的按 token 算力分配,而不是“全体一起变便宜”或“硬缓存跳过”。
核心创新
- 指出统一算力与硬缓存在少步视频扩散中的缺口。
- 不确定性引导的异构注意力:可靠 token 局部、困难 token 稠密,单参数调节折中。
- 与 DMD 少步蒸馏显式兼容,推理不增加额外 Transformer 评估。
- 在 Wan2.2/2.1 上用 VBench、VBench-2.0 与大规模盲测验证质量-效率。
方法概览
两阶段:先以不确定性感知损失训练不确定性分支;再冻结分支,用自适应阈值路由稠密/局部注意力并 DMD 微调。推理复用上一步不确定性,无额外 Transformer 前向。
- 阶段一:在 DMD 学生上增加不确定性分支,对每个噪声 latent 同时预测干净样本与非负逐 token 不确定性;用不确定性加权的高斯负对数似然改写 DMD 梯度(重建项 + log 方差正则),让误差大的位置学到更高不确定。
- 阶段二:冻结不确定性分支,按每步均值/标准差设阈值 T(τ)=μ+cσ,构造路由掩码:不确定 token 走 Attn_dense,可靠 token 走 Attn_local;块内再把部分确定/不确定 token 互换以提高全局覆盖。掩码用于下一步 τ−Δ,推理时复用上一步预测,无额外 Transformer 评估。
- 局部注意力采用三维邻域(默认 11×11×11);超参 c 控制稠密比例,实验主设置约 ρ≈0.2。再用标准 DMD 目标微调稀疏化后的 DiT。训练可用额外无梯度全注意力前向估计路由,但部署不需要。
- 实现上与 FlexAttention 等块稀疏内核结合以兑现墙钟加速;可插到 Wan 等 Transformer 视频扩散骨干,并在 3 步蒸馏设定下评测。
逐图理解论文
均匀加速的局限
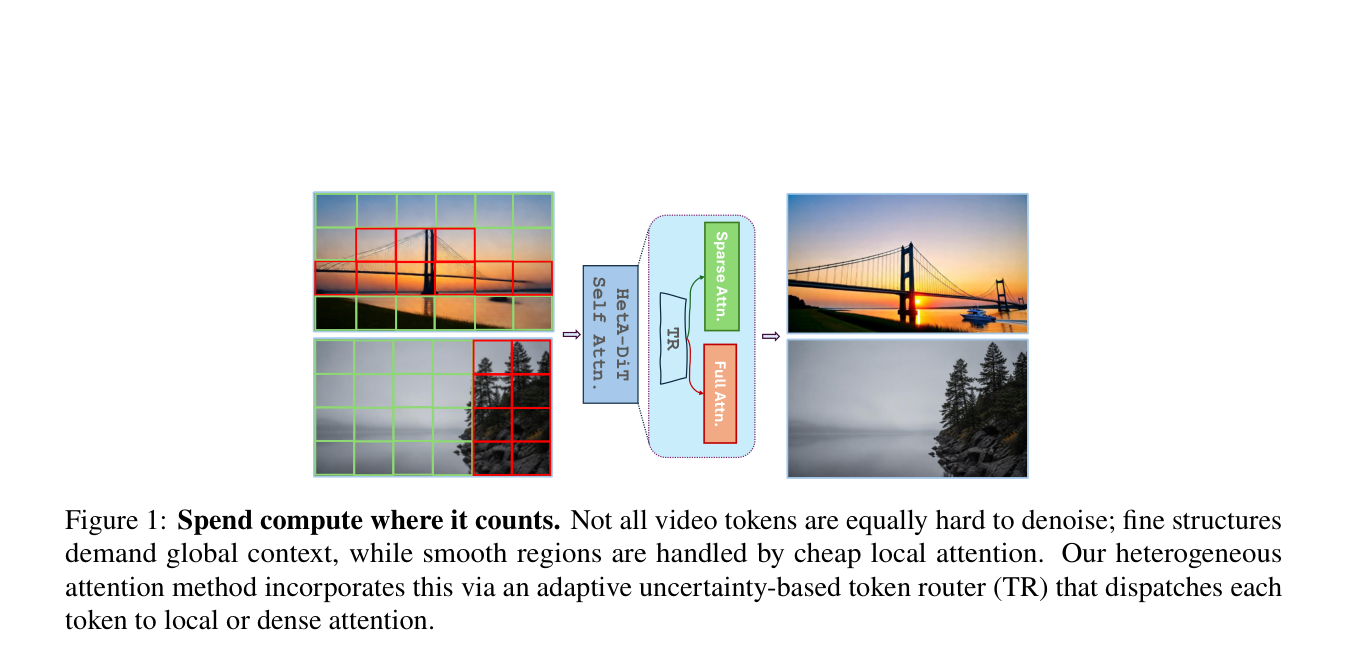
图1用桥与海岸例子说明“算力花在刀刃上”:细结构块标红走 Full Attn,平滑区域标绿走 Sparse/Local Attn,中间 TR 路由器按不确定性分发。适合开篇直觉图。
不确定性路由
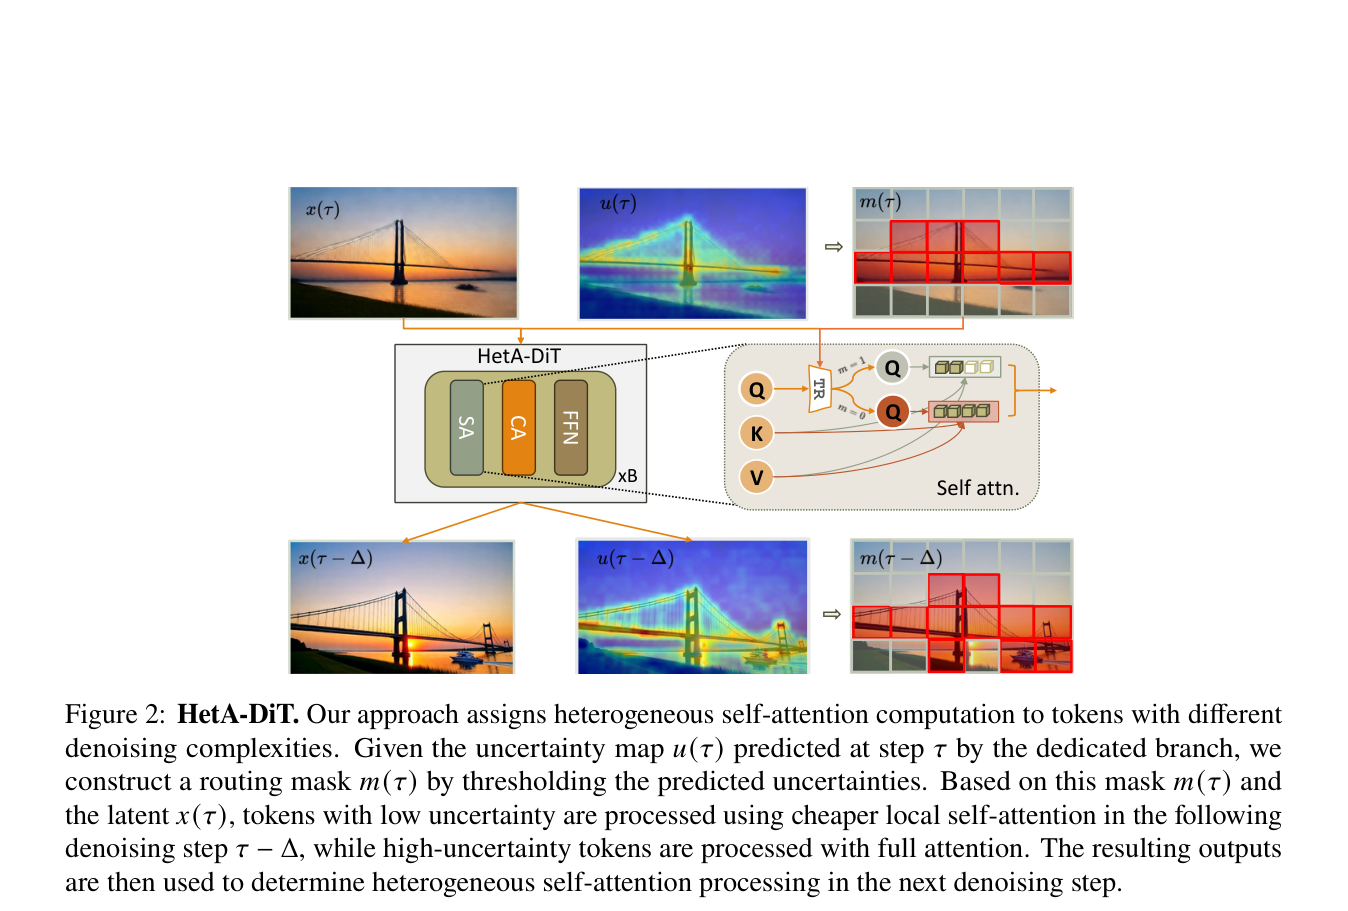
图2是算法主图:由 u(τ) 阈值得到 m(τ),在下一步对高不确定 token 做全注意力、低不确定做局部注意力,并在 HetA-DiT 块的 SA 路径里合流;随后再更新下一步路由。适合讲方法细节。
质量证据
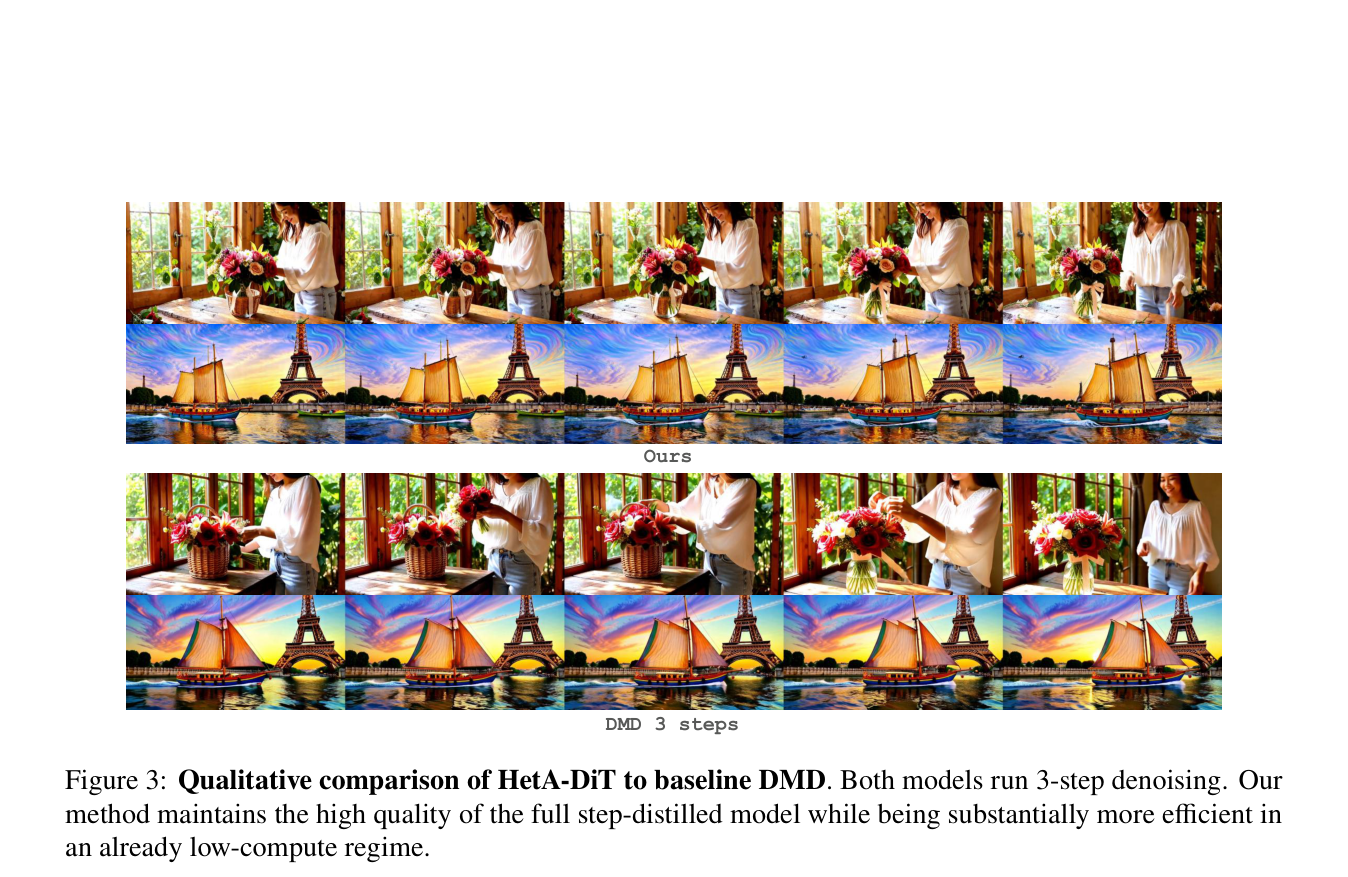
图3在同为 3 步去噪下对比 Ours 与稠密 DMD:插花与埃菲尔铁塔帆船片段显示 HetA 仍保持细节与时序观感,支撑“少步且稀疏仍接近稠密质量”的主张。
实验如何设计?
- 基座:DMD 蒸馏的 Wan2.2-5B(约 704p,121×704×1280)与 Wan2.1-1.3B(480p,81×480×832);推理统一 3 步。
- 指标:完整扩展 VBench 与 VBench-2.0;方法盲测人工偏好共 1248 对、19 名评估者;DeepSpeed FLOPs 与 FlexAttention 延迟剖析。
- 对照:稠密 DMD 2/3 步、Attention Surgery、ReHyAt、VSA、ToCa、Jenga、STA 等;消融含随机/固定路由、纯局部、邻域尺寸与不同局部比例。
关键结果与论文证据
- VBench(Wan2.2 设定)上 DMD3s-HetA-DiT 总分 83.28,与稠密 Wan2.2 5B 的 83.28 持平,并高于多种高效基线;相对 3 步稠密 DMD(82.94)在总分与语义上更好或可比。
- Wan2.1 设定下 HetA 总分 83.10,贴近 DMD3s 的 83.61 与原版 Wan2.1。VBench-2.0 上 HetA 总分 58.9,介于/接近 DMD3s(60.8)与全量 Wan 系结果。
- 人工偏好:相对 DMD2s 获 50% 对 26%;相对 Attention Surgery 获 68% 对 19%;相对 DMD3s 为 32% 对 36%(接近),说明在已少步设定下仍难被轻易区分。
- 效率:平均约 20% token 稠密时,Wan2.2-5B@704p 注意力/块级 FLOPs 约降 4.85×/1.73×,延迟约 1.84×/1.63×;c=0.9、约 80% 局部是质量-速度甜点。不确定性路由优于随机与固定均匀路由。
阅读时需要注意
- 把局部比例推到约 90% 会继续加速但分数下降,存在明确折中。
- 训练仍需两阶段与教师分数,调参成本虽远低于预训练,但不是训练免费。
- 人工偏好相对最强 3 步稠密 DMD 未全面占优;结果主要验证 Wan 系 DMD 设定,迁移到其他骨干需再验证。
关联工作
- DMD 及后续少步蒸馏定义了现代视频部署的主战场;STA、VSA、SLA、SANA-Video、ReHyAt、Attention Surgery 等代表“统一变便宜”的注意力路线。
- ToCa/LiteAttention 等缓存依赖多步冗余;MoE-DiT 多在 FFN 分流,与本文注意力级路由互补。
- VBench/VBench-2.0 与盲测偏好共同构成质量证据链。