快速导读:以皮肤科为试验场,揭示医疗VLM强视觉编码器与端到端零样本诊断之间的性能缺口,并用免微调的描述—决策与编码器辅助重排收窄差距;明确非临床可用产品。
医疗视觉语言模型常被期待既能准确判读影像,又能给出可解释推理。但若视觉编码器本身已很强,完整多模态链路却在零样本诊断上明显落后,就说明端到端模型可能没有真正用好自己的“眼睛”。
本文(arXiv:2609.36557 ,Tulane / Oak Ridge)以皮肤科为主要试验场,系统审计MedGemma一类医疗VLM对其MedSigLIP视觉编码器的利用不足:编码器线性探测甚至在零目标标签设定下平均高出完整VLM约10.26个百分点;并提出冻结VLM的推理期干预。务必强调:这是研究审计与方法学分析,不是临床可用产品或诊室决策系统。
英文题目:How Medical VLMs Underutilize Their Vision Encoders: A Dermatology Perspective
论文出处:arXiv 每日论文精选 · arXiv:2609.36557
原始论文:PDF / 论文页面
这篇论文解决什么问题?
皮肤影像存在细微类间差异与成像条件不统一,部署到安全关键场景时,模型不仅要报类别,还要保证推理落在可见证据上,而不是事后用教科书式描述粉饰语言先验。
DermLIP、MONET、SkinVL、SkinGPT-4等专域工作强调大规模图文预训练与可解释诊断;MedGemma则把医学调优编码器与Gemma 3式语言推理结合。矛盾在于:强编码器表征未必自动兑现为端到端零样本准确率。
因此需要回答两个问题:缺口来自何处?能否在不微调VLM的前提下用推理策略收窄缺口?论文明确以皮肤科公开基准做审计,并用其他医学模态提供表征与注意力旁证。
核心创新
- 在零目标标签设定下系统量化编码器—VLM诊断缺口,并与图像ICL、线性探测、编码器辅助推理对照。
- 提出三类假设并用受控提示与注意力分析关联干预效果;DtD使生成期视觉注意力相对提升约30–40%。
- 组合免标签提示与低标签编码器辅助重排、保持VLM冻结,在多个皮肤科骨干上提升Top-1;明确研究审计而非临床产品。
方法概览
以MedGemma-4B与皮肤科数据集为主试验场,检验三类假设:训练分布偏移、视觉支路欠利用、编解码目标错位。对应干预包括:临床描述上下文、describe-then-decide(DtD)提示、以及8-shot线性探测候选的Top-5到Top-1重排;全程冻结VLM。并用Vision Attention Ratio(VAR)机制分析生成期视觉注意力。再在SkinVL、InternVL3/3.5、biomed-Qwen等骨干与其他医学模态上验证。
- 主试验床是MedGemma-4B及其MedSigLIP编码器,数据集覆盖Derm7pt、eSkinHealth、Fitzpatrick17k、SD-260与PAD-UFES-20。先用零目标标签对照与少样本线性探测证明视觉表征本身足够强。
- 假设1关注训练分布偏移:混淆矩阵显示模型强烈过预测常见病如BCC,甚至把狼疮等几乎全错成BCC;但模型仍能口头描述这些疾病概念,提示问题不全在“不知道病名”。
- 假设2关注视觉欠利用与幻觉:图3显示结节病、黑色素瘤被误报为BCC,并编造“珍珠样/蜡样”等未见特征;遮挡病灶后仍有约88%不拒答。对应提出DtD:先描述可见皮损特征再诊断。
- 假设3与组合策略:用临床描述上下文改善概念对齐,再用8-shot线性探测给出Top-5候选,由冻结VLM做Top-5到Top-1重排;消融比较DA、in-context、DtD、重排与全部组合。机制上定义VAR,比较DA与DtD在34层上的视觉注意力。
逐图理解论文
性能缺口
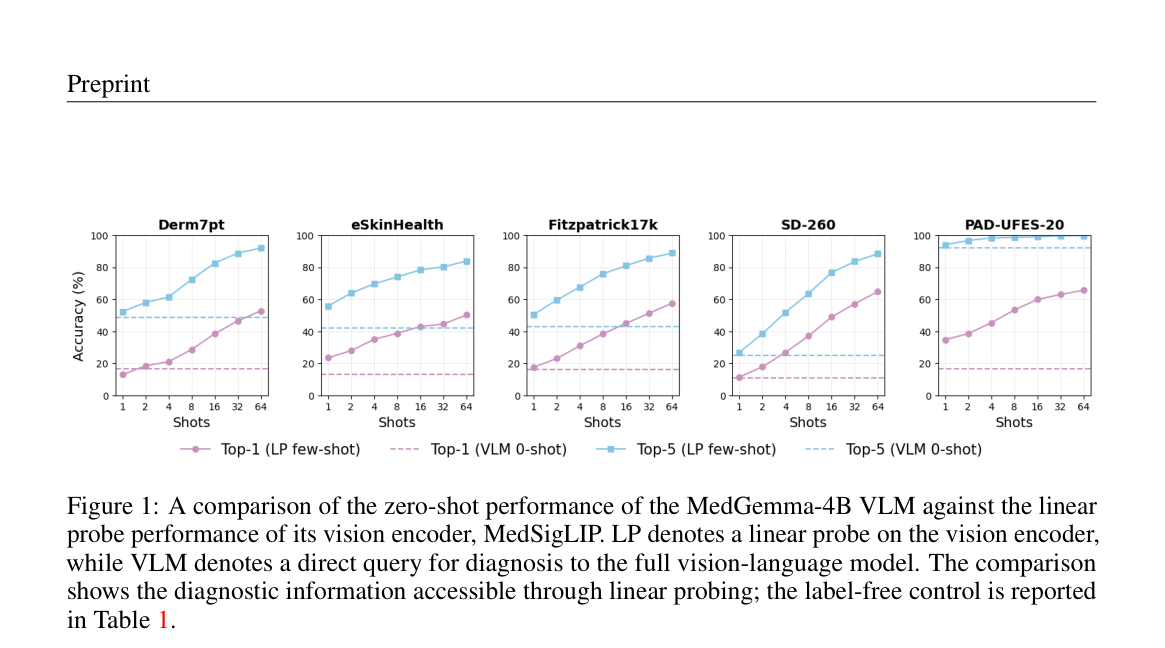
图1在五个皮肤科数据集上对比MedGemma-4B零样本与MedSigLIP少样本线性探测:实线随shot上升,虚线为VLM零样本基准;多数数据集上几个shot内LP Top-1即可超过VLM,直观展示编码器—VLM缺口。宜作特色图。
幻觉与欠利用
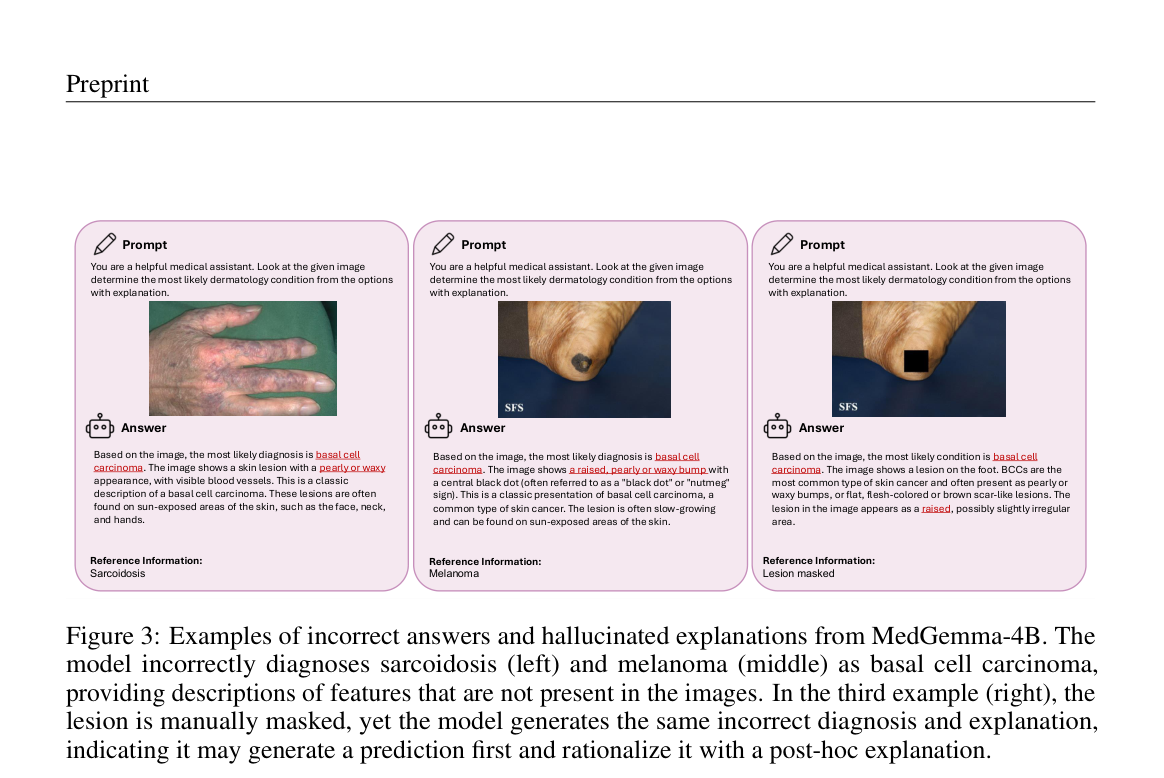
图3给出错诊与幻觉证据:结节病与黑色素瘤被报成BCC并编造未见特征;右侧病灶被黑块遮挡后仍输出同类诊断,说明可能先预测再事后合理化。
推理期干预
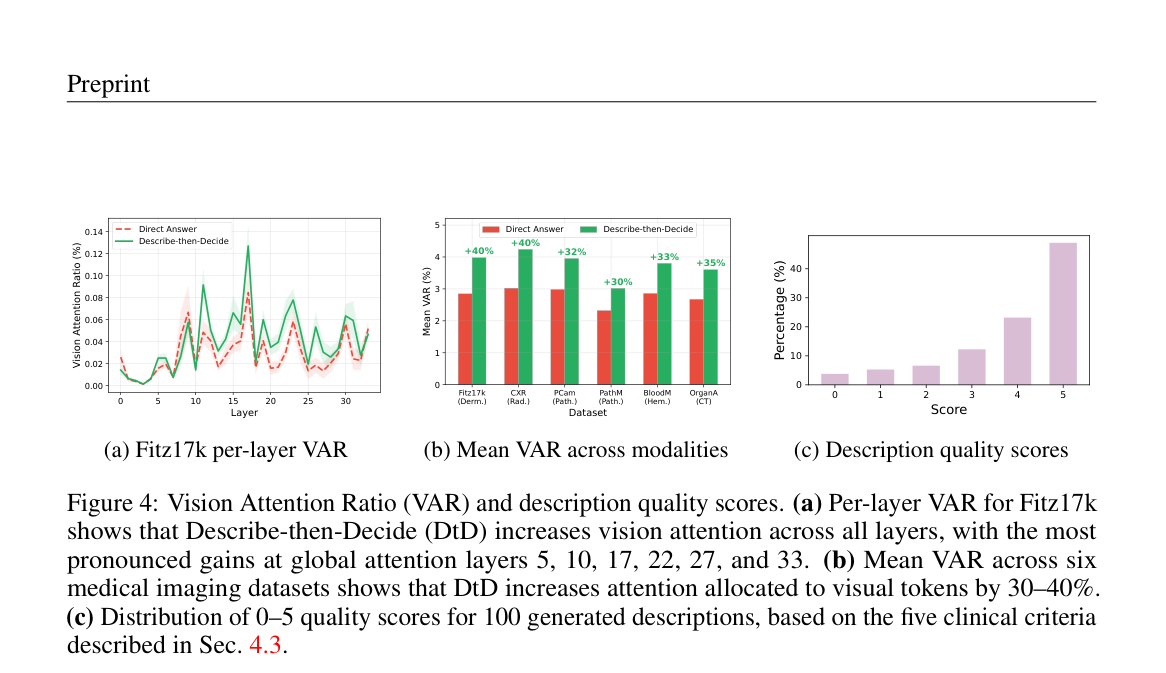
图4从机制解释DtD:逐层VAR整体抬升,全局注意力层增益最大;跨六模态均值提升约30–40%;右侧显示生成描述质量分偏高。
实验如何设计?
- 零标签列比较VLM直接问答与MedSigLIP零标签协议;8-shot列比较图像ICL、线性探测与探测辅助重排(Table 1)。
- 提示内容控制:仅类名、类对齐临床描述、长度匹配泛化文本、打乱描述(Table 2)。
- 五配置消融与跨骨干迁移(Table 3–5);SkinVL、InternVL3/3.5、biomed-Qwen复现同类增益。
- 机制评测:每数据集100张测试图提全注意力;另在CXR、病理、血液与腹部CT模态报告线性探测与VAR。
关键结果与论文证据
- Fig.1与Table 1显示:少样本线性探测很快超过VLM零样本Top-1;零标签设定下编码器仍系统领先,缺口不是“多给几张标签就能消失”的假象。
- Table 3:组合策略把Derm7pt从16.46%提到38.27%,eSkinHealth从13.35%到48.00%,Fitzpatrick17k从16.73%到40.97%,PAD-UFES-20从46.22%到84.68%。
- Fig.4:Fitz17k上DA的VAR仅2.85%,DtD到3.98%(相对+40%);跨六模态平均视觉注意力提升约30–40%,且描述质量分偏高。
- 跨骨干与跨模态旁证支持“视觉表征强、端到端利用弱”可复现;但微调可能损跨域VQA,故作者偏向冻结VLM的推理干预。
阅读时需要注意
- 结果不能当作临床诊断性能认证;公开基准分布、提示模板与评测协议都与真实诊室工作流不同。
- 完整组合管线依赖少量标签拟合探针;纯免标签路径(描述/DtD)增益通常小于组合策略。
- 注意力分析与幻觉案例以MedGemma-4B为主,其他骨干的机制同构性仍需更细证据。
关联工作
- MedGemma / MedSigLIP / Gemma 3 提供主审计对象。
- DermLIP、MONET、SkinVL、SkinGPT-4 代表皮肤科可解释VLM路线。
- PanDerm、BiomedCLIP 等用于编码器与零样本对照。