快速导读:VTR-Bench 用 300 条场景提示把画面文字与场景运动拆开评测,11 个模型最低总体 WER 仍为 0.250,关键帧 Director Agent 可在同一生成器上继续降错。
视频生成已经能做出接近电影感的画面,但场景里的字经常是另一回事。广告海报、实验参数、界面文案一旦拼错或改写,视频看起来再真,信息也是错的。现有基准多打画质、构图和物理合理,对更长段落、多个载体上的规定文字覆盖不足。
VTR-Bench(arXiv:2610.01499,香港城市大学数据科学系 / 港科广 / 西湖大学等)用 300 条精心构造的提示覆盖广告、科学、用户界面、文化与日常生活,把文字保真(WER)和场景运动满足度(Video Score)拆开自动评。作者还给出关键帧引导的 Director Agent,用视觉反馈迭代精修首帧与运动。代码见https://github.com/hardenyu21/VTR-Bench
英文题目:VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2610.01499
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1用 Seedance2.5 的约十秒丝网印刷广告把问题钉死:Video Score 0.90,清单上的场景和动作大多满足,WER 却是 0.552。标题 Urban Greens 变成 A PosterER Series,algae/vivid 被写错,小字难以辨认,油墨标签重复且写错 CO2-neutral。好看不等于写对。
相关工作里,VBench、EvalCrafter、Video-Bench 覆盖质量与提示对齐;T2VTextBench 与 AVGen-Bench 开始看屏幕文字,但目标偏短,前者还全靠人工,难以反复评新模型。VTR-Bench 要把多个文字块、从短标签到较长段落,都放进具体应用场景里自动打分。
因此方法必须同时回答三件事:提示如何保证文字与载体可被画进连贯场景;如何把“字对不对”和“场景对不对”分开;推理时能否在不改生成器权重的前提下把字改对。
核心创新
- 把规定文字嵌入五类应用场景,显式给出内容与载体,使视觉文字成为可单独打分的能力维。
- 用载体级转录加提示级 20 题清单,把文字保真与场景/运动满足度解耦,并做人机对齐。
- 用关键帧 Director Agent 在推理时迭代精修首帧与运动,同一生成器上同时改进 WER 与 Video Score。
方法概览
人工先定广告、科学、界面、文化、日常生活五类场景,GPT-5.6 生成种子,DeepSeek-V4-Flash 写成带参考字符串与载体标注的完整提示;Qwen-Image 每次出三张参考图,VLM 做可行性检查,连续三次失败则重写,最后人工审核,得到 300 条提示、1202 个文字块。评价分两支:GPT-5.6 设计并经人工审的 20 题 chain of query 得到 Video Score;VLM 按载体从最清晰帧转录,用保留大小写、符号与单字汉字的分词器算有界 WER(默认 α=5)。另提出 Keyframe-Guided Agentic Framework:Director Agent 先精修首帧与运动计划,再把选中首帧、原提示和运动计划交给同一视频生成器。
- 构造上,专家先定五类场景。GPT-5.6 生成核心场景、文字用途与候选载体种子,人工筛选去重。DeepSeek-V4-Flash 写成完整提示,标明参考字符串和载体。可行性环每次用 Qwen-Image 出三张参考图,VLM 检查能否容纳文字与载体;不通过就改提示,连续三次失败则整段重写,通过后再经最终人工审核。成品是 300 条、每类 60,共 1202 个文字块,百分之九十四点三的提示要求三到五块;整段文本长度中位数 102.5 token,块长度中位数 23。
- 评价分两支。Video Score:每条提示有 20 个经人工审的是否题,覆盖 Scene Attributes、Motion Adherence、Spatial Relationship、Entity Presence、Temporal Consistency,分数是满足比例。文字支:VLM 按载体描述在最清晰出现处转录,参考文本从生成提示中遮掉;不可读或缺失记空串。分词器保留大小写、有内容符号和单个汉字,忽略普通标点。有界 WER 允许假设比参考多 α 个 token,默认 α=5,再对编辑距离封顶到 1。
- Keyframe-Guided Agentic Framework 把 Director Agent 插在生成器前面。Agent 先写图像提示、比较候选首帧,可改提示、局部编辑或重绘,选出文字更准的第一帧;再写运动计划(主体动作、相机、时间进程),把选中首帧、原提示和运动计划交给同一视频生成器;VLM 抽帧检查文字稳定与载体存续,再决定改运动或重生成。I2V 与 Agentic 评测前都去掉生成视频的第一帧,避免把精修静帧直接算进分数。
逐图理解论文
解耦评测
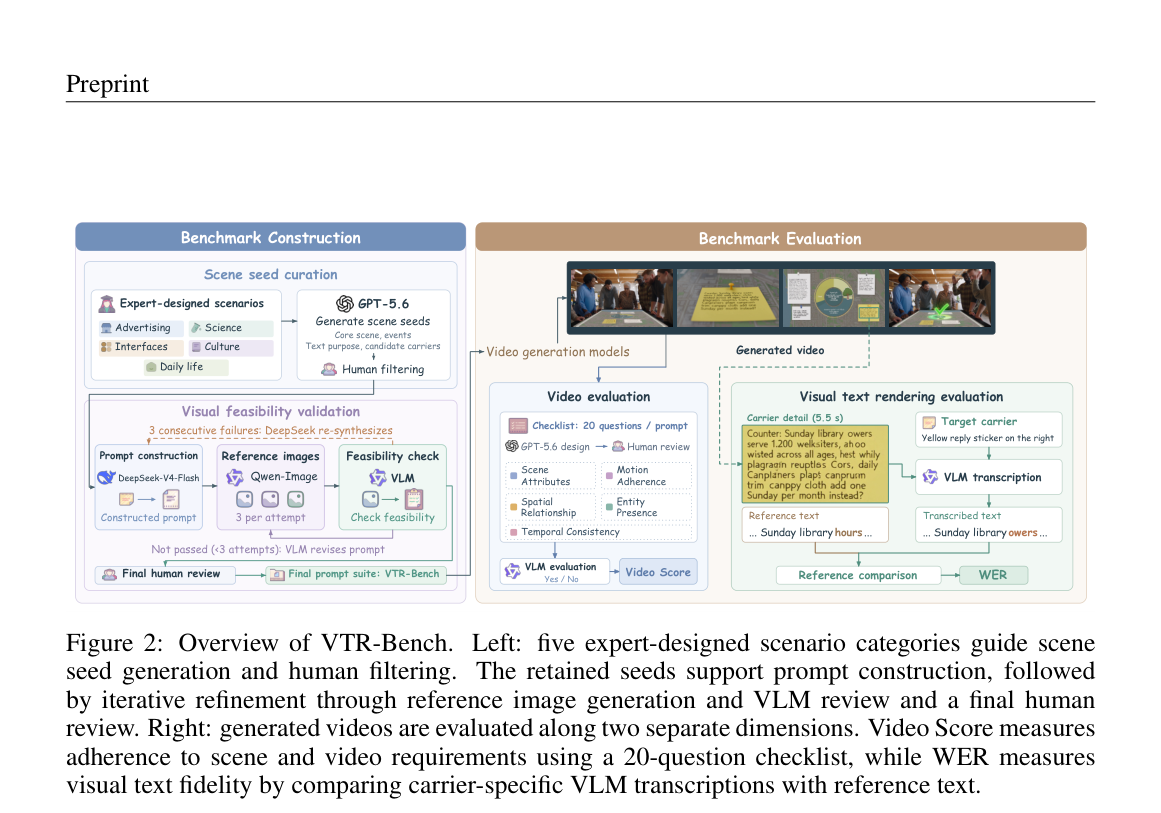
图2是基准总览,宜作特色图。左列 Benchmark Construction:五类专家场景→GPT-5.6 种子→人工过滤,再经 DeepSeek-V4-Flash 写提示、Qwen-Image 三张参考图、VLM 可行性与最终人工审核。右列 Benchmark Evaluation 分两支:20 题清单得 Video Score;按载体做 VLM 转录后与参考比 WER,示例把 Sunday library hours 写成 owers。
关键帧 Agent
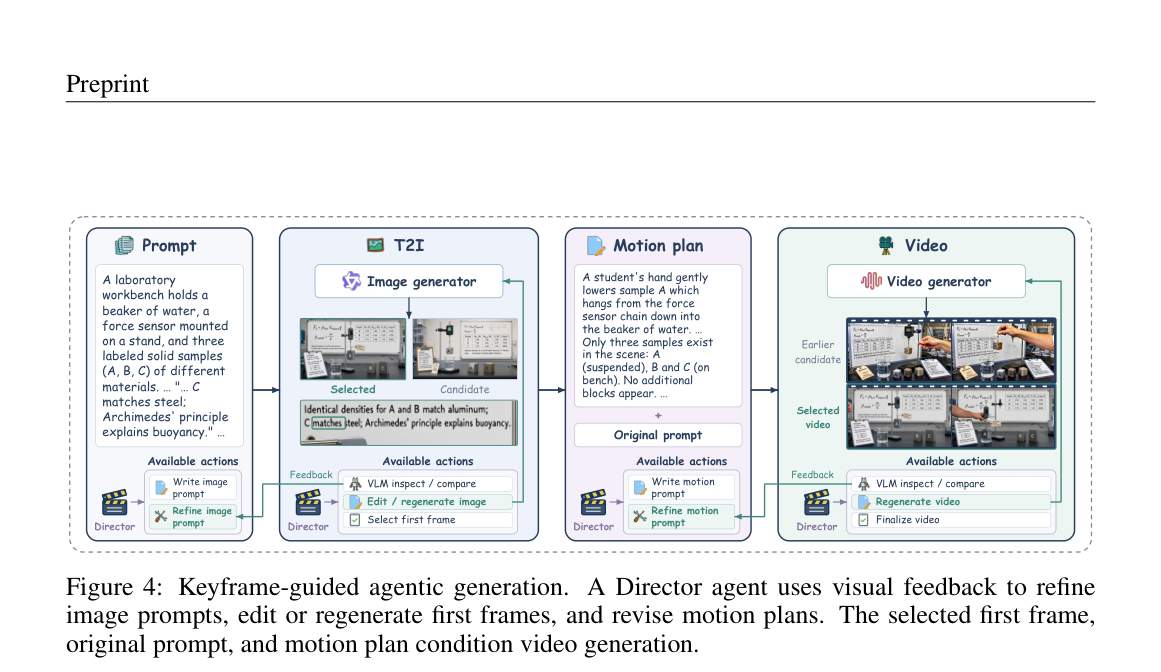
图4是关键帧引导的 Director Agent 流程。四段:Prompt 写实验室阿基米德浮力与样品 A/B/C;T2I 用图像生成器出候选首帧,VLM 检查后可选编辑/重绘/选定;Motion plan 描述手把样品 A 放入烧杯;Video 用同一视频生成器,结合选中首帧、原提示与运动计划,再比较候选并定稿。每段底部都有 Director 可用动作与视觉反馈环。
关键证据
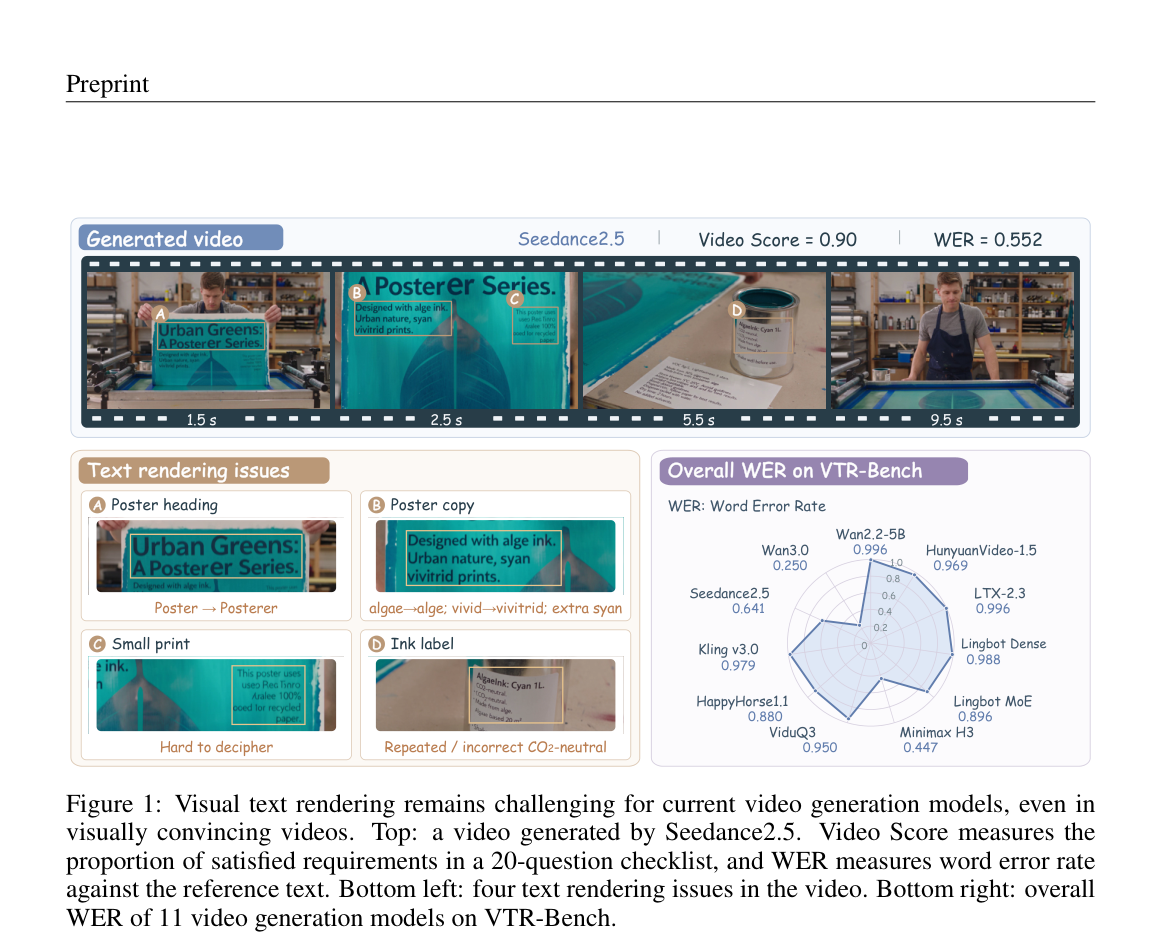
图1是问题总览。顶栏 Seedance2.5 胶片四帧(1.5s/2.5s/5.5s/9.5s),标 Video Score=0.90、WER=0.552。左下四个错误:A 标题 Poster→Posterer;B 文案 algae→alge、vivid→vivitrid、多出 syan;C 小字难辨;D 油墨标签重复/写错 CO2-neutral。右下雷达给出 11 模型总体 WER,Wan3.0 0.250 最低,多数模型 0.88–1.0。
实验如何设计?
- 开源:Wan2.2-5B、HunyuanVideo-1.5、LTX-2.3、Lingbot Dense/MoE、Minimax H3,经 vllm-omni,默认最优设置,时长统一。专有:ViduQ3、HappyHorse1.1、Kling v3.0、Seedance2.5、Wan3.0,720p。视频统一 10 秒、24 FPS,生成在 H20,评价在 A800。主评价器为 Qwen3.8-27B。
- 失败分析比较 Minimax H3 与 LTX-2.3 的高/低分辨率×长/短时长四组合;并对 13213 个目标统计载体未找到、整段不可读、已转录。Agent 实验只在 Minimax H3 上对比 Original、I2V 与完整 Agentic;Director 与 VLM 为 Qwen3.7-plus,生图为 Qwen-Image-3.0。
- 人机对齐抽 100 条视频(偏向 Seedance2.5、Minimax H3、Wan3.0 这类可转录且 WER 相对低的模型),覆盖 2000 题 CoQ 与 404 文字块,三标注者多数票为参考。
关键结果与论文证据
- 视觉文字仍然难。Table 1 里总体 WER 最低是 Wan3.0 的 0.250,Video Score 0.849;多数开源模型 WER 接近上限,Minimax H3 以 0.447 / 0.756 成为开源组文字最好。专有模型内差也很大:HappyHorse、Vidu、Kling 的 WER 在 0.88–0.98,并不自动强于 H3(页6–7)。
- 高 Video Score 推不出字对。Kling v3.0 与 Seedance2.5 的 Video Score 都约 0.79,WER 却是 0.979 对 0.641。Minimax H3 的 Video Score 低于多数专有模型,文字却更好。场景、实体和空间关系都可以对,文案仍可以错(页7)。
- 分辨率帮强者不帮弱者。Fig.5 中 Minimax H3 提高分辨率后 WER 下降(高长 0.4468,低短 0.6092);LTX-2.3 四种配置 WER 都约 0.995。缩短时长也没有稳定改善。13213 个目标里,整段不可读 23.31%,载体未找到 9.34%;Kling 转录覆盖约百分之八十但 WER 仍 0.979,可转录不等于写对(页7–8)。
- 推理时精修有效。完整 Agent 框架把 H3 总体 WER 从 0.4468 降到 0.3015(相对降 32.5%),Video Score 从 0.7562 升到 0.8315,五类场景相对直接生成都更好。相对只喂首帧的 I2V,完整框架再降 9.4% WER,并在每类拿到最高 Video Score;UI 上 I2V 的 WER 最低,说明运动规划与首帧条件化的收益不完全重合(页8–9)。人机上 CoQ 一致率 92.15%,视频级 WER 的 Pearson 0.9842、CCC 0.9835。
阅读时需要注意
- Agent 框架未在弱文字模型上复现;对 LTX-2.3 这类几乎写不出可读字的系统,改分辨率和时长都不够。
- 自动评价依赖 VLM 是否题与转录,人机相关性高,但仍可能与专用 OCR 或不同评价器有偏差;附录用 Qwen3.6-27B 做了对照。
- 失败案例与 Fig.1 为展示用挑选;300 条提示不能覆盖全部真实广告或界面。预印本,未同行评审。
关联工作
- 通用视频基准把文字当作提示对齐的一小项;T2VTextBench 证明屏幕文字值得单独测,但扩展性受限。VTR-Bench 把载体、参考字符串和场景清单写成可自动复评的协议。
- HunyuanVideo 的字形编码、合成文本视频微调等是训练侧补丁;本文的 Director Agent 是推理时补丁,不改生成器权重。
- 结论把视觉文字写成视频的信息功能:不仅要像,还要把用户规定的内容写对。后续可沿场景复杂度、文字密度与运动来拆保真度。