快速导读:DMAD 用两个分类头直接学习对数密度比,把分布匹配蒸馏改成对抗训练,从而去掉学生分数拟合与在线教师评估。
扩散模型画质已经很高,但采样要沿着噪声链走很多步。少步蒸馏想把教师压成几次前向,一条路逼学生沿教师轨迹走,另一条路只匹配输出分布。DMD 走后一条:用冻结教师和学生 critic 分别估分数,再用二者之差更新学生。critic 一旦落后,误差会淹没真正的分数差;DMD2 用五次 critic 换一次学生更新来续命,却更贵,还要在线跑教师。
DMAD(arXiv:2610.02188,Texas A&M 与字节跳动 Intelligent Creation)把这件事改成两个分类任务。共享骨干上的教师头和真实头区分“教师/真实 vs 学生”,对学生样本的线性 logit 损失在最优时恢复与 DMD 相同的分布匹配梯度。教师视频或图像可以预先生成并缓存,判别器与学生 1:1 更新。项目见https://yzmblog.github.io/projects/DMAD。
英文题目:DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation
论文出处:arXiv 每日论文精选 · arXiv:2610.02188
原始论文:PDF / 论文页面
这篇论文解决什么问题?
分数差看起来干净,实现上却要维持一个始终跟踪学生分布的扩散 critic。图2 用两个相邻高斯混合、学生分布固定、解析梯度已知的玩具场做对照:DMD 的分数差箭头又乱又冲,NMSE 1.539;单头 logit 梯度更贴真值,NMSE 0.144。这说明分开估两个大分数再相减,相对误差可以大于信号本身。
已有工作往往把对抗项当作分数目标的附加稳定器,判别器仍受去噪任务约束。DMAD 反过来:分类 logit 就是匹配梯度,判别器可以接扩散编码器或分类特征,而不必再做去噪。
只有教师样本会把学生上限钉在教师保真度上;引入真实数据头,才可能在 ImageNet 与 COCO 上超过教师。两个头在不同噪声水平上的相对可信度还不一样,所以还要按间隙调教师权重。
核心创新
- 把 DMD 的分数差改写成分类 logit,证明最优判别器恢复同一分布匹配梯度,从而取消辅助分数网络。
- 用教师样本与真实数据两个头联合匹配,线性损失驱动少步学生,并缓存教师样本、1:1 更新。
- 用真实头的带级 logit 间隙自适应重加权教师监督(gap-based reweighting)。
- 在 ImageNet 一步、SDXL 四步、Wan 与 MiniMax-H3 四步上对照少步方法与多步教师。
方法概览
从 DMD 的反向 KL / 分数差更新出发,命题1证明无约束 BCE 最优 logit 等于 log pt−log pθ,t,其对输入的梯度就是 sp−sθ,从而对学生输出的线性损失 −E[h] 与理想分布匹配梯度相同。实现上共享骨干 Fϕ 接两个头:hT 区分教师样本与学生样本,hR 区分真实数据与学生样本,判别器损失为两项平衡 BCE 之和;生成器损失是 −E[λT ωi hT(G)+λR hR(G)]。教师样本可预先缓存,训练不再在线跑教师,判别器与学生 1:1 更新。真实头在各噪声带上对真实与教师样本的均值 logit 间隙做 EMA,间隙小的噪声带给更大教师权重 ωi(gap-based reweighting),反传时停止间隙统计的梯度。图像与视频流程相同,只改判别头以适应骨干。
- 形式化从反向 KL 的分数差更新出发。命题1:平衡 BCE 的无约束最优 logit 是 log pt−log pθ,t,输入梯度等于 sp−sθ;固定判别器时,对学生输出的线性损失 −E[h] 与理想 LDM 梯度相同。非饱和损失 −log D 会再乘 1−D,相当于对样本加权,作者更偏向线性损失。
- 实现上,噪声 z 经少步学生 Gθ 得到样本,与缓存的教师样本、真实样本一起做前向加噪。共享 Fϕ(·,t,c) 分出 hT 与 hR。判别器最小化两项 BCE:教师正/学生负,真实正/学生负。生成器最小化 −λT ωi hT(G)−λR hR(G)。图3 用猫沙发视频画出这条计算图:品红虚线是学生反传,紫虚线是判别器反传,实线 sg 切断间隙权重的梯度。
- 间隙重加权把噪声分成带,对每带维护真实头在真实样本与教师样本上的均值 logit 差的 EMA(β=0.99)。差小于各带中位数的噪声带得到更大教师权重,经 sigmoid 温度 τ 后按 batch 或带均值归一。ImageNet/SDXL 与 Wan、MiniMax-H3 的归一地板略有不同。消融里关掉该机制会让 COCO FID 从 14.47 升到 16.62,VBench Total 掉 1.14。
逐图理解论文
分数差的代价
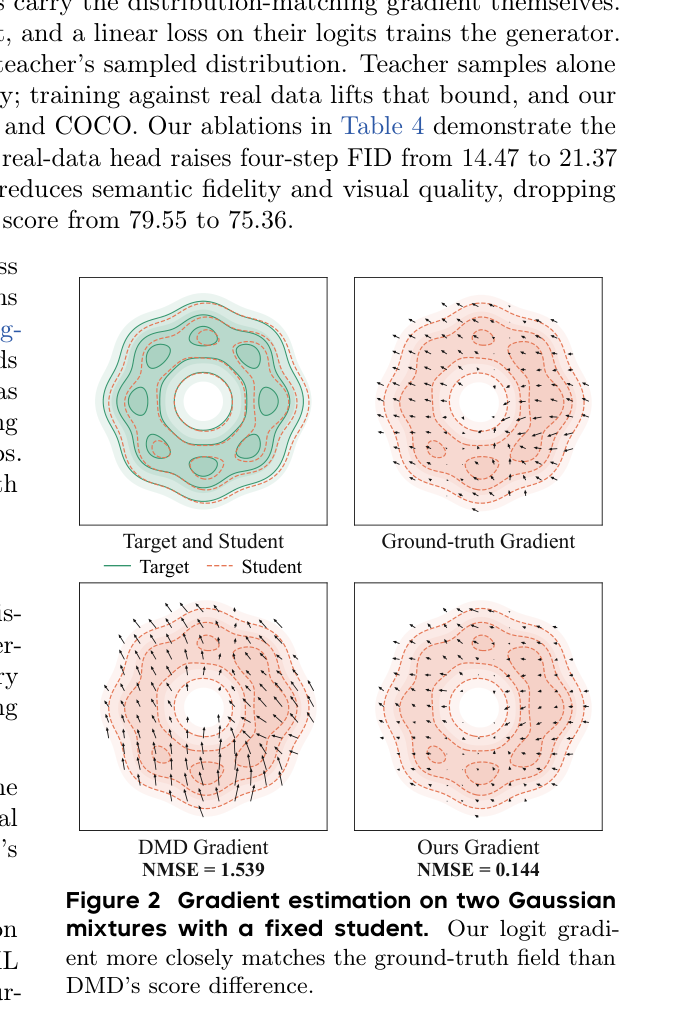
图2是固定学生时的二维高斯混合梯度场。左上 Target 为青绿花瓣状等高线,Student 为红虚线,略有偏移;右上 Ground-truth Gradient 箭头沿法向。左下 DMD Gradient 箭头杂乱,标 NMSE=1.539;右下 Ours Gradient 与真值同向,NMSE=0.144。裁切左侧带有正文残句,读图时忽略。
对抗式匹配
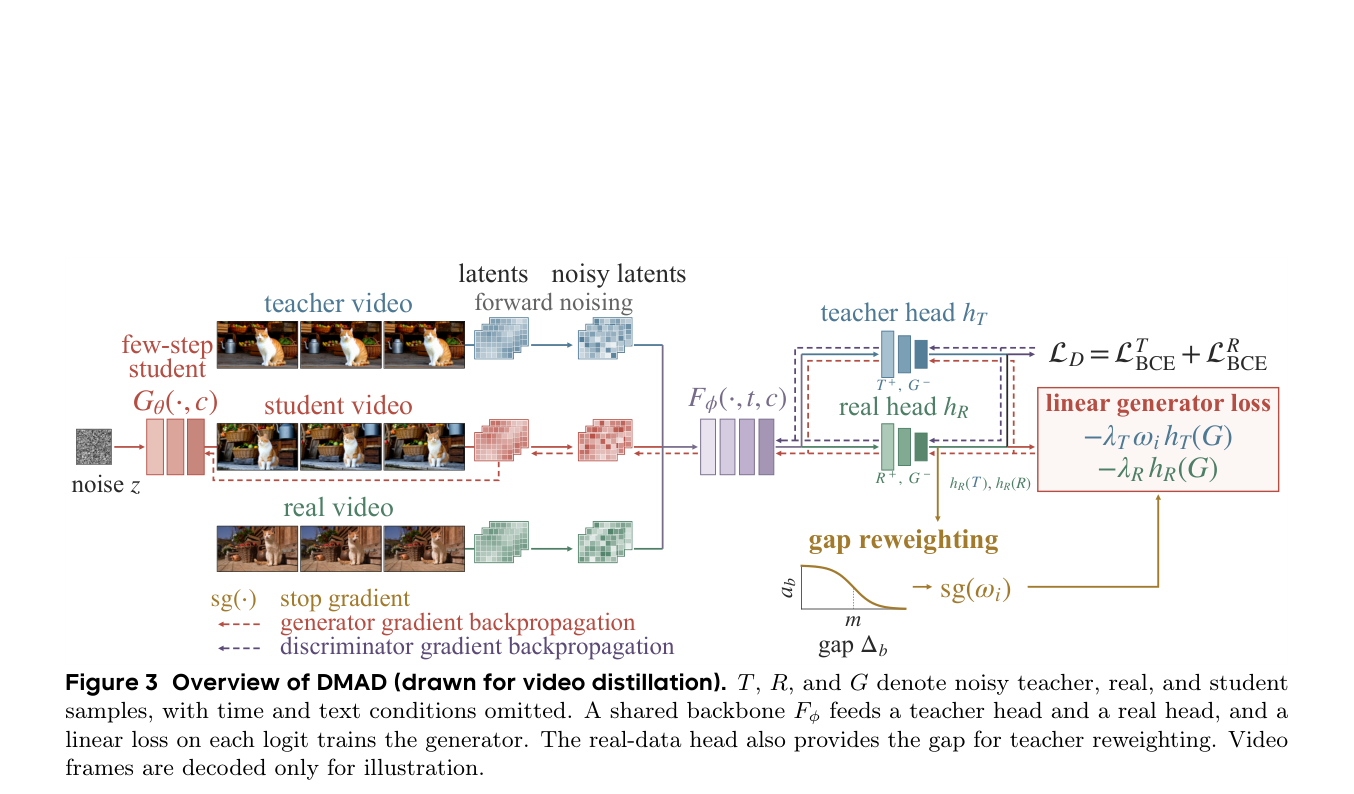
图3是视频蒸馏总览,宜作特色图。左列噪声 z 经红色少步学生得到猫沙发视频,上为教师视频、下为真实室内猫视频,三者加噪成蓝/红/绿潜变量,进入紫色共享骨干 Fϕ。右上教师头 hT 与真实头 hR 分别做 T+/G− 与 R+/G−,判别损失为两项 BCE;红框线性生成器损失 −λT ωi hT(G)−λR hR(G)。中下间隙重加权曲线把 Δb 映射为 ab,经 sg(ωi) 接到教师项。图例区分切断梯度、学生反传与判别器反传。解码帧仅供示意。
Figure 1 Samples of our four-step student distilled from MiniMax-H3
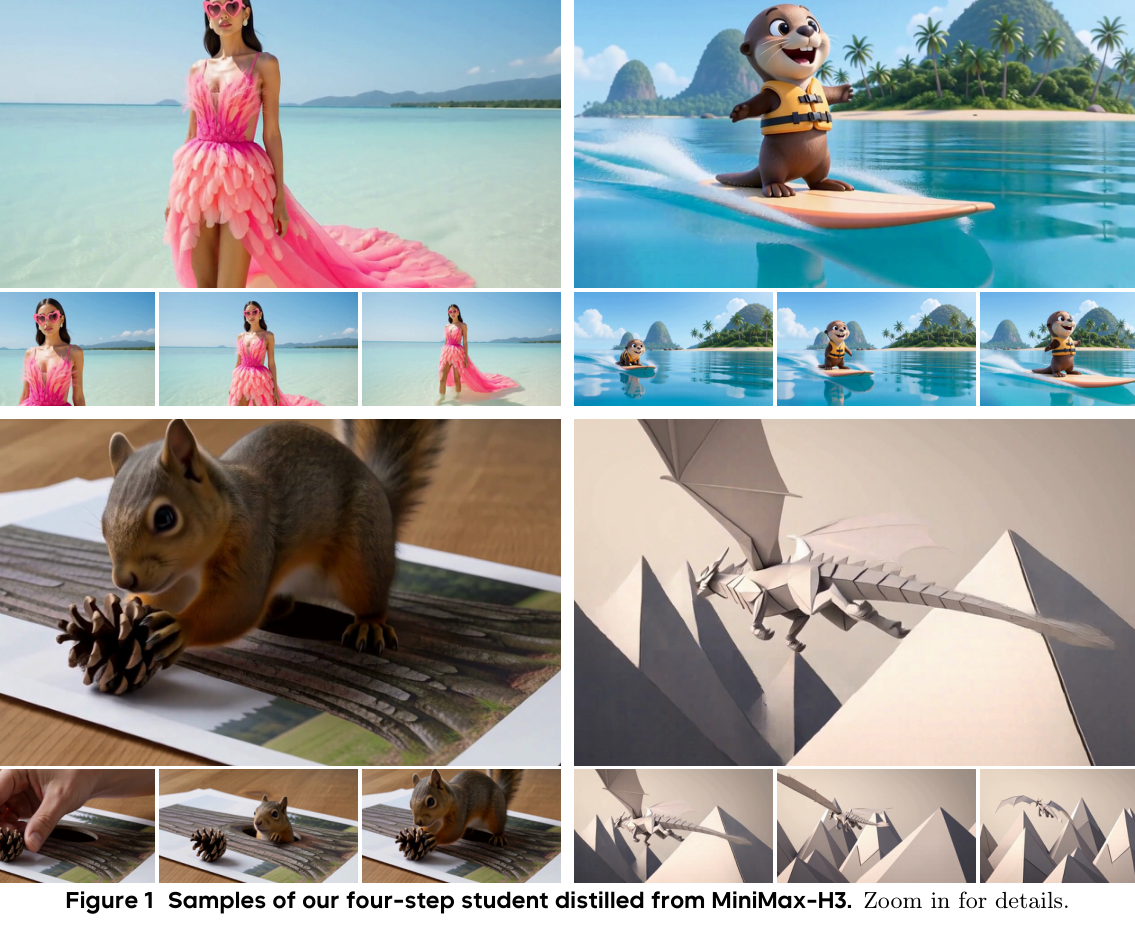
图1是 MiniMax-H3 四步学生的样张墙。左上粉羽毛连衣裙与浅海;右上卡通水獭穿救生衣在热带海岸冲浪;左下松鼠从印刷风景照片里探出咬松果,手在画外按住纸面;右下低多边形折纸龙掠过金字塔。每张主图下有三到四帧小图,展示镜头推进或动作相位。
实验如何设计?
- 图像:按 DMD2 设定蒸馏 EDM(ImageNet-64×64 一步 FID)与 SDXL(50 万 LAION-Aesthetics 真实图,COCO 2014 10K 零样本,报告 FID、patch FID、CLIP)。
- 视频:蒸馏 Wan2.1-T2V 1.3B/14B 与 MiniMax-H3-33B 到四步,真实视频来自 UltraVideo,评测用与 rCM 相同的 VBench 增强提示;MiniMax 另做 VideoGenEval 用户研究(视觉、音频、运动、提示对齐、总体)和 AVGen-Bench。
- 对照包括轨迹/一致性方法(sCM、rCM、LCM、Lightning)和分布匹配/对抗蒸馏(DMD、DMD2、SiDA、SenseFlow、D2O-F)。消融去掉某一头、关闭间隙重加权、或改用非饱和损失。训练代价在 H200 上按官方 DMD2 的 5:1 critic 比对照 1:1。
关键结果与论文证据
- ImageNet 一步 FID 1.24,好于 DMD2 长训的 1.28 与 EDM SDE 教师的 1.36;加上 D2O-F 式投影判别器后到 1.04。作者把优势写成:判别表征直接给学生梯度,而不必五次重拟合 critic(Table 1,页8)。
- SDXL 四步 FID 14.47、patch FID 19.88,均优于 DMD2、SenseFlow 和 100 步教师;一步 FID 16.11、CLIP 0.338,是对照里最好的一步 FID 与最高 CLIP(Table 2)。图8 补充了更自然的颜色与纹理,但正文主定性图是视频。
- Wan2.1 1.3B 四步 VBench Total 84.70、Quality 85.98,超过 DMD2、sCM、rCM 与 50 步教师;14B Total 85.15。Semantic 上 rCM 仍更高。图4 在同一噪声下对比雨中巴士、玫瑰绽放、虎背男孩、逆光模特:教师偏蓝的情绪、花瓣纹理和老虎解剖结构在 Ours 行更稳,sCM/rCM 常见结构塌或运动跳(页7–9)。
- MiniMax-H3 四步在用户研究中相对 DMD2/rCM 总偏好 79.1%/84.6%(排除平局),视觉与音频优势最大,运动 60.3%/73.8%,提示对齐只有 54.3%/61.1%。图1 展示粉羽毛裙海滩、冲浪水獭、松果松鼠错觉、折纸龙;图5 则在鳄鱼与飞鸟、公园瑜伽、海豚画布与鲨鱼、高尔夫入洞上对比,DMD2/rCM 容易丢掉飞鸟或动作相位,Ours 更跟提示。去掉真实头是图像 FID 最大的崩法,去掉教师头则伤视频语义(Table 4)。H200 上同形状更新,DMAD 明显更省时间与显存(Table 5)。
阅读时需要注意
- 论文没有单独的 Limitations 节;伦理声明提醒蒸馏会降低伪造成本,并继承教师偏见。
- VBench 语义分不是最高,用户研究里提示对齐也最接近 50%,不能把总分理解成“什么都更好”。
- 一步 1.04 FID 用了投影判别器,和标准头 1.24 不是同一模型。
- 需要缓存教师样本、维护带级 EMA,工程上比纯分数蒸馏多一套统计。
- 当前公开版本为预印本,代码与配置以项目页后续发布为准。
关联工作
- 轨迹蒸馏与一致性模型约束“怎么走”,分布匹配约束“走到哪”。DMAD 站在后一营,但用对抗分类替换分数差。
- DMD2、SenseFlow、SiDA 把对抗当稳定器;DMAD 把对抗当主梯度,因此能缓存教师、把更新比降到 1:1。
- 真实数据头把学生从教师分布里放出来,这是它在 ImageNet/COCO 上超过多步教师的关键叙述。