快速导读:CIM 比较原图与因果聚焦视图的语义偏移,把认知不确定性从偶然模糊里分离出来,并用嵌入漂移加速估计。
多模态大模型会把语法通顺但事实错误的内容说得很自信,尤其当背景物体、颜色等查询无关线索压过真正证据时。现有不确定性量化多看输出熵或语义熵,容易把数据模糊和模型自身的能力边界混在一起,对偶然不确定性更敏感,对认知不确定性估计不足。Causal-Invariant Masking(CIM,arXiv:2610.02887,NeurIPS 2026;城大、Apple、东南大学、华为诺亚、悉尼大学)认为稳健推理应在去掉任务无关特征后仍保持语义不变:若原预测依赖虚假相关,因果聚焦视图会把信念推开。
方法用查询条件的 RoI 裁剪得到保留因果证据的视图 v′,再定义 Semantic Divergence 为该视图与原图语义分布的 KL。理论把输出看成能量模型,证明该散度在有界扰动下收敛到对非因果能量偏移方差的一半。为避开离散语义聚类,作者再提出 Expected Embedding Drift,在超球面嵌入里用余弦漂移做几何代理,实验中加速约 50%。InternVL2-8B 与 Qwen2.5-VL-7B 上,CIM 在 VQAv2、OKVQA、AdVQA、POPE 与 MME 的幻觉检测优于语义熵等基线,并可用于拒答重答和自适应分辨率推理。局限是依赖 RoI 质量与语义等价估计。
英文题目:Revealing Epistemic Uncertainty in MLLMs via Causal-Invariant Masking
论文出处:arXiv 每日论文精选 · arXiv:2610.02887
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1把两类扰动对照清楚。左栏同一只叼飞盘的狗:Source Image 是户外,Blurred Image 把整图抹糊,Background Mixup 把背景换成室内并改飞盘颜色。中栏显示 Semantic Entropy 随与原图 MSE 增大,在 Blurring 上急剧上升,Background Paste 却几乎不涨。右栏把增量按各指标标准差归一化后,Blur 上 SE 为 0.047、本文为 0.101;Bg. Mixup 上 SE 仅 0.093,本文 Semantic Divergence 升到 0.342。也就是说,语义熵把模糊当成不确定性,却分不清会诱发幻觉的背景窜改。
UQ 文献把方法分成内在置信、口头化不确定性和一致性采样。Semantic Entropy 与 Semantic Dispersion 按意义聚类多样本;EigenScore 等看内部表示几何。MLLM 侧的 UMPIRE、VL-Uncertainty、Uncertainty-o 也在扰动或多样本上算一致性,但扰动通常是全局的,并不显式分开关键证据和无关特征。CIM 的实现也是扰动测试,但其扰动按查询保留 RoI:比较的是原信念与“留住答题证据、压掉无关上下文”的视图,而不是单纯测信息丢失。
核心创新
- 用保留 RoI 的因果掩码比较语义分布,隔离对无关线索的依赖。
- 证明 Semantic Divergence 在有界偏移下等于非因果敏感度方差的一半。
- 提出免聚类的 Expected Embedding Drift,在超球面嵌入上近似同一偏移。
方法概览
CIM 相对查询把图像分成 vc 与 vs,用 GroundingDINO 检测后做 RoI 并集裁剪得到 v′。Semantic Divergence 是 P(s|v′) 与 P(s|v) 的 KL。能量分解假设下,似然比消去因果能量,散度收敛到非因果偏移方差的一半。EED 用原分布的期望嵌入作圆心,对掩码采样词元算 1−cos,在 vMF 几何下成为该 KL 的无偏代理。部署时把 SD/EED 与半采样 SE 插值,以同时覆盖两类不确定性。
- 把视觉输入相对查询分成因果特征 vc 与非因果特征 vs。该分解对满足 P(s|vc, vs)=P(s|vc) 的 oracle 预测器定义,并不假设被测 MLLM 已经知道。稳健推理在去掉 vs 后应保持稳定;过滤后若语义大移,就暴露对虚假相关的依赖。作者引入保留 vc 的掩码算子 T(·),主实现是查询条件 RoI 裁剪:用 GroundingDINO 检测关键物体,过滤过大框,再裁并集框以保留物体关系和局部上下文,得到 v′=T(v)。附录显示检测器选择并非关键。
- Semantic Divergence 定义为 Usem=DKL(P(s|v′)∥P(s|v))。实践中从原图和掩码图各采样序列,用蕴含模型聚类到语义类再聚合似然。若模型稳健,或数据模糊但模型诚实,意义分布稳定、Usem 低;若幻觉靠背景,则出现语义偏移、Usem 高。理论把语义输出写成 Boltzmann 分布,并假设因果能量在 T 下不变、非因果能量偏移为 Δs。Lemma 3.2 表明似然比里因果项消去,故度量对 vc 上的偶然模糊不敏感。Theorem 3.3 证明 Usem 等于指数函数在 Δs 上的 Jensen 间隙,并在有界偏移下 Usem=½VarQ[Δs]+O(ε³)。
- 离散聚类要为 P 与 Q 采样并做两两蕴含判定,成本高。EED 把词元分布看成超球面上的语义向量:每一步用原模型词概率加权得到期望嵌入 μP,t,再对掩码采样的词元算 1−cos(eyt, μP,t),对 K′ 条样本和所有时间步平均得到 UEED。它不再需要聚类模型,复杂度从 O((K+K′)²) 降到 O(K′)。在 von Mises-Fisher 假设下,相同浓度的两个 vMF 的 KL 正比于均值方向的余弦距离,从而 UEED 是 Semantic Divergence 的无偏几何代理(差一个尺度与常数)。
逐图理解论文
两类不确定
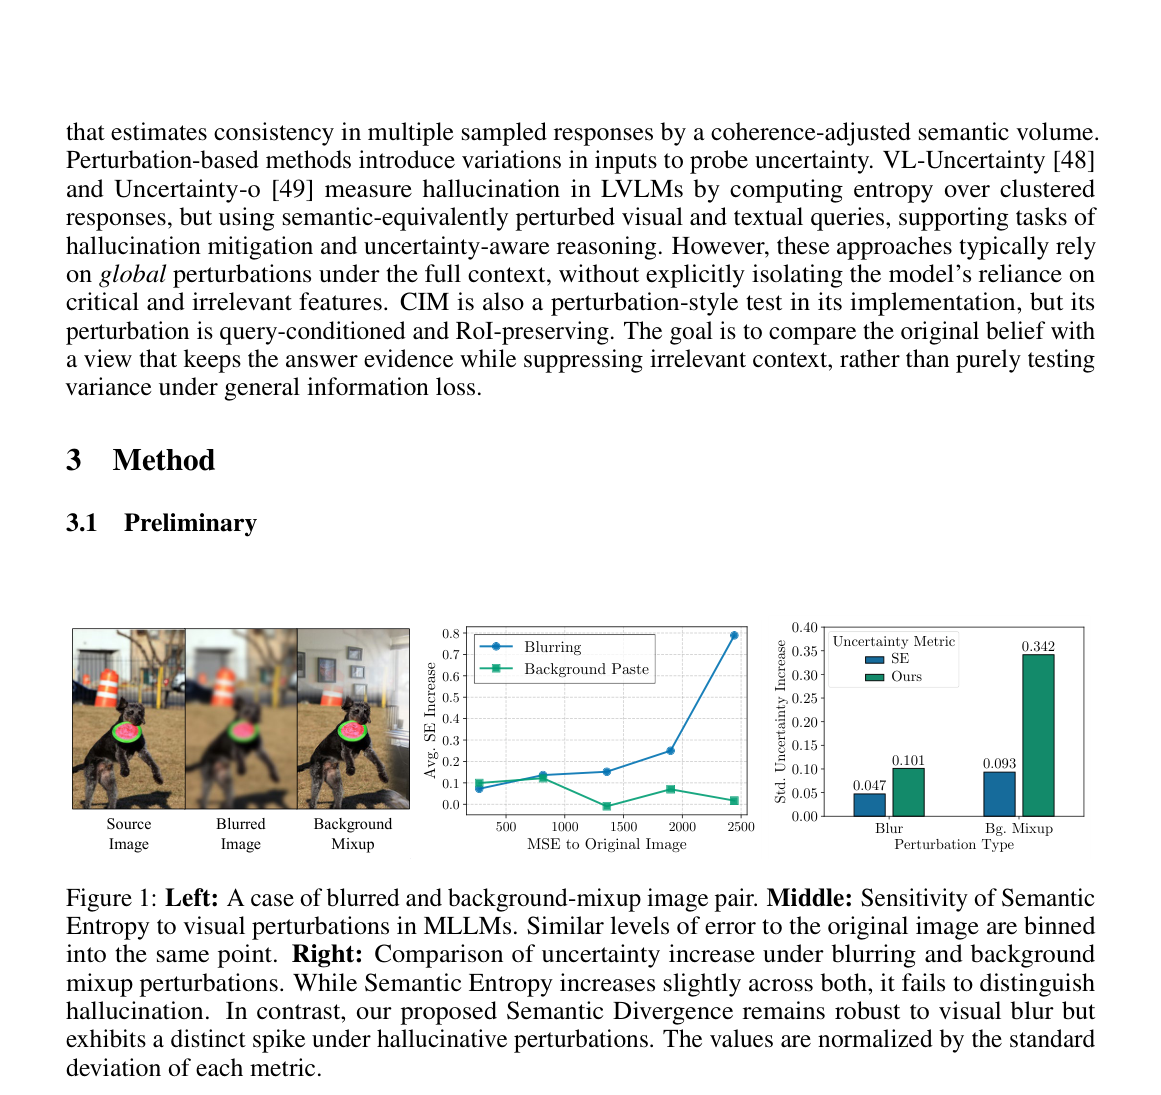
该 PNG 上半是第 2.2 节相关工作与 3.1 Preliminary 标题,下半才是图1。左三张图为 Source Image、Blurred Image、Background Mixup:同一只戴绿标的狗,模糊图整幅发糊,背景混合把户外换成室内并改飞盘。中图横轴 MSE to Original Image,蓝线 Blurring 的平均 SE 增量随误差升到约 0.8,绿线 Background Paste 接近持平。右图 Std. Uncertainty Increase:Blur 上 SE 0.047、Ours 0.101;Bg. Mixup 上 SE 0.093、Ours 0.342。讲图时不要把上方英文段落当画面元素。
因果掩码
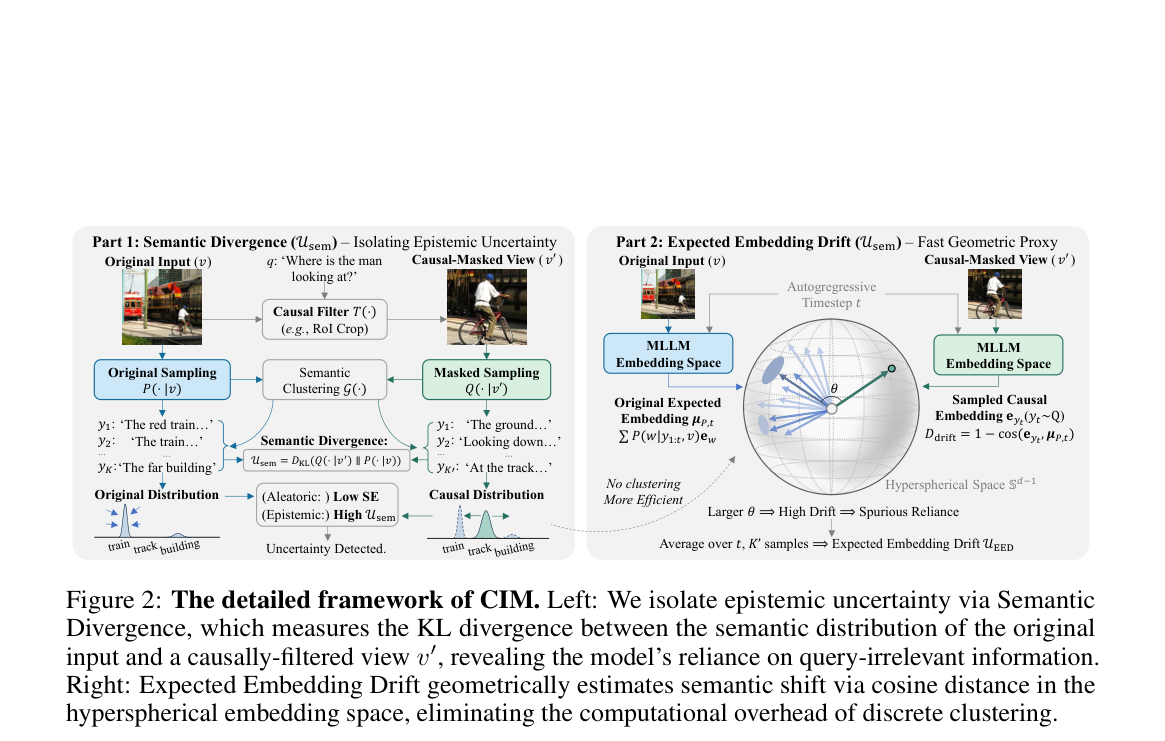
图2是 CIM 框架,宜作特色图。左半 Part 1 Semantic Divergence:原图是铁轨边骑车人与红火车,查询 Where is the man looking at?;Causal Filter T(·) 如 RoI Crop 得到只含人与车的 Causal-Masked View。原采样 P 给出 The red train、The train、The far building,掩码采样 Q 给出 The ground、Looking down、At the track。中间 Usem=DKL(Q(·|v′)∥P(·|v))。下方示意原分布低 SE(偶然)、因果分布高 Usem(认知)。右半 Part 2 在超球面 S^{d-1} 上画原期望嵌入 μP,t 与掩码采样嵌入,夹角 θ 越大则 Ddrift=1−cos 越大,表示虚假依赖;无需聚类,对 t 与 K′ 平均得到 UEED。
关键证据
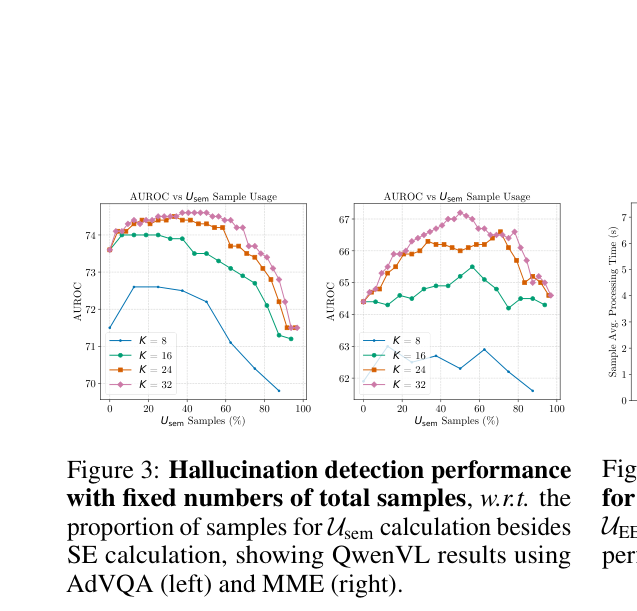
图3是固定总样本数时的采样分配。左 AdVQA、右 MME,均为 QwenVL,横轴 Usem Samples (%),纵轴 AUROC,四条线 K=8/16/24/32。两图都呈中间高峰:总预算增大则整体上移,最佳大约在 20%–60%,两端分配会下降。右缘裁进了图4的部分纵轴刻度,讲分配曲线时不要把那截坐标当图3面板。
结论与局限
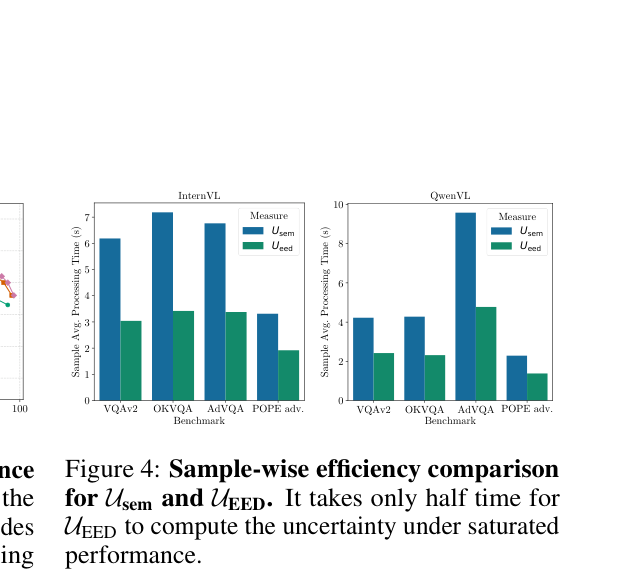
图4比较 Usem 与 UEED 的单样本平均耗时,左 InternVL、右 QwenVL,蓝柱 Usem、绿柱 UEED(图例写作 Ueed)。InternVL 上 VQAv2/OKVQA/AdVQA/POPE adv 的蓝柱大约 6.2/7.3/6.8/3.4 秒,绿柱约一半。QwenVL 上 AdVQA 蓝柱接近 10 秒、绿柱约 5 秒,对应正文约 9.6 秒到约 4.8 秒;其余三个基准绿柱同样约为蓝柱一半。左缘裁进了图3横轴的 100 与部分图注残字,读柱状图时忽略左侧碎片。
实验如何设计?
- 评测模型为 InternVL2-8B 与 Qwen2.5-VL-7B-Instruct。基准包括普通 VQA(VQAv2、OKVQA、AdVQA)和幻觉向的 POPE、MME。RoI 由轻量 GroundingDINO 生成。为公平比较,基线最大采样次数 Ktotal=K,本文 Ktotal=K+K′,都固定为 32。原分布样本可同时用来算半采样的语义熵,因此最终用本文指标与该 SE 插值得到混合分数,以同时覆盖偶然与认知不确定性;纯 SD、不插 SE 的 AUROCEPI 用来单独看认知分量。
- 消融对比 Random Crop、Reversed Crop(只留背景)以及 GQA 上的 Ground-Truth RoI。图3在总样本数固定时,扫描用于 Usem 的样本占比。图4比较 Usem 与 UEED 的单样本耗时。应用实验包括:不确定性超阈值则拒答并重答;以及把低不确定性样本降到最大分辨率 256,把高分辨率留给不确定样本。
关键结果与论文证据
- Table 1 上 CIM 在三个 VQA 基准全面高于所列基线。针对诱发错误的 AdVQA,InternVL 的 AUROC 为 76.8%,高于 Semantic Entropy 的 75.5% 和 EigenScore 的 67.1%。EED 多数情况下与显式 SD 相差约 1 个百分点以内。Table 2 的 POPE 上,InternVL 的 SD 在三路都约 75% AUROC,高于语义熵的约 68–72%。QwenVL 上 EED 反而明显强于显式方法,如 Random 上 83.2% 对 66.2%,作者将其归因于 QwenVL 在 POPE 上解码更尖、离散聚类更不稳,而连续嵌入不受硬聚类影响。附录 MME 上 CIM 仍是最好。
- Table 3 显示 RoI Crop 优于随机裁与反向裁。混合分数下 InternVL 的 VQAv2 AUROC 为 81.3%,随机裁 80.2%,反向裁 77.6%。去掉 SE 后的 AUROCEPI 差距更大:相对随机裁,InternVL 在 VQAv2/AdVQA 高 6.5/9.2,QwenVL 高 11.6/14.0。GQA 上本文 RoI 与真值框接近,两者都明显好于乱裁,说明关键是保住查询相关证据,精确框反而不如保留因果证据重要。图3呈中间高峰:总预算在双方各 40%–60% 时最好,偏到任一端都会伤一种不确定性的估计;增大总预算会抬 AUROC,但最佳比例稳定。
- 图4上 UEED 在两个模型和四个基准上都把单样本耗时降到约一半。以计算更重的 QwenVL AdVQA 为例,正文写从约 9.6 秒降到约 4.8 秒。图5用不确定性阈值触发重答:InternVL 在 AdVQA 从 47.9% 到 51.1%,QwenVL 从 47.5% 到 50.0%,VQAv2/OKVQA 也有正增益。图6把最自信样本降分辨率:QwenVL 把最自信 50% 降到低分辨率后,平均时延从 0.65 秒到 0.50 秒,准确率从约 75.2% 到约 76.1%;InternVL 在 50–70 百分位阈值附近有类似收益。作者认为对已经足够的样本,高分辨率反而可能分心。
阅读时需要注意
- CIM 依赖 RoI 质量与语义等价估计,检测失败或聚类失配会影响分数;作者称实验上影响有限,但未消除该依赖。
- 主实现用 GroundingDINO 作经验因果过滤器,不是真正的 oracle vc 分离;反向裁更差,说明乱丢证据不能代替保留 RoI。
- 主表的幻觉检测使用与 SE 插值的混合分数,因此部署时仍需分配采样预算;纯认知度量看 AUROCEPI。EED 在 QwenVL 的 POPE 上优于 SD,说明离散聚类并非处处更准。
关联工作
- Semantic Entropy 解决语言表面变体,但仍把认知与偶然不确定性混在输出多样性里。EigenScore 与凸包几何分析看嵌入散布,针对的是通用 LLM 的 UQ。
- UMPIRE、VL-Uncertainty 与 Uncertainty-o 把一致性或语义等价扰动扩到视觉语言模型,可做幻觉缓解和不确定感知推理,但扰动多在全上下文上全局施加。CIM 把扰动改成查询条件、保留 RoI。
- 因果不变性文献强调因果机制应在干预或环境间保持稳定。CIM 不要求像素级分离,只要求 T 保住查询相关证据并压掉非因果上下文,再用散度读出模型对无关信号的敏感度。