DyG2T:用粒子补全与时间解耦打破可微动力学建模的表示坍缩
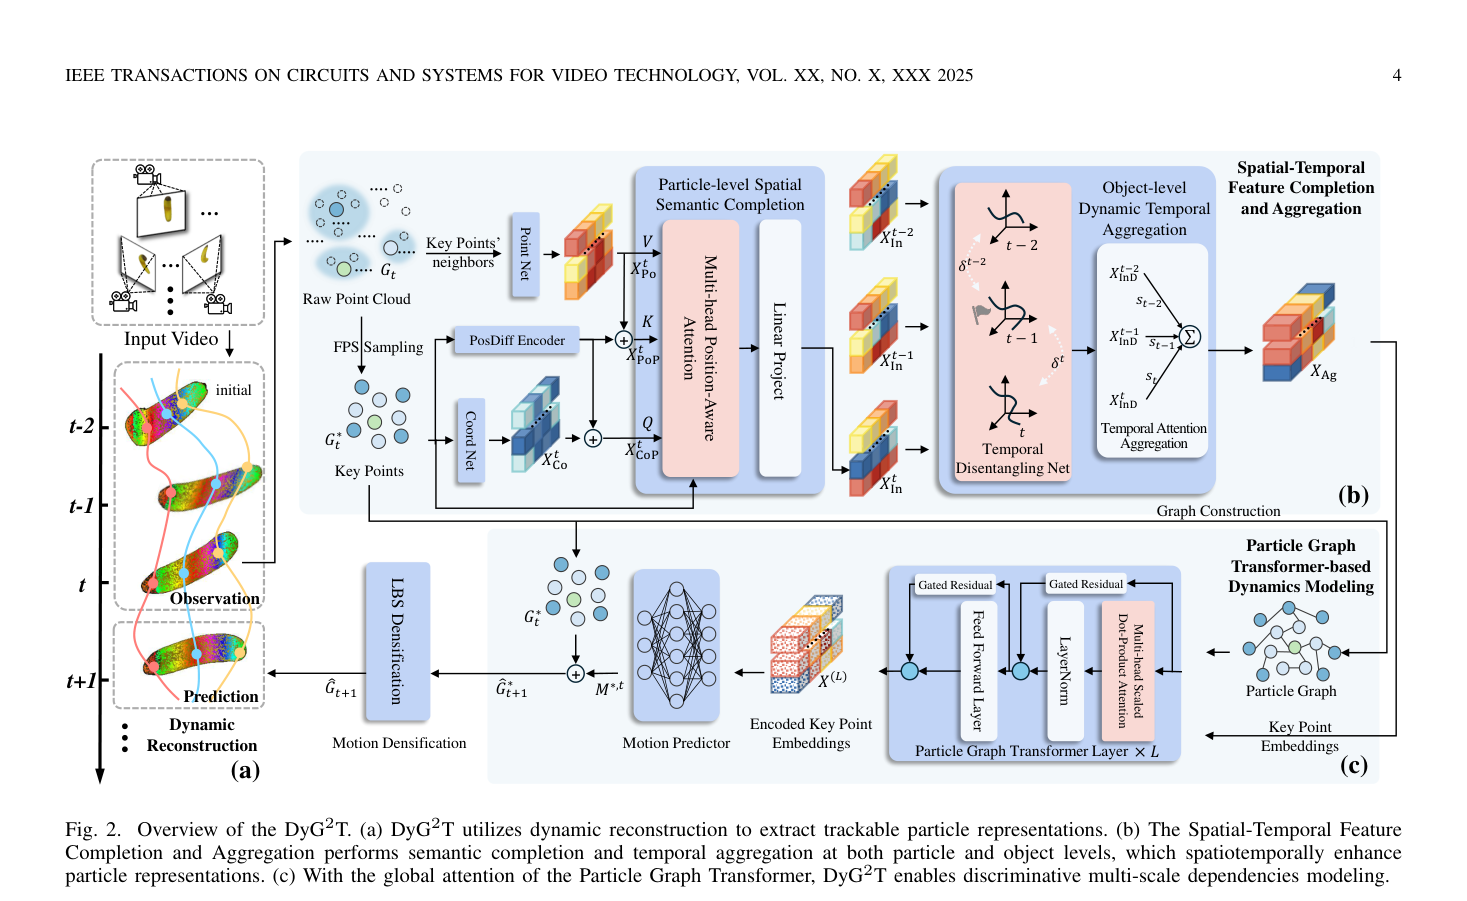
DyG2T通过空间补全与时间解耦增强关键点表示,并利用粒子图Transformer建模多尺度交互,实现从稀疏视角视频中准确预测动态物体运动轨迹。
DyG2T通过空间补全与时间解耦增强关键点表示,并利用粒子图Transformer建模多尺度交互,实现从稀疏视角视频中准确预测动态物体运动轨迹。
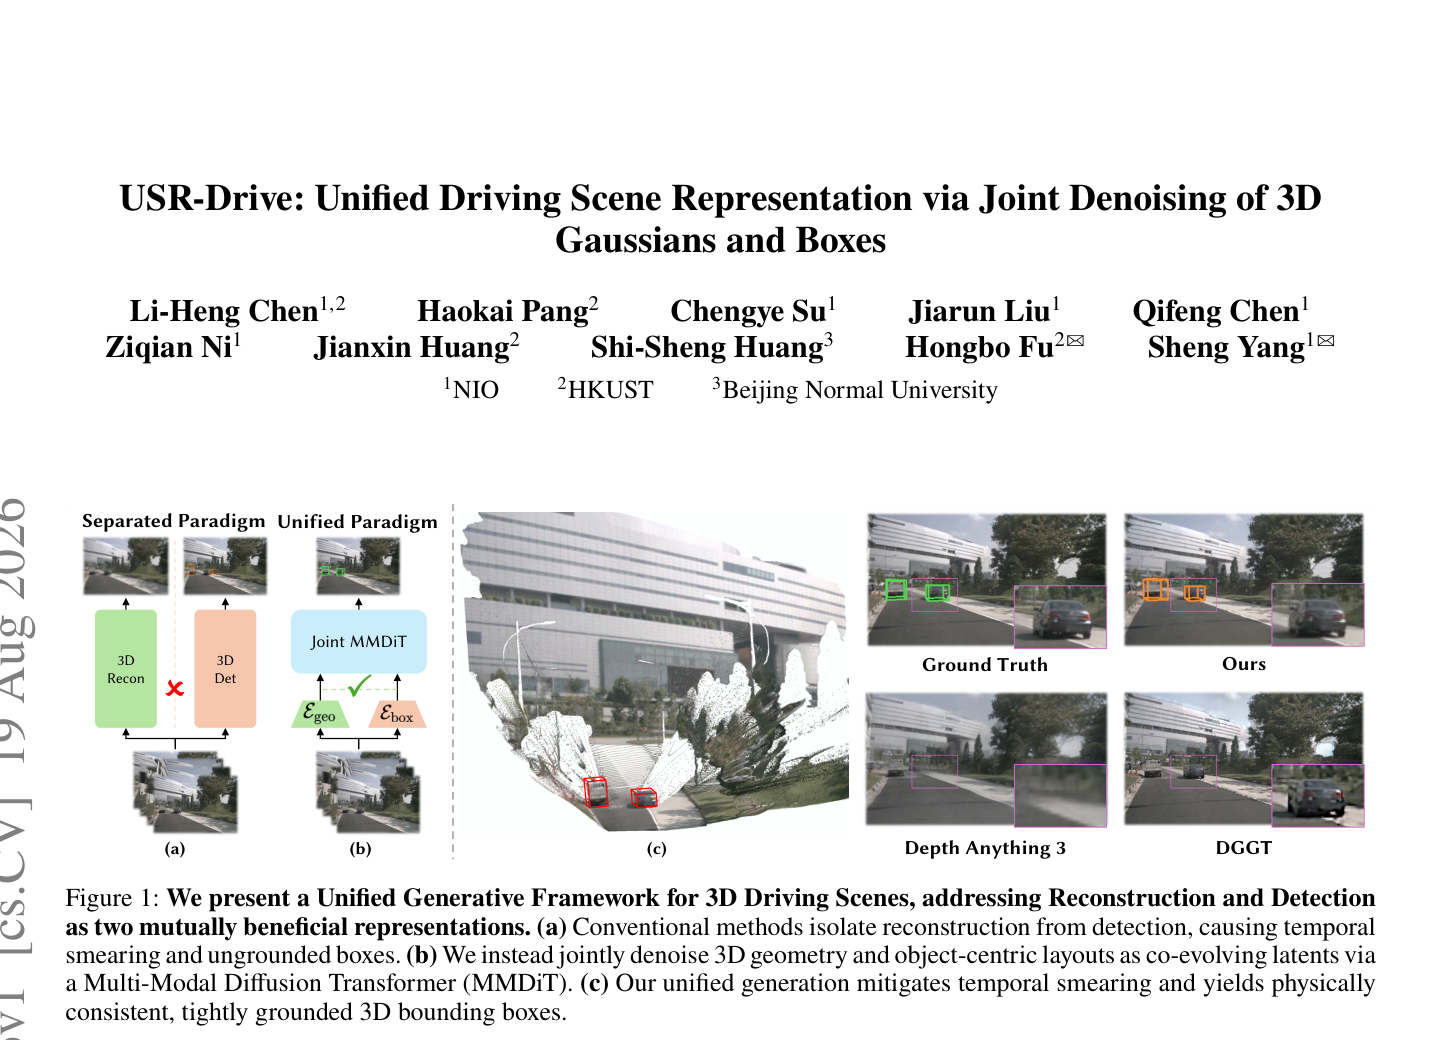
USR-Drive提出一个统一生成框架,将稠密3D高斯几何与稀疏3D检测框作为共同演化的潜在变量,通过多模态扩散Transformer联合去噪,实现动态重建与3D检测的相互增强。
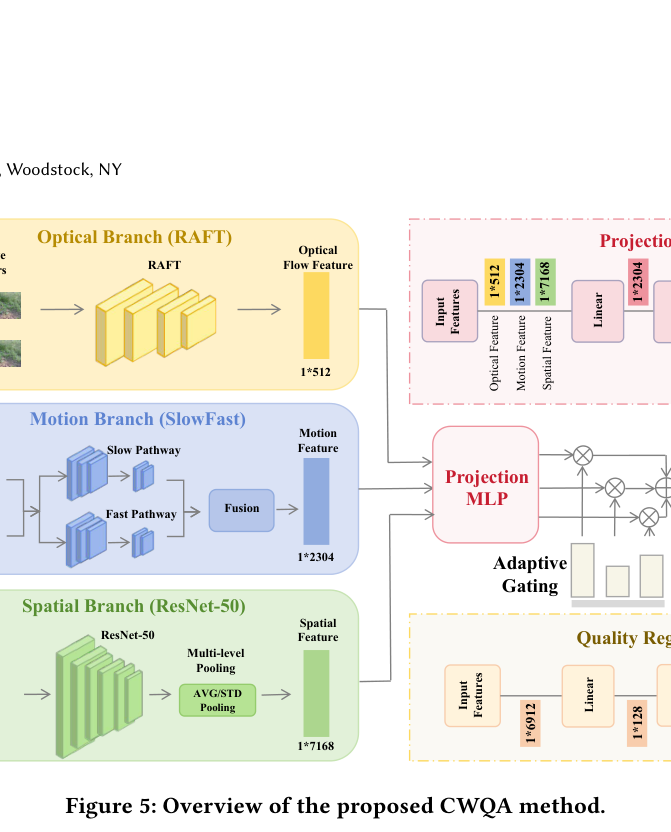
提出首个相机控制视频生成质量评估基准CamWorldQA(720个生成视频)及三支路无参考质量评估模型CWQA,联合空间、时序与光流特征预测感知质量。
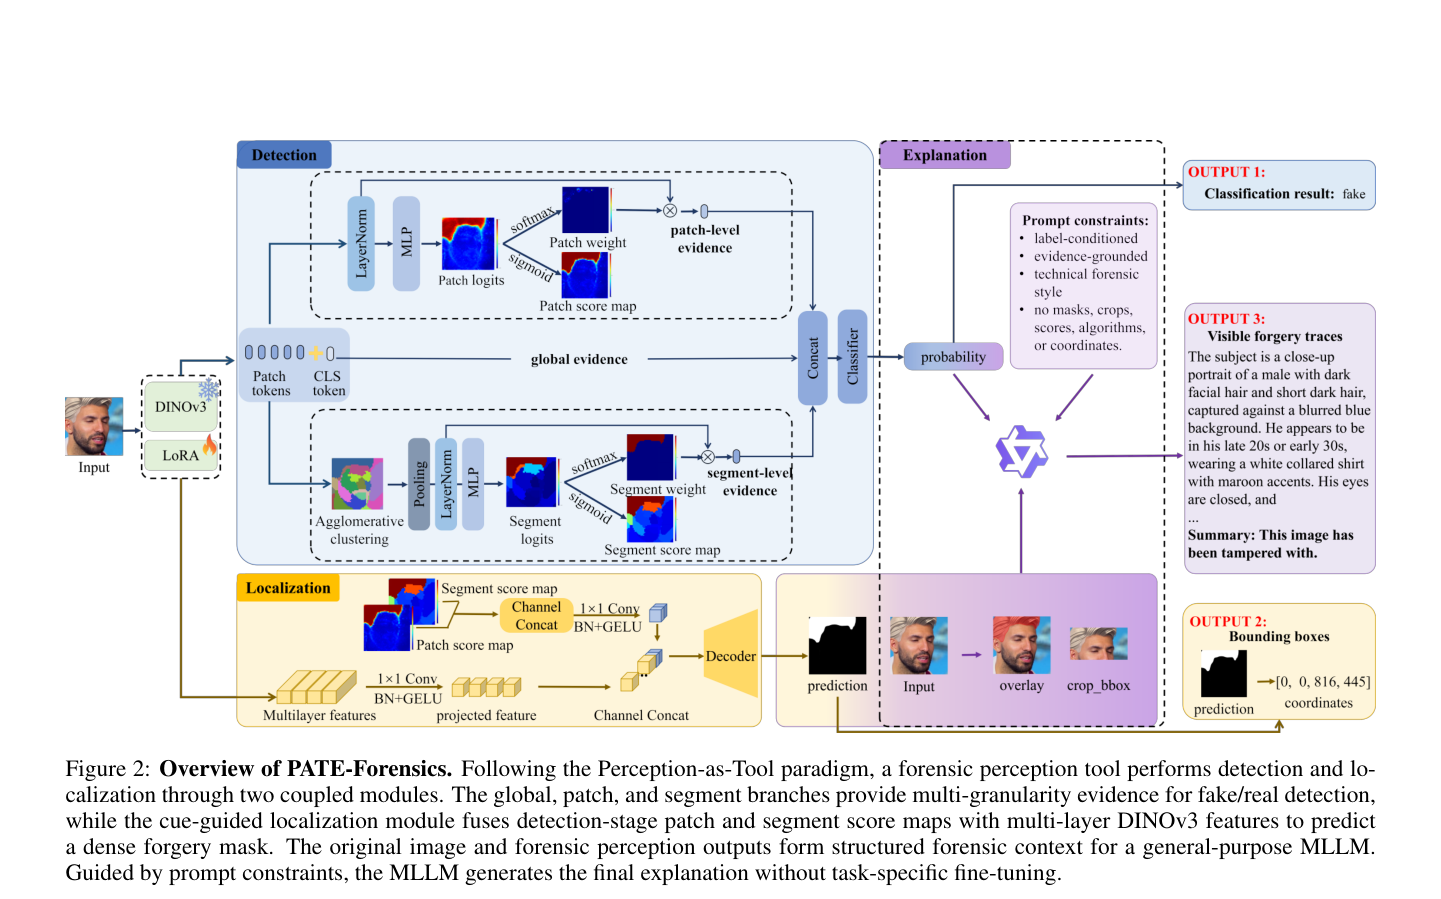
提出 Perception-as-Tool 范式,将检测与定位外置为取证感知工具,为冻结的通用 MLLM 提供结构化取证上下文以生成解释,无需任务特定微调。
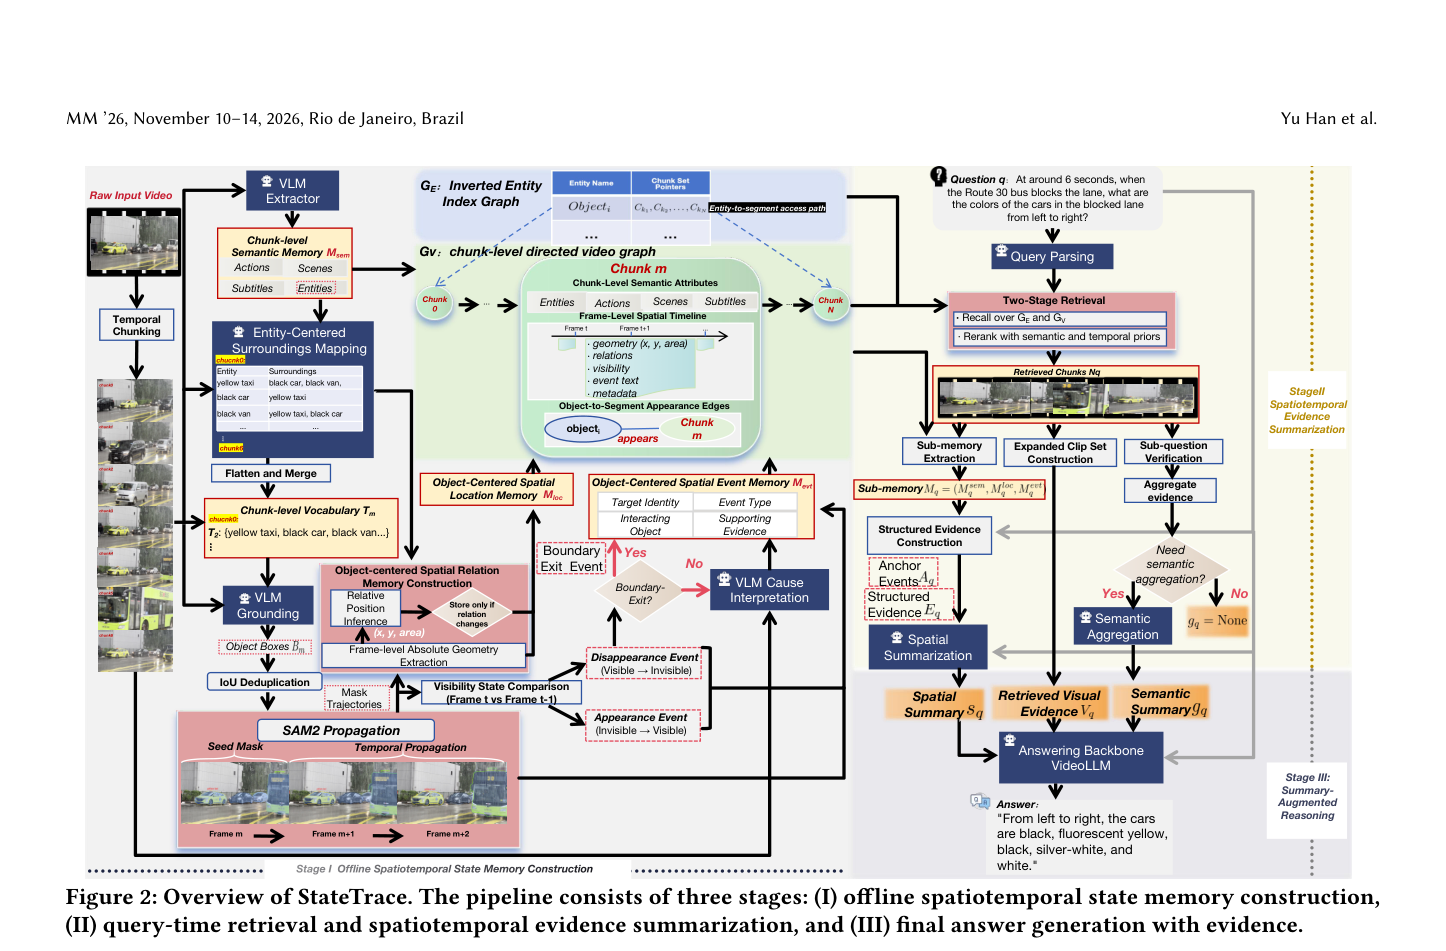
StateTrace 提出对象中心的时空状态记忆框架,使 VideoLLM 能够在目标物体长时间不可见时显式推理其隐藏状态,并在新基准 HSR-Bench 上取得 15–28 点的显著提升。
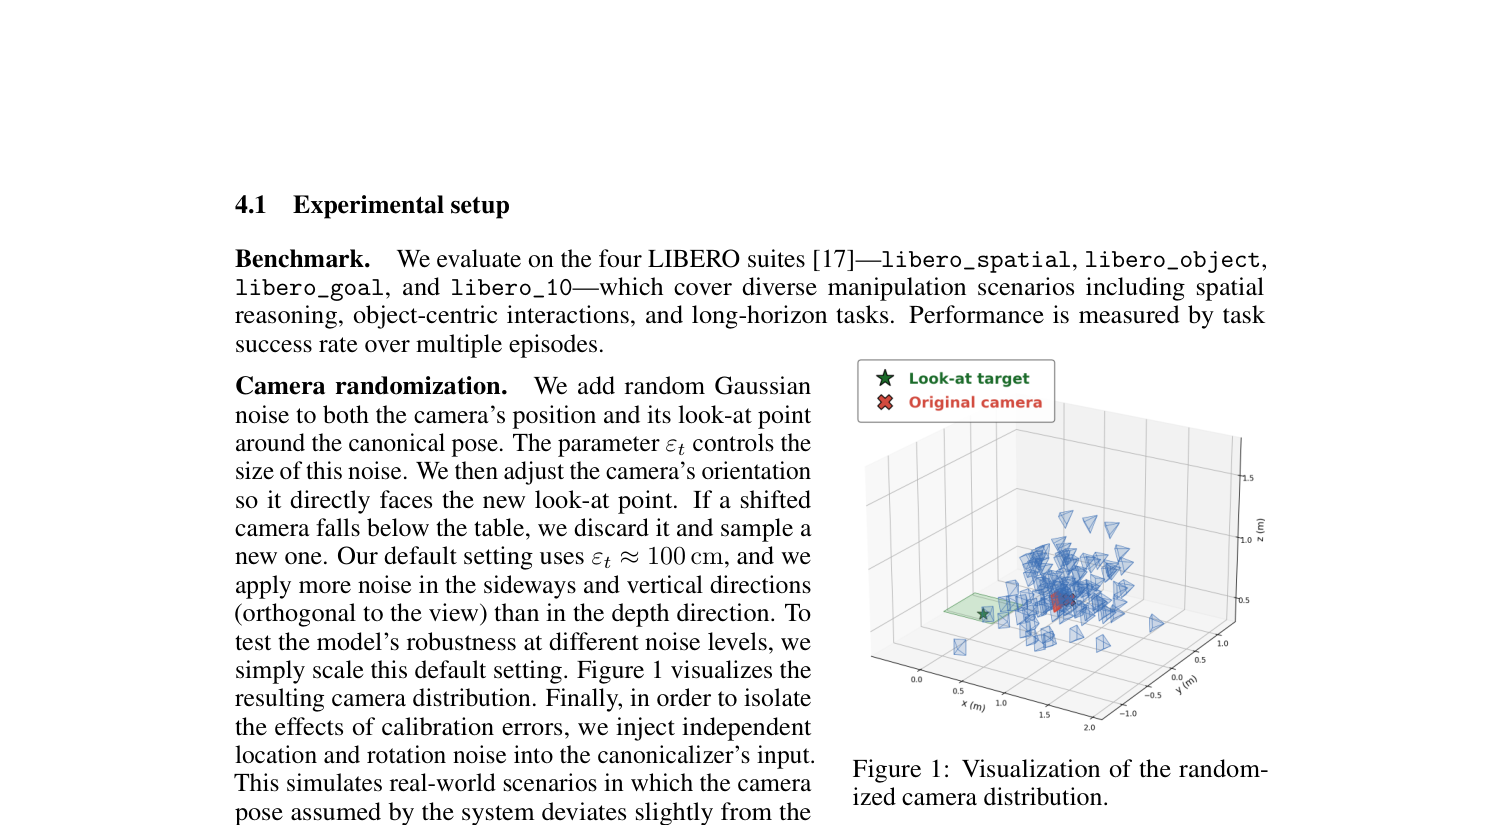
GS-VLA提出一个4M参数的3D高斯canonicalizer,在冻结VLA策略前恢复规范视角观测,无需策略重训练即可大幅恢复相机视角扰动造成的成功率损失。
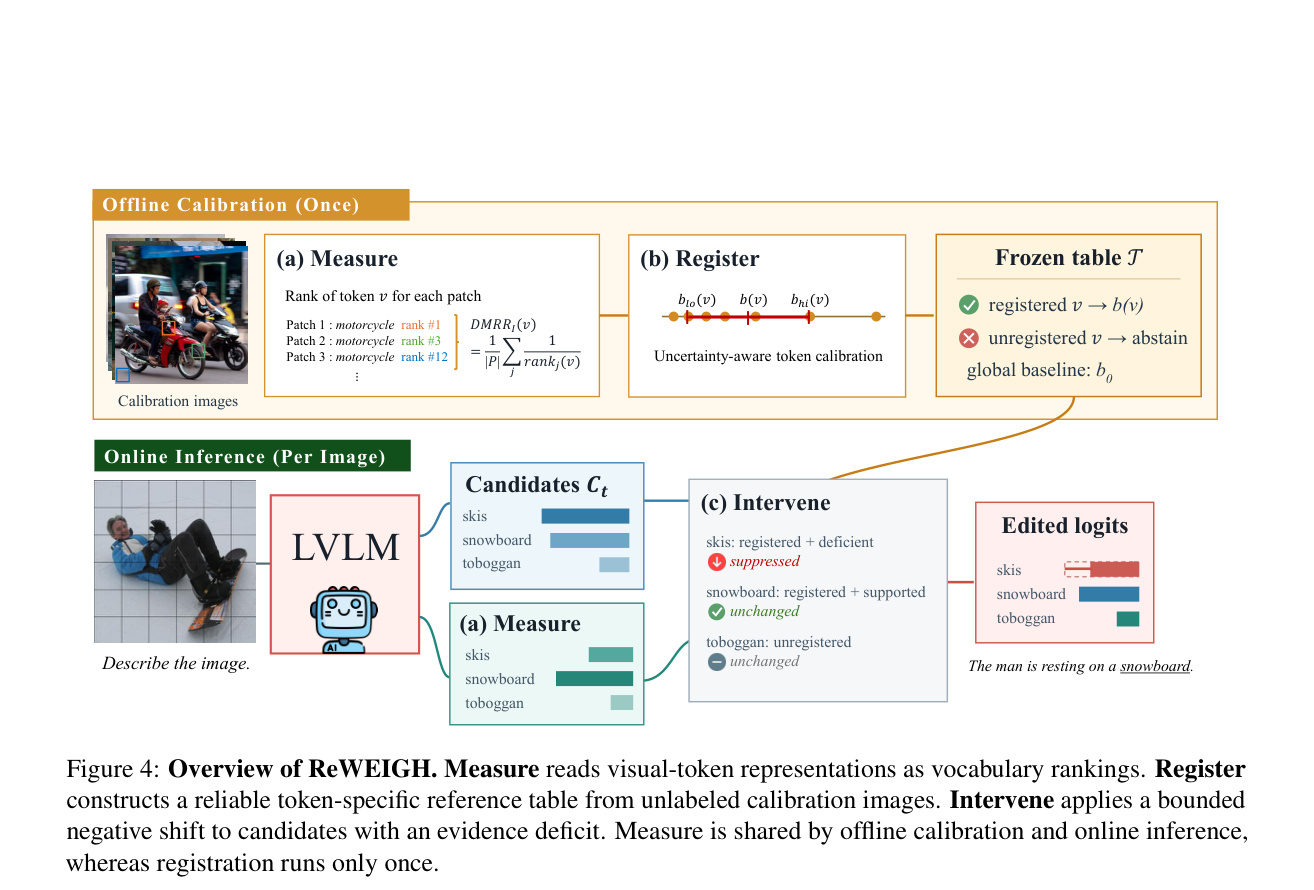
ReWEIGH 是一种免训练的解码干预方法,通过聚合视觉位置的词汇排名(DMRR)并与词元特定参考比较,对有证据不足的候选词元施加有界惩罚,从而缓解 LVLM 幻觉。
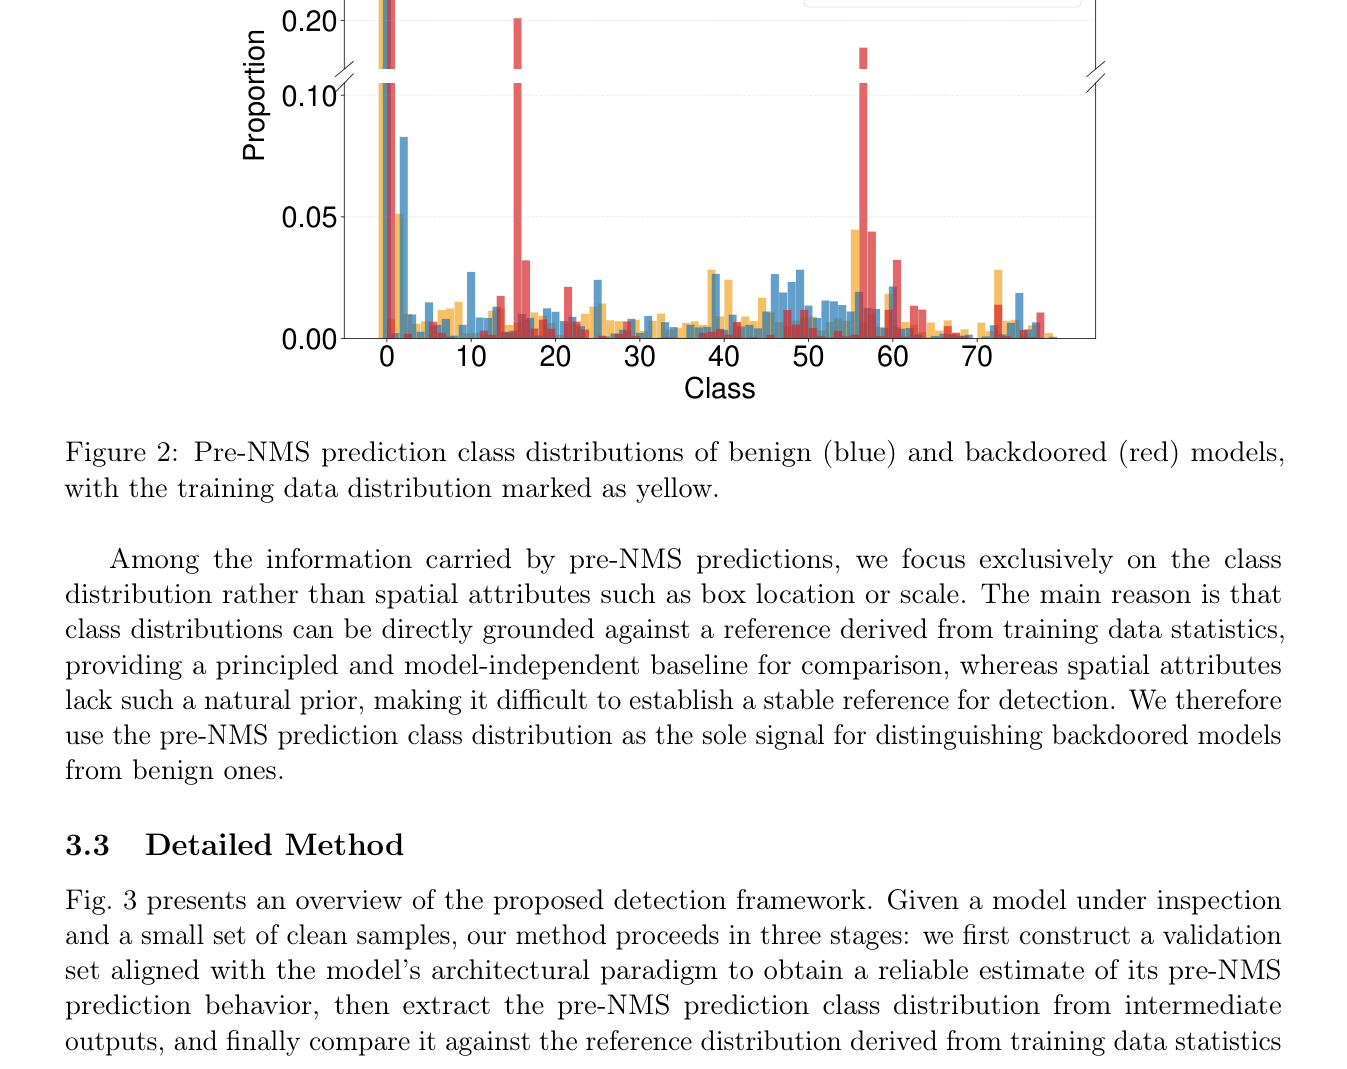
DistScan 通过度量模型 NMS 前预测类别分布与训练数据类别频率之间的 Jensen-Shannon 散度来检测目标检测模型中的后门,无需触发器知识、权重访问或额外训练。