UniH3:统一层级同质性与异质性以实现全合一医学图像复原
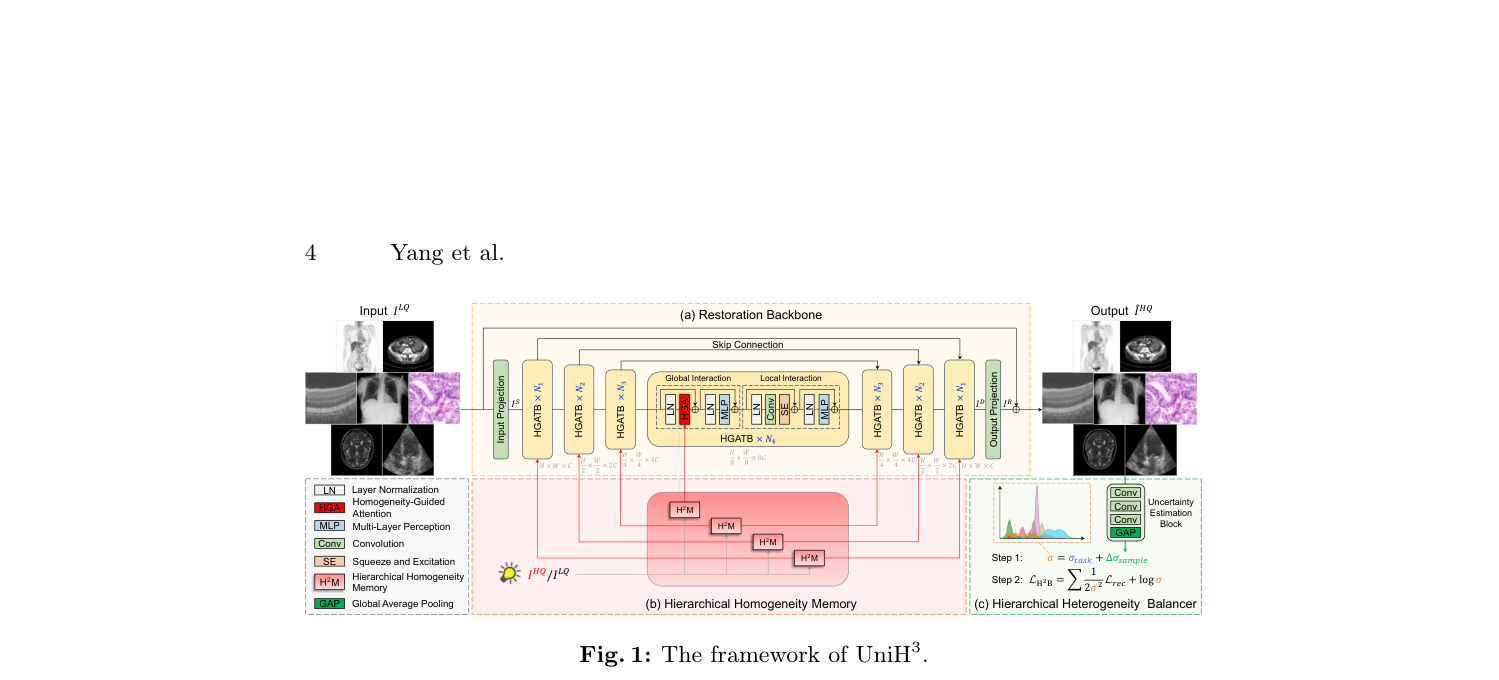
本文提出 UniH3 框架,通过层级同质性记忆(H2M)和层级异质性平衡器(H2B)同时建模医学图像中的层级同质性与异质性,在 2D 和 3D 基准上实现了全合一及单任务医学图像复原的 SOTA 性能。
本文提出 UniH3 框架,通过层级同质性记忆(H2M)和层级异质性平衡器(H2B)同时建模医学图像中的层级同质性与异质性,在 2D 和 3D 基准上实现了全合一及单任务医学图像复原的 SOTA 性能。
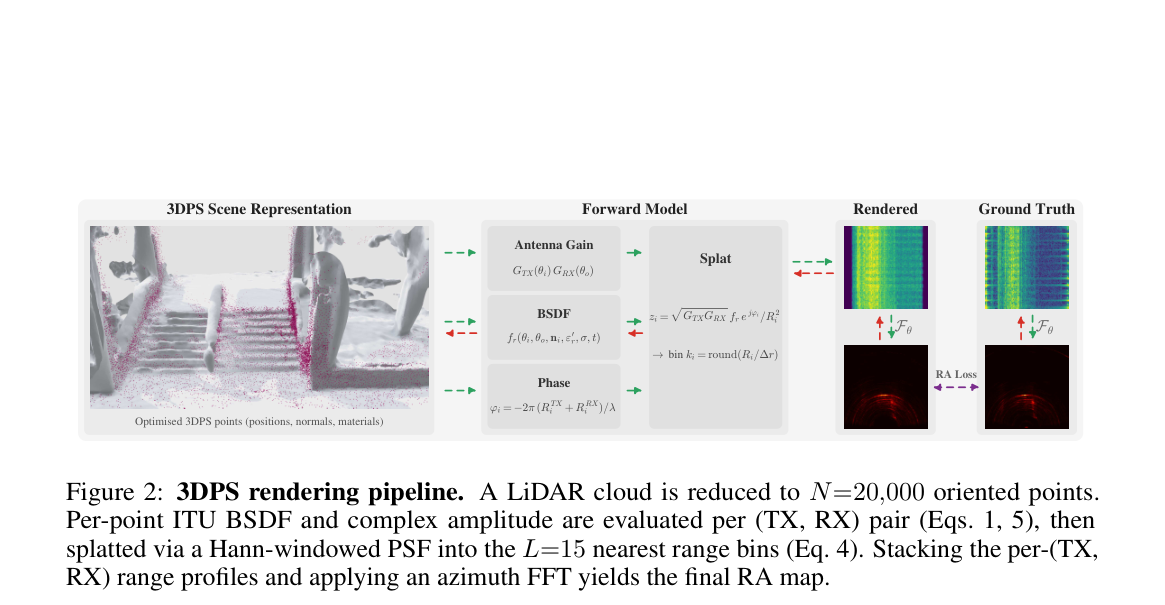
提出3DPS,一种基于ITU-R P.2040材料模型和复数PSF溅射的可微分点渲染器,在保持物理保真度和复数输出的同时,实现了毫米波雷达新视角合成的高效多视角优化。
本文提出 SOFTPROMPT,通过在跨模态边界注入少量连续软提示 token 并采用空格初始化,在冻结 VLM 骨干网络的前提下,以极少的可训练参数实现了与 LoRA 相当的少样本检测性能,且无灾难性遗忘。
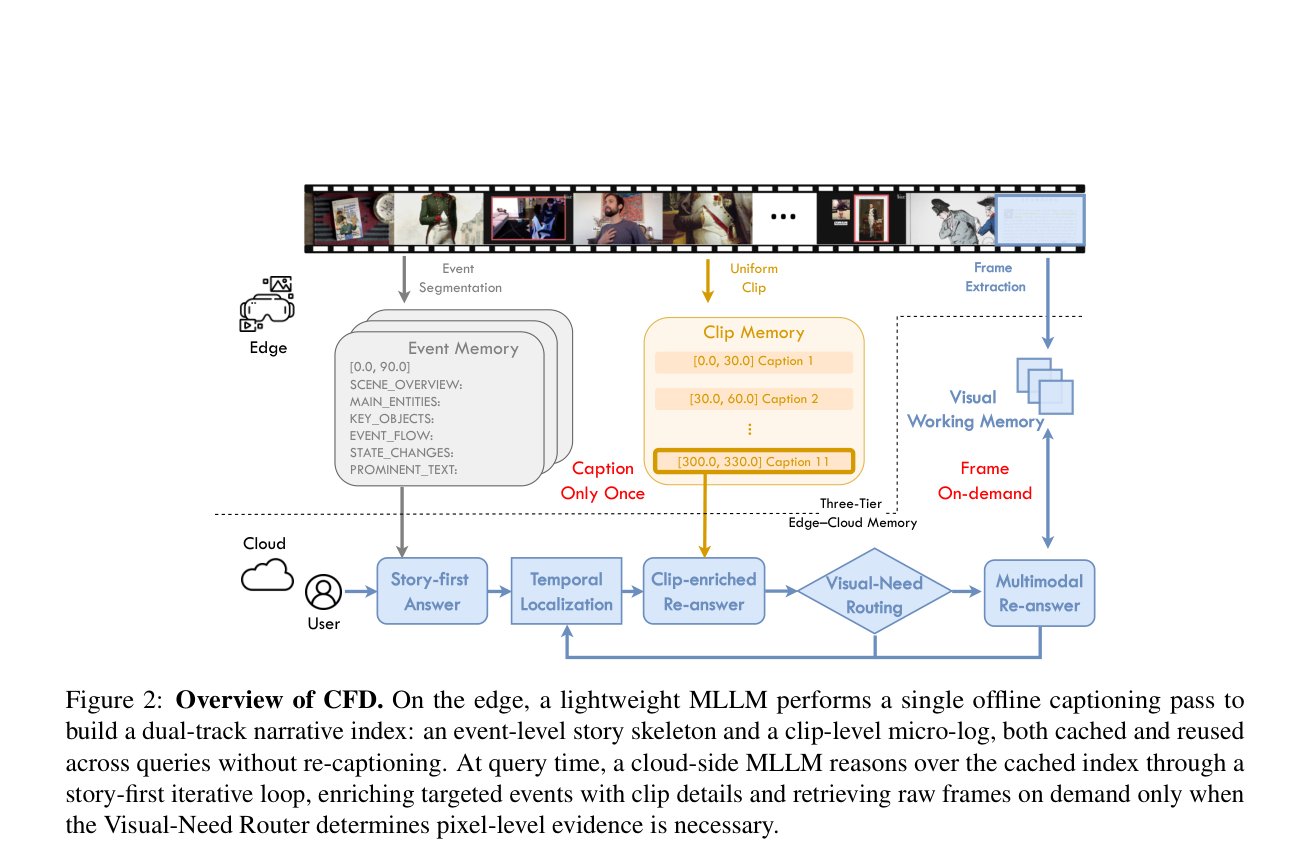
CFD 提出了一种边缘-云协同的长视频理解框架,通过离线构建双轨叙事索引(事件骨架与片段日志)和在线基于 Visual-Need Router 的按需帧检索,在显著降低视觉计算成本的同时保持竞争性准确率。
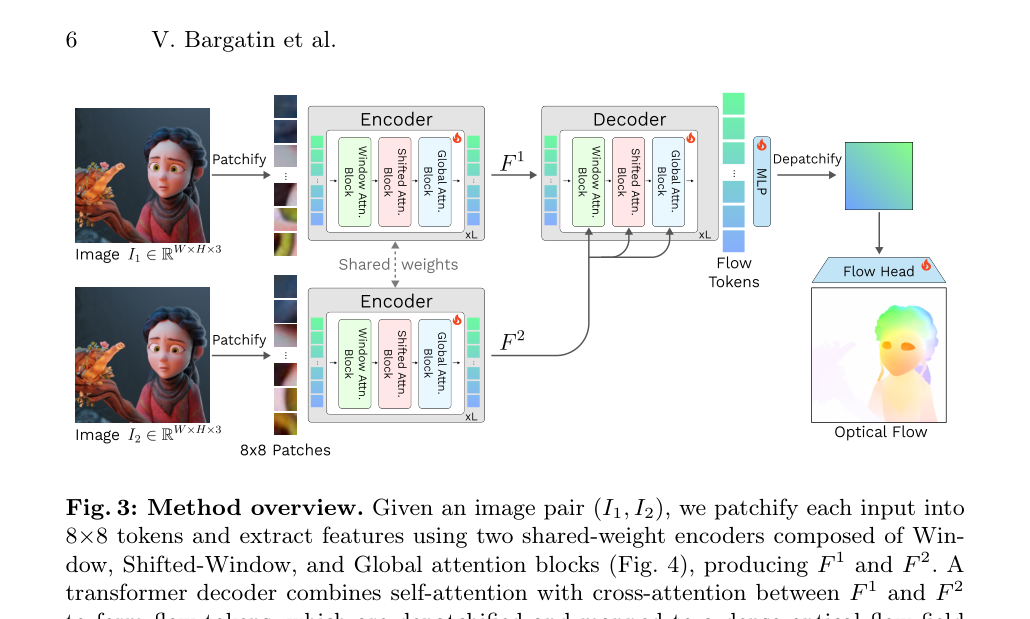
FreeFlow提出了一种无需光流特定归纳偏置(如相关体、特征扭曲)的分层Transformer架构,通过窗口、移位窗口和全局注意力机制,在Sintel、KITTI-2015和Spring基准上实现了最先进的性能,同时保持了高分辨率推理的内存效率。
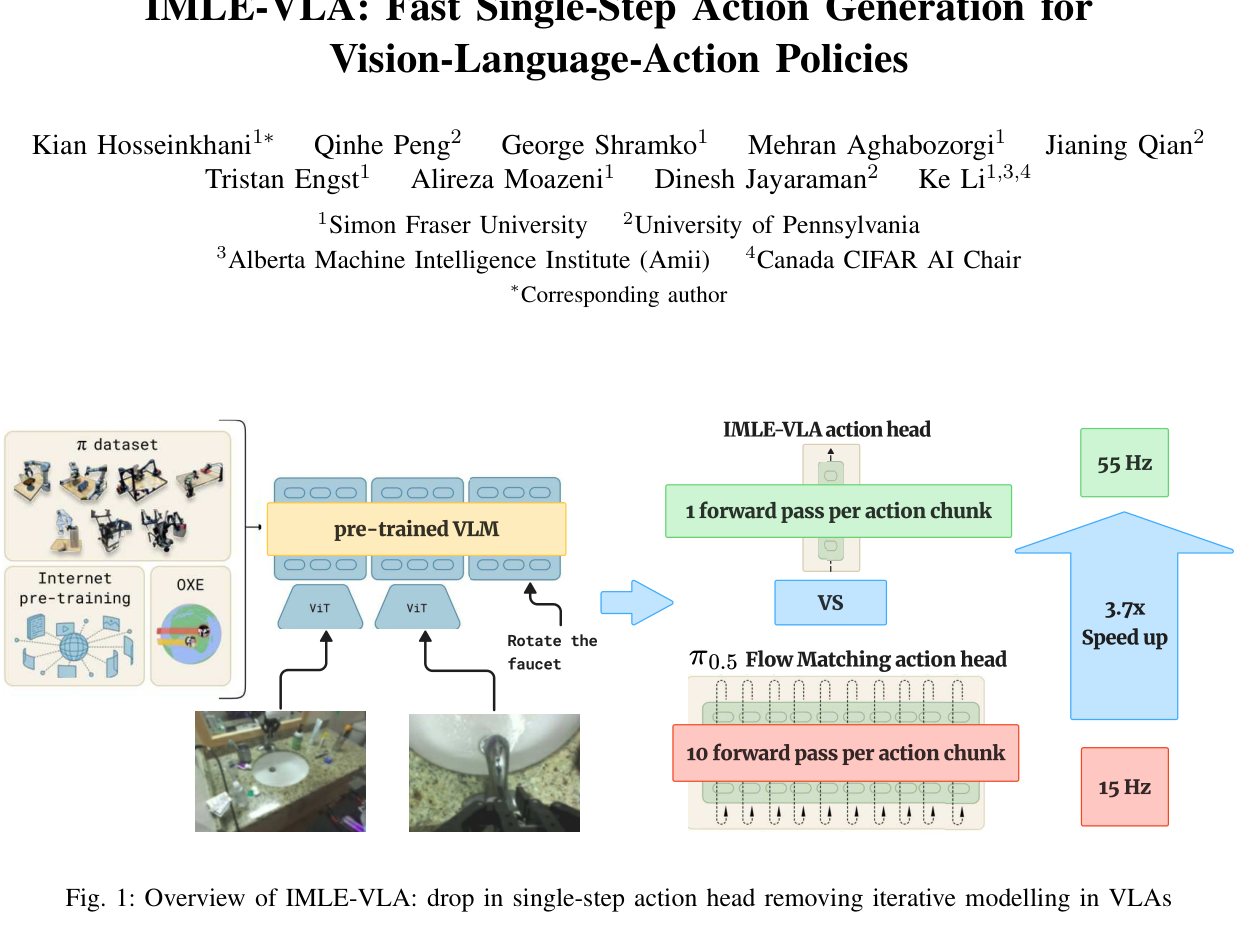
IMLE-VLA 通过引入基于 conditional Implicit Maximum Likelihood Estimation (cIMLE) 的单步动作头替换传统的迭代式 flow-matching 头,在保持 π0.5 鲁棒性的同时,将 VLA 推理频率提升至 55 Hz(3.67 倍),并在 LIBERO 基准测试中取得 98.0% 的最高成功率。
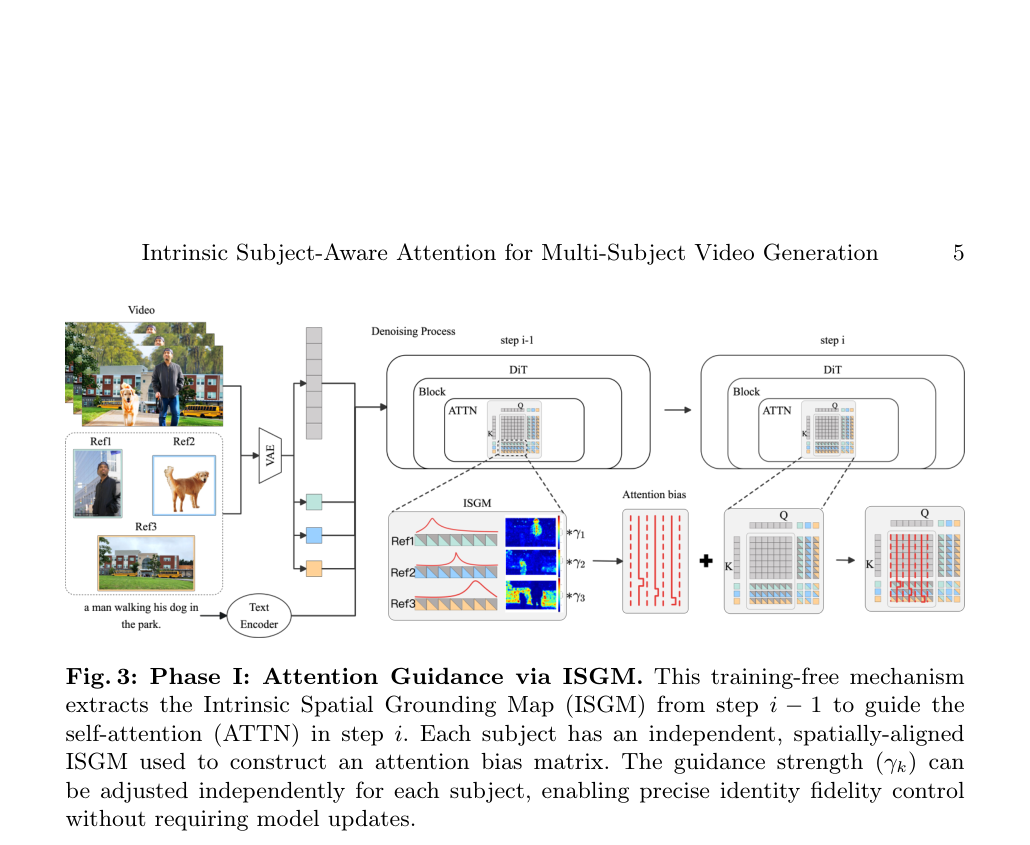
本文提出 DIAL 框架,通过挖掘 DiT 中的 Intrinsic Spatial Grounding Map (ISGM),在低噪声阶段实现免训练的可控保真度引导,在高噪声阶段通过零成本偏好优化锚定主体语义,显著提升了多主体视频生成的身份一致性与稳定性。
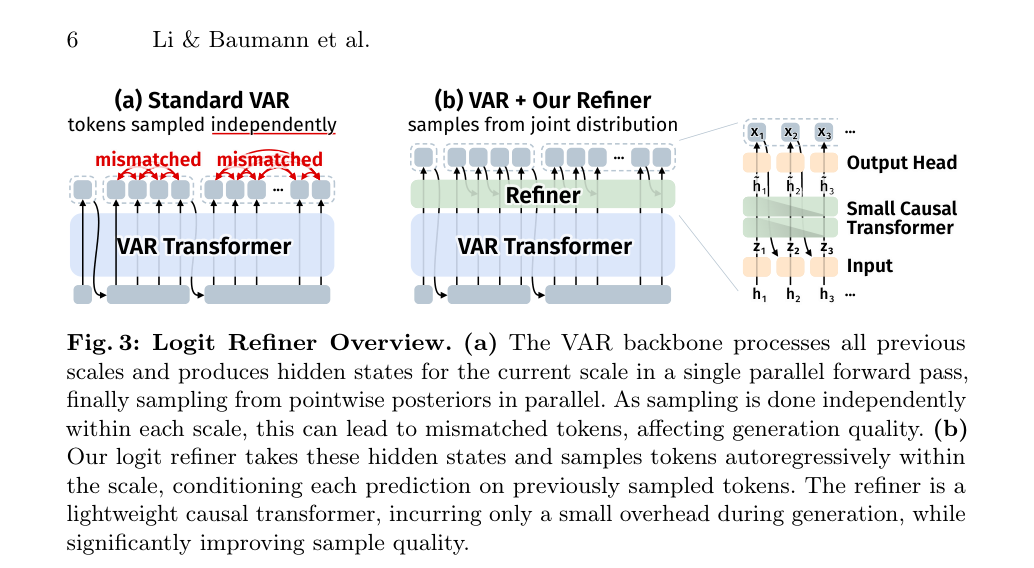
本文提出 Logit Refiner,一个轻量级自回归模块,通过恢复 VAR 模型中尺度内 token 的联合分布依赖,在不重新训练骨干网络的前提下显著提升了图像生成的空间一致性。
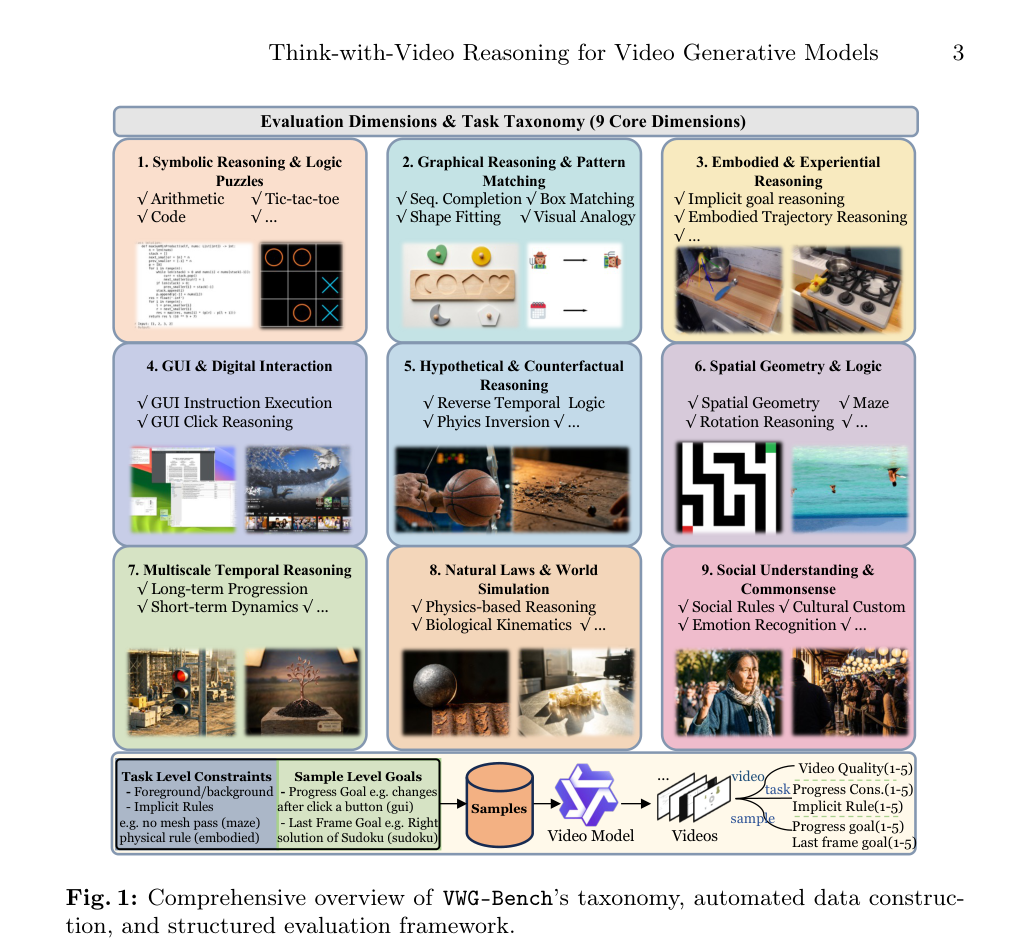
本文提出了涵盖9个推理维度的VWG-Bench基准和基于强化学习的Vid-PRE提示增强模块,旨在诊断并提升视频生成模型在逻辑、物理及空间推理任务中的表现。
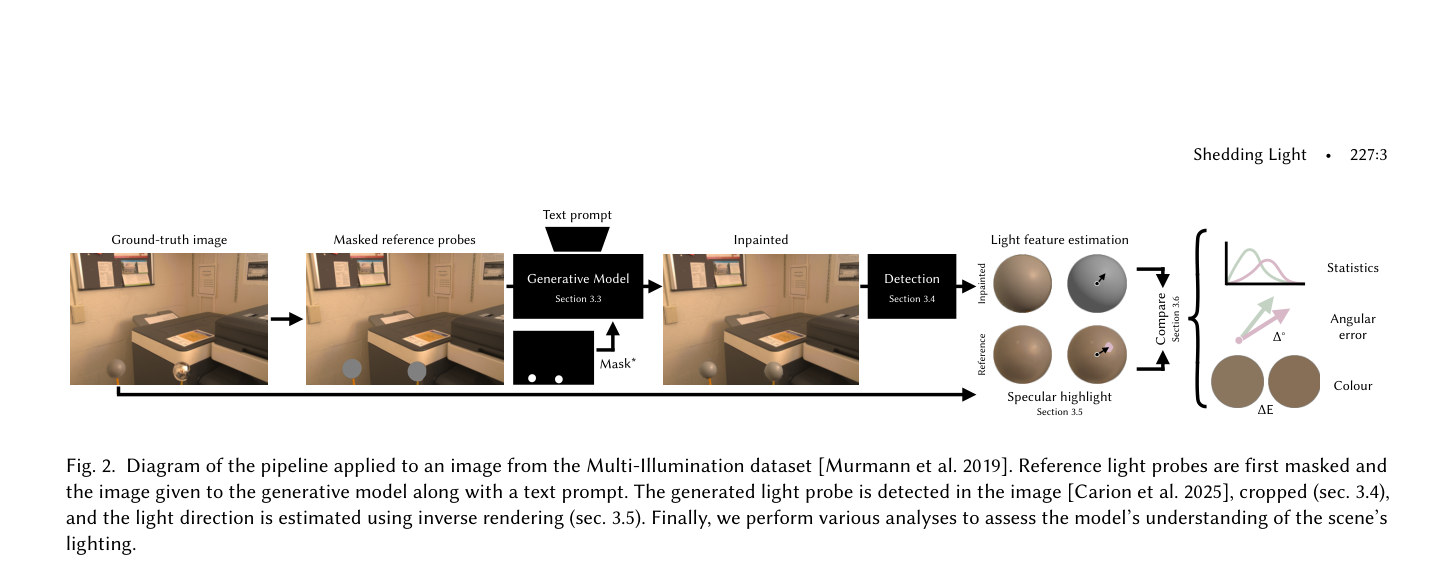
本文提出了一种基于 inpainting 和物理渲染逆问题的基准测试方法,通过让生成模型在真实场景中插入“光探针”(diffuse spheres),定量评估了 16 个 SOTA 生成模型对场景光照方向、颜色及空间变化的物理准确性。