快速导读:SparSTAR提出一种免训练的块稀疏注意力框架,在每个高成本尺度上动态构建per-head稀疏掩码,为InfinityStar视频自回归生成提供约1.6×端到端加速且保持VBench质量。
SparSTAR针对InfinityStar时空自回归(STAR)视频生成中晚期尺度的注意力成本瓶颈,提出一种免训练的块稀疏注意力框架。其核心主张是:在STAR的混合KV上下文下,从扩散模型或图像VAR迁移的稀疏模式不可靠,必须在每个高成本尺度上从当前激活动态重建稀疏掩码。
论文通过三项分析实验建立这一主张:跨尺度模式复用导致平均35.6%的注意力质量损失;跨clip边界复用Clip 1模式仅保留56%注意力质量,而Clip 2新鲜选择保留85%;每尺度重算相比单次迁移提升PSNR 1.73 dB,额外延迟仅0.30秒。基于此,SparSTAR用clip感知的块选择器在每个尺度动态构建per-head稀疏掩码,并通过前向-only FlexAttention路径执行。
英文题目:SparSTAR: Sparse Attention for SpaceTime AutoRegressive Video Synthesis
论文出处:arXiv 每日论文精选 · arXiv:2608.10519
原始论文:PDF / 论文页面
这篇论文解决什么问题?
InfinityStar的STAR生成在720p最终尺度包含约72,000个token,每个尺度都需要密集关注参考上下文、文本条件和当前尺度token,注意力成本随尺度增长急剧上升。SSA机制虽然将历史上下文压缩为前一clip的最终尺度,但当前clip内部的密集注意力仍然是主要开销。
现有免训练稀疏注意力方法大多针对固定分辨率的扩散去噪网格设计。Sparse VideoGen的per-head动态选择假设固定的空间网格结构,Radial Attention依赖时空能量衰减的静态掩码,这些假设在STAR的混合KV上下文中不成立。
SparVAR在图像VAR中通过跨尺度复用注意力模式实现加速,其前提是相邻尺度的token存在对应关系,可以从历史尺度token推断当前尺度的稀疏模式。但在InfinityStar的SSA掩码下,历史尺度token并不完整保留,跨尺度模式相似性被破坏,直接迁移会导致明显的注意力质量损失。
FastSTAR走的是token剪枝路线,与SparSTAR的注意力边稀疏化互补。两者可以叠加使用,这为SparSTAR的兼容性实验提供了自然基线。
核心创新
- 系统分析证明InfinityStar中注意力模式跨尺度和跨clip边界不可靠迁移,跨尺度复用导致平均35.6%的注意力质量损失
- 提出clip感知的块选择器,在每个尺度上从当前激活动态构建per-head稀疏掩码,不跨尺度或跨clip复用模式
- 开发前向-only FlexAttention执行路径(FastFlex),省略推理不需要的反向索引结构
- 采用递减密度调度(0.625, 0.1875, 0.1875, 0.09375),对token最多的最终尺度施加最强稀疏
方法概览
SparSTAR在每个高成本尺度和每个注意力头上,从当前query和key激活中动态评分并选择连续key块:将query和KV序列按128-token块划分,计算聚合query-key块兼容性分数Sij,按clip感知策略保留文本块(及Clip 1的图像金字塔块)为dense,对其余块联合Top-K选择,通过前向-only FlexAttention路径(FastFlex)执行稀疏注意力。
- 块划分与聚合评分:将query和KV序列按128-token块划分,对块内向量取均值后计算聚合query-key兼容性分数Sij,避免token级评分的计算开销。
- clip感知保留策略:Clip 1中文本块和图像金字塔块强制保留为dense,后续clip仅文本块dense,其余块参与联合Top-K选择。这一策略保证条件信息不被稀疏化破坏。
- per-head动态掩码:每个注意力头独立计算自己的稀疏掩码,不共享模式。这允许不同头关注不同的时空区域,保持注意力表达的多样性。
- 递减密度调度:四个被稀疏化的细化尺度采用密度0.625、0.1875、0.1875、0.09375,token最多的最终尺度施加最强稀疏,因为该尺度的注意力冗余度最高。
- FastFlex执行路径:基于FlexAttention的前向-only变体,省略推理不需要的反向索引结构,稀疏算子比FlashAttention-2快7.08倍,选择和掩码构建增加不到1.7%端到端延迟。
- 免训练特性:整个框架不需要任何微调或梯度更新,可以直接应用于预训练的InfinityStar模型,降低了部署门槛。
逐图理解论文
失败案例:复用模式的代价
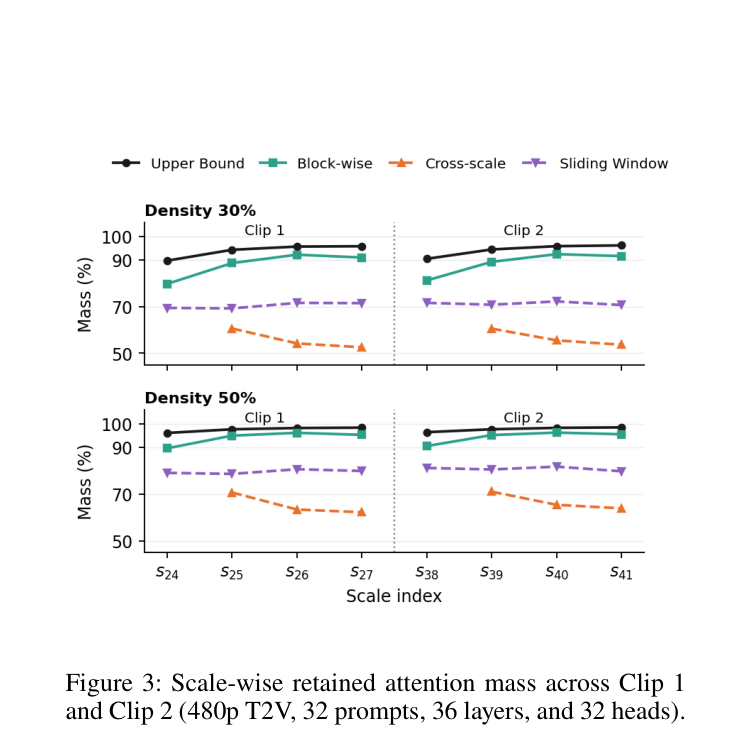
该图展示Clip 1和Clip 2各尺度的保留注意力质量分布。观察不同尺度间保留质量的波动幅度,可以理解为什么跨尺度复用模式会损失大量注意力质量。
研究缺口:跨clip边界同样失效
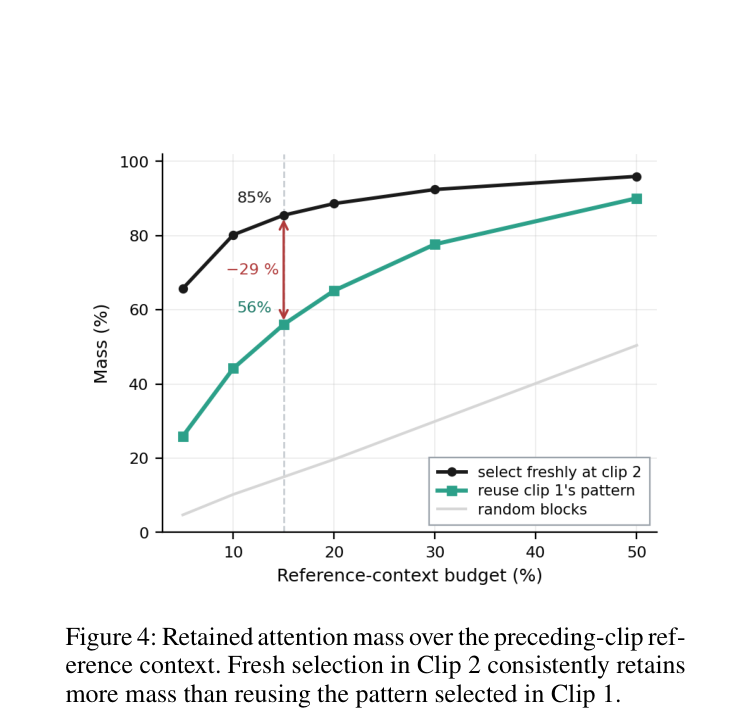
更棘手的是跨clip边界。在双clip生成中,有人可能想复用Clip 1选好的模式来处理Clip 2的参考上下文。论文发现,在相同的参考上下文预算下,Clip 2新鲜选择能保留百分之八十五的注意力质量,而直接复用Clip 1的模式只保留百分之五十六,整整损失二十九个百分点。这说明注意力模式不仅跨尺度不可靠,跨clip也不可靠。现有的免训练稀疏方法,无论是针对扩散网格设计的,还是依赖跨尺度模式相似性的,都无法直接迁移到STAR的混合KV上下文里。
SparSTAR的贡献:每尺度动态重建
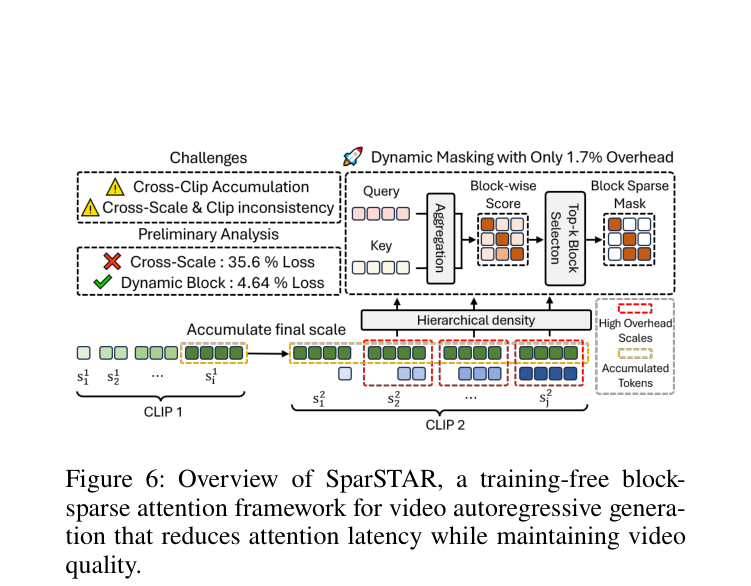
该图是SparSTAR的框架总览,展示块划分、聚合评分、clip感知保留和FastFlex执行的关键组件及其数据流。
验证:质量保持与加速
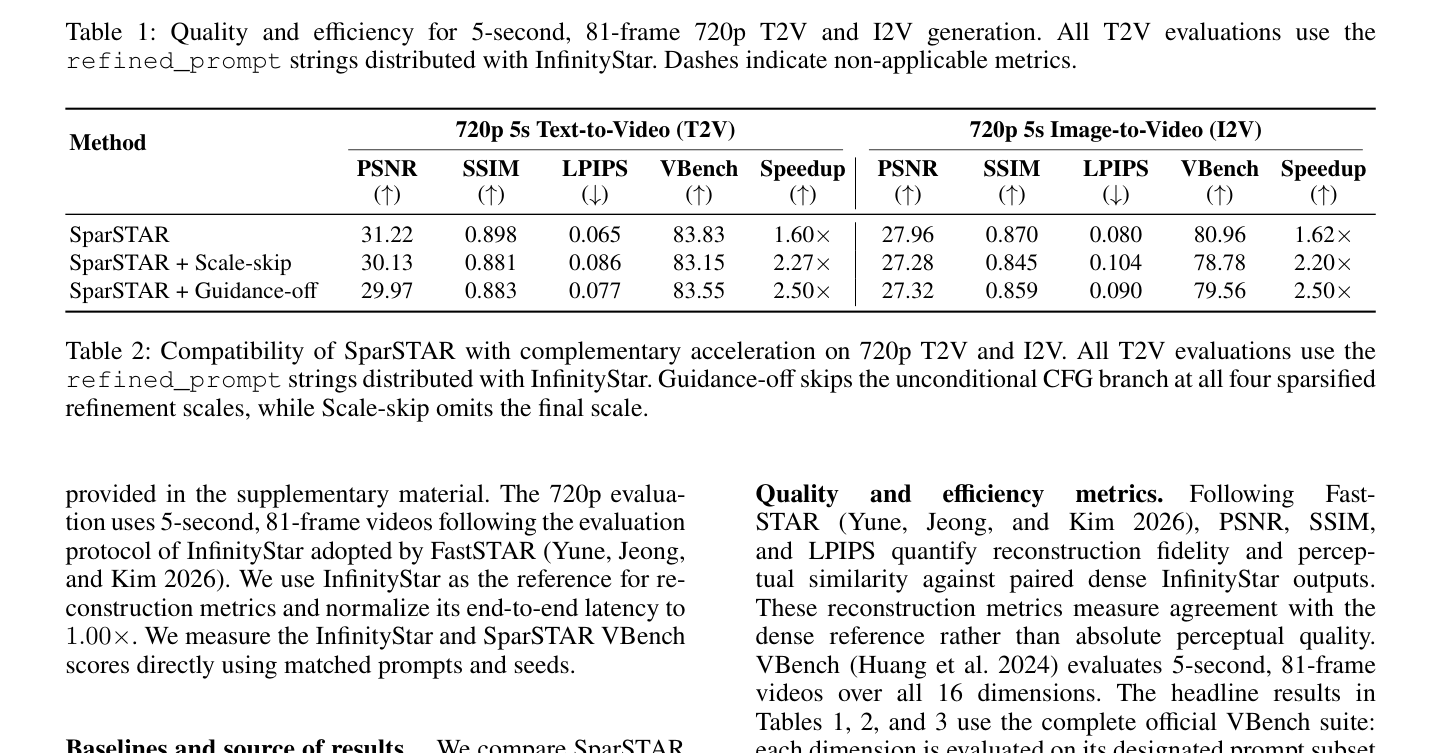
该表汇总720p主实验的质量和效率指标,SparSTAR与dense、FastSTAR等基线的对比直接支撑论文的核心贡献声明。
结论与局限
该表展示480p 10秒长视频结果,VBench下降幅度小,验证了跨clip场景下动态重算的质量保持能力。
实验如何设计?
- 主实验覆盖720p 5秒81帧的T2V和I2V生成,评估PSNR、SSIM、LPIPS和VBench综合质量指标,同时测量端到端加速比。
- 长视频实验覆盖480p 10秒双clip生成,验证跨clip场景下动态重算的必要性和SparSTAR的质量保持能力。
- 三项分析实验分别考察跨尺度模式一致性、跨clip边界模式持久性、以及尺度距离对模式复用效果的影响,为动态重算提供实证依据。
- 消融实验对比递增、恒定、递减三种密度调度,验证递减调度在质量-效率权衡上的优势。
- 补充实验包括480p 5秒设置、选择策略对比和块大小消融,覆盖更广泛的操作条件。
关键结果与论文证据
- 720p T2V主结果:SparSTAR达到PSNR 31.22 dB、VBench 83.83,端到端加速1.60倍,相比FastSTAR的PSNR提升2.92 dB(第6页Table 1)。
- 720p I2V主结果:SparSTAR达到PSNR 27.96 dB、VBench 80.96,加速1.62倍,相比FastSTAR提升2.31 dB(第6页Table 1)。
- 兼容性:SparSTAR与Guidance-off叠加后720p T2V/I2V均达2.50倍加速,VBench分别为83.55和79.56,证明稀疏注意力与CFG跳过互补(第6页Table 2)。
- 长视频:480p 10秒T2V中SparSTAR加速1.31倍,VBench 82.77,相比dense的83.64仅下降0.87;I2V下降0.46,质量损失可控(第7页Table 3)。
- 跨尺度复用损失:跨尺度模式复用导致平均35.6%注意力质量损失,而每尺度重算Block-wise Top-K与token-wise上界平均差距仅4.64%,证明动态重算接近最优(第3页Figure 3)。
- 跨clip边界:15%参考上下文预算下,Clip 2新鲜选择保留85%注意力质量,复用Clip 1模式仅保留56%,损失29个百分点(第4页Figure 4)。
- 重算频率:每尺度模式更新相比单次迁移提升PSNR 1.73 dB,额外延迟仅0.30秒;每2尺度更新恢复0.79 dB(第4页Figure 5)。
- 密度调度消融:递减调度在质量和效率上均优于递增和恒定调度,验证了晚期尺度冗余度更高的假设(第7页Figure 7)。
阅读时需要注意
- 仅在8B InfinityStar单一模型上验证,未覆盖更广泛的STAR模型家族或其他视频自回归架构。
- 长视频评估仅覆盖双clip(10秒)场景,更长多clip生成的累积效应和误差传播未验证。
- 块大小和密度调度对性能的敏感性未充分探索,块大小低于128时无有效FlexAttention kernel配置。
- clip感知策略的独立贡献未通过消融实验量化,无法区分其与动态重算各自的增益。
- 稀疏模式对时间一致性的影响未系统评估,VBench的时间维度可能无法完全捕捉长程时序退化。
关联工作
- InfinityStar引入SSA将历史上下文压缩为前一clip的最终尺度,这是SparSTAR需要处理的混合KV上下文的基础。
- SparVAR的跨尺度模式复用是SparSTAR最直接的对比对象,论文通过分析实验证明其在SSA下不可靠。
- FastSTAR的token剪枝与SparSTAR的注意力边稀疏化正交,两者叠加可获额外加速。
- FlexAttention为SparSTAR提供了kernel级编程能力,FastFlex是其前向-only优化变体。