快速导读:本文提出两种针对免训练重建式AI生成图像检测器的对抗攻击方法(潜在空间攻击与像素空间攻击),证明该类检测器存在固有脆弱性。
本文针对免训练重建式AI生成图像检测器(如AEROBLADE、HFI、RDD)的对抗鲁棒性展开系统研究。这类检测器利用LDM自编码器对生成图像的重建误差低于真实图像这一假设进行检测,因无需训练、可解释性强而受到关注。然而,作者发现其核心检测原理——重建误差——本身就是一个可被定向攻击的脆弱点。
论文提出两种基于梯度的对抗攻击方法:Llatent在潜在空间最大化扰动前后图像编码的距离,使图像偏离AE流形;Lpixel在像素空间直接最大化原图与重建图之间的LPIPS距离。实验表明,在极小的L∞扰动预算下,三种主流检测器的AUROC即可降至随机水平以下,且攻击具有跨AE、跨检测器的迁移性,并在JPEG压缩和模糊等真实退化下保持有效。
英文题目:Training-Free Reconstruction-Based AI-Generated Image Detectors Are Inherently Vulnerable to Adversarial Examples
论文出处:arXiv 每日论文精选 · arXiv:2608.16646
原始论文:PDF / 论文页面
这篇论文解决什么问题?
重建式检测器的基本假设是:LDM自编码器在生成图像上重建误差低,在真实图像上重建误差高。这一假设源于生成图像位于AE流形附近,而真实图像则偏离该流形。AEROBLADE利用AE重建误差和LPIPS检测LDM生成图像;HFI通过高频分量分离改进重建误差计算;RDD结合像素空间和潜在空间去偏重建误差。
然而,这一检测原理的对抗鲁棒性此前未被系统研究。Carlini & Farid曾证明基于神经网络的检测器易受白盒和黑盒攻击,但免训练重建式检测器因不依赖分类器,常被默认具有更强的鲁棒性。本文的核心问题是:如果攻击者直接针对重建误差这一检测信号进行优化,这类检测器是否还能保持有效?
作者指出,重建式检测器的脆弱性源于其检测信号本身的可微性。AE编码器和解码器都是可微的神经网络,因此重建误差对输入图像的梯度可以被计算并用于构造对抗扰动。这意味着攻击者不需要欺骗一个分类器,只需要让图像的重建误差发生系统性偏移即可。
这一研究空白具有重要的现实意义:AI生成图像检测器被部署在内容审核、虚假信息检测等安全场景中,如果攻击者能够以不可察觉的扰动绕过检测,这些系统的实际价值将大打折扣。
核心创新
- 首次系统揭示免训练重建式AI生成图像检测器的固有对抗脆弱性
- 提出潜在空间攻击Llatent,通过最大化编码距离使图像偏离AE流形
- 提出像素空间攻击Lpixel,直接最大化原图与重建图的LPIPS距离
- 证明攻击跨AE、跨检测器可迁移,且在JPEG压缩和模糊等真实退化下仍有效
方法概览
提出两种基于梯度的攻击:Llatent在潜在空间最大化扰动前后图像编码的距离,使图像偏离数据流形;Lpixel在像素空间直接最大化原图与重建图之间的LPIPS距离。两者均以PGD方式在L∞扰动预算内迭代优化。
- Llatent攻击:在潜在空间最大化扰动前后图像编码之间的距离,使扰动后的图像偏离AE流形。具体而言,攻击者计算编码器输出对输入图像的梯度,沿梯度方向迭代更新扰动,使图像在潜在空间中远离原始位置。
- Lpixel攻击:在像素空间直接最大化原图与重建图之间的LPIPS距离。LPIPS作为感知相似性度量,比MSE更能反映人类视觉感知,因此攻击者优化的是感知层面的重建差异。
- 两种攻击均以PGD方式在L∞扰动预算内迭代优化。PGD框架通过投影操作确保扰动不超过预设的epsilon-budget,保证对抗样本在视觉上与原始图像几乎不可区分。
- 攻击目标函数的设计直接对应检测器的核心假设:Llatent攻击使图像偏离AE流形,从而增大重建误差;Lpixel攻击直接增大重建误差本身。两者从不同角度瓦解检测信号。
- 跨AE迁移性评估:攻击者使用不同AE(SD2、SD3.5、Flux AE)生成对抗样本,然后在三种检测器上评估攻击效果,验证攻击是否依赖于特定的AE结构。
- 真实场景鲁棒性评估:在JPEG压缩(q=10到100)和高斯模糊(σ=0.5到5)下评估攻击效果,模拟对抗样本在社交媒体等真实传播渠道中可能经历的退化。
- 消融实验:用MSE替代LPIPS作为攻击距离函数,评估感知度量在攻击中的必要性;同时评估RDD完整分数(含Slatent)对攻击的防御效果。
- 实验数据:在Synthbuster子集(Midjourney-v5、Flux.1-schnell、SD3.5)与RAISE-1k真实图像上评估,共300张合成图与100张真实图。
逐图理解论文
直觉与失败案例
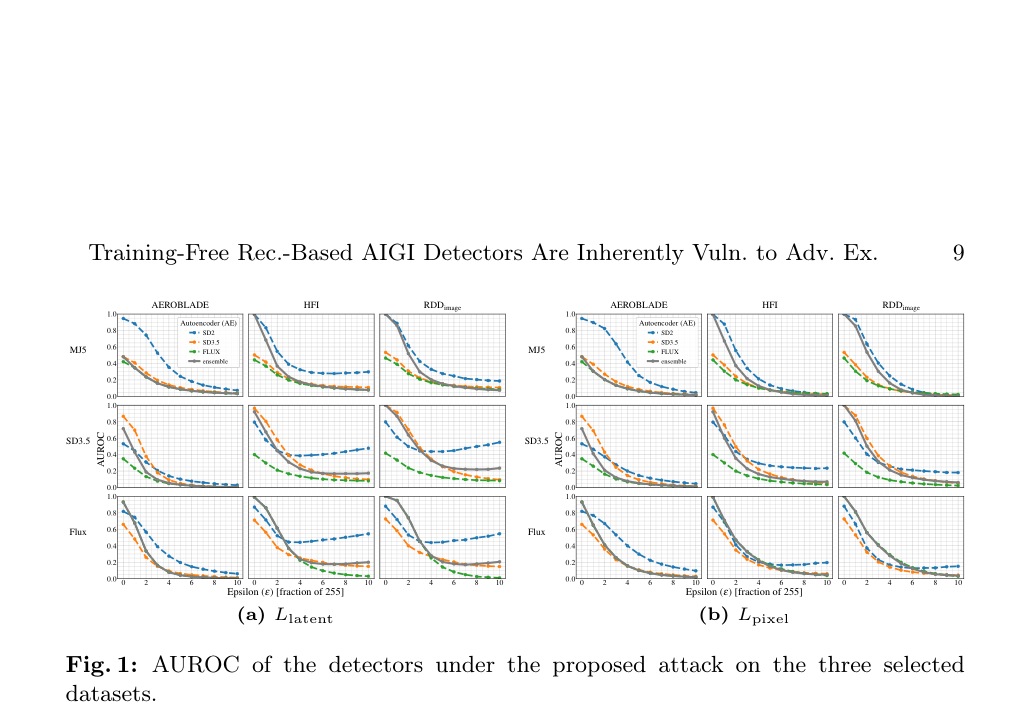
图1展示了三种检测器在三个数据集上随epsilon-budget增大的AUROC变化。重点观察AUROC从接近1迅速降至0.5以下的转折点,这直观说明了检测器在极小扰动下即失效的固有脆弱性。
研究空白与核心区分
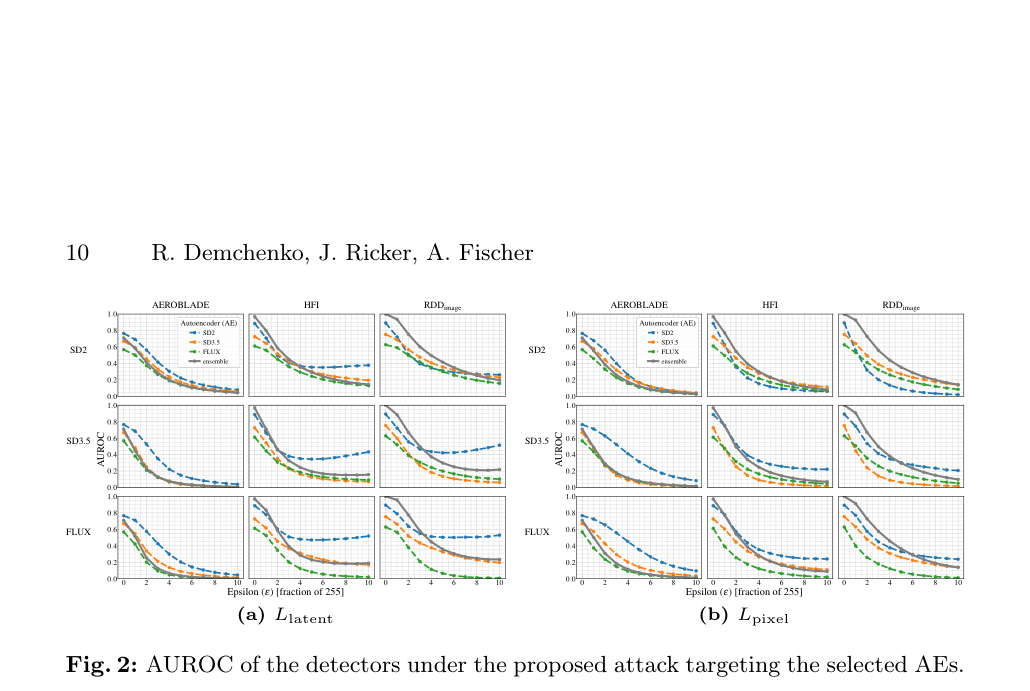
图2展示了跨AE迁移性实验结果。观察使用不同AE(SD2、SD3.5、Flux AE)生成的攻击在三种检测器上的AUROC变化,验证攻击不依赖于特定AE结构。
结论与意义
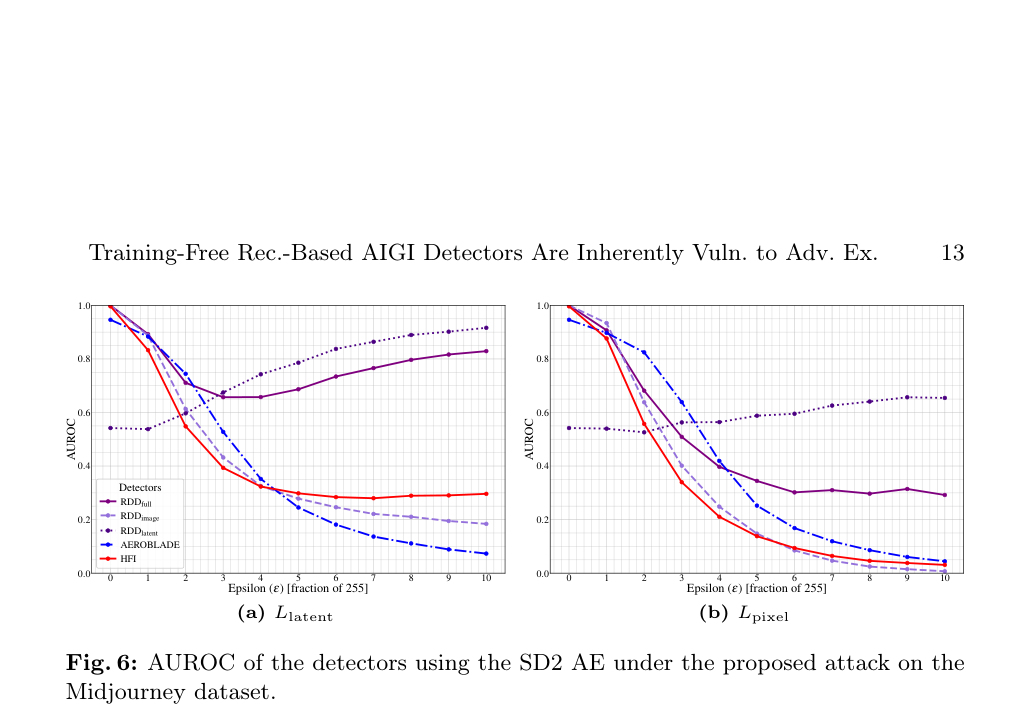
图6展示了RDD完整分数(含Slatent)在攻击下的表现。观察Slatent分数对Llatent攻击的防御效果,这是论文中唯一显示潜在防御可能性的结果。
实验如何设计?
- 数据集:Synthbuster子集包含Midjourney-v5、Flux.1-schnell、SD3.5三种生成模型的图像,真实图像来自RAISE-1k数据集,共300张合成图与100张真实图。
- 攻击强度:epsilon-budget从1/255到10/255,覆盖从几乎不可察觉到轻微可见的扰动范围,评估检测器在不同攻击强度下的表现。
- 评估指标:AUROC衡量检测器区分真假图像的能力,AUROC=0.5表示随机水平,低于0.5意味着检测器被反向利用。
- 对抗样本质量:用LPIPS和SSIM衡量扰动不可感知性,与JPEG压缩、模糊、噪声等常见退化进行对比,确保攻击在视觉上不可察觉。
- 跨AE迁移性:分别使用SD2、SD3.5、Flux AE生成攻击,在AEROBLADE、HFI、RDD三种检测器上评估,验证攻击的通用性。
- 真实退化鲁棒性:在JPEG压缩(q=10到100)和高斯模糊(σ=0.5到5)下评估攻击效果,模拟真实传播场景。
关键结果与论文证据
- 检测不可靠(AUROC≤0.5)出现在epsilon=3/255或4/255,针对所有AE和数据集(第9页)。这意味着仅需极小的扰动预算,三种检测器即全部失效。
- Llatent在epsilon=3时AUROC降至0.5以下,LPIPS约0.24,SSIM约0.96(第11页)。扰动在感知上几乎不可察觉,但检测器已完全失效。
- Lpixel在epsilon=3时AUROC降至0.5以下,但LPIPS约0.38(第11页)。相比Llatent,Lpixel的扰动在感知上更明显,但攻击效果同样致命。
- JPEG q=90时攻击效果略有减弱(因压缩破坏扰动),但更高压缩水平下攻击仍有效(第11页)。对抗样本在真实传播退化下保持攻击力。
- RDD的Slatent分数随扰动增强而AUROC上升,对Llatent攻击的防御效果显著,对Lpixel较弱(第13页)。这表明潜在空间分数可能提供部分防御能力。
- MSE替代LPIPS后攻击效果明显减弱,但对AEROBLADE及多数HFI/RDD配置仍有效(第12页)。感知度量增强了攻击效率,但并非攻击成功的必要条件。
- 跨AE迁移性实验表明,使用不同AE生成的攻击在三种检测器上均有效(第10页),说明攻击不依赖于特定的AE结构。
- AUROC低于0.5意味着检测器被反向利用:攻击者不仅绕过检测,还能使生成图像被更自信地判定为真实图像。
阅读时需要注意
- 攻击仅针对重建式检测器,可能不适用于基于分类器的检测方法(如FakeInversion、DIRE等利用完整扩散过程重建并训练分类器的方法)。
- 部分场景假设攻击者能访问生成图像的AE,对专有生成模型可能效果降低。
- 由于计算复杂度,每组实验分析的图像数量相对较少(300张合成图与100张真实图),统计显著性可能受限。
- 论文未提出有效的防御方法,仅指出RDD的Slatent分数可能提供部分防御,但未系统验证。
关联工作
- AEROBLADE:被评估的基线检测器,利用AE重建误差和LPIPS检测LDM生成图像,是免训练重建式方法的代表。
- HFI:被评估的基线检测器,通过高频分量分离改进重建误差计算,试图捕捉生成图像在高频细节上的差异。
- RDD:被评估的基线检测器,结合像素空间和潜在空间去偏重建误差,是当前性能较强的重建式方法。
- Carlini & Farid:开创性工作,证明基于神经网络的检测器易受白盒和黑盒攻击,为本文提供了对抗攻击的方法论基础。
- FakeInversion / DIRE:另一类重建式方法,利用完整扩散过程重建并训练分类器,本文未评估,但其训练依赖可能引入不同的脆弱性。
- PGD:本文攻击方法基于的投影梯度下降对抗攻击框架,是白盒攻击的标准工具。