快速导读:MIRROR 是一个三层放射学流水线,其语言层只读取结构化证据而非像素,从而在架构上保证报告不能断言分类器未检测到的发现。
MIRROR 的核心主张是一个架构层面的保证:报告生成器只能断言分类器已经检测到的发现。这个保证不是靠提示词措辞实现的,而是靠信息流的形状实现的——语言层接收的输入是一个结构化文本载荷,包含标签、概率和区域名,从不包含像素。因此,finding-level grounding 可以通过测试断言,而不是通过基准测量。
论文同时诚实地展示了这个保证的边界。在 detail-level grounding 层面,系统并不保证报告中的具体数值和描述是接地的。图 4(b) 中的报告陈述了心胸比和肋膈角清晰度,而系统中没有任何组件测量过这些量。这个失败案例不是 bug,而是作者刻意展示的边界:架构保证只能覆盖发现集合,不能覆盖细节描述。
英文题目:MIRROR: Multimodal Intelligent Radiology Reasoning and Observation Reporter
论文出处:arXiv 每日论文精选 · arXiv:2608.16709
原始论文:PDF / 论文页面
这篇论文解决什么问题?
放射科医生面对深度模型输出时存在一个信任鸿沟。模型返回一个数字,比如'肺炎概率 0.87',但不解释为什么。Grad-CAM 等显著性方法可以暴露预测来源,语言模型可以把结构化证据渲染成可读文本,但这两者很少被组合成端到端相互一致的系统。
组合它们还引入了第二个更隐蔽的风险:能访问图像的报告生成器可能写出分类器从未产生的发现。一个视觉 LLM 直接读图后生成的报告,可能包含系统从未测量过的断言。这是幻觉问题在放射学报告中的具体形态。
MIRROR 的立场是:与其在事后检测幻觉,不如在架构上让幻觉不可能发生。如果语言层根本看不到图像,它就无法从图像中编造发现。这个立场与 Rudin 的'停止解释黑箱'形成张力——MIRROR 承认自己正是 Rudin 批评的事后解释架构,但认为在临床工作流中,一个可测试的接地保证比一个不可解释的端到端模型更有价值。
核心创新
- 提出 finding-level grounding 与 detail-level grounding 的区分:前者可通过测试断言,后者不成立并在真实生成报告中展示失败。
- 注册表驱动的多模态设计:模态的分类法、解剖词汇和报告措辞是数据而非代码,三种模态已注册、路由并通过测试。
- 开源实现:三种骨干网络、两种可解释性方法、LLM 报告后端与确定性离线回退、真实 DICOM 摄取、两个推理引擎共享同一响应契约。
- 在 ChestMNIST 上展示判别能力与决策能力的分离:所有标签排序优于随机,但默认阈值下 14 个标签中 11 个无阳性预测;Brier 分数与不看图像的常数预测器几乎相同。
方法概览
MIRROR 串联三层:多标签分类器(DenseNet-121/EfficientNet-B0/ViT-B/16,头部宽度等于模态分类法大小)、Grad-CAM/Score-CAM 证据定位层(将每个阳性发现映射到命名解剖区域)、以及临床推理层(LLM 或离线模板,仅接收标签、概率和区域名,从不接收图像)。模态注册表集中管理分类法、解剖词汇和报告措辞,支持胸部X光、脑MRI、头部CT三种模态的路由。
- Layer 1 是多标签分类器,支持 DenseNet-121、EfficientNet-B0 和 ViT-B/16 三种骨干网络,头部宽度等于模态分类法的大小。在 ChestMNIST 上,分类法有 14 个标签。
- Layer 2 是证据定位层,使用 Grad-CAM 或 Score-CAM 将每个阳性发现映射到命名解剖区域。3×3 位置网格是刻意粗糙的解剖描述符,目的是让区域名成为语言层可以消费的离散符号,而不是连续的注意力图。
- Layer 3 是临床推理层,接收的输入只有标签、概率和区域名。这个载荷的形状是 grounding 保证的来源:语言层没有像素、没有文件句柄、没有图像嵌入,因此它无法断言任何不在载荷中的发现。
- modality registry 集中管理分类法、解剖词汇和报告措辞。注册意味着路由、头部尺寸和词汇表都经过测试。胸部 X 光、脑 MRI 和头部 CT 三种模态已注册,但只有胸部 X 光有训练检查点和基准结果。
- 两个推理引擎共享同一个响应契约:本地 PyTorch 栈实现图 1 的接地架构,托管 serverless 引擎让视觉 LLM 直接读图。只有本地栈被基准测试,托管引擎中的 grounding 约束不成立。
- pertinent negatives 的设计:低于置信阈值的预测以阴性形式呈现,而不是被丢弃。这让不确定性保持可见,报告读者可以看到系统考虑了哪些发现但认为它们不存在。
逐图理解论文
一个具体的失败案例
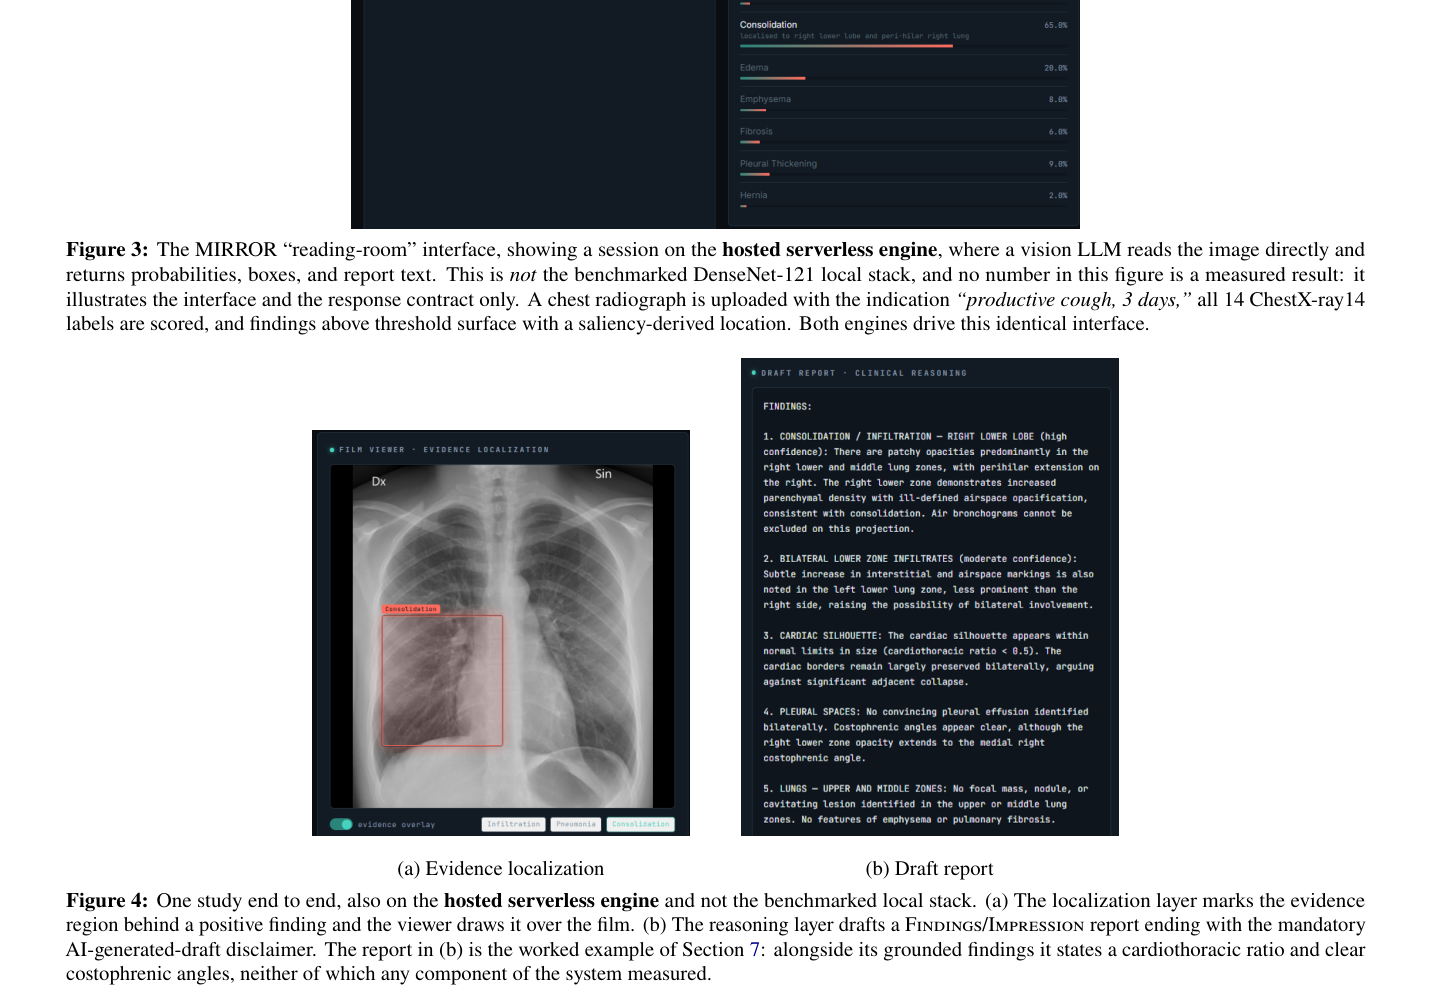
图 4 展示一个端到端研究案例。注意 (b) 中的报告除了接地发现外,还陈述了心胸比和肋膈角清晰度——系统中没有任何组件测量过这些量。这是 detail-level grounding 失败的实例。
核心区分:发现级接地与细节级接地
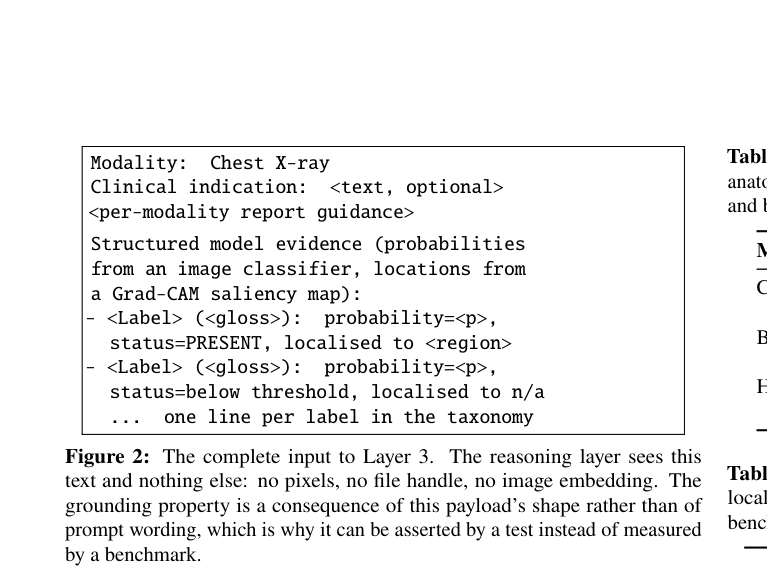
图 2 展示 Layer 3 的完整输入载荷。注意它只有文本:标签、概率和区域名,没有像素、文件句柄或图像嵌入。grounding 性质是这个载荷形状的推论,而非提示词措辞的结果。
架构如何实现接地保证
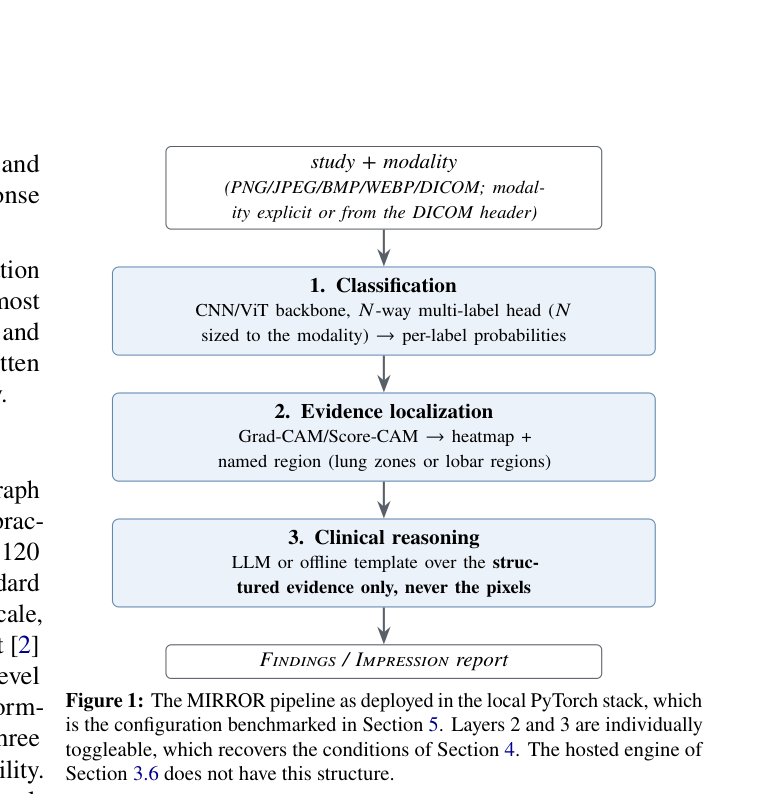
图 1 展示本地 PyTorch 栈中的 MIRROR 流水线结构。重点观察 Layers 2 和 3 的可切换设计:关闭它们就恢复了第 4 节的消融条件。这是 grounding 保证的架构来源。
判别能力与决策能力的分离
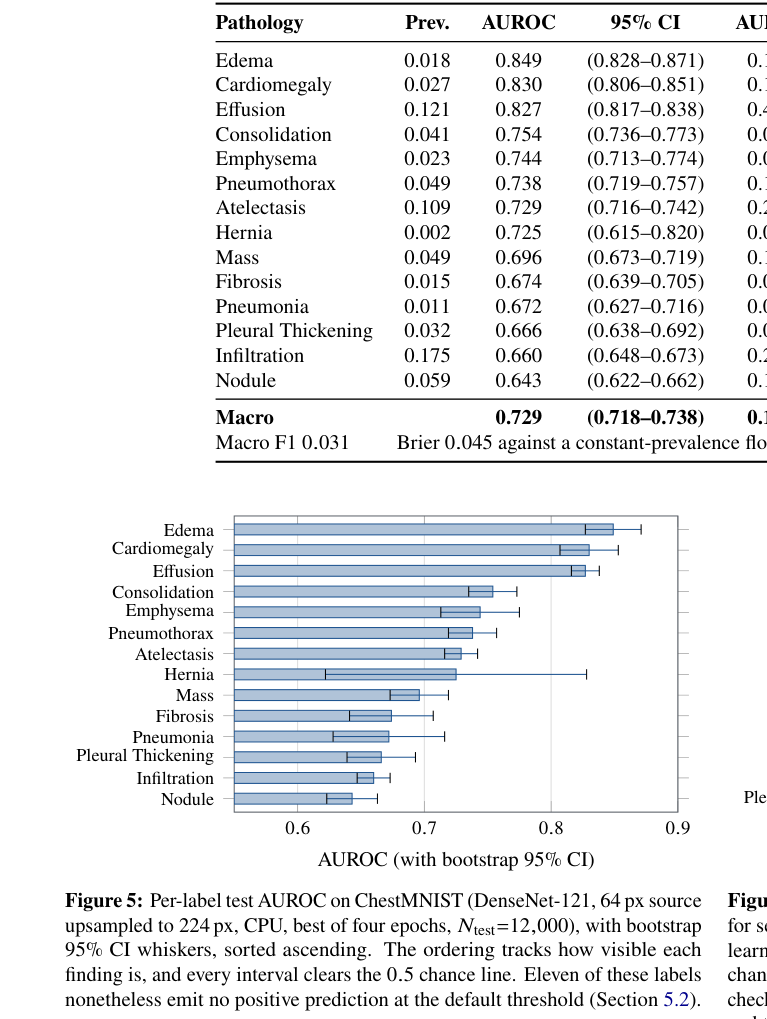
图 5 展示 ChestMNIST 上逐标签 AUROC 的排序。所有置信区间都越过 0.5 机会线,但其中 11 个标签在默认阈值下无阳性预测。判别能力与决策能力的分离在此图中清晰可见。
结论与局限
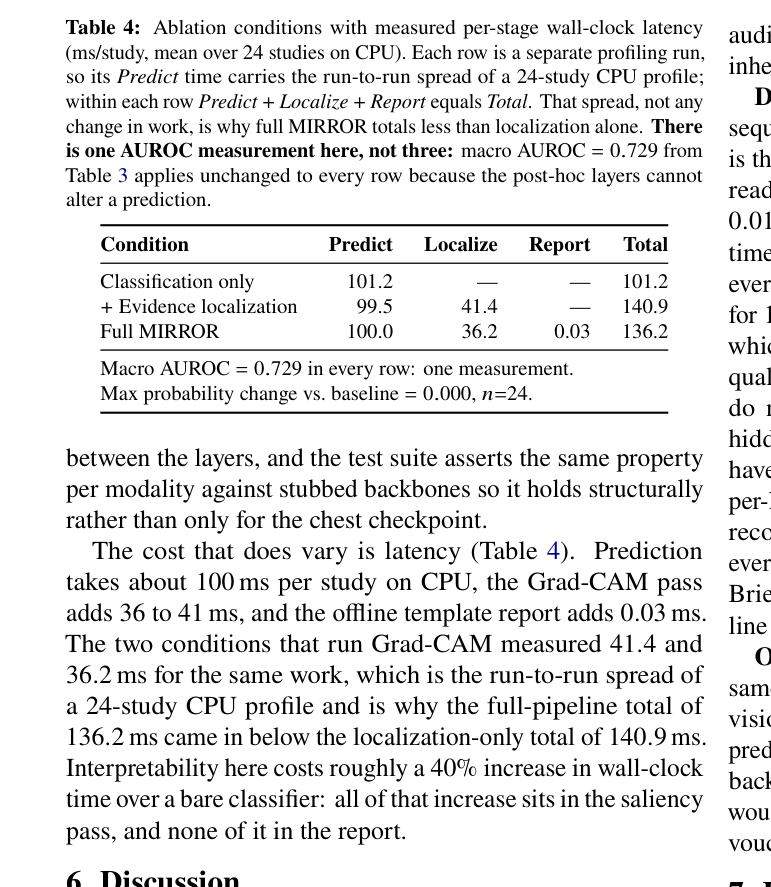
表 4 展示延迟消融。注意每行是独立 profiling 运行,Predict 时间带有运行间波动。全 MIRROR 总时间低于单独定位的原因是波动而非工作量减少。
实验如何设计?
- 主基准在 ChestMNIST 测试集上进行,N=12,000,DenseNet-121 骨干,64px 源图像上采样到 224px,CPU 训练,四轮中取最佳。
- 合成数据控制实验:1,400 张程序生成的类胸片图像,生成器为七个预命名标签注入可见斑点,其余七个无视觉关联。目的是验证指标测量的是真实判别能力而非标签频率。
- 事后不变性回归测试:三种条件(仅分类、分类+定位、完整流水线)下比较最大逐标签概率,n=24,验证 Layers 2 和 3 不改变预测。
- 每阶段墙钟延迟消融:24 个研究在 CPU 上的平均耗时,分别测量 Predict、Localize 和 Report 三个阶段。
关键结果与论文证据
- ChestMNIST 上 macro AUROC 为 0.729,bootstrap 95% CI [0.718, 0.738],所有标签排序优于随机(第 5 页)。
- 但默认阈值 0.5 下,14 个标签中 11 个无阳性预测,macro sensitivity 仅 0.019。判别能力与决策能力严重分离(第 5 页)。
- AUPRC lift over prevalence 从 1.6×(Fibrosis)到 6.8×(Cardiomegaly),均值 3.1×,说明排序确实优于随机(第 5 页)。
- Brier 分数 0.045 与常数预测器的 0.047 几乎相同,ECE 0.018。聚合校准指标在类别不平衡下会美化不做事的模型(第 5 页)。
- 合成控制实验中,信号标签平均 AUROC 0.917,无信号标签平均 0.533,两组无重叠,验证了指标的真实性(第 6 页)。
- 事后不变性测试中,最大逐标签概率变化为 0.000(n=24),证明 Layers 2 和 3 不修改预测(第 7 页)。
- 延迟消融:Predict 约 100ms,Localize 增加 36-41ms,Report 增加 0.03ms。接地保证的代价约为 40ms(第 7 页)。
阅读时需要注意
- 唯一的定量基准是 ChestMNIST,64 像素源分辨率、7,200 张训练图像预算,默认阈值下分类器不是可用的检测器。
- 多模态仅为架构层面:脑 MRI 和头 CT 路径已实现并通过测试,但无训练检查点,无预测性声明。
- 解释质量未测量:pointing-game 和 IoU 协议已实现但未运行,未进行 Adebayo 等提出的显著性健全性检查。
- 未进行放射科医生阅读研究,无证据表明定位或报告层对人类有帮助,仅知其成本约 40ms。
- 报告质量仅定性评估,未与真实放射科医生报告(如 MIMIC-CXR)比较。
关联工作
- CheXNet 的 121 层 DenseNet 在肺炎检测上达到放射科医生水平,是 MIRROR 分类器骨干的参照。
- Grad-CAM 通过梯度将 CAM 推广到任意架构,是 MIRROR Layer 2 的默认可解释性方法;Score-CAM 是去除梯度依赖的备选。
- Adebayo 等的显著性健全性检查展示了多种方法对模型和数据不敏感,MIRROR 引用其作为应运行但未运行的检查。
- TieNet 和 R2Gen 代表直接像素到文本的报告生成范式,同样面临幻觉问题。MIRROR 的贡献在于用架构约束而非事后检测来解决这个问题。