快速导读:PixRestore提出一种无VAE的像素空间DiT统一图像复原模型,结合DINO自适应分层视觉引导与单步对抗微调,以约50M参数和44ms延迟在八类退化任务上取得最佳综合质量与效率。
统一图像复原(UIR)的目标是用单一模型处理去模糊、去雾、去噪、去雨、低光增强、超分等多种退化。近年来,基于大规模文生图(T2I)潜空间扩散模型的方法在感知质量上表现突出,但这类路线依赖有损VAE和开放生成先验,容易丢失复原敏感的细节并引入内容不一致的伪影。PixRestore提出了一条相反的技术路线:放弃VAE和T2I预训练,直接在patchified像素空间做flow matching,用冻结的DINOv2提供分层视觉引导,并通过DINO特征空间的对抗目标将多步扩散微调为单步生成器。
论文的核心论点是:强统一图像复原并不需要损失细节的潜空间编码,也不需要十亿级文生图先验。在相同DiT-S设置下,像素空间建模在PSNR、LPIPS和MUSIQ上全面优于三种潜空间方案,同时参数量和延迟更低。配合自适应分层视觉引导和单步微调,PixRestore以约50M参数和44ms延迟在八类退化上取得最佳综合质量与效率。
英文题目:PixRestore: Unified Image Restoration via Pixel Diffusion Transformer
论文出处:arXiv 每日论文精选 · arXiv:2608.16793
原始论文:PDF / 论文页面
这篇论文解决什么问题?
UIR的主流路线之一是CNN/Transformer回归模型,如PromptIR和AirNet。这类方法训练稳定、推理快,但输出容易过度平滑,对严重退化的去除不彻底。另一条路线是基于T2I潜扩散的生成模型,如FoundIR-v2、FLUX-IR和FAPE-IR。它们借助大规模生成先验获得更强的纹理合成能力,但VAE的压缩会丢失高频细节,T2I目标与忠实复原之间存在根本冲突,模型可能生成与输入不一致的内容。
论文通过一个关键实验揭示了潜空间路线的代价:在完全相同的UIR训练和测试设置下,将DiT-S分别放在SD2VAE、FluxVAE和QwenVAE的潜空间中训练,PSNR只有22.10到22.80 dB,而像素空间DiT-S达到26.62 dB;LPIPS从0.21以上降到0.1593。这说明VAE的信息瓶颈本身就是UIR的性能天花板,而不是模型容量或训练数据的问题。
此外,无参考质量指标也存在系统性偏差。论文展示了一个去雨纹案例:PixRestore去雨最彻底,但MUSIQ和AFINE-NR却把它排在最后,反而偏好保留雨纹的LQ输入和FoundIR-v2输出。这意味着仅凭现有无参考指标无法可靠评估退化去除能力,需要一个能反映退化去除的辅助指标。
核心创新
- 提出无VAE、无T2I先验的像素空间DiT用于UIR,在patchified像素上直接flow matching,保留像素对齐细节并降低计算
- 提出基于LQ-HQ DINO特征相似度的自适应分层视觉引导:路由器预测逐层权重用于稠密条件注入,互补权重用于分层特征监督
- 提出DR-Score:基于VLM(Gemini-3.1 Pro)的退化去除评分,弥补MUSIQ/AFINE-NR等无参考指标无法反映退化去除的缺陷
- 通过DINO特征空间对抗目标将多步扩散模型微调为单步生成器,保持质量的同时实现44ms推理
方法概览
PixRestore在patchified像素空间直接做flow matching,采用LightningDiT骨干,无VAE、无T2I预训练。冻结DINOv2提取多层特征,自适应层路由器以LQ-HQ特征相似度为监督预测逐层权重,融合为稠密条件注入DiT交叉注意力,并对不可靠层施加更强HQ特征监督。多步模型经DINO对抗目标微调为单步生成器。
- 像素空间flow matching:PixRestore将LQ图像和噪声状态分别patchify后送入LightningDiT骨干,直接在像素空间学习从噪声到HQ图像的速度场。没有VAE编码解码,没有T2I条件,像素对齐的细节得以保留。
- 冻结DINOv2分层特征提取:用冻结的DINOv2从LQ图像提取多层特征。浅层保留局部结构和细节,深层编码全局语义,不同层对不同退化敏感。
- 自适应层路由器:路由器以LQ-HQ特征相似度为监督,预测每一层DINO特征的权重,将多层特征加权融合为一个稠密条件,通过交叉注意力注入DiT。同时,互补权重用于分层特征监督,对不可靠层施加更强的HQ特征约束。
- DINO对抗单步微调:多步flow matching模型训练完成后,用基于DINO特征的对抗目标微调为单步生成器。判别器在DINO特征空间而非像素空间工作,避免像素级对抗带来的纹理伪影。
- DR-Score退化去除评分:用VLM(Gemini-3.1 Pro)对复原结果打分,专门评估退化是否被去除。每张图测试5次取平均以降低VLM输出的随机性。
- 轻量配置:PixRestore-S含冻结DINO编码器在内共53.7M参数、658G FLOPs、44ms延迟;PixRestore-B为210.89M参数、1842G FLOPs、79ms延迟。
逐图理解论文
潜空间路线的代价
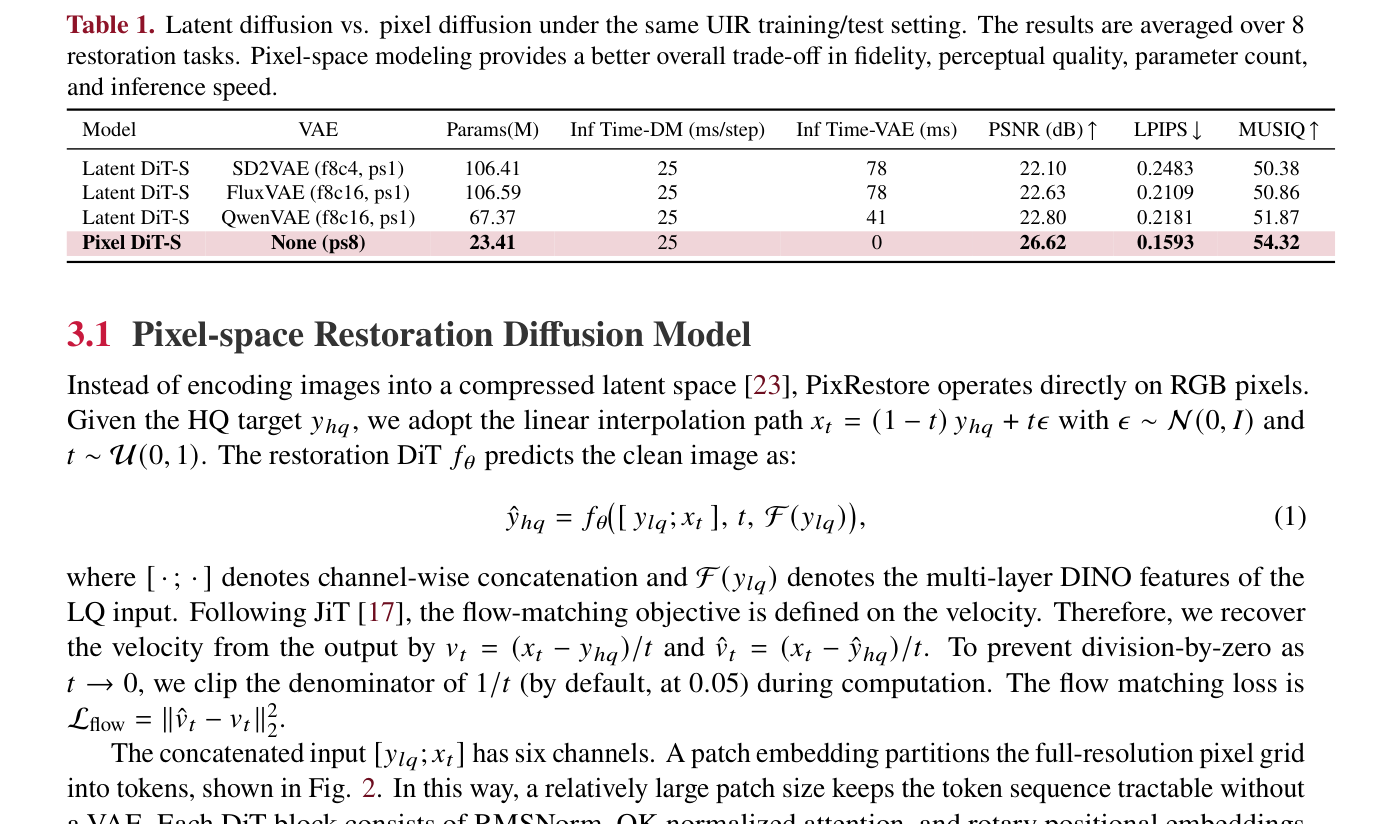
像素空间与三种潜空间方案的对比表。在相同DiT-S设置下,像素空间在PSNR、LPIPS、MUSIQ上全面领先,同时参数量和延迟更低,直接支撑论文的核心论点。
研究缺口与核心区分
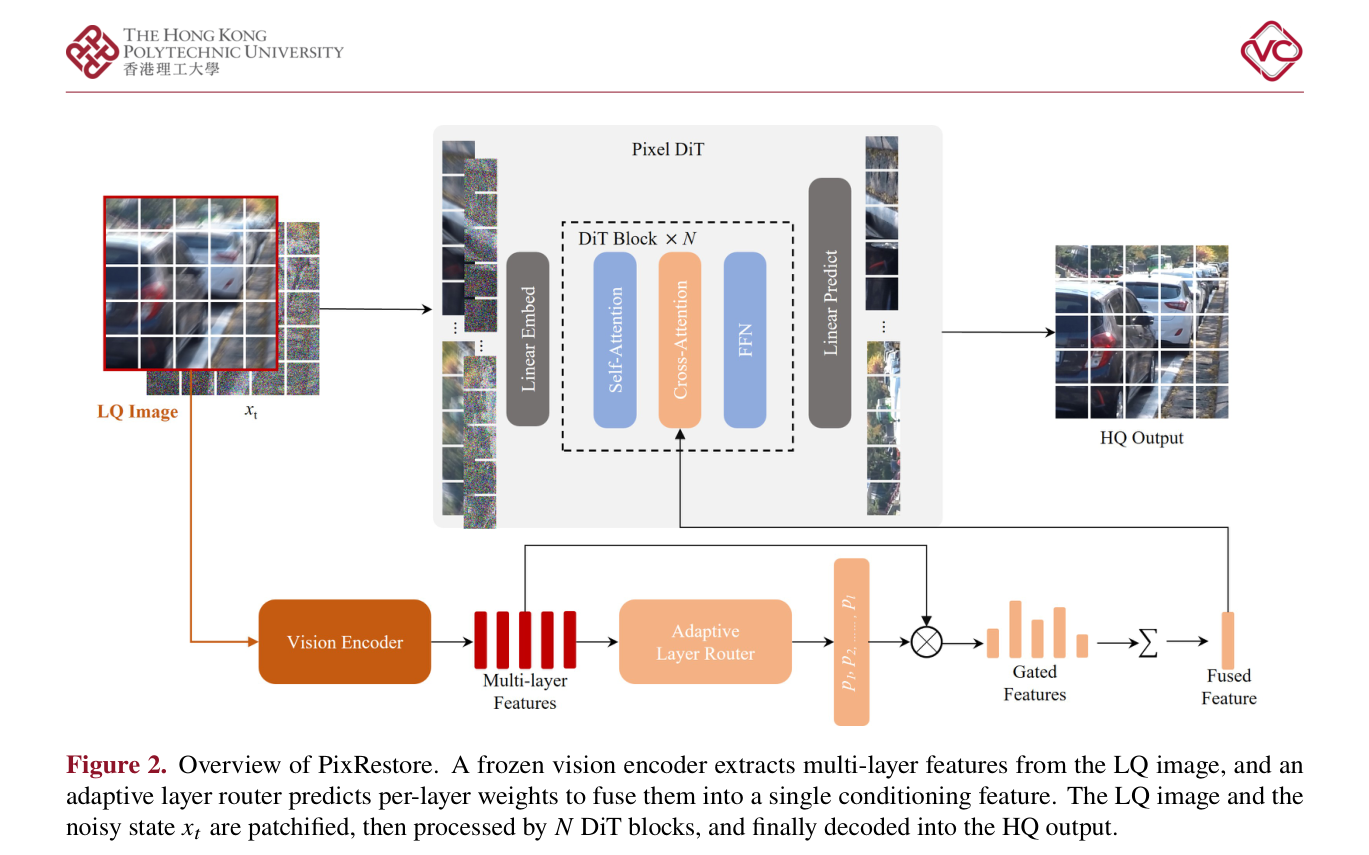
整体架构图。注意LQ图像同时进入冻结DINO编码器和patchify路径,自适应层路由器输出的权重用于融合多层特征,融合后的条件通过交叉注意力注入DiT块。
自适应分层视觉引导
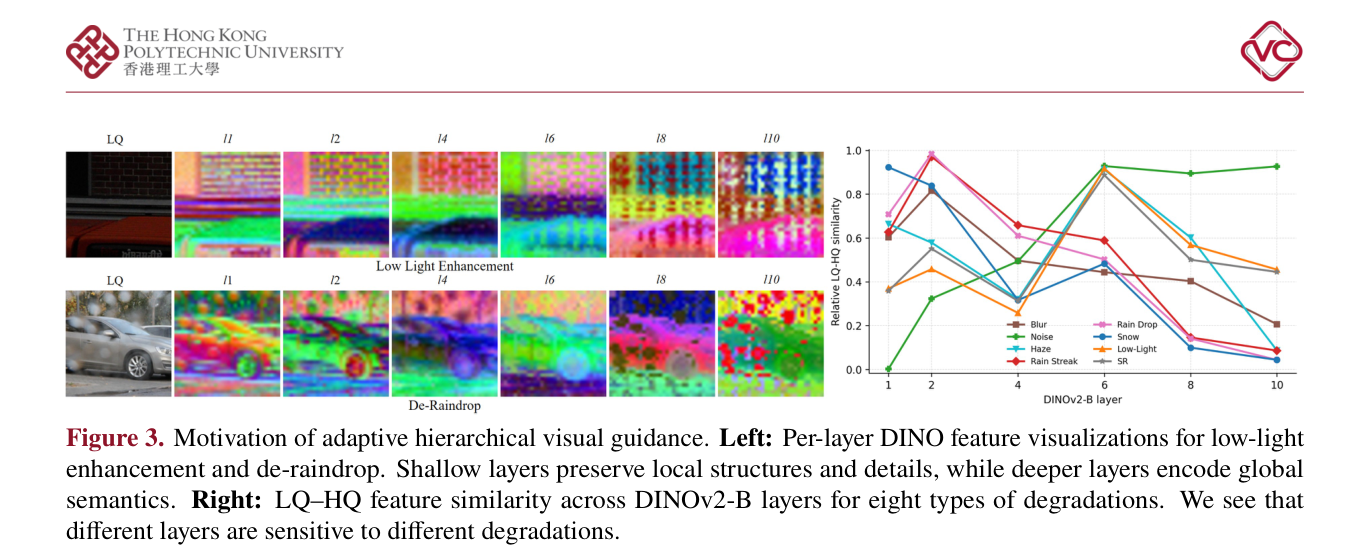
左侧展示DINO各层特征可视化,浅层保留局部结构、深层编码全局语义;右侧展示八类退化下各层LQ-HQ相似度曲线,不同退化对不同层敏感,这是自适应层路由器的动机。
单步生成与效率
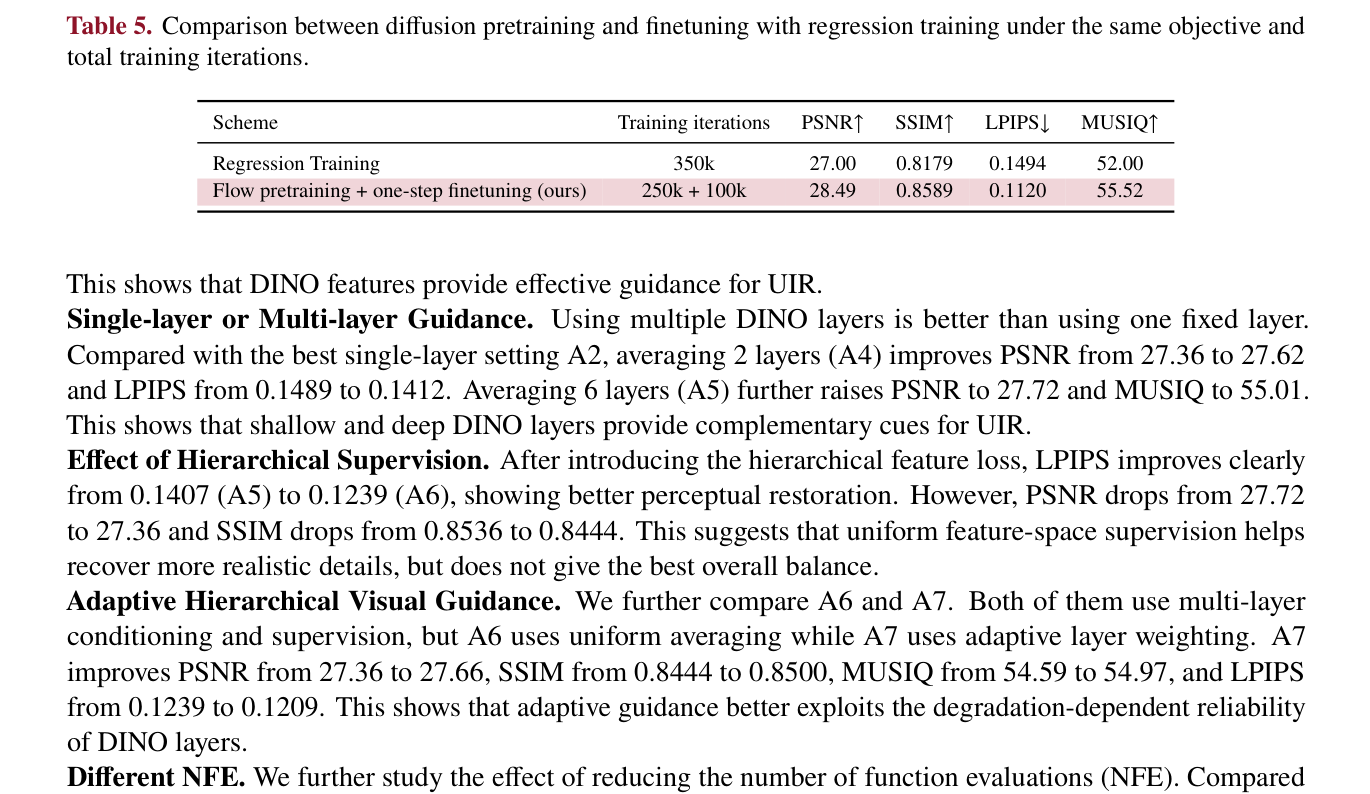
多步扩散虽然质量好,但推理太慢。PixRestore的做法是:先用flow matching预训练多步模型,再用DINO特征空间的对抗目标把它微调成单步生成器。判别器工作在DINO特征空间而不是像素空间,避免了像素级对抗的纹理伪影。对比直接回归训练,这条扩散预训练加单步微调的路线在PSNR、LPIPS和MUSIQ上全面领先。最终,PixRestore-S以约50M参数和44毫秒延迟完成单步推理,比PromptIR、DiffUIR、FoundIR等快7到23倍,计算量只有FoundIR-v2的约一百八十分之一。
结论与意义
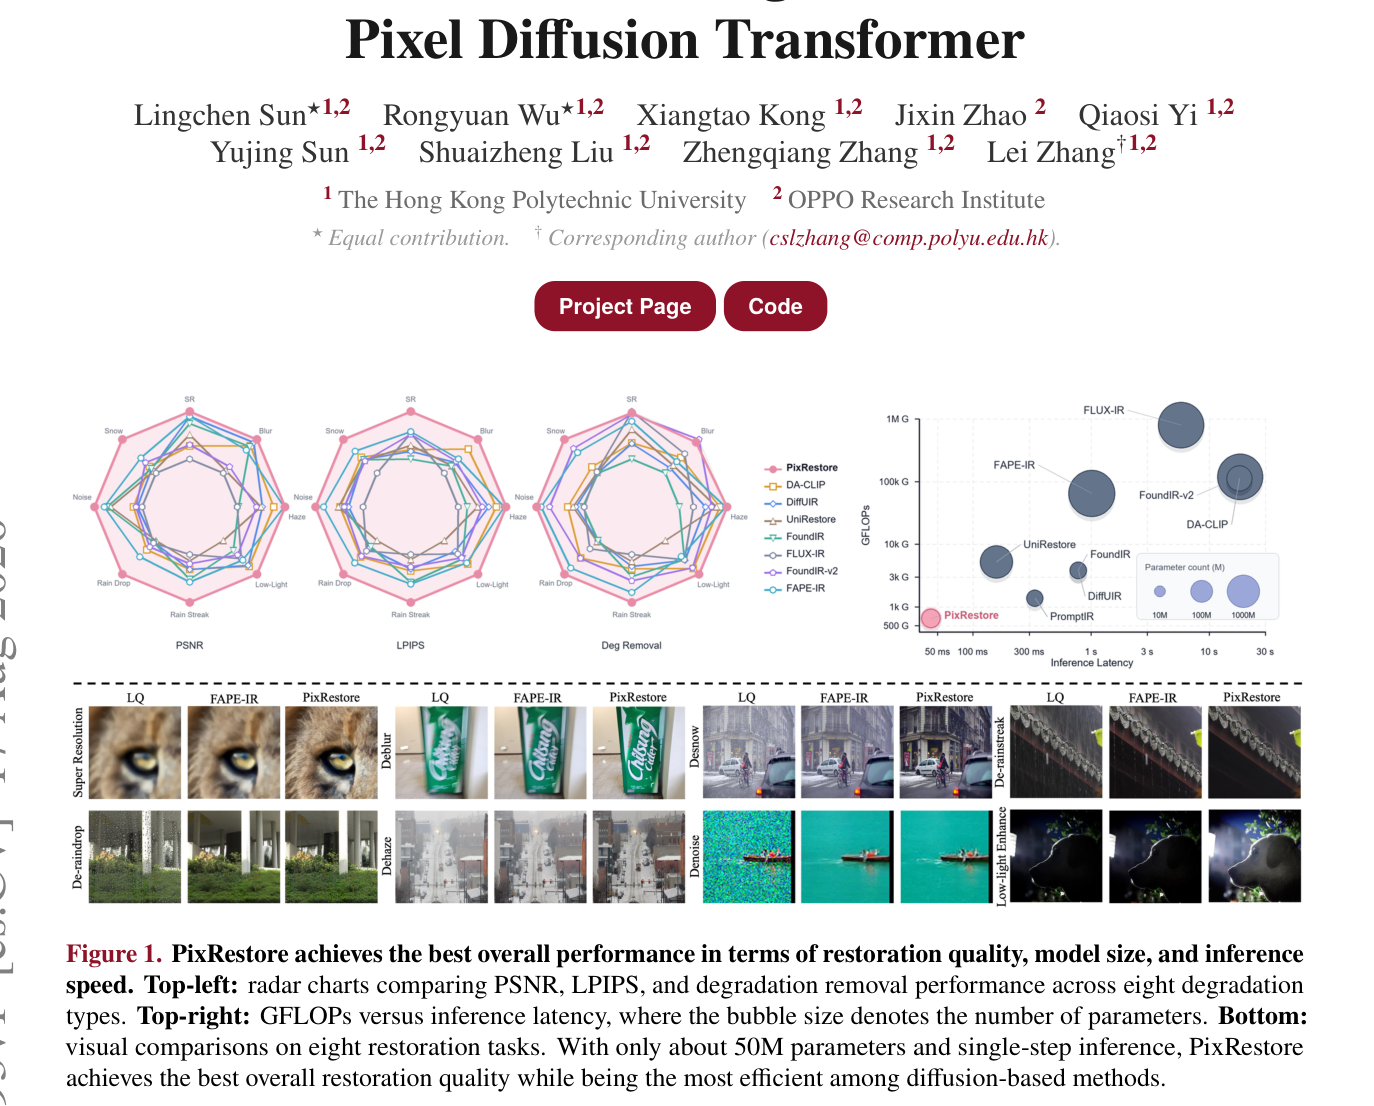
雷达图展示PixRestore在八类退化上的综合表现,气泡图展示GFLOPs、延迟和参数量的权衡。重点看PixRestore的气泡位置:参数最小、延迟最低,同时雷达图面积最大,说明效率与质量可以兼得。
实验如何设计?
- 训练数据约2.83M图像,覆盖八类退化:去模糊、去雾、去噪、去雨纹、去雨滴、去雪、低光增强、超分。
- 在15个公开基准上评估,对比PromptIR、DiffUIR、DA-CLIP、FoundIR、FoundIR-v2、UniRestore、Flux-IR、FAPE-IR等方法,包含官方版本和用相同数据重训的版本(标记∗)。
- 消融实验覆盖:单层/多层DINO条件、分层监督、自适应权重、NFE数量、单步微调、flow预训练vs回归训练。
- 可扩展性实验在不同骨干GFLOPs和patch size下测量LPIPS变化。
- 真实世界测试集包含六类退化、每类100张无GT图像,以DR-Score为主指标评估泛化能力。
关键结果与论文证据
- 像素空间vs潜空间(表1,第4页):相同DiT-S设置下,像素空间PSNR 26.62 dB,比三种潜空间方案高约4 dB;LPIPS 0.1593,比潜空间低约0.05以上。
- 消融A0→A10(表4,第10页):加入自适应分层引导后PSNR从26.62提升到28.49,LPIPS从0.1593降到0.1120,MUSIQ从54.32升到55.52。
- flow预训练+单步微调vs直接回归训练(表5,第10页):PSNR 28.49 vs 27.00,LPIPS 0.1120 vs 0.1494,MUSIQ 55.52 vs 52.00,证明扩散预训练对单步生成器至关重要。
- 复杂度(表3,第8页):PixRestore-S以53.7M参数、44ms延迟运行,比PromptIR、DiffUIR、FoundIR、FAPE-IR快约7到23倍,计算量约为FoundIR-v2的1/181、Flux-IR的1/1209。
- 真实世界测试集(表6,第11页):PixRestore-B平均DR-Score 67.88最高,FAPE-IR∗以67.55次之,但PixRestore参数和延迟远低于后者。
- 可扩展性(图6,第11页):LPIPS与GFLOPs相关系数-0.96,说明性能随计算量单调改善;patch size从16降到4时LPIPS从约0.129降到约0.101。
- DR-Score有效性(图4,第7页):在去雨纹案例中,MUSIQ和AFINE-NR偏好保留退化的输出,而DR-Score与人类感知判断一致,正确识别PixRestore去雨最彻底。
- 并非所有指标全第一(表2,第8页):如denoise任务上PixRestore的PSNR略低于FoundIR∗(36.16),说明忠实度与感知质量之间仍有取舍。
阅读时需要注意
- 固定tokenization设置下,单一分辨率训练的模型无法直接扩展到更高分辨率,需要重训或架构修改。
- 相比十亿级T2I模型,紧凑骨干在信息极度匮乏的退化下可能力不从心。
- DR-Score依赖专有VLM(Gemini-3.1 Pro),模型更新可能带来评分差异,且VLM输出有随机性,需多次采样取平均。
- MUSIQ和AFINE-NR等无参考指标不能可靠反映退化去除,可能偏好保留退化的输出,评估体系本身仍需完善。
关联工作
- PromptIR是回归式UIR的代表,基于提示的退化感知调制,训练稳定但输出易过度平滑。
- DiffUIR是复原原生扩散UIR方法,采用选择性沙漏映射,不依赖T2I先验,但仍是多步推理。
- DA-CLIP用CLIP退化感知条件引导扩散复原,体现了视觉基础模型特征作为条件的思路,但PixRestore用DINOv2的分层特征并加入自适应加权,条件更稠密、更任务自适应。
- FoundIR-v2基于SDXL的T2I潜扩散,用MoE路由和MLLM标注,体现了VAE细节损失和T2I目标冲突的问题。
- FLUX-IR和FAPE-IR基于FLUX的T2I潜扩散,需要复杂辅助设计且参数巨大,计算量是PixRestore的上千倍。
- LightningDiT是PixRestore采用的DiT骨干架构,DINOv2提供冻结的分层视觉特征。