快速导读:提出 Perception-as-Tool 范式,将检测与定位外置为取证感知工具,为冻结的通用 MLLM 提供结构化取证上下文以生成解释,无需任务特定微调。
PATE-Forensics 解决的核心问题是:可解释深度伪造取证是否必须依赖任务适配的多模态大模型?论文给出的答案是否定的。作者提出 Perception-as-Tool 范式,将检测与定位外置为一个取证感知工具,把该工具的结构化输出连同原始图像一起交给一个冻结的通用 MLLM,由后者在提示约束下生成解释。
这一设计的直接收益是架构解耦:检测和定位模块可以独立训练、独立升级,而解释生成端无需任何任务特定微调。论文在 DDL-X Track 3 官方评测中排名第一,并通过渐进式组件消融验证了多粒度检测证据与线索引导定位的各自贡献。
英文题目:PATE-Forensics: Perception-as-Tool for Explainable Deepfake Forensics with General-Purpose MLLMs
论文出处:arXiv 每日论文精选 · arXiv:2608.18573
原始论文:PDF / 论文页面
这篇论文解决什么问题?
深度伪造生成模型日益逼真,取证系统需要同时完成三件事:判断图像真伪、定位伪造区域、给出人类可读的解释。现有方法大多把这三件事塞进同一个任务适配的 MLLM 里。FakeShield 用 MLLM 输出引导专用定位模块,Omni-Fake-R1 则通过强化学习微调让 MLLM 直接联合输出检测、定位与解释。
这类方案的问题在于:每引入一个新的取证任务或新的数据分布,就需要重新适配 MLLM,微调成本高、可扩展性差。而且细粒度取证感知本质上依赖密集视觉线索,让一个通用 MLLM 直接承担密集预测任务,既低效也不符合其擅长高层语义推理的定位。
论文的切入点是重新审视 MLLM 在取证流程中的角色。与其让 MLLM 去做它不擅长的密集感知,不如让专门的感知模块完成检测与定位,MLLM 只负责它擅长的解释生成。这就是 Perception-as-Tool 的核心动机。
核心创新
- 提出 Perception-as-Tool 范式,架构上解耦检测/定位与解释生成,避免 MLLM 任务特定微调
- 设计耦合的取证感知工具,将多粒度检测(全局、patch、segment)与线索引导定位紧密耦合
- 将检测阶段的 patch 和 segment 可疑度分数空间化为粗取证线索,显式引导密集掩码预测
- 用冻结的通用 MLLM 结合结构化取证上下文和提示约束生成取证解释
方法概览
PATE-Forensics 采用 DINOv3 骨干(LoRA 适配)构建取证感知工具,包含多粒度检测模块(全局、patch、segment 分支)和线索引导定位模块(将 patch/segment 可疑度分数空间化为分数图,与多层 DINOv3 特征融合经 SegFormer 式解码器预测密集掩码)。原始图像与感知输出(概率、掩码、叠加图、裁剪区域)构成结构化取证上下文,输入冻结的通用 MLLM(Qwen3.5-Flash),在提示约束下生成解释。
- 取证感知工具采用 DINOv3 骨干,通过 LoRA 进行参数高效适配。检测模块包含三个分支:全局分支、patch 分支和 segment 分支,分别从不同粒度提供真伪判断证据。
- segment 分支通过 agglomerative clustering 在 DINOv3 特征上生成语义感知区域,使检测证据不局限于固定网格,而是对齐到语义上有意义的图像区域。
- 线索引导定位模块将 patch 和 segment 分支的可疑度分数空间化为 forgery score map,与多层 DINOv3 特征融合,经 SegFormer 式解码器预测密集伪造掩码。
- 这一设计与 TruFor 形成对比:TruFor 在检测阶段提取了噪声敏感指纹,但检测线索并未显式复用于掩码预测;PATE-Forensics 则让检测阶段的分数图直接成为定位模块的引导信号。
- 结构化取证上下文由原始图像与感知输出共同构成,包括检测概率、预测掩码、掩码叠加图和可疑区域裁剪图。这些信息以结构化形式输入冻结的 Qwen3.5-Flash。
- 解释生成阶段通过提示约束规范 MLLM 的输出格式与内容范围,使其基于给定的取证上下文进行推理,而非依赖模型内部可能不可靠的先验。
逐图理解论文
现有方法的困境
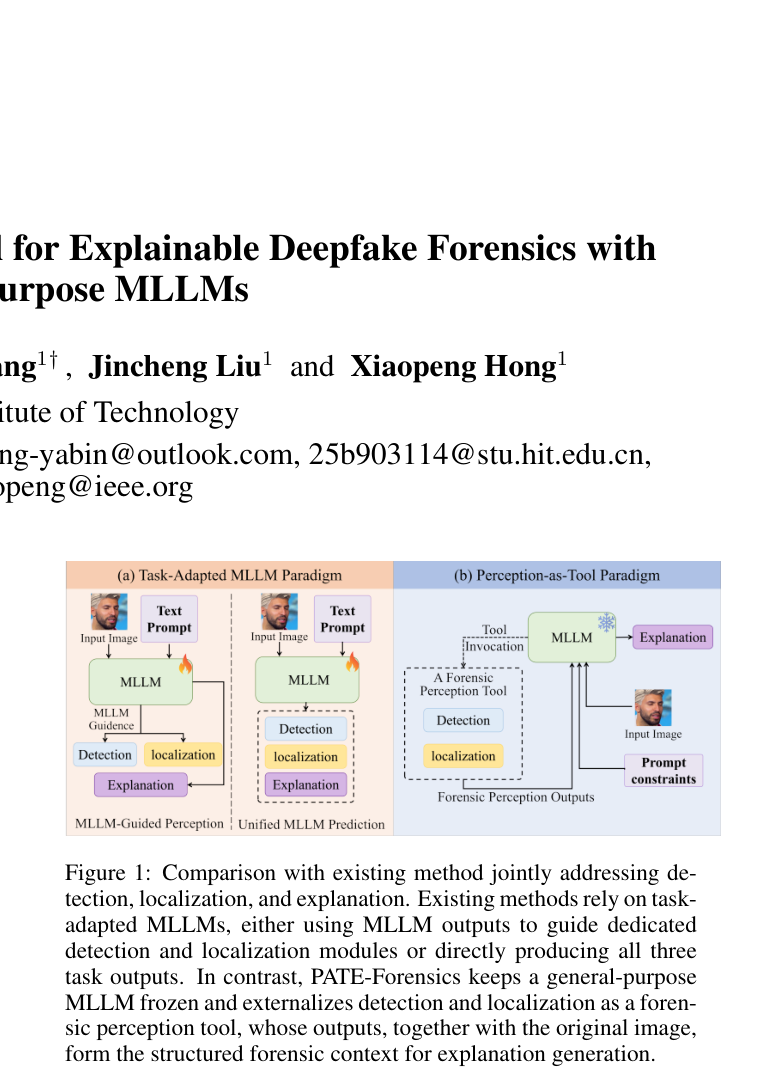
图 1 对比了现有方法与 PATE-Forensics 的架构差异。左侧显示现有方法依赖任务适配的 MLLM,右侧显示 PATE-Forensics 将 MLLM 冻结,检测与定位外置为取证感知工具。观察此图应关注数据流方向:感知输出如何作为上下文回传给 MLLM。
核心区分:感知与解释解耦
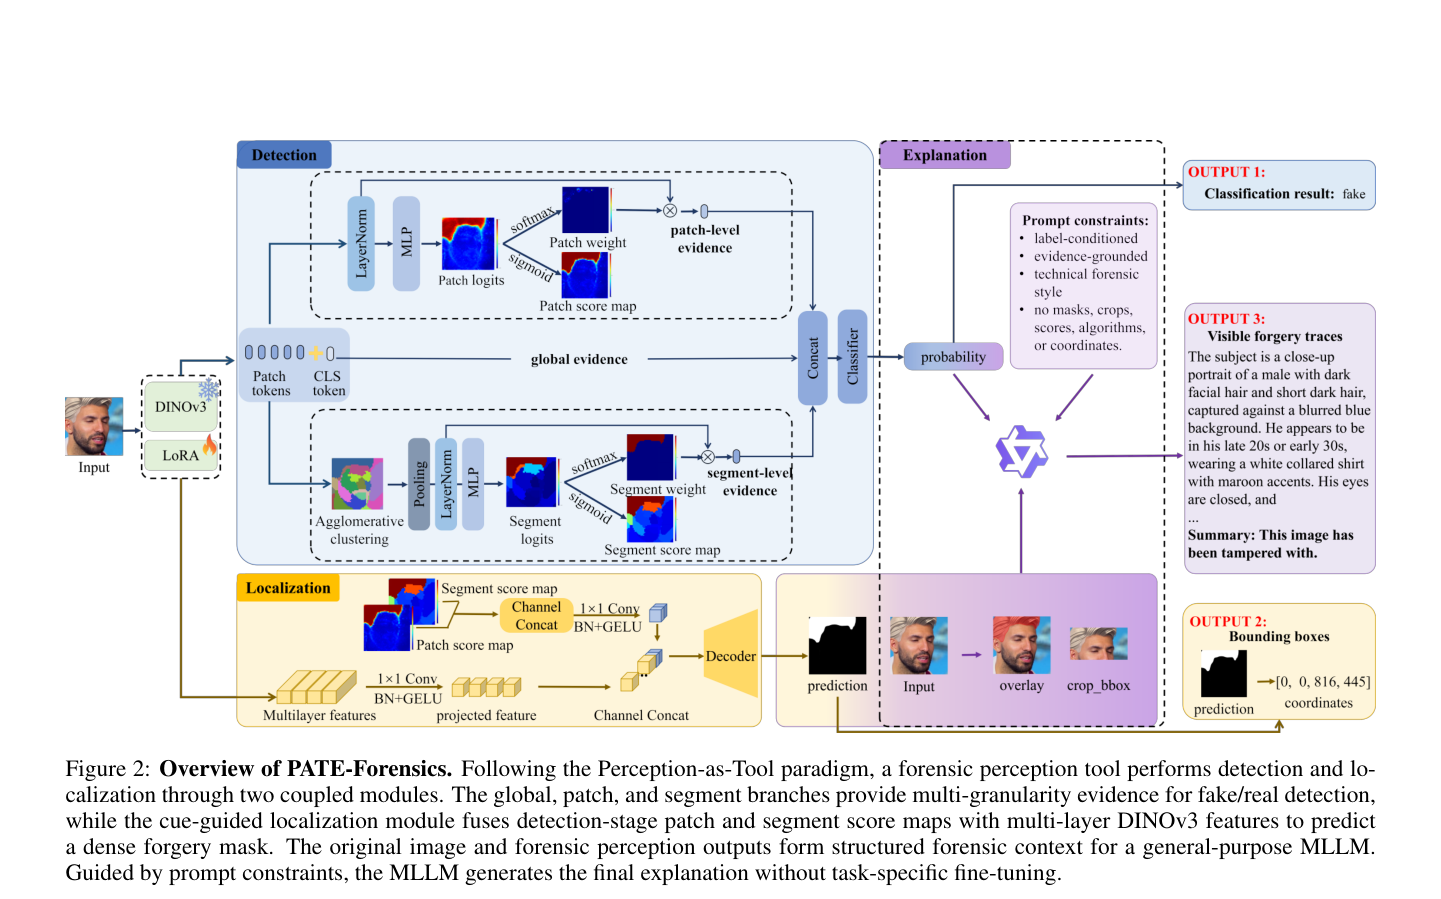
图 2 是方法总览,展示了取证感知工具的内部结构。重点观察检测模块的三个分支如何汇入线索引导定位模块,以及结构化取证上下文如何流向冻结的 MLLM。
证据:消融与官方评测
表 2 是渐进式组件消融。从基线到完整模型,每一行新增一个组件,应关注 patch 证据、segment 证据和粗取证线索各自带来的增量,以判断哪个组件贡献最大。
实验如何设计?
- 模型在 DDL-I 数据集上训练,论文对训练/验证集进行了重新划分,并采用几何增强和画布级布局增强来提升鲁棒性。
- 组件消融采用渐进式设计:从基线开始,依次加入 patch 证据、segment 证据和粗取证线索,观察每一步的性能变化。
- 官方评测在 DDL-X Track 3 上进行,该赛道属于 IJCAI 2026 AI Safety Workshop,要求同时完成检测、定位与可解释性任务。
- 定性分析展示了真实与伪造图像的 MLLM 解释生成效果,包括伪造区域的边界框坐标输出。
关键结果与论文证据
- 在 DDL-X Track 3 官方评测中,PATE-Forensics 以 0.8940 的最终得分排名第一(第 6 页)。
- 渐进式消融显示,加入 patch 证据后性能提升 0.1995,加入 segment 证据再提升 0.3079,加入粗取证线索进一步带来 0.0943 的增益(第 6 页)。
- 基线模型的得分为 0.2923,完整模型达到 0.7025,说明多粒度检测证据与线索引导定位的贡献是实质性的(第 6 页)。
- 在定位相关的消融指标上,完整模型达到 0.9914 和 0.9961,显著高于基线的 0.7283 和 0.7910(第 7 页)。
- 定性结果(第 7 页)显示,对于真实图像,系统正确报告未检测到伪造区域;对于伪造图像,MLLM 能输出与伪造区域对应的边界框坐标并生成解释。
阅读时需要注意
- 仅在 DDL-I 单一数据集上验证,跨数据集泛化性未评估,无法判断模型在分布外数据上的表现。
- 解释生成依赖单一 MLLM(Qwen3.5-Flash),未系统比较不同 MLLM 对解释质量的影响。
- 未报告推理速度或计算开销,实际部署的可行性缺乏数据支撑。
- 论文将原始测试集 90% 并入训练集,仅留 10% 作验证,可能高估泛化性能;官方排行榜分数与内部消融实验的数据划分协议不同,数值不可直接比较。
- MLLM 生成解释的温度和 top-p 未显式指定,依赖服务商默认值,可能影响可复现性。
关联工作
- FakeShield 是 MLLM 引导感知的代表方法,由 MLLM 生成篡改描述并引导定位模块,但 MLLM 仍需任务适配。
- SIDA 从大视觉语言模型提取检测与分割 token 表示,输入专用头进行预测,属于感知端利用 MLLM 特征的路线。
- Omni-Fake-R1 通过强化学习微调让 MLLM 联合输出检测、定位与解释,是统一 MLLM 预测路线的代表。
- TruFor 结合 RGB 内容与噪声敏感指纹进行定位,但检测阶段线索未显式复用引导掩码预测,PATE-Forensics 的线索引导定位正是对这一缺口的回应。
- NFA-ViT 使用噪声引导注意力放大细微伪造线索,Face X-Ray 通过揭示混合边界检测人脸伪造,Lips Don't Lie 关注嘴部动态,这些工作共同构成了深度伪造取证的技术背景。