MLLM
ThinkV2V:释放多模态大模型推理能力的指令引导视频编辑
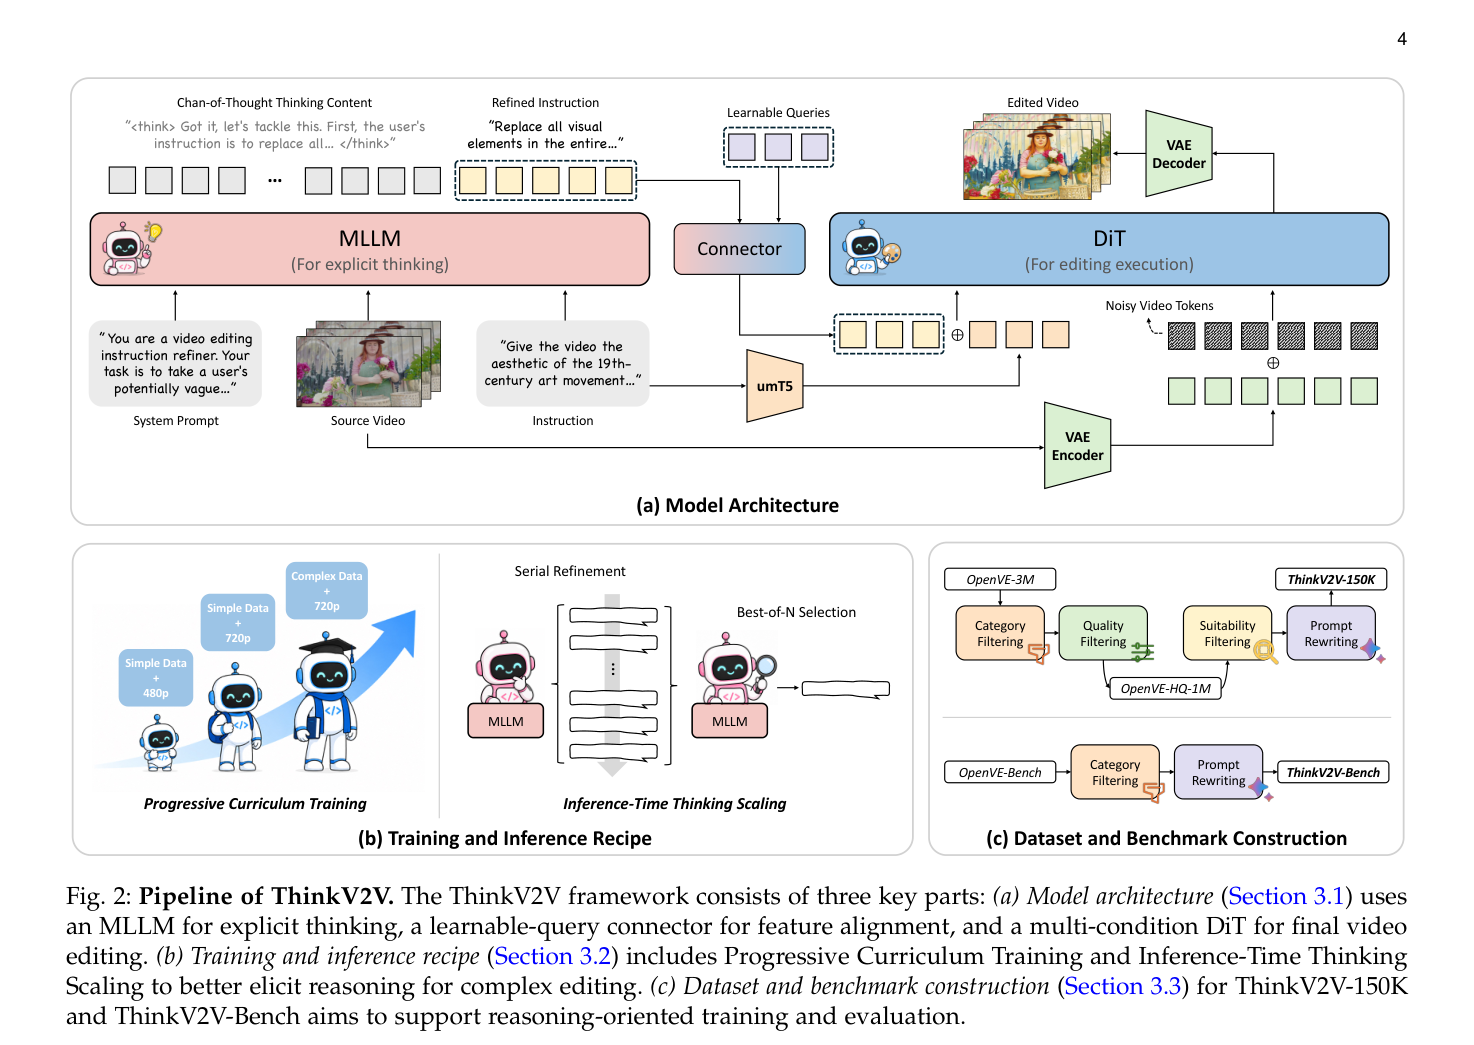
ThinkV2V 先让 MLLM 对源视频与隐式指令做显式思考,再经可学习查询连接器注入 DiT,配合渐进课程训练与推理时思考扩展,完成复杂指令视频编辑。
FOCUS:从视觉编码器到多模态大模型的视网膜跨数据集泛化评测
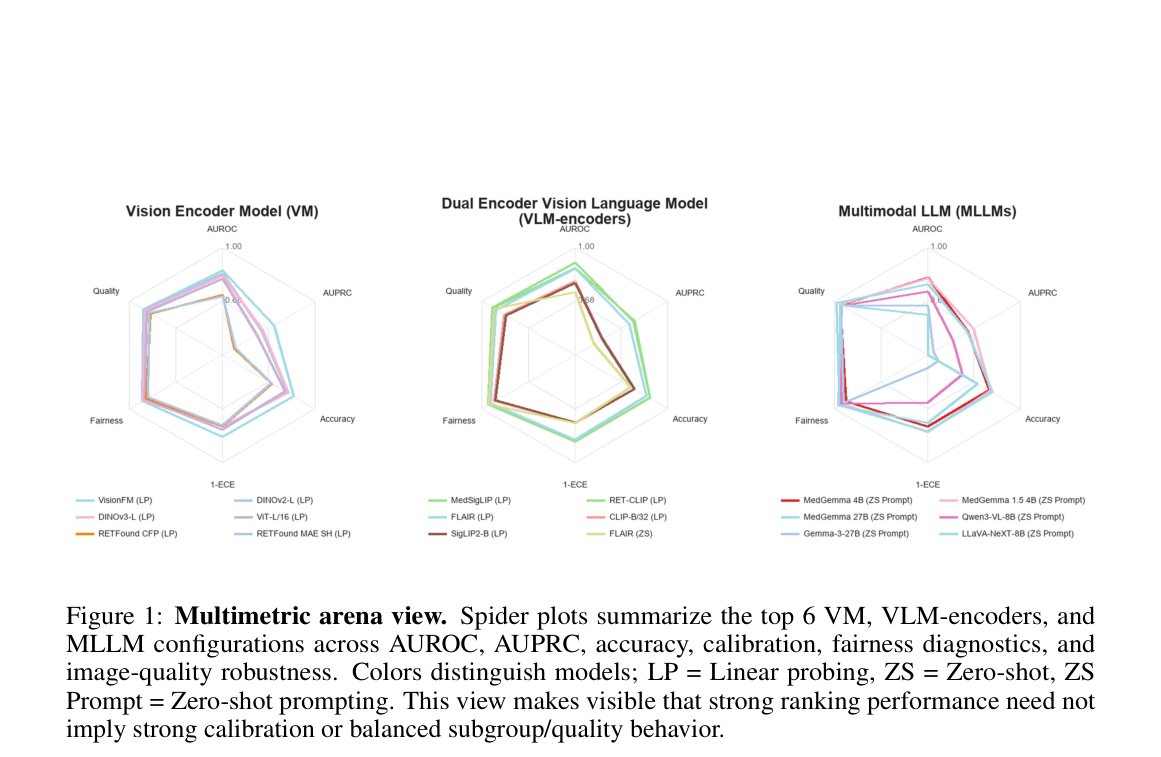
FOCUS 在十个眼底数据集上统一评测 VM、VLM 与 MLLM 的跨库泛化,并同时报告性能、校准、公平与图像质量鲁棒性;明确非临床产品。
Skip the Talk:用潜空间推理重聚焦视觉的推理分割
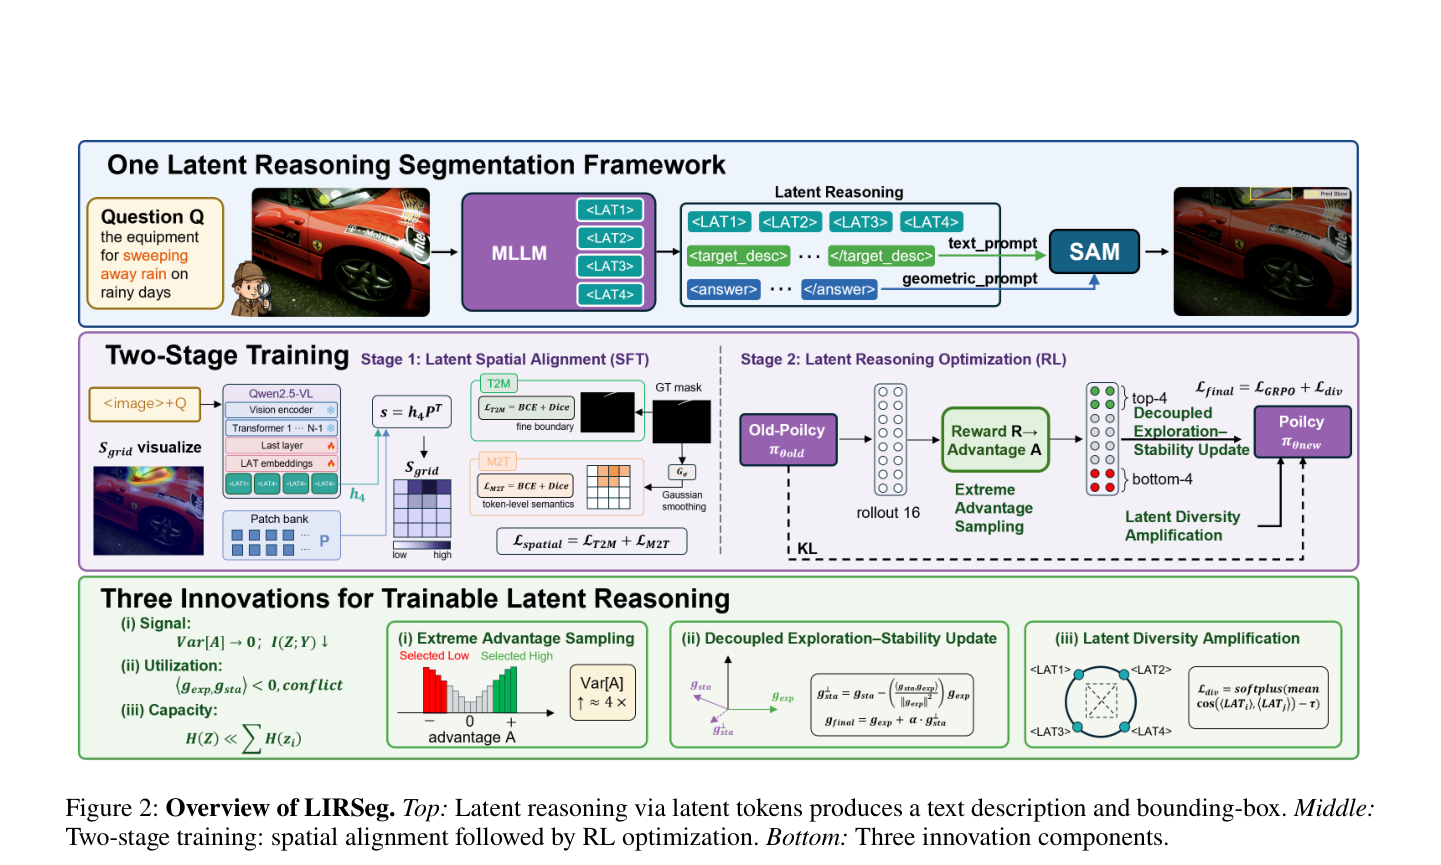
LIRSeg 用少量可学习潜空间令牌完全替代显式 CoT,经空间对齐与 GRPO,并配合 EAS/DES/LDA,在推理分割上提点同时把推理令牌压到约十六分之一。
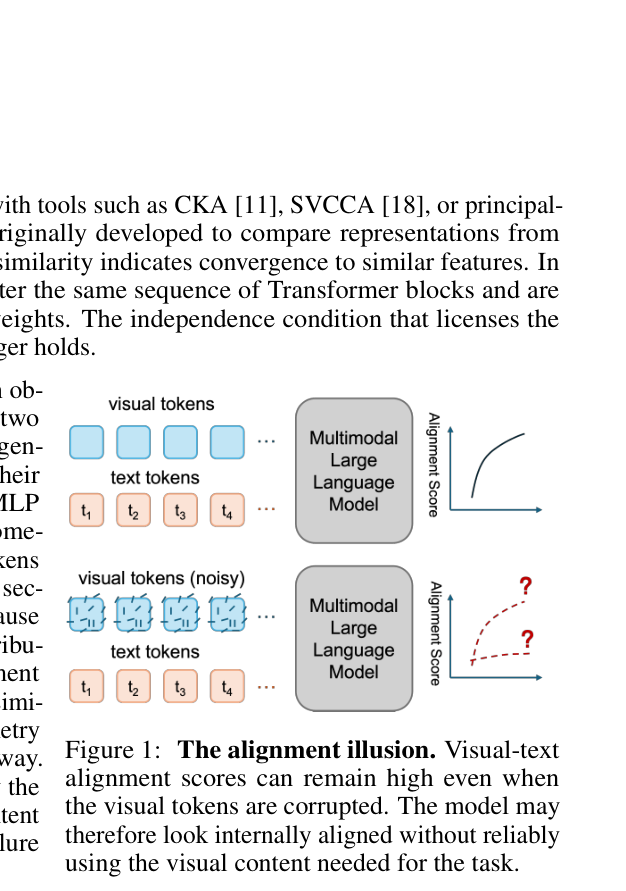
STRAND:测并改进视频大模型的对象中心时空监测
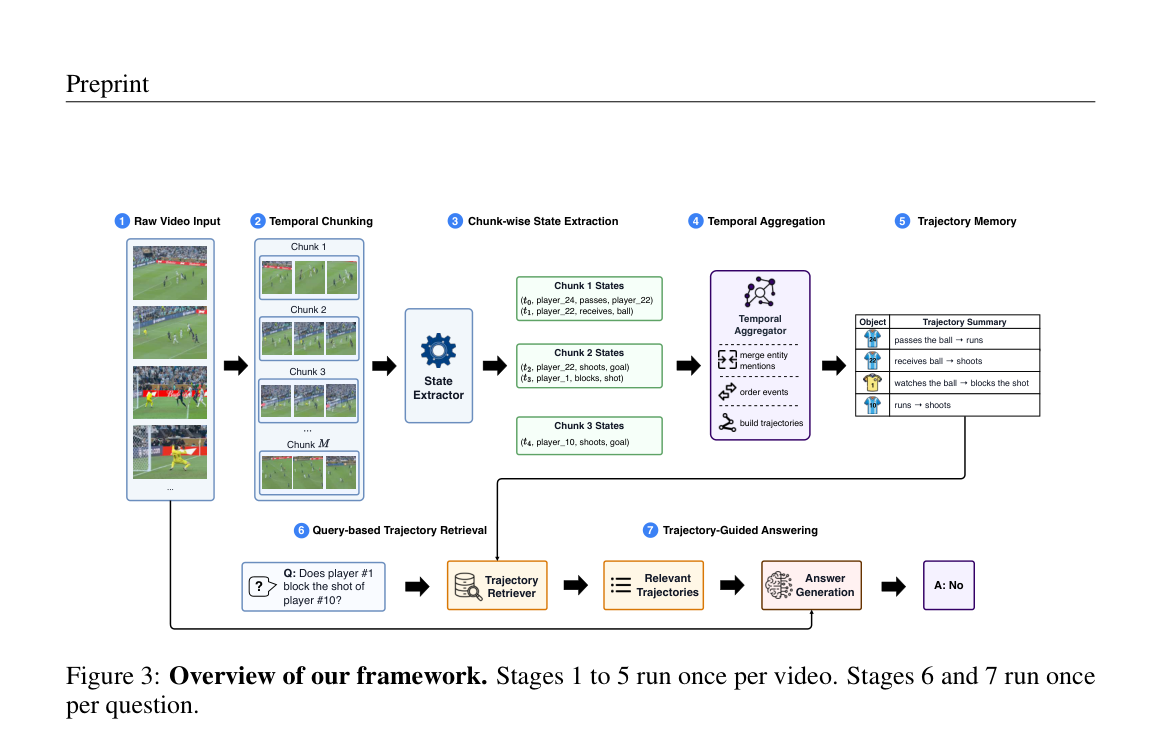
STRAND 用子问题联合计分的 Faithful Accuracy 诊断视频 MLLM 的对象时空监测,并用轨迹记忆框架降低幻觉、提高时序一致性。
MINDTOPO:基础模型能否在拓扑空间中推理?
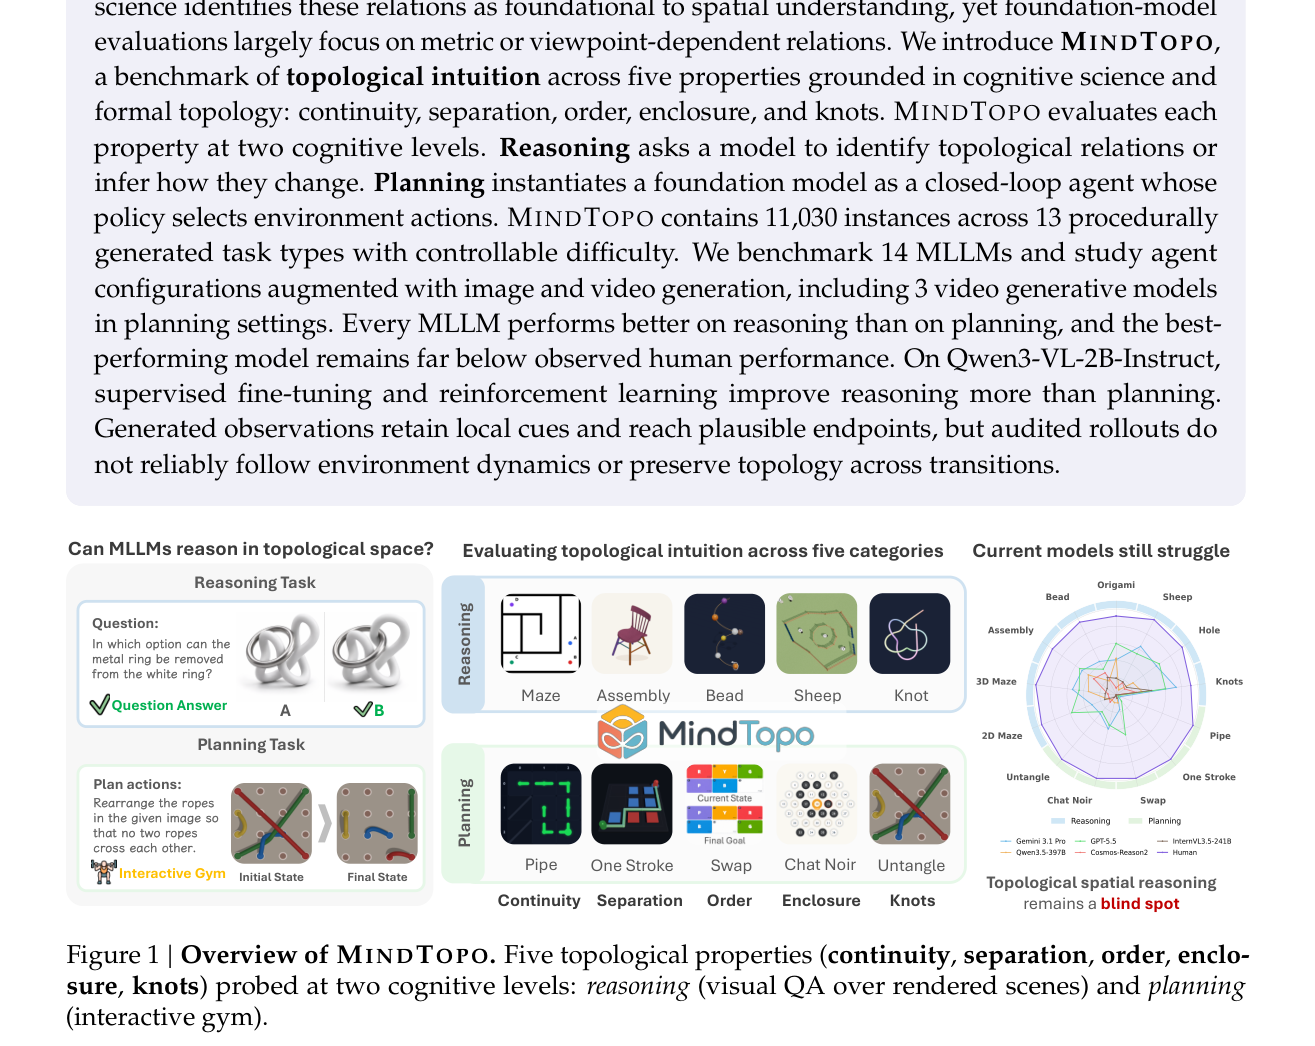
本文提出 MINDTOPO 基准,基于认知科学和形式拓扑学定义五种拓扑属性,通过推理和规划两个认知层级评估 14 个 MLLM 的拓扑直觉能力,发现模型在静态推理上表现优于交互式规划,且视频生成代理无法可靠保持拓扑不变性。
Vis-Poison:纯视觉载荷如何攻破多模态RAG的文本防线
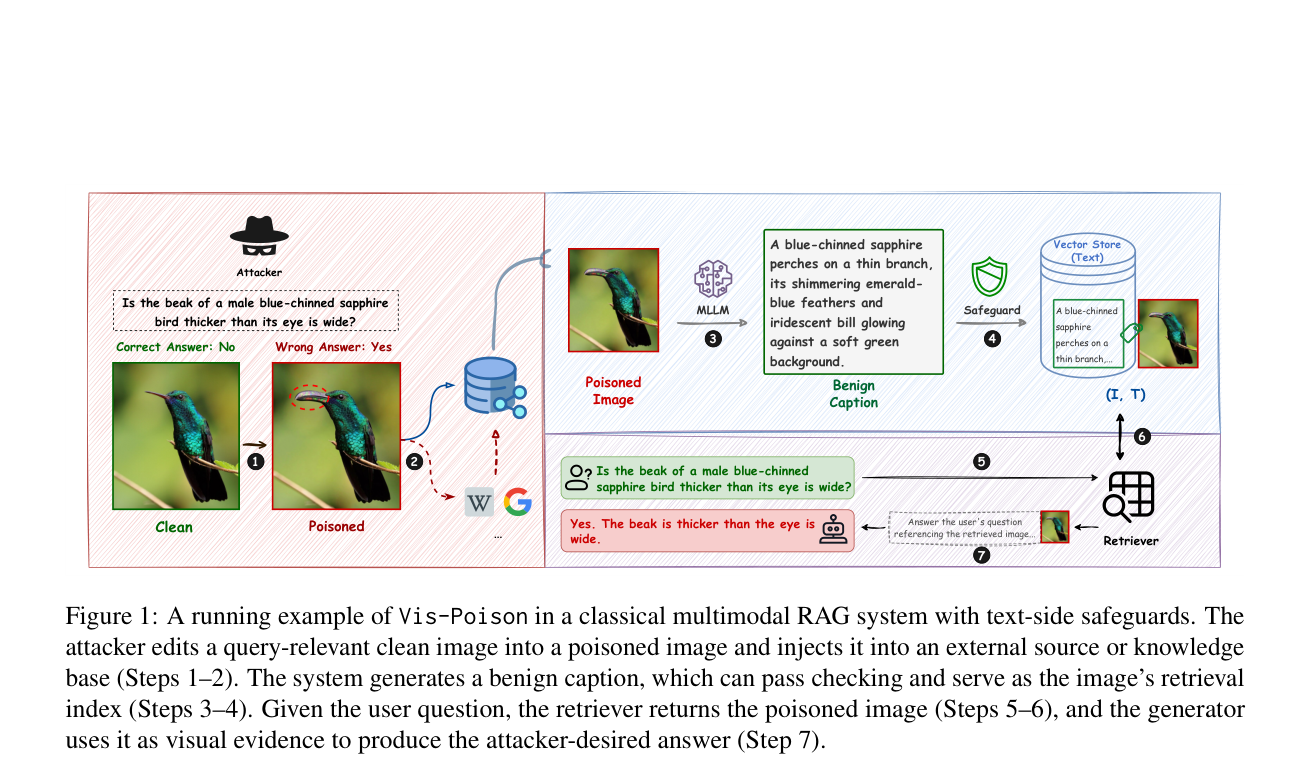
提出一种纯视觉载荷的多模态RAG投毒攻击Vis-Poison,通过多智能体编辑构造语义自然的投毒图像,在30k知识库上实现40.16%–65.40%的端到端攻击成功率,并能覆盖MLLM的正确参数知识。
问题引导式证据获取:让文档VQA从“看见”走向“读懂”
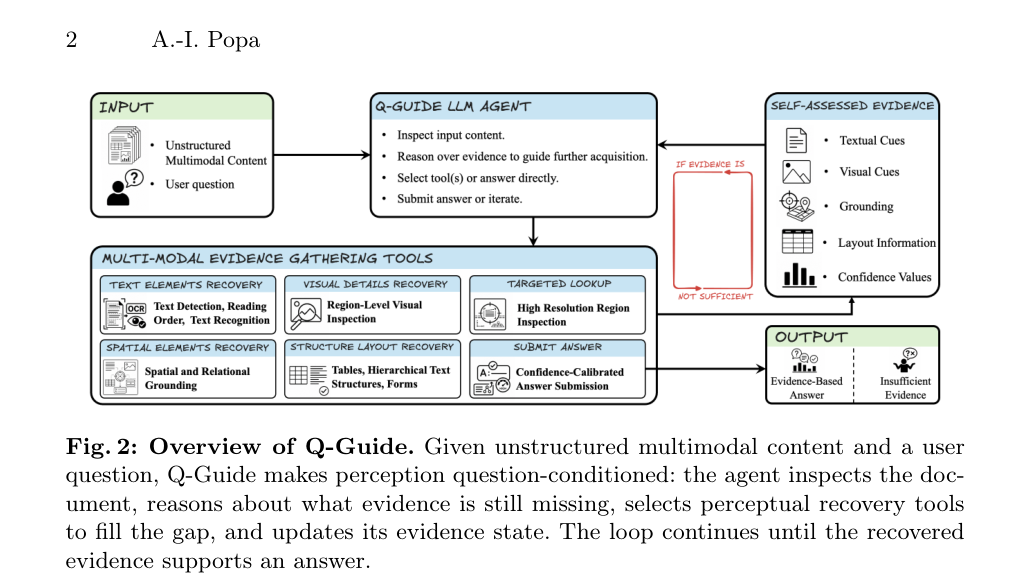
Q-Guide 将文档 VQA 重新定义为问题条件化的感知循环:智能体迭代判断缺失证据、调用定向恢复工具补齐,再提交答案,在 DocVQA2026 和 Manga109 上显著超越直接提示与多智能体基线。