快速导读:StateTrace 提出对象中心的时空状态记忆框架,使 VideoLLM 能够在目标物体长时间不可见时显式推理其隐藏状态,并在新基准 HSR-Bench 上取得 15–28 点的显著提升。
长视频问答中有一个被长期忽视的盲区:当目标物体被遮挡、装进容器或盖住时,现有 VideoLLM 往往把“看不见”直接当成“不知道”。StateTrace 针对这一问题提出对象中心的时空状态记忆框架,显式记录每个对象何时出现、何时消失、消失原因是什么,并在查询时把这些状态线索压缩成摘要,与视觉证据一起交给模型回答。
论文的核心论点是:隐藏状态推理的瓶颈不在视觉编码,而在状态持续性的建模。StateTrace 通过离线构建对象轨迹与消失原因,把“不可见”从信息缺失转化为可查询的状态记录,从而在 HSR-Bench 上取得显著提升。
英文题目:StateTrace: An Object-Centric Framework for Hidden-State Spatiotemporal Reasoning in Long Videos
论文出处:arXiv 每日论文精选 · arXiv:2608.18532
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有长视频增强方法大多走证据驱动路线:Video-RAG 检索相关片段,FlexSelect 压缩上下文,还有一些方法聚合可见观测。这些方法的共同假设是答案所需的证据一定在可见帧里。但现实场景中,物体可能被遮挡几十秒甚至几分钟,查询时刻远晚于最后可见时刻,证据驱动方法只能返回“无法确定”。
论文将这一问题形式化为隐藏状态时空推理:给定长视频和一个关于目标物体的查询,模型需要推断目标在不可见期间的潜在状态。关键难点在于,不可见不等于状态消失——物体被装进杯子后,它的位置随杯子移动;被车挡住后,它的颜色没有改变。
作者识别出两个核心缺失能力:一是消失原因推理,即区分物体是走出画面还是被遮挡、被容纳;二是状态持续性建模,即在长时间不可见后仍能保持对象身份与空间关系的连续性。这两点构成了 StateTrace 的设计动机。
核心创新
- 系统定义并形式化长视频问答中的隐藏状态时空推理问题,识别状态持续性建模为核心缺失能力
- 提出 StateTrace 对象中心框架,将长视频推理从纯视觉证据驱动转变为结构化状态中心推理
- 构建 HSR-Bench 诊断基准,含 1,427 个视频问答样本、1,384 个独特视频,覆盖遮挡、容纳、覆盖和长延迟查询场景
- 设计消失原因推理模块,区分边界退出与帧内消失,并用 VLM 推断 inside/occluded/other/unknown 四类原因
- 基于 SAM2 掩码传播构建跨块连续的对象轨迹,结合 IoU 关联维持对象身份
方法概览
StateTrace 分三阶段:离线构建对象中心时空状态记忆(语义记忆 Msem、空间位置记忆 Mloc、空间事件记忆 Mevt,组织为块级有向图 GV 和实体索引图 GE);查询时通过两阶段检索提取相关子记忆,生成语义聚合摘要与空间摘要;最后将摘要与检索到的视觉证据结合输入 VideoLLM 生成答案。
- 离线构建对象中心时空状态记忆:StateTrace 用 SAM2 掩码传播构建跨块连续的对象轨迹,通过 IoU 关联维持对象身份,避免同一物体在不同片段中被当成不同实体。
- 三类记忆结构:语义记忆 Msem 记录对象属性,空间位置记忆 Mloc 记录对象在每帧的位置,空间事件记忆 Mevt 记录状态转换事件。三类记忆组织为块级有向图 GV 和实体索引图 GE。
- 消失原因推理模块:通过边界接触比区分边界退出与帧内消失,再用 VLM 将帧内消失细分为 inside、occluded、other、unknown 四类。这一步把“看不见”变成了有语义标签的状态记录。
- 查询时两阶段检索:先从实体索引图定位目标对象,再从块级有向图提取相关子记忆,生成语义聚合摘要与空间摘要。空间摘要把低层空间事件记录转化为对象状态演化的显式描述。
- 最终答案生成:将语义摘要、空间摘要与检索到的视觉证据拼接输入 VideoLLM,让模型在结构化状态线索的辅助下作答,而不是只依赖原始视频帧。
逐图理解论文
失败案例
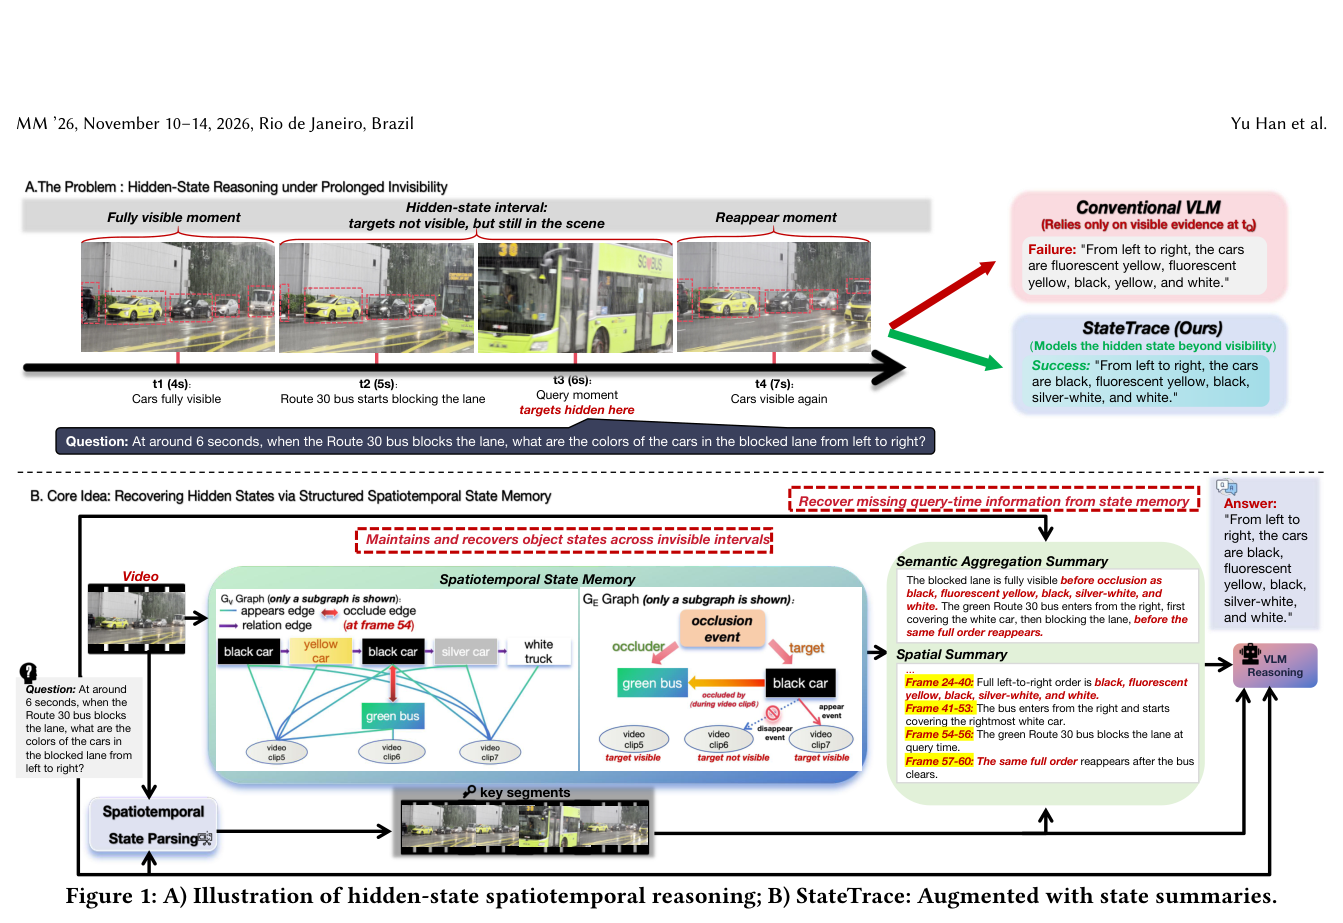
图 1 左侧展示了隐藏状态时空推理的典型场景:目标物体被遮挡后,模型需要推断其不可见期间的状态。右侧对比了 StateTrace 与普通 VideoLLM 的差异,StateTrace 通过状态摘要补充了不可见期间的信息。
研究缺口
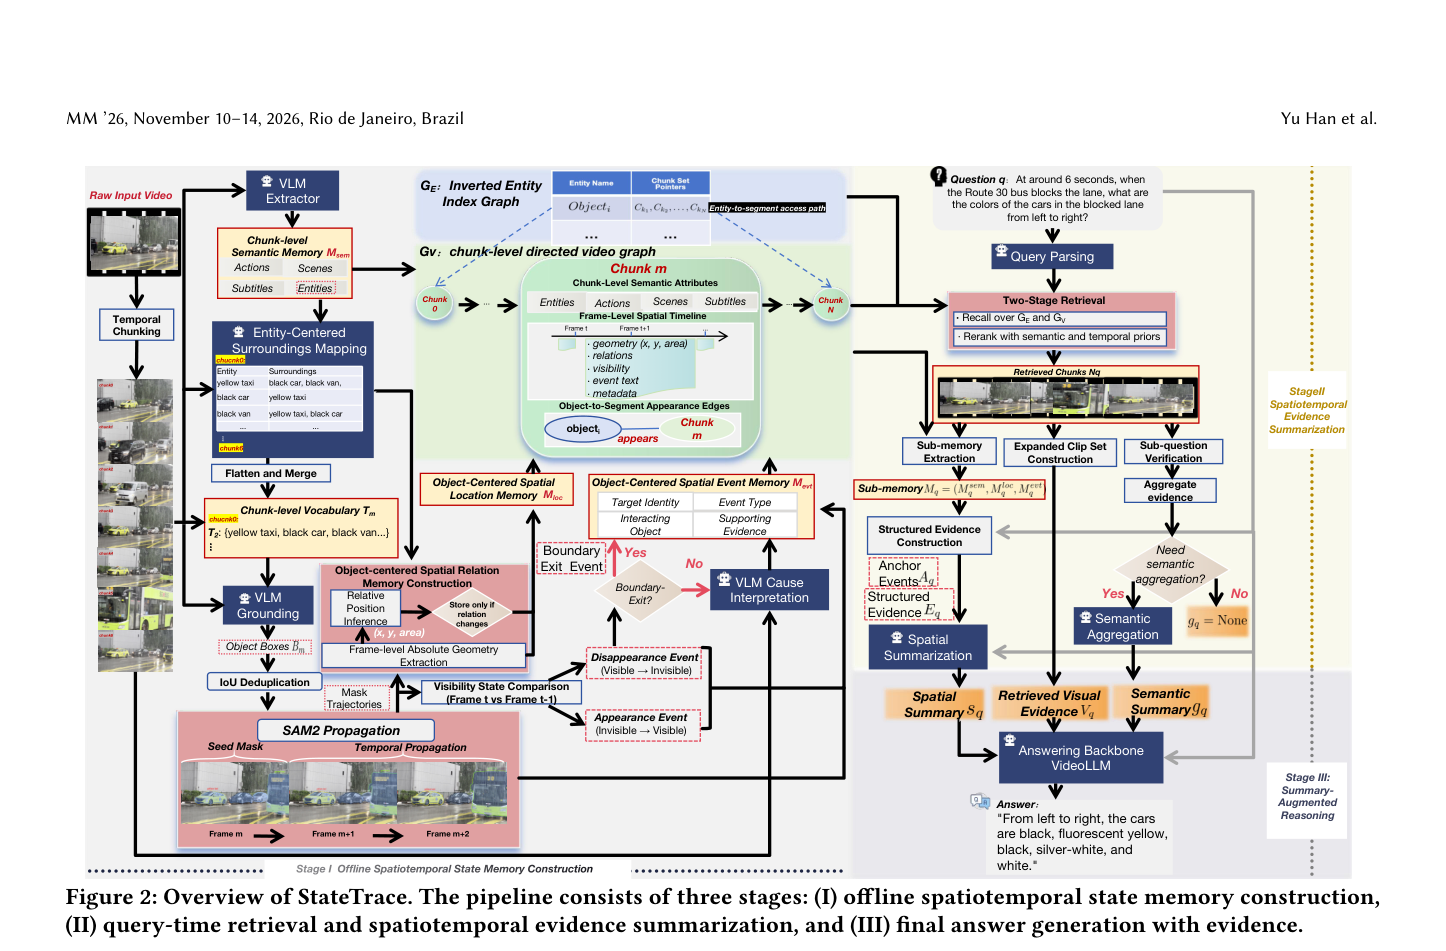
图 2 是 StateTrace 的整体流程,分三阶段:离线时空状态记忆构建、查询时检索与摘要生成、最终答案生成。重点观察对象轨迹如何从掩码传播中构建,以及消失原因如何被记录为图结构中的边。
验证与证据
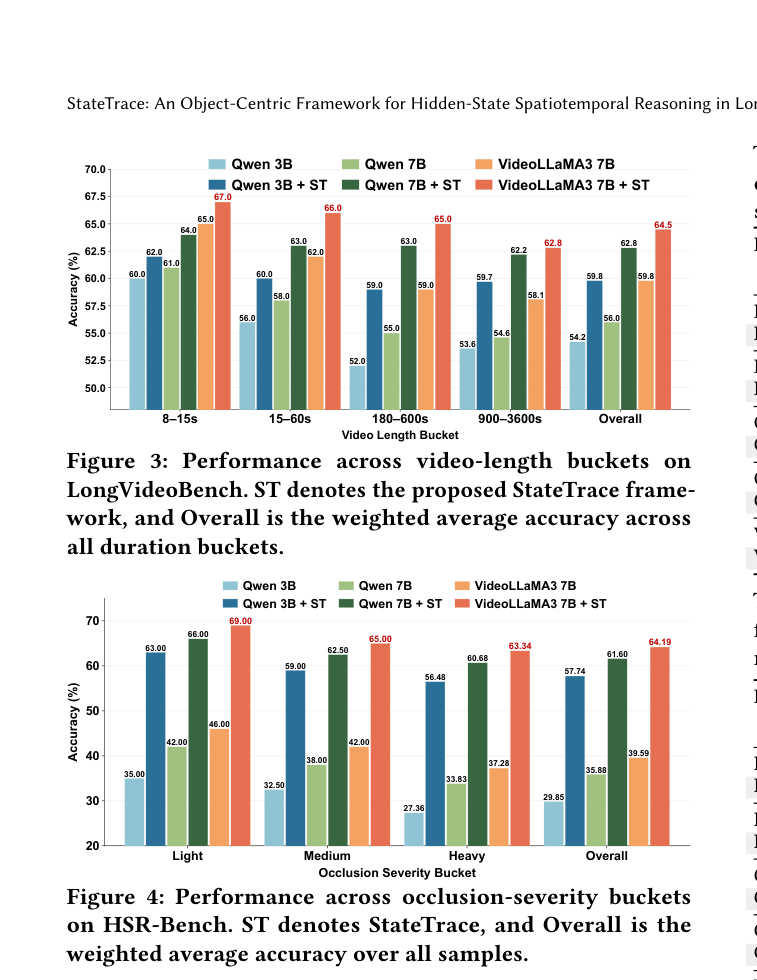
图 4 展示 HSR-Bench 上不同遮挡严重程度的表现。重度遮挡分桶的提升最大,直接支持论文的核心论点:隐藏状态推理是主要瓶颈。
结论与局限
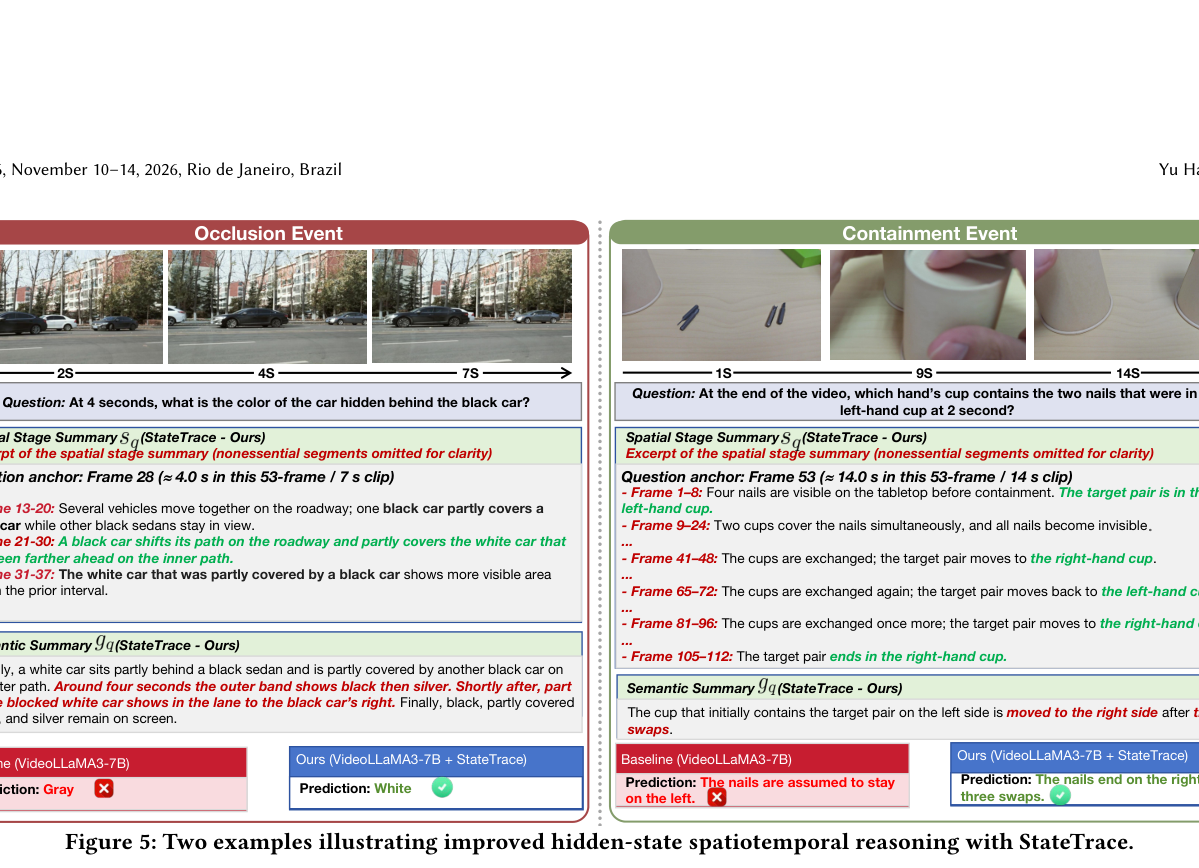
图 5 给出两个定性例子:一个是被黑车遮挡的汽车颜色推理,另一个是多次交换后判断哪个杯子装钉子。观察 StateTrace 如何在目标长时间不可见后仍给出正确答案。
实验如何设计?
- 公开基准评估:在 MLVU、VideoMME(含/不含字幕)、LongVideoBench 三个基准上测试,覆盖 InternVL2.5、VideoLLaMA3、Qwen2.5-VL、LLaVA-Video 四种 backbone。
- HSR-Bench 诊断评估:新基准含 1,427 个视频问答样本、1,384 个独特视频,覆盖遮挡、容纳、覆盖和长延迟查询场景,与 Video-RAG、FlexSelect 等增强方法对比。
- 消融实验:分别移除消失原因推理(DispC)、空间摘要生成(SpS)、关键片段检索(KCR)三个组件,观察各组件对性能的独立贡献。
- 分桶分析:LongVideoBench 按视频时长分桶(8–15s、15–60s、180–600s、900–3600s),HSR-Bench 按遮挡严重程度分桶(heavy、medium),检验方法在不同难度下的表现。
关键结果与论文证据
- StateTrace 在 HSR-Bench 上相对 base model 提升 15.14–28.31 点,其中 Qwen2.5-VL-3B 从 29.85 提升至 57.74,增益最大(第 6 页)。
- VideoLLaMA3-7B + StateTrace 在 HSR-Bench 上达到 64.19,为最佳结果(第 6 页)。
- 在 LongVideoBench 上,VideoLLaMA3-7B 从 59.8 提升至 64.5,说明方法在长视频状态连续性任务上尤其有效(第 6 页)。
- 消融显示空间摘要生成(SpS)贡献最大:移除后 VideoLLaMA3-7B 在 LongVideoBench 从 64.5 降至 60.5(第 8 页)。
- 消失原因推理(DispC)同样关键:移除后 VideoLLaMA3-7B 从 64.5 降至 61.2(第 7 页)。
- 关键片段检索(KCR)贡献相对较小但一致:移除后 VideoLLaMA3-7B 从 64.5 降至 62.7(第 8 页)。
- 重度遮挡分桶中 VideoLLaMA3-7B 准确率从 37.28 提升至 63.34,说明方法在隐藏状态最关键的场景下优势最大(第 7 页)。
阅读时需要注意
- 离线解析阶段依赖 VLM 提取器和 SAM2 掩码传播,计算开销较大,限制了实时应用场景。
- 消失原因推理仅覆盖 inside、occluded、other、unknown 四类,复杂交互场景(如多物体同时遮挡)覆盖有限。
- HSR-Bench 从 OVIS 和 MOSEv2 构建,场景多样性受源数据集限制,可能无法覆盖所有真实世界的隐藏状态模式。
- 论文为 MM '26 预印本,结果未经同行评议,部分表格数据在论文中截断,完整数据需查阅原文。
关联工作
- Video-RAG 和 FlexSelect 是长视频增强的代表方法,前者基于检索增强,后者基于上下文选择与压缩。它们与 StateTrace 的关键区别在于:前者仍然假设证据在可见帧里,后者显式建模不可见期间的状态。
- SAM2 在 StateTrace 中承担掩码传播任务,是构建对象轨迹的基础组件。OVIS 和 MOSEv2 作为 HSR-Bench 的源数据集,提供了大量遮挡与容纳场景。
- Qwen3-VL 用于 HSR-Bench 的问题草拟,说明基准构建本身也依赖强 VLM 的能力。