快速导读:提出Co-3DGT框架,通过协同蒸馏发现可靠新类物体,并以场景感知不确定性正则化和LLM引导的层次对齐实现鲁棒训练,显著提升开放词汇3D目标检测性能。
开放词汇3D目标检测(3D-OVD)的目标是让检测器识别训练时从未见过的物体类别。由于无法获得新类的3D标注,主流做法是先用2D基础模型或类无关3D检测器发现新物体,再以伪标签形式训练3D检测器。然而,这一发现过程天然携带两类噪声:2D反投影导致的定位不精确,以及3D提案导致的语义误分类。
Co-3DGT针对这两类噪声提出了统一的解决框架。在发现阶段,它通过协同蒸馏将2D语义信息与3D几何信息进行匈牙利匹配,蒸馏出可靠的新物体伪标签;在训练阶段,它引入双重引导——场景感知不确定性正则化与LLM引导的层次对齐——来抑制噪声对模型的影响。
英文题目:Open-Vocabulary 3D Object Detection with Co-Distillation Discovery and Dual Guidance Robust Training
论文出处:arXiv 每日论文精选 · arXiv:2608.19973
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有两阶段3D-OVD流程中,新物体发现是第一步,也是噪声的主要来源。基于2D检测反投影的方法依赖深度估计和相机参数,将2D边界框映射到3D空间,但深度误差会直接导致3D框定位偏移。基于3D提案的方法虽然几何定位更准确,但类无关检测器无法提供语义标签,需要借助2D模型赋予类别,这一过程容易产生语义误分类。
更关键的问题在于训练阶段。现有方法将基础类真值和新类伪标签同等对待,使用相同的监督损失。这意味着发现阶段的定位误差和语义错误会无差别地传播到3D检测器的训练中,导致模型在新类上的性能受限。
论文指出,这一问题的本质是缺乏对伪标签质量的显式建模,以及缺乏针对噪声的鲁棒训练机制。因此,需要同时从发现和训练两个环节入手,才能从根本上提升3D-OVD的性能。
核心创新
- 提出Co-Distillation Discovery,通过匈牙利匹配联合2D语义与3D几何信息蒸馏高质量新物体伪标签
- 提出Scene-Awareness-Guided Uncertainty Regularization (SGUR),以基础类不确定性期望正则化新类回归损失
- 提出LLM-Guided Hierarchical Alignment (LGHA),利用LLM生成三层超类别标签增强分类鲁棒性
- 统一框架同时提升发现可靠性与训练鲁棒性,在SUN RGB-D和ScanNetV2上取得SOTA
方法概览
Co-3DGT包含两个阶段:(1) Co-Distillation Discovery:将2D开放词汇检测器的语义框与类无关3D检测器的提案框构建二分匹配问题,以IoU、3D前景概率和2D置信度组成代价矩阵,用匈牙利算法求解,蒸馏出几何一致且语义可靠的新物体伪标签;(2) Dual Guidance Robust Training:SGUR以基础类场景感知不确定性为锚点正则化新类不确定性,动态加权3D框回归损失;LGHA利用LLM生成top/mid/bottom三层类别标签,与CLIP文本嵌入进行层次语义对齐。
- Co-Distillation Discovery将2D开放词汇检测器(如Detic)的语义框与类无关3D检测器(如CuTR)的提案框构建为二分匹配问题。代价矩阵由三项组成:IoU衡量几何一致性,3D前景概率衡量提案的置信度,2D置信度衡量语义可靠性。通过匈牙利匹配求解最优对应关系,蒸馏出同时满足几何一致和语义可靠的新物体伪标签。
- 与纯2D反投影相比,协同蒸馏避免了深度误差导致的定位偏移;与纯3D提案相比,它通过2D语义信息为提案赋予了可靠的类别标签。
- SGUR(Scene-Awareness-Guided Uncertainty Regularization)的核心思想是:基础类真值标注提供了场景感知的不确定性参考。对于新类伪标签,其回归损失根据与基础类不确定性的偏离程度进行动态加权,偏离越大,权重越低,从而抑制不可靠伪标签对回归的负面影响。
- LGHA(LLM-Guided Hierarchical Alignment)利用LLM为每个类别生成top、mid、bottom三层超类别标签。例如,椅子可能被归入家具(top)、坐具(mid)、带靠背坐具(bottom)等层次。这些超类别标签与CLIP文本嵌入进行层次对齐,为分类提供超越原始类别的结构化语义监督,增强模型对语义噪声的鲁棒性。
- 整个框架在发现阶段和训练阶段形成闭环:更可靠的伪标签降低了训练阶段的噪声输入,而鲁棒训练机制进一步抑制了残余噪声的影响。
逐图理解论文
失败案例与直觉
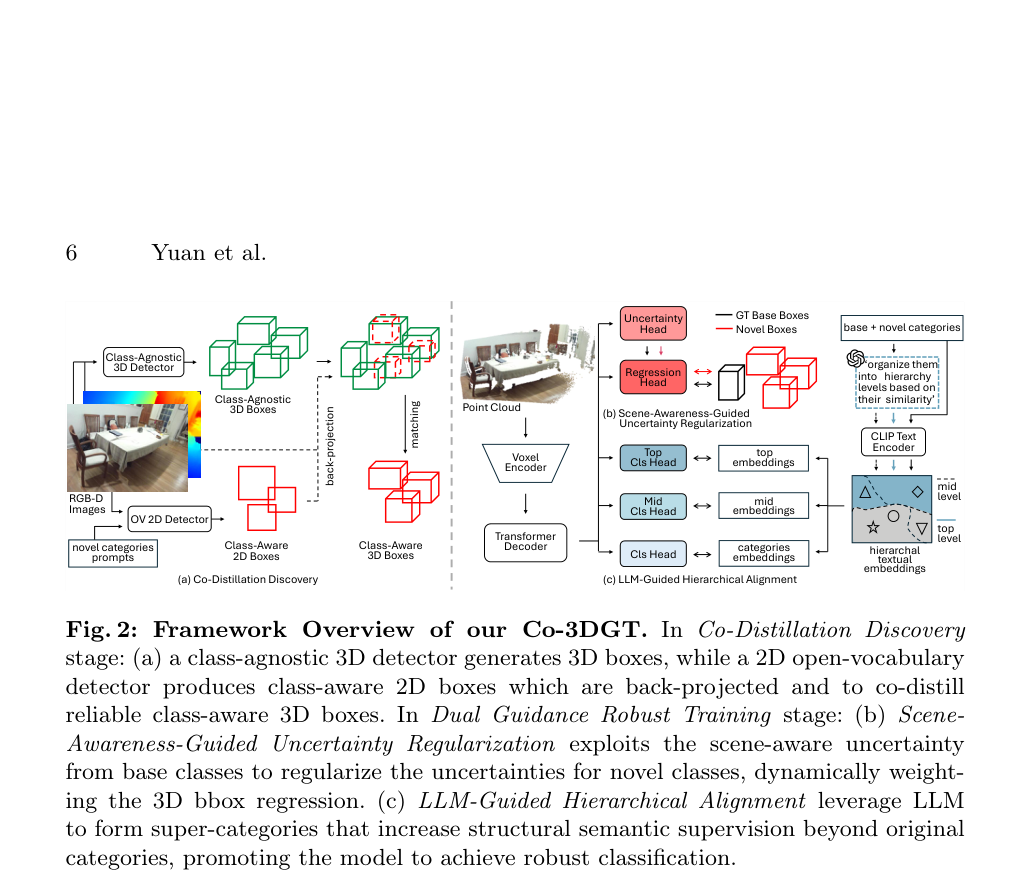
该图展示了Co-3DGT的完整框架。左侧的Co-Distillation Discovery阶段显示2D语义框与3D提案框如何通过匹配蒸馏出可靠伪标签;右侧的Dual Guidance Robust Training阶段展示SGUR如何正则化不确定性,以及LGHA如何利用LLM生成超类别进行层次对齐。观察此图可以理解两个阶段的衔接关系。
验证与结论
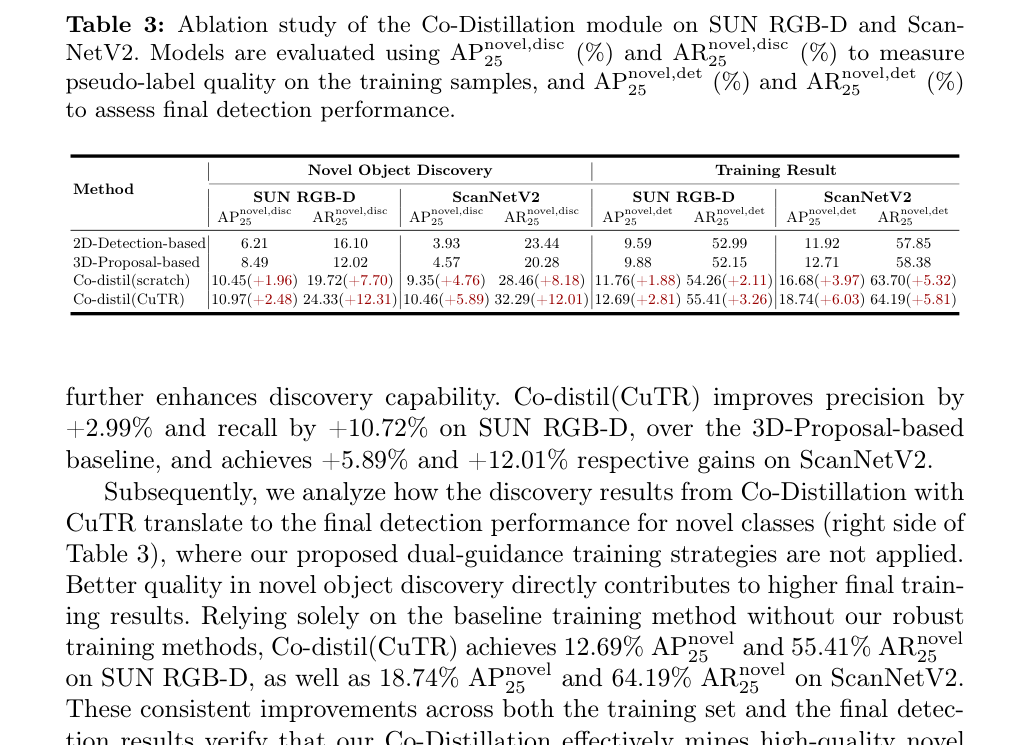
该表对比了四种发现策略的性能。重点观察Co-distil(CuTR)相比3D-Proposal-based在recall上的大幅提升,这直接证明了协同蒸馏在发现新物体方面的优势。
Fig
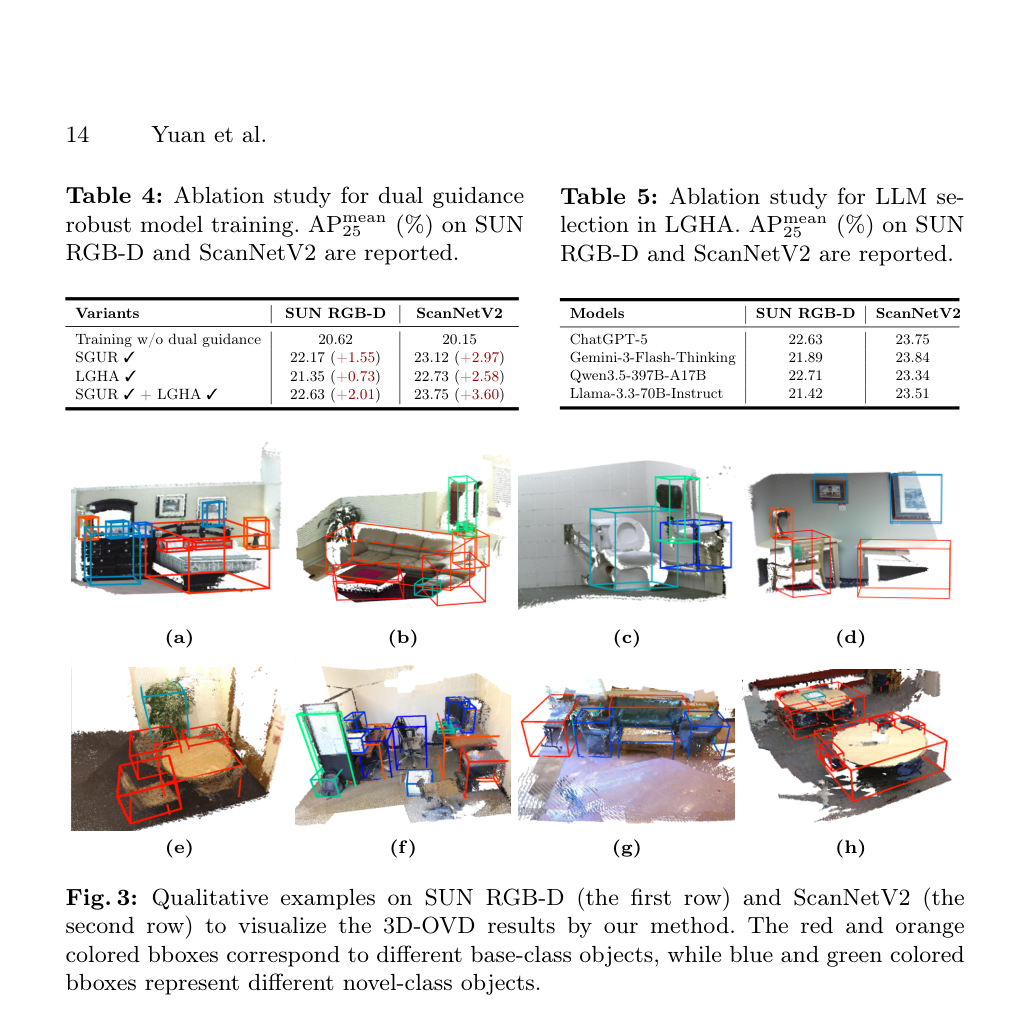
该图展示了SUN RGB-D和ScanNetV2上的定性结果。蓝色和绿色框代表新类物体,观察这些框的定位精度和类别正确性,可以直观感受Co-3DGT在新类检测上的改进。
实验如何设计?
- 在SUN RGB-D和ScanNetV2两个室内数据集上进行评估,采用AP25和AR25作为主要指标。
- 与8个基线方法对比,包括OV-3DET、CoDA、CoDAv2、INHA、OV-Uni3DETR等。
- 在ScanNetV2上进行了20个未见类别的逐类AP25对比,评估无真值标注设置下的性能。
- 对Co-Distillation模块进行消融,对比2D-Detection-based、3D-Proposal-based、Co-distil(scratch)和Co-distil(CuTR)四种发现策略。
- 对SGUR和LGHA分别进行单独及组合消融,验证双重引导的贡献。
- 对比不同LLM(ChatGPT-5、Gemini-3-Flash-Thinking、Qwen3.5-397B-A17B、Llama-3.3-70B-Instruct)对LGHA的影响。
关键结果与论文证据
- 在SUN RGB-D上,Co-3DGT的APnovel25达到14.37%,较OV-Uni3DETR提升4.71个百分点;在ScanNetV2上达到21.91%,提升9.82个百分点(第12页,表1)。
- APmean25在SUN RGB-D上为22.63%,ScanNetV2上为23.75%,分别较OV-Uni3DETR提升4.57和8.60个百分点(第12页,表1)。
- 无真值标注设置下,Co-3DGT在ScanNetV2上的APmean25达到36.15%,较OV-Uni3DETR提升10.82个百分点(第13页,表2)。
- Co-distil(CuTR)相比3D-Proposal-based,在SUN RGB-D上precision提升2.99%、recall提升10.72%,在ScanNetV2上分别提升5.89%和12.01%(第13页,表3)。
- SGUR单独贡献在SUN RGB-D上为+1.55%,ScanNetV2上为+2.97%;LGHA单独贡献分别为+0.73%和+2.58%;两者组合贡献为+2.01%和+3.60%(第14页,表4)。
- 不同LLM对LGHA的影响较小,APmean25在SUN RGB-D上波动于21.42%至22.71%之间,ScanNetV2上波动于23.34%至23.84%之间(第14页,表5)。
- 定性可视化显示,Co-3DGT在新类物体上产生了更准确的3D框定位和更可靠的类别预测(第14页,图3)。
阅读时需要注意
- SGUR依赖场景中存在基础类真值标注,在完全无标注设置下不可用。
- 发现阶段耗时较高:SUN RGB-D约47分钟,ScanNetV2约169分钟(单RTX 3090),高于OV-Uni3DETR的25分钟和103分钟。
- 仅评估了室内数据集,未验证室外场景的泛化能力。
- 当前框架不具备实时性,未来工作提及需引入时序融合以实现实时3D-OVD。
- 论文中部分数值存在不一致:Co-distil(CuTR)的precision提升在正文中表述为+2.99%,但表3中标注为+2.48%;Co-distil(scratch)的precision提升在正文中写为+0.97%,但表3显示为+1.96%。
关联工作
- OV-3DET是首个无需3D标注的3D-OVD方法,采用2D检测反投影策略,本文沿用其无标注评估设置。
- CoDA属于3D-Proposal-based范式,协同新物体发现与跨模态对齐,本文在其基础上改进发现策略。
- INHA从2D OVD结果播种3D提案并引入多层层次对齐,本文的LGHA与其思路相关但引入LLM生成超类别。
- OV-Uni3DETR是多模态统一开放词汇检测器,是本文的主要对比基线,本文在仅点云输入下超越其性能。
- CLIP用于类别文本编码和语义对齐,Detic作为2D开放词汇检测器用于发现阶段,CuTR作为类无关3D检测器生成提案。