快速导读:RoMAN-Flow 提出基于自回归归一化流(AR-NF)策略的离线强化学习框架,通过无采样的 NF-IQL 后训练和一步蒸馏解决 AR-NF 采样瓶颈,在多个仿真与真实机器人基准上取得竞争性性能并大幅降低推理延迟。
RoMAN-Flow 解决的核心问题是:自回归归一化流(AR-NF)策略虽然提供精确的条件似然,适合基于似然的离线强化学习后训练,但其自回归逆变换导致策略优化和部署时的采样开销过大,难以在机器人操作中实用化。论文提出一个两阶段框架:先用无采样的 NF-IQL 后训练直接优化离线数据中高优势动作块的精确似然,再用一步蒸馏将教师 AR-NF 压缩为单次前向的双向 Transformer 学生,从而在保留精确似然优势的同时消除顺序逆变换的延迟。
论文在 MetaWorld-MT50、LIBERO、RoboMimic 和真实 Franka–XHand 平台上验证了方法。NF-IQL 后训练在多个基准上取得竞争性或最优成功率,一步蒸馏在 LIBERO-Long 上将动作块生成延迟降低约八点五倍而成功率几乎不降。真实机器人实验显示 NF-IQL 相比纯模仿学习有大幅提升,但一步蒸馏在真实场景中仍有明显性能损失,提示蒸馏的泛化边界需要进一步研究。
英文题目:RoMAN-Flow: Taming Autoregressive Normalizing Flows for Offline Reinforcement Learning in Robotic Manipulation
论文出处:arXiv 每日论文精选 · arXiv:2608.20208
原始论文:PDF / 论文页面
这篇论文解决什么问题?
离线强化学习利用固定的奖励标注数据改进机器人策略,避免了在线交互的高成本。近年来扩散策略和流匹配策略在机器人操作中表现突出,但它们不暴露低成本的精确似然,使得基于似然的离线 RL 后训练难以直接应用。IQL 等隐式 Q 学习方法虽然不需要策略采样,但其演员更新通常依赖从策略中采样动作来估计梯度,这与扩散策略的采样成本叠加后变得昂贵。
AR-NF 是一类可逆生成模型,能够给出连续动作块在给定多模态条件下的精确条件似然。SimFlow 等工作已经证明 AR-NF 在机器人操作中具有强生成建模能力。然而,AR-NF 的逆变换是自回归的:生成动作块时需要逐步恢复每个动作维度,每一步都依赖前一步的输出,导致推理延迟随动作块长度线性增长。这个速度瓶颈使得 AR-NF 在需要实时控制的机器人部署场景中难以接受。
因此,研究缺口可以概括为:如何在保留 AR-NF 精确似然优势的同时,消除其在策略优化和部署两个阶段的自回归采样成本。RoMAN-Flow 的答案是双重的——训练阶段用无采样的优势加权似然优化,部署阶段用一步蒸馏压缩逆变换。
核心创新
- 提出 RoMAN-Flow 框架,使 AR-NF 策略在机器人操作中实用化,保留连续动作建模和精确似然评估
- 提出无采样的 NF-IQL 后训练,仅对离线数据集动作块进行优势加权似然优化,避免自回归策略采样
- 提出一步策略蒸馏,通过对齐教师中间流状态和最终动作块,消除部署时的顺序逆变换
- 将块级前缀 Q 值学习与 AR-NF 精确似然结合,实现基于似然的离线策略改进
方法概览
RoMAN-Flow 采用条件 AR-NF 策略,通过多模态编码器(SmolVLM 或 ResNet)编码视觉、语言和本体感受条件;模仿学习阶段最大化演示动作块的精确条件似然;NF-IQL 后训练基于 IQL,学习块级 Q 值和状态值,用优势加权似然直接优化离线数据动作块,无需策略采样;最后通过数据诱导和先验采样的中间状态对齐与动作重建,将教师 AR-NF 蒸馏为一步双向 Transformer 学生。
- RoMAN-Flow 采用条件 AR-NF 策略,通过多模态编码器(SmolVLM 或 ResNet)编码视觉、语言和本体感受条件,将连续动作块映射到高斯先验下的潜在变量。模仿学习阶段最大化演示动作块的精确条件似然。
- NF-IQL 后训练基于 IQL 框架,学习块级 Q 值和状态值,使用期望分位数回归估计值函数。演员更新采用优势加权似然:直接在离线数据集的动作块上,按优势权重调整其精确条件似然,高优势动作块似然升高,低优势动作块似然降低。整个过程不需要从策略中采样动作。
- 块级前缀 Q 值学习参考了 CO-RFT 的做法,将动作块视为整体进行 Q 值估计,与 AR-NF 的块级似然自然对齐。轨迹级奖励重标记的灵感来自 HUBL,用于在稀疏奖励任务中构造更有效的训练信号。
- 一步蒸馏阶段,学生模型是一个双向 Transformer,训练目标是同时对齐教师 AR-NF 的中间流状态和最终动作块。具体来说,学生需要在单次前向中重建教师通过多步自回归逆变换得到的中间状态序列和最终动作块。
- 蒸馏的数据来源包括离线数据集中的真实状态-动作对,以及从先验采样潜在变量后经教师逆变换生成的状态-动作对。这种数据诱导和先验采样的结合,使学生能够覆盖教师策略的分布。
- 部署时,学生模型只需一次前向传播即可生成完整动作块,完全消除了自回归逆变换的顺序依赖。
逐图理解论文
失败直觉:似然与速度的两难
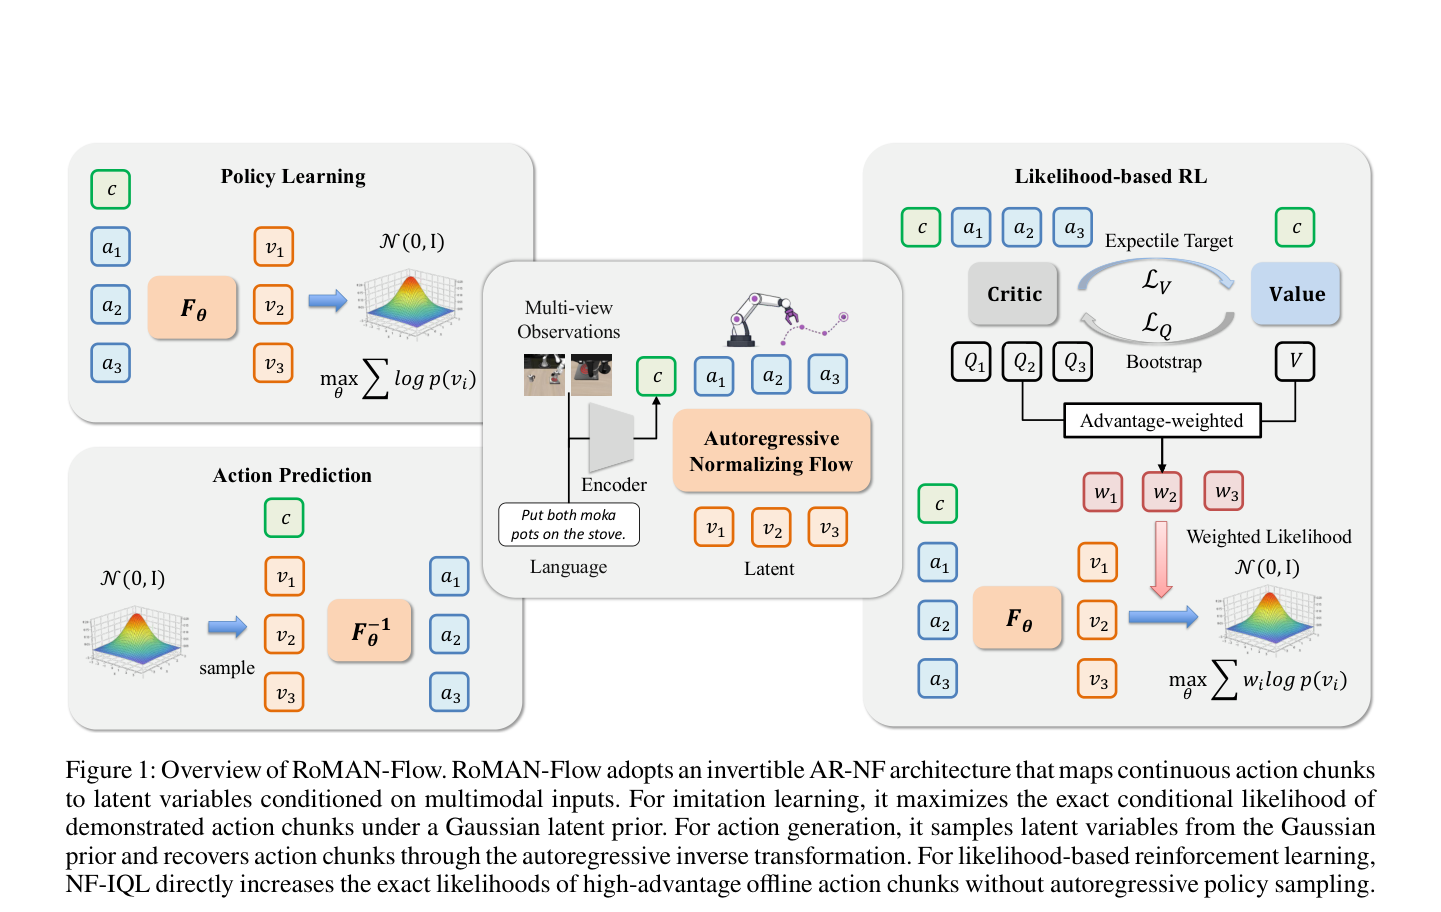
该图展示 RoMAN-Flow 的整体框架:AR-NF 将连续动作块映射到高斯先验下的潜在变量,模仿学习最大化精确条件似然,NF-IQL 直接优化高优势动作块的似然而无需采样。观察此图可以理解精确似然如何在训练和推理两个阶段被利用。
验证方式与核心证据
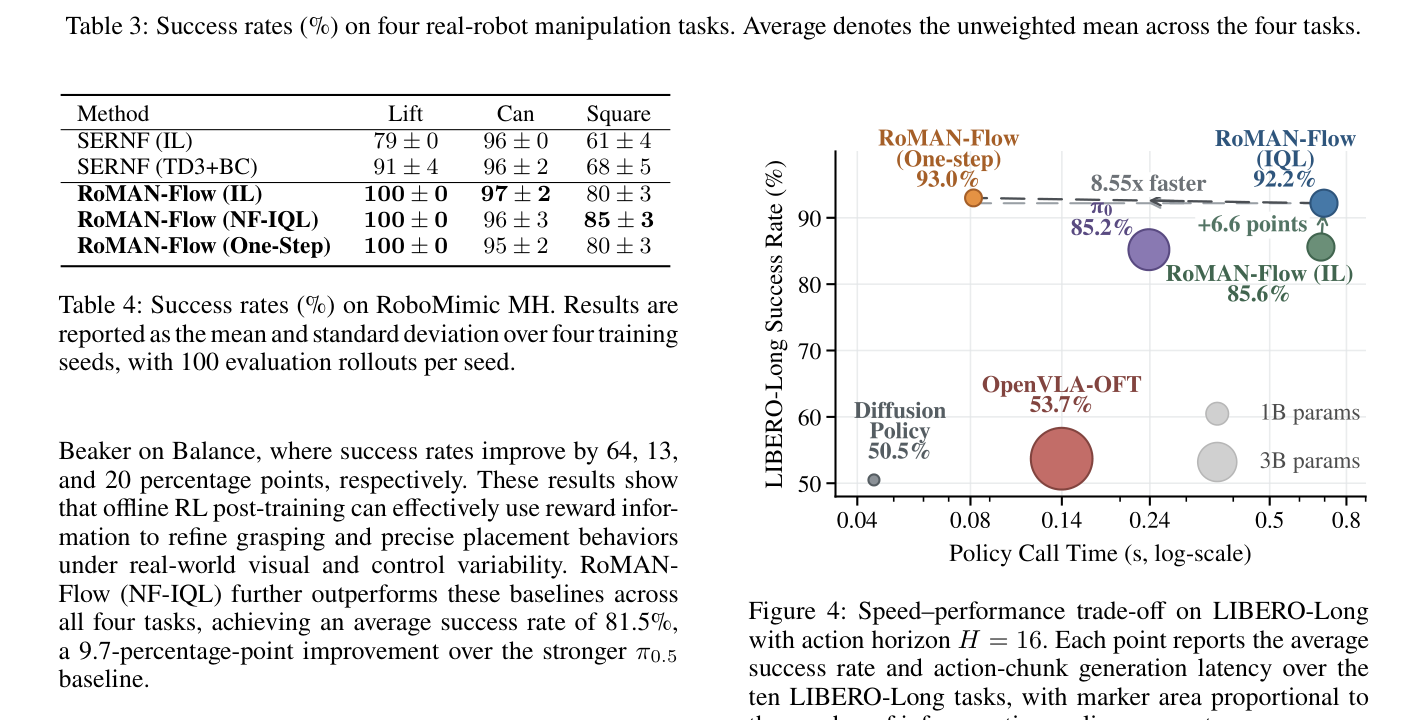
该表展示真实机器人四个任务的成功率对比:NF-IQL 相比 IL 有大幅提升,而 One-Step 在部分任务上明显下降。注意 Pick Cylinder 任务的显著差距,这是蒸馏泛化局限的直接证据。
Figure 2: One-step policy distillation
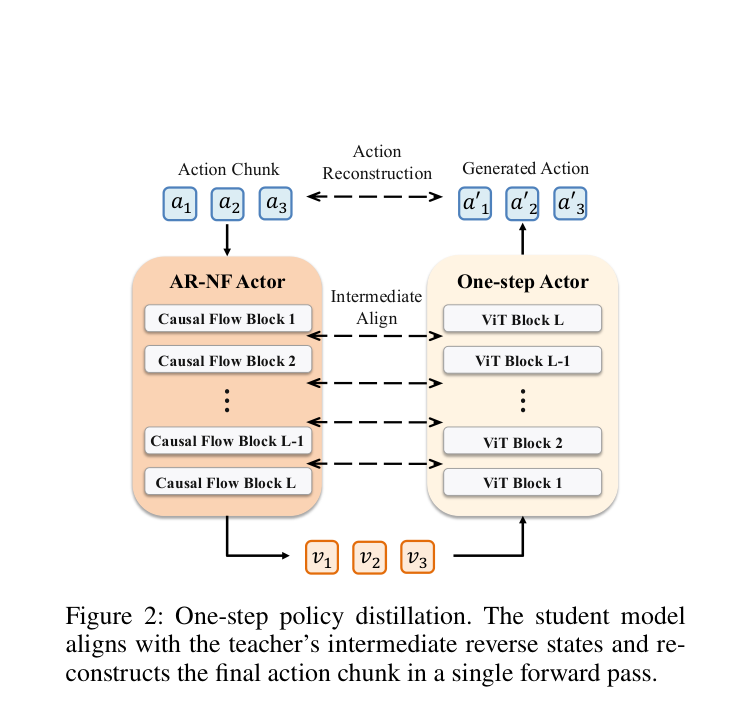
该图展示一步蒸馏的机制:学生模型对齐教师 AR-NF 的中间逆变换状态,并在单次前向中重建最终动作块。注意学生如何绕过自回归顺序依赖,这是消除部署延迟的关键。
实验如何设计?
- MetaWorld-MT50:五十个操作任务,按难度分为四组,评估平均成功率。
- LIBERO:四个任务套件(Spatial、Object、Goal、Long),其中 LIBERO-Long 包含长时序任务,用于评估速度-性能权衡。
- RoboMimic MH:Lift、Can、Square 三个任务,与 SERNF(使用 RealNVP 策略和 TD3+BC)进行受控对比,报告四个训练种子的均值和标准差。
- 真实机器人:七自由度 Franka 机械臂和十二自由度 XHand 灵巧手平台,四个操作任务,评估对象初始化包含分布外位置。
- 消融实验:AR-NF 演员容量从 S 到 XL 配置(约三千四百万到六亿八千六百万参数),在 RoboMimic Square-MH 上评估。
关键结果与论文证据
- NF-IQL 在 MetaWorld-MT50 上平均成功率达 81.1%,比 IL 阶段的 72.8% 提升 8.3 个百分点(第 6 页)。
- NF-IQL 在 LIBERO 平均成功率达 95.3%,为对比方法中最高;One-Step 在 LIBERO-Long 达 93.0%,同样最高(第 6 页)。
- RoboMimic MH 上 NF-IQL 在 Lift、Can、Square 分别达 100%、96%、85%,优于 SERNF 的 91%、96%、68%(第 7 页)。
- 真实机器人任务 NF-IQL 平均成功率 81.5%,比 IL 的 57.3% 提升 24.2 个百分点(第 7 页)。
- One-Step 蒸馏在 LIBERO-Long 将动作块生成延迟从约 697 ms 降至 81.5 ms,加速 8.55 倍,成功率 93.0% 对比教师 92.2%(第 7 页)。
- AR-NF 演员容量消融显示 S/B/L 配置成功率均为 77%–78%,XL 配置达 85%,说明需要较大容量才显现收益(第 7 页)。
- NF-IQL 在 MetaWorld Easy 组成功率从 80.4% 略降至 80.0%,优势加权对简单任务可能无益(第 6 页)。
阅读时需要注意
- 一步蒸馏在真实机器人上平均成功率从 81.5% 降至 69.5%,Pick Cylinder 任务仅 20%,说明蒸馏在分布外场景下泛化不足。
- AR-NF 演员容量在中小规模内扩展未带来性能提升,需要较大容量才显现收益,增加了计算成本。
- NF-IQL 在简单任务上可能无益甚至略降,优势加权似然的适用条件需要进一步分析。
- 论文 arXiv 编号和部分引用日期异常,可能为预印本占位,需核实。
- MetaWorld-MT50 与 π0 + Flow-SDE 的对比条件不完全对等:后者使用在线环境交互,而 NF-IQL 仅用离线数据。
关联工作
- Diffusion Policy 是扩散策略基线,缺乏可处理精确似然,是 RoMAN-Flow 的对比对象。
- IQL 是 NF-IQL 后训练的基础框架,采用优势加权最大似然演员更新。
- SimFlow 是 RoMAN-Flow 采用的 AR-NF 骨干架构。
- FARMER 和 BiFlow 是一步蒸馏方法的灵感来源,分别针对图像生成中的 AR-NF 推理加速和双向一步逆变换。
- SERNF 是 RoboMimic 上的受控对比方法,使用 RealNVP 策略与 TD3+BC。
- CO-RFT 是块级前缀 Q 值学习的参考方法,HUBL 是轨迹级奖励重标记的灵感来源。