快速导读:提出ID-VTG任务,用参考图像+文本的多模态查询解决文本无法区分相似实体的视频时序定位问题,并构建两个基准数据集与VGD-Agg双分支快慢框架。
视频时序定位(Video Temporal Grounding, VTG)的目标是根据自然语言查询在视频中定位事件片段。传统VTG方法默认文本查询足以唯一指代目标事件,但这一假设在真实场景中经常失效:当视频中出现多个视觉相似实体执行相同动作时,例如体操比赛中多名穿着相同队服的运动员依次完成同一套动作,文本描述“运动员完成空翻”无法区分具体是哪一位运动员。本文提出Image-Disambiguated Video Temporal Grounding(ID-VTG)任务,在文本查询之外引入一张参考图像作为严格的视觉约束,要求模型同时利用文本和图像信息定位目标片段。
为支撑该任务,作者构建了两个高歧义基准数据集:IDVTG-Gym聚焦细粒度、有序的体操动作,运动员外观高度相似;IDVTG-InternVid覆盖开放世界视频,包含多样实体和强时序干扰项。在此基础上,作者提出Visually-Guided Disambiguation Aggregation(VGD-Agg)框架,通过双分支快慢结构实现图像无关候选生成与图像相关细粒度匹配的协同。
英文题目:ID-VTG: Image-Disambiguated Video Temporal Grounding
论文出处:arXiv 每日论文精选 · arXiv:2608.20127
原始论文:PDF / 论文页面
这篇论文解决什么问题?
传统VTG的文本中心假设存在根本性局限。文本查询擅长表达语义类别和动作,但在描述细粒度视觉属性时力不从心。例如,“穿红色衣服的人”可以写出来,但“左数第三位、头发略卷、鞋带是蓝色的那位运动员”几乎无法用自然语言简洁表达。当视频中存在多个满足文本描述的实体时,纯文本查询天然存在指代歧义。
现有的时空视频定位(Spatio-Temporal Video Grounding, STVG)数据集如VidSTG和HC-STVG虽然包含空间标注,但其输入仍然是纯文本,且要求目标事件在视频中唯一出现,缺乏硬负样本。这意味着在这些数据集上训练的模型从未被要求区分“相似但不同”的实体,无法评估消歧能力。
Minotaur支持图像或文本单独查询,但不支持图文联合查询,无法利用图像来消解文本的指代歧义。ICQ探索了图像组合查询,但其关注点是语义修改而非指代消歧,其数据集也缺乏真正的歧义性。这些工作共同揭示了一个研究空白:缺少一个以图像作为消歧信号、以图文联合查询为输入、以高歧义场景为评估基准的VTG任务。
核心创新
- 首次提出Image-Disambiguated Video Temporal Grounding (ID-VTG)任务,以参考图像作为严格视觉约束消除文本指代歧义
- 构建IDVTG-Gym(体操细粒度有序动作)和IDVTG-InternVid(开放世界多实体强干扰)两个高歧义基准数据集,共76.8K查询、506.8小时视频
- 提出VGD-Agg双分支快慢框架,Fast Branch高效生成proposal,Slow Branch执行帧级细粒度视觉匹配
- 引入视频特定的Compare Token作为可学习硬负样本决策边界,以及Depress Value表示文本无关事件,通过Softmax竞争机制实现特征空间可分离
- 设计排序损失L_sim强制¯s_gt > s_c > ¯s_non-gt的序关系,显式优化Compare Token的判别能力
方法概览
提出VGD-Agg框架,基于SnAG构建双分支结构:Fast Branch生成图像无关的候选proposal特征;Slow Branch通过Distractor Generator生成视频特定的Compare Token和Depress Value,执行帧级图像匹配并优化排序损失(¯s_gt > s_c > ¯s_non-gt);Vision-Assisted Disambiguation模块利用Softmax竞争机制,将图像无关proposal特征推向Depress Value,图像相关proposal聚合匹配帧特征,得到可分离的消歧proposal特征,再经Text-Guided Grounding头分类与回归边界。
- VGD-Agg基于SnAG框架构建,采用双分支设计。Fast Branch继承SnAG的高效proposal生成能力,从视频流中生成图像无关的候选事件proposal特征,保证计算效率。
- Slow Branch执行帧级细粒度视频-图像匹配,通过Distractor Generator生成两个关键组件:视频特定的Compare Token和Depress Value。Compare Token是可学习的高相似度硬负样本原型,作为图像相关性的动态决策边界;Depress Value表示文本无关视频事件的可学习表示。
- Slow Branch同时优化排序损失,强制约束目标片段相似度大于Compare Token相似度、Compare Token相似度大于非目标片段相似度,即¯s_gt > s_c > ¯s_non-gt。这一序关系显式优化Compare Token的判别能力,使其成为区分目标与干扰项的决策边界。
- Vision-Assisted Disambiguation模块利用Softmax竞争机制实现特征空间的可分离性。图像无关的proposal特征被推向Depress Value方向,图像相关的proposal聚合匹配帧特征,从而在特征空间中形成清晰的目标-干扰项分离。
- 消歧后的proposal特征送入Text-Guided Grounding头进行分类与边界回归,最终输出精确的时序边界。
- 输入融合方式上,作者对比了Text-only、Attention Fusion、BLIP-2 Fusion和ICQ Fusion四种基线方案,证明VGD-Agg的视觉消歧机制优于简单的特征拼接或注意力融合。
逐图理解论文
研究空白
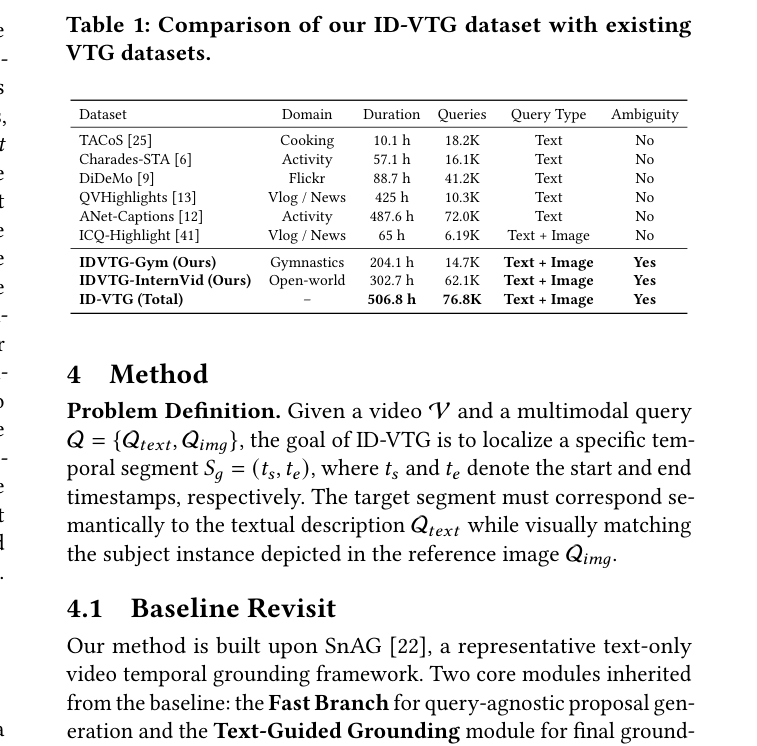
现有工作各有缺口。STVG数据集虽然包含空间标注,但输入仍是纯文本,而且要求目标事件唯一,根本没有硬负样本。Minotaur支持图像查询,却不支持图文联合输入。ICQ探索了图像组合查询,但关注的是语义修改而非指代消歧。换句话说,缺少一个以图像作为消歧信号、以图文联合查询为输入、以高歧义场景为评估基准的任务。
方法贡献
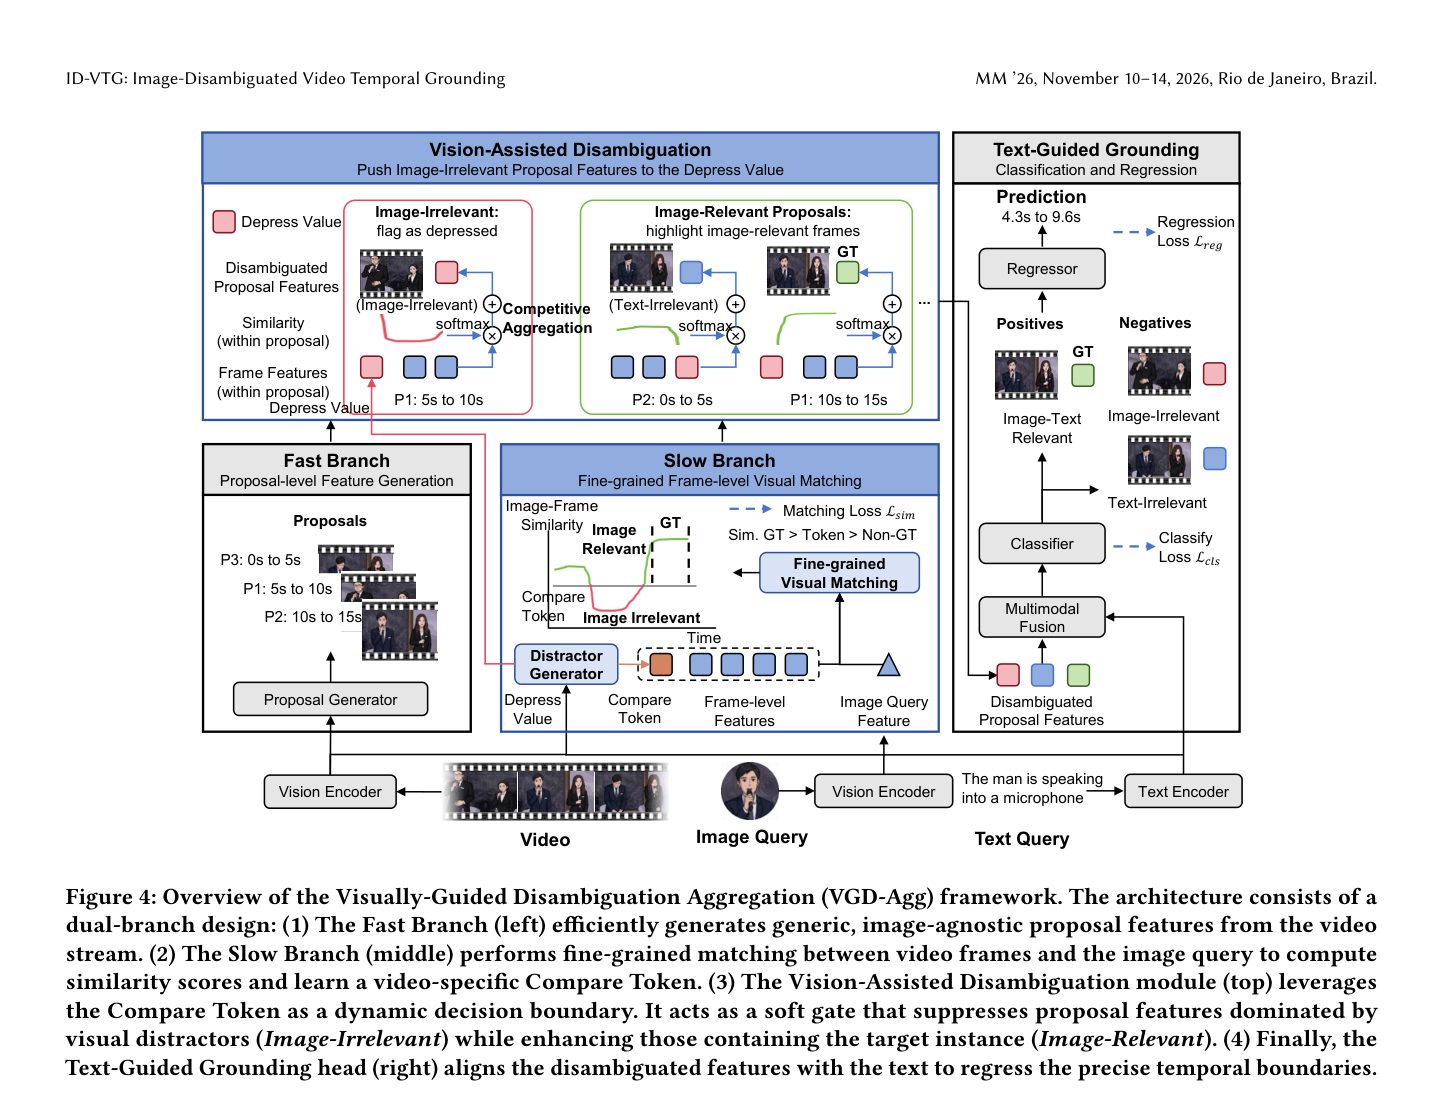
该图是VGD-Agg框架的完整架构图。重点观察Fast Branch与Slow Branch的并行结构,以及Vision-Assisted Disambiguation模块如何利用Compare Token作为动态决策边界来分离图像相关与图像无关的proposal特征。
验证与消融
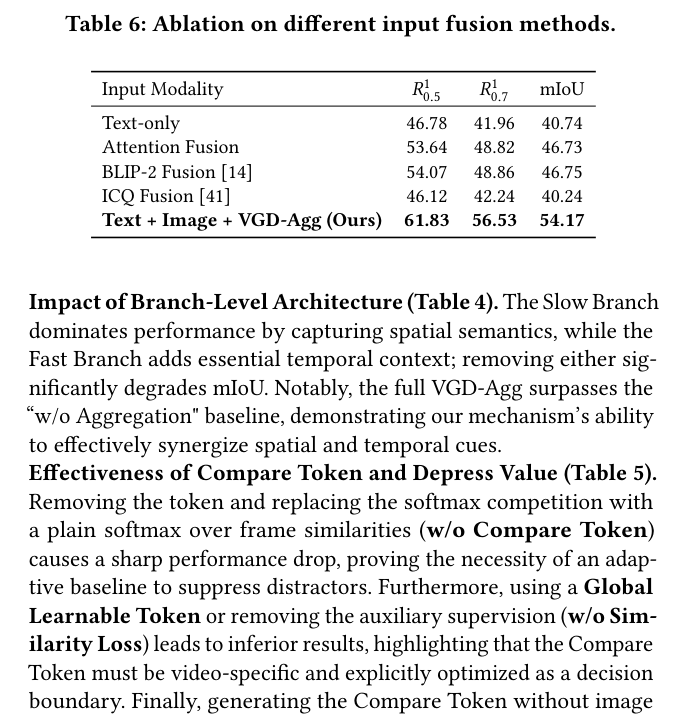
作者构建了两个高歧义基准:IDVTG-Gym聚焦体操细粒度动作,IDVTG-InternVid覆盖开放世界多实体场景。消融实验揭示了一个关键结论:简单的特征融合无法替代结构化消歧。Text-only的mIoU只有40.74,Attention Fusion和BLIP-2 Fusion都在46左右,而完整VGD-Agg达到54.17。去掉Compare Token后性能大幅下降,证明视频特定的决策边界是核心设计。
结论与意义
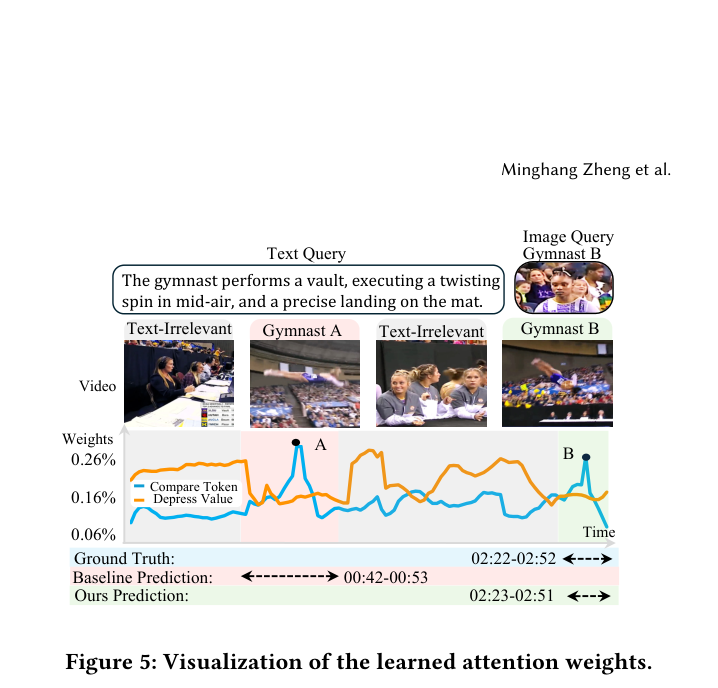
该图可视化学习到的注意力权重。观察模型在目标实例出现的时间段是否分配更高注意力,以及在干扰项出现时注意力是否被有效抑制,这直接验证了视觉消歧机制的实际效果。
实验如何设计?
- 在IDVTG-Gym的三个子集(Overall、Sub-act.、Holistic)上与RaTSG、UVCOM、CG-DETR、ICQ、SnAG五个基线对比。
- 在IDVTG-InternVid域内测试集及OOD Web数据集上评估跨域泛化能力。
- 消融实验覆盖分支级架构(Slow Branch/Fast Branch/Aggregation)、Compare Token与Depress Value设计、输入融合方式三个维度。
- 按歧义类型(Text Ambiguity vs Image Ambiguity)分析消歧能力,并测试图像查询在Clean、Brightness、Low Resolution三种条件下的鲁棒性。
- 通过注意力权重可视化进行定性分析,验证模型是否真正关注目标实例。
关键结果与论文证据
- 在IDVTG-Gym Overall子集上,VGD-Agg的R1@0.5达到61.83,较SnAG提升8.19个百分点(第7页表2),证明图像消歧在细粒度动作定位中的有效性。
- 在IDVTG-InternVid上,VGD-Agg的R1@0.5为51.21,较SnAG提升6.95个百分点(第7页表3),说明框架在开放世界场景同样有效。
- Web OOD数据集上VGD-Agg的R1@0.5为21.99,较SnAG提升5.51个百分点(第7页表3),显示一定的跨域泛化能力,但绝对性能仍然较低。
- 分支级消融显示:去掉Slow Branch后mIoU降至46.73,去掉Fast Branch后mIoU为51.32,去掉Aggregation后mIoU为53.50,完整模型为54.17(第7页表4),证明双分支协同不可或缺。
- Compare Token消融显示:去掉Compare Token后mIoU降至48.49,替换为Global Learnable Token后mIoU为52.62,去掉Similarity Loss后mIoU为52.67(第7页表5),证明视频特定的Compare Token和排序损失是关键设计。
- 输入融合消融显示:Text-only的mIoU仅为40.74,Attention Fusion为46.73,BLIP-2 Fusion为46.75,ICQ Fusion为40.24,完整VGD-Agg为54.17(第7页表6),证明简单的特征融合无法替代结构化的视觉消歧机制。
- 歧义类型分析显示:在Text Ambiguity Only场景下,VGD-Agg的R1@0.5为53.27,SnAG为41.94;在Image Ambiguity Only场景下,VGD-Agg为41.12,SnAG为38.19(第8页表7),说明框架对两类歧义均有消解能力,且对文本歧义的提升更显著。
- 鲁棒性测试显示:Low Resolution条件下VGD-Agg的R1@0.5为49.10,仍优于所有基线(第8页表8),说明框架对图像质量退化具有一定容忍度。
阅读时需要注意
- IDVTG-InternVid的标注由Gemini-2.5-Pro自动生成,仅10%测试集经人工重标注,训练集标注噪声可能影响模型性能上限。
- Web OOD数据集的绝对性能较低(R1@0.5=21.99),跨域泛化仍有较大提升空间。
- 图像查询鲁棒性测试仅覆盖亮度与低分辨率两种退化,未涉及遮挡、视角变化等更复杂场景。
- 框架基于SnAG构建,对基线架构存在依赖,未验证与其他proposal-free方法的兼容性。
关联工作
- SnAG是VGD-Agg的基础框架,VGD-Agg继承其Fast Branch和Text-Guided Grounding模块,在其上扩展Slow Branch和Vision-Assisted Disambiguation。
- ActionFormer为Fast Branch中的多尺度proposal编码器提供来源。
- FineGym是IDVTG-Gym的源数据集,提供层级化体操动作标注;InternVid是IDVTG-InternVid的源数据集,提供大规模开放世界视频。
- Sa2VA在数据集构建Stage 2中用于定位目标实例,Gemini-2.5-Pro是IDVTG-InternVid自动标注pipeline的核心MLLM。