快速导读:Q-Guide 将文档 VQA 重新定义为问题条件化的感知循环:智能体迭代判断缺失证据、调用定向恢复工具补齐,再提交答案,在 DocVQA2026 和 Manga109 上显著超越直接提示与多智能体基线。
文档视觉问答(DocVQA)的难点不在于模型“看不见”文档,而在于它无法可靠地“读取”问题所依赖的具体证据。小字标注、表格单元格颜色、空间关系、跨页身份匹配——这些信息在单次快速感知中极易丢失。Q-Guide的核心主张是:感知本身应该是问题条件化的,模型应当像人类查阅文档一样,先判断缺什么,再有针对性地去看。
Q-Guide是一个紧凑的单循环智能体,由同一MLLM策略在每轮检查当前证据状态,判断缺失证据,从五个恢复工具中选择并执行,将带区域坐标的观察追加到证据状态。充分性谓词基于自报置信度与实测可靠性的门控决定提交或继续。在DocVQA2026和M109NC两个基准上,Q-Guide显著超越直接提示与多智能体基线,且跨三个Claude骨干泛化。
英文题目:Question-Guided Evidence Acquisition for Multimodal Visual Question Answering
论文出处:arXiv 每日论文精选 · arXiv:2608.19739
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有文档VQA系统将感知视为固定步骤:页面编码一次后直接回答,这是一种System-1式的感知。当问题依赖的细节恰好落在模型注意力覆盖不足的区域时,回答就会失败。直接提示基线(仅图像、仅OCR文本、两者拼接)在DocVQA2026上均表现不佳,说明单纯增加输入信息量并不能解决“该看哪里”的问题。
近期智能体方法引入了规划、路由、多智能体协作等更重的编排机制。但这些方法带来了新的失败模式:规划错误会级联传播,噪声摘要会污染后续推理,多智能体间的通信开销可能超过收益。论文的编排消融显示,3-Stage Research在DocVQA2026上仅达35.7%,甚至低于直接提示基线,说明更复杂的编排并不自动带来更好的感知。
关键的研究空白在于:没有人系统回答“哪些问题条件化的感知恢复动作真正有效”。Q-Guide的贡献正是填补这一空白——不是堆叠更多智能体,而是设计一个最小充分的问题条件化感知循环,并逐一验证每个恢复工具的实际贡献。
核心创新
- 将文档 VQA 形式化为问题条件化的测试时感知推理循环(System-2 感知),而非语言层面的慢思考
- 提出五类问题条件化恢复工具,每类针对一个感知缺口,所有观察附带源区域坐标实现证据接地
- 用实测可靠性 ρ(ℓ) 校准的置信度门控实现充分性判断,无需独立 critic 或 planner
- 证明紧凑迭代工具循环优于更重的规划/路由/多智能体编排,且跨三个 Claude 骨干和两个视觉域泛化
方法概览
Q-Guide 是一个紧凑的单循环智能体,由同一 MLLM 策略 π 在每轮检查证据状态 et=(q,D,Ot),判断缺失证据,从五个恢复工具(文本恢复、视觉细节、定向查询、空间恢复、结构恢复)中选择并执行,将带区域坐标的观察 oi=(ai,ri,yi) 追加到证据状态;充分性谓词 ϕ 基于自报置信度 σ 与实测可靠性 ρ(ℓ) 的门控(默认 τ=med)决定提交或继续,低置信度触发验证并回退 Unknown。长文档用重叠分块加置信度加权多数融合。
- 证据状态et=(q,D,Ot)由问题、文档和累积观察序列组成。每轮迭代中,同一MLLM策略π检查证据状态,判断缺失证据,从五个恢复工具中选择并执行。
- 五个恢复工具分别针对一类感知缺口:文本恢复(Text Recovery)提取被忽略的文字;视觉细节(Visual Inspection)放大局部区域;定向查询(Targeted Query)针对特定信息提问;空间恢复(Spatial Recovery)验证空间关系;结构恢复(Structure Recovery)解析表格和布局结构。
- 每个工具返回的观察oi=(ai,ri,yi)附带源区域坐标ri,实现证据接地。这意味着模型不仅知道“答案是什么”,还知道“答案来自文档的哪个位置”,便于验证和追溯。
- 充分性谓词ϕ基于自报置信度σ与实测可靠性ρ(ℓ)的门控(默认τ=med)决定提交或继续。低置信度触发验证并回退Unknown,避免在证据不足时强行作答。
- 长文档使用重叠分块加置信度加权多数融合。页面级检索在DocVQA2026上仅达50.0%,而分块融合达65.0%,说明问题条件化的证据聚合优于简单的页面选择。
- 整个系统不需要独立的critic或planner模块。置信度门控直接由策略自身的自报置信度驱动,用实测可靠性校准阈值,保持了架构的紧凑性。
逐图理解论文
失败案例与直觉
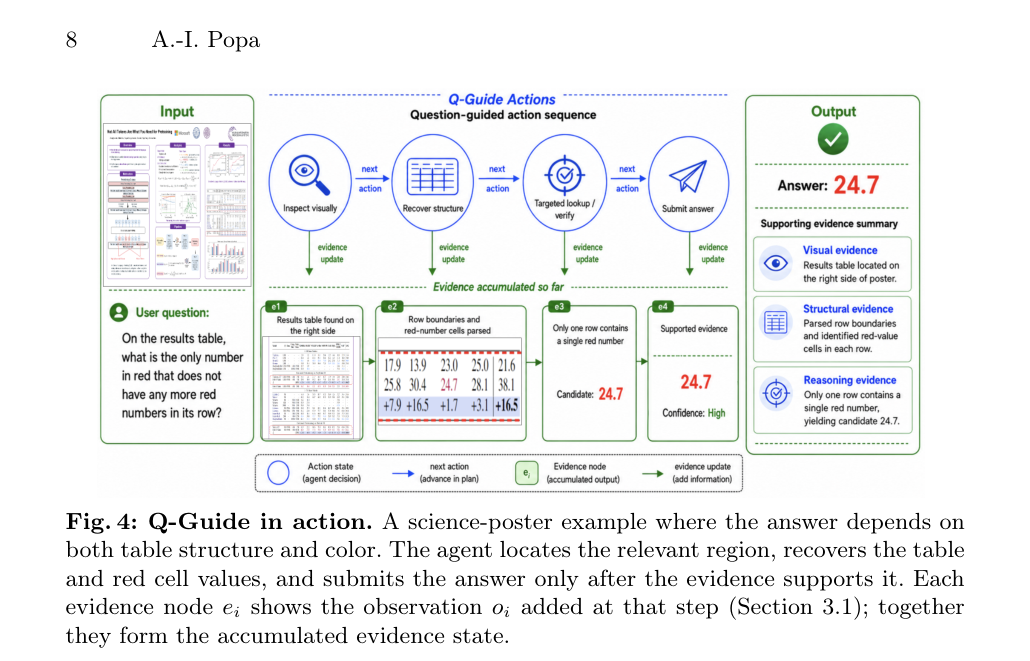
科学海报示例展示了Q-Guide的实际运作:答案依赖表格结构和颜色,智能体先定位相关区域,恢复表格和红色单元格值,证据充分后才提交。每个证据节点ei显示该步添加的观察,观察其证据接地的方式。
研究空白
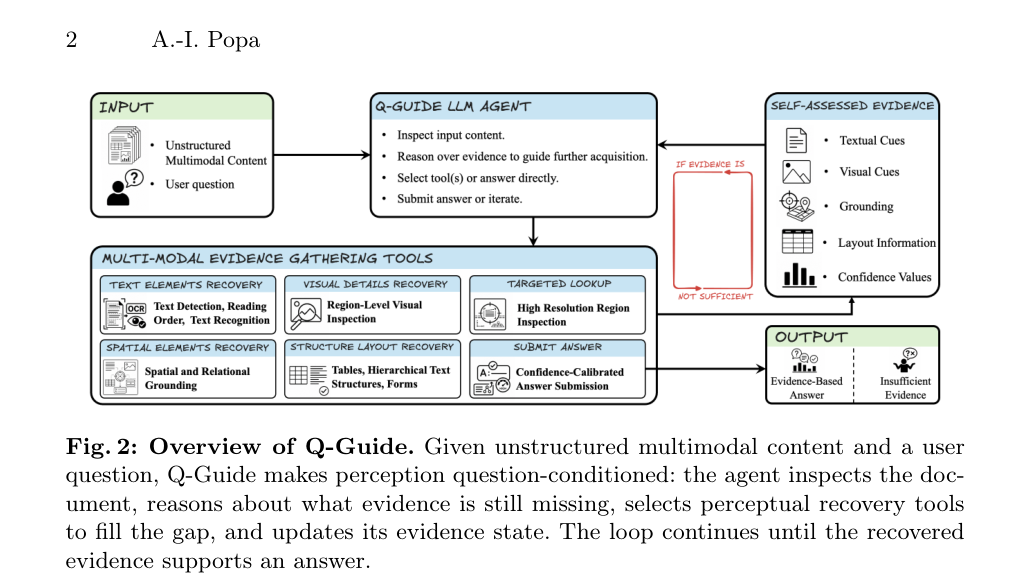
系统总览图展示了Q-Guide的循环结构:智能体检查文档、推理缺失证据、选择恢复工具、更新证据状态,循环直到证据充分。关键看点是循环的紧凑性——没有独立的planner或critic,同一策略承担所有角色。
工具消融与编排对比
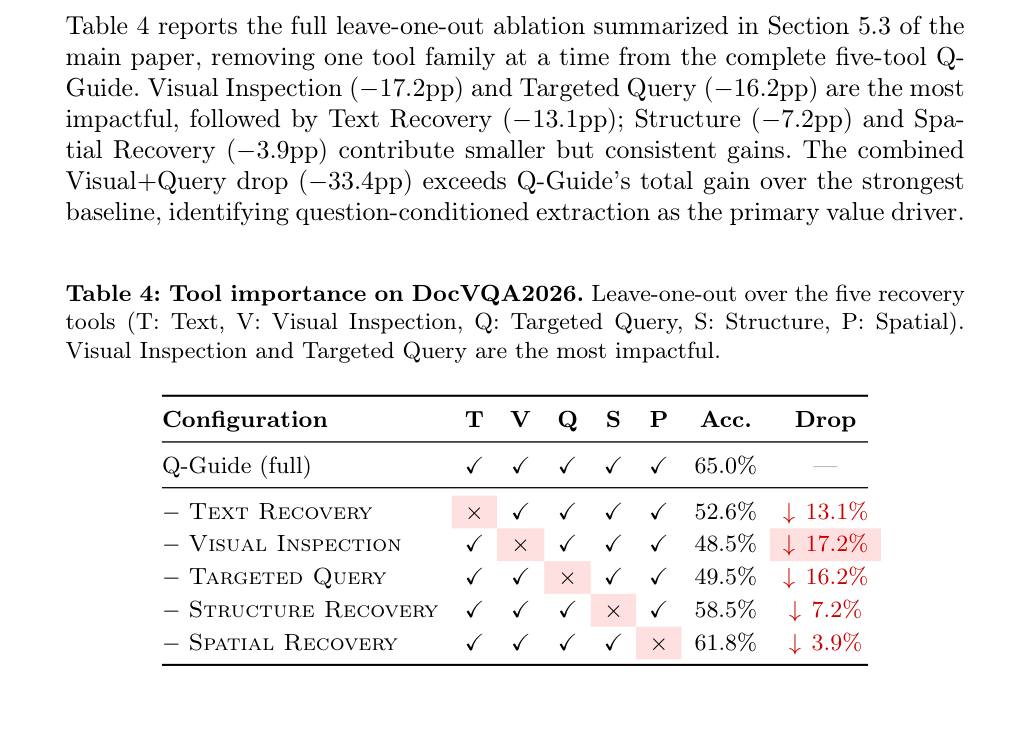
完整留一消融表。Visual Inspection(−17.2pp)和Targeted Query(−16.2pp)影响最大,Text Recovery(−13.1pp)次之,Structure和Spatial贡献较小但一致。Visual+Query联合移除−33.4pp,超过Q-Guide相对最强基线的总增益,确认问题条件化提取是主要价值驱动。
结论与意义
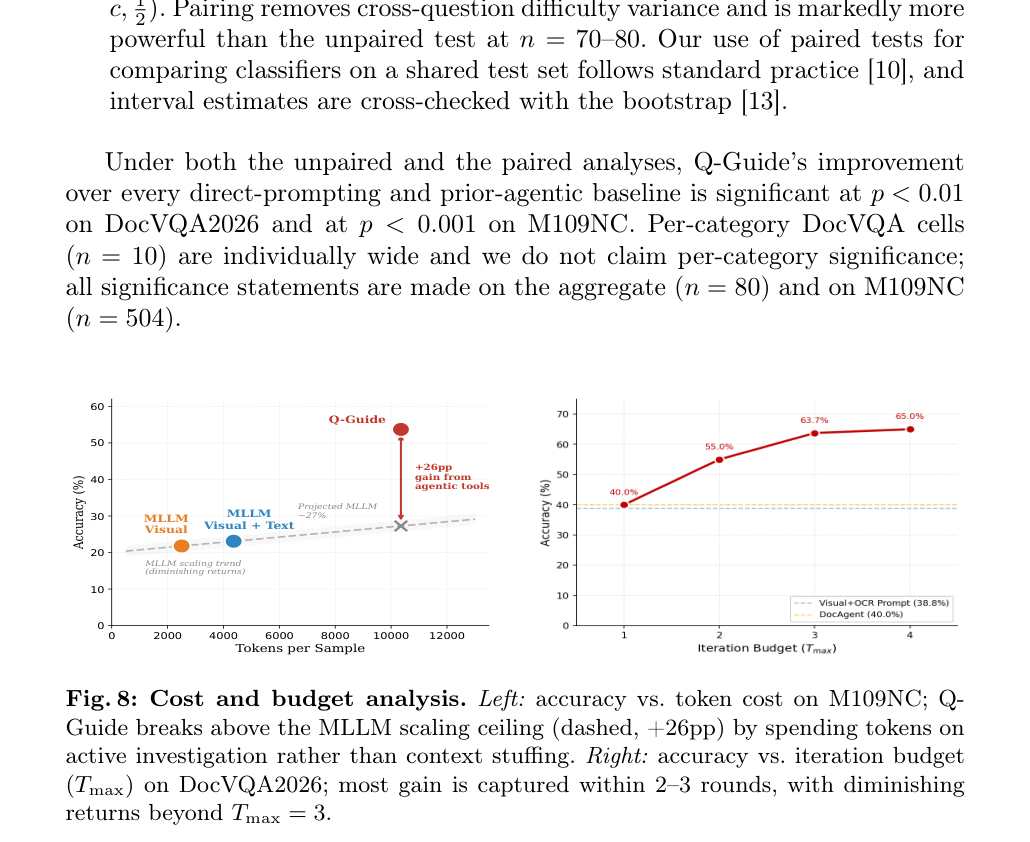
成本与预算分析。左图显示Q-Guide通过主动调查而非上下文填充突破MLLM扩展天花板;右图显示大部分增益在2-3轮内实现,Tmax=3后收益递减。观察重点是成本-收益曲线的拐点位置。
实验如何设计?
- DocVQA2026验证集:80题,8类文档,每类10题。论文明确声明逐类结果仅作趋势参考,不做逐类显著性声明。
- M109NC基准:基于Manga109-v2026构建的角色命名任务,n=504,测试跨页身份匹配能力。分别使用Claude-OCR和GT-OCR两种文本源。
- 基线设置:直接提示基线(Visual-only、OCR-only、Visual+OCR Prompt)和智能体基线(ARIAL、DocAgent、MDocAgent)。所有智能体基线在Claude骨干上重新实现,与原始论文报告数值不可直接比较。
- 消融设计:编排策略消融(直接提示、Extract-Synthesize、3-Stage Research、Advisory Routing、Basic agentic、Q-Guide)和工具重要性留一消融。
- 跨骨干泛化测试:Claude Opus 4.6、Sonnet 4.6、Opus 4.5三个骨干。
- 成本与迭代预算分析:token成本测量(M109NC上50题均值)和Tmax收敛拟合。
关键结果与论文证据
- DocVQA2026总体准确率65.0%,比最强直接基线Visual+OCR Prompt(38.8%)高26.2点,比最强智能体基线DocAgent/MDocAgent(40.0%)高25.0点,p<0.01(第9页)。
- M109NC上Q-Guide达32.4%(Claude-OCR),比DocAgent(24.4%)高8.0点;GT-OCR下达53.7%,比Visual+OCR Prompt GT-OCR(24.9%)高28.8点(第11页)。
- 工具留一消融:Visual Inspection −17.2pp、Targeted Query −16.2pp、Text Recovery −13.1pp、Structure −7.2pp、Spatial −3.9pp;Visual+Query联合移除−33.4pp,超过Q-Guide相对最强基线的总增益(第19页)。
- 编排消融:3-Stage Research仅35.7%(低于直接基线),Advisory Routing 44.3%与Extract-Synthesize持平,Basic agentic 50.0%,Q-Guide 65.0%。更重的编排不带来更好感知(第12页)。
- 跨骨干:Q-Guide在Opus 4.6/Sonnet 4.6/Opus 4.5分别达65.0%/62.8%/64.2%,均超所有基线,而MDocAgent在较弱骨干上从40.0%退化到31.4%(第13页)。
- 迭代预算:Tmax=1时40.0%,Tmax=2时55.0%,Tmax≥3约65%;饱和拟合R²=0.982,90%增益在约3.2轮实现(第22页)。
- Token成本:Q-Guide每问10,351 tokens(93%输入侧),约2.5×DocAgent(4,055)和2.4×Visual+Text(4,364)。这是主动证据恢复的代价(第21页)。
- 置信度校准:med相对可靠性约0.63×high,单调分离支持τ=med门控。low级别主要为自弃权行为而非准确率估计(第22页)。
阅读时需要注意
- 地图类问题仍具挑战(DocVQA2026上仅50.0%):工具恢复局部文本和细节,但不将地图表示为可导航结构,缺少map-to-graph工具。
- OCR质量敏感:M109NC上Claude-OCR与GT-OCR差距达21.3点,有效文本质量仅约0.33。
- M109NC主导失败为感知视觉匹配(64.5%),跨页身份匹配依赖MLLM原生相似度评估,未使用显式嵌入距离匹配器。
- 长文档聚合采用轻量分块+置信度加权多数,概率多块证据模型和问题感知检索器留待未来工作。
- token成本约为最强智能体基线的2.5倍,输入侧开销占93%。
- DocVQA2026验证集仅80题,M109NC为论文自建基准,非独立第三方评测。
关联工作
- ARIAL将文档QA视为迭代定位与解析证据的过程,与Q-Guide动机相似,但Q-Guide采用更紧凑的单循环证据恢复而非多阶段规划。
- AgenticOCR提出按需解析的智能体OCR方法,与Q-Guide共享问题条件化感知动机。
- TextMonkey、mPLUG-DocOwl2、Qwen2.5-VL代表OCR-free或文档专用MLLM的模型侧改进路线。Q-Guide走系统侧路线:保留通用MLLM并暴露按需感知工具。
- Visual Sketchpad、TextCoT、Chain-of-Spot将视觉推理分解为交互式或链式步骤,Q-Guide借鉴其主动证据收集思想但聚焦问题条件化感知。