快速导读:提出一种纯视觉载荷的多模态RAG投毒攻击Vis-Poison,通过多智能体编辑构造语义自然的投毒图像,在30k知识库上实现40.16%–65.40%的端到端攻击成功率,并能覆盖MLLM的正确参数知识。
多模态检索增强生成(multimodal RAG)系统越来越多地将图像作为外部知识证据引入生成过程。现有投毒攻击主要依赖操纵文本元数据,如恶意caption或指令注入,这类攻击在文本不传给生成器或存在文本侧防护时失效。Vis-Poison提出了一种全新的攻击范式:投毒载荷完全存在于图像像素中,不依赖任何文本元数据操纵。
Vis-Poison的核心洞察是captioning与视觉问答之间存在注意力差异。同一张图像,captioning任务引导模型关注全局内容,而具体查询会引导模型关注局部区域。攻击者利用这一差异,在查询相关的干净图像上做局部语义编辑,使检索阶段的caption保持良性,而生成阶段模型被编辑区域诱导出攻击者期望的答案。
英文题目:Vis-Poison: Poisoning Visual Knowledge in Multimodal Retrieval-Augmented Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.20756
原始论文:PDF / 论文页面
这篇论文解决什么问题?
多模态RAG的典型流程是:图像先经过captioner生成文本描述作为检索索引,用户查询到来时retriever根据相似度返回相关图像,generator将图像作为视觉证据生成答案。这个流程中存在一个安全假设:如果文本侧有防护,投毒攻击就会被拦截。
现有攻击如PoisonedEye和MM-PoisonRAG都依赖文本载荷。PoisonedEye构造投毒图像-文本对,但依赖指令注入文本,在isValid文本事实核查下被完全拦截。MM-PoisonRAG在文本中显式暴露虚假证据,同样易被文本侧过滤。Shereen et al.的视觉文档攻击要么依赖白盒梯度优化,要么依赖页面内渲染文本,仍与文本线索绑定。
Vis-Poison要回答的问题是:能否构造一种投毒攻击,其恶意信息只存在于图像像素中,文本侧防护完全无法感知?这要求投毒图像在检索阶段看起来正常,在生成阶段却能诱导错误答案。
核心创新
- 首次提出纯视觉载荷的多模态RAG知识投毒攻击,不依赖任何文本元数据操纵
- 设计Planner-Editor-Verifier多智能体自动构造流程,在R=1时成功率超过73%
- 提出知识感知评估框架,用闭卷回答代理参数知识,定义POR、CHR、PIR三个指标区分知识缺陷利用与参数知识覆盖
- 证明局部语义编辑在captioning与视觉问答之间存在注意力差异,实现检索隐蔽性与生成操控性的解耦
方法概览
Vis-Poison通过编辑查询相关的干净图像构造投毒图像:Planner(MLLM)生成图像编辑指令,Editor(FLUX.2 [klein]-9B)执行编辑,Verifier(MLLM)验证图像是否支持攻击者期望答案并反馈修订。利用captioning与视觉问答之间的注意力差异:captioning关注全局内容使局部编辑在检索阶段隐蔽,而查询在生成阶段引导模型关注被编辑区域。
- Vis-Poison采用Planner-Editor-Verifier三阶段多智能体构造流程。Planner(MLLM)根据查询和干净图像生成图像编辑指令,Editor(FLUX.2 [klein]-9B)执行编辑,Verifier(MLLM)验证编辑后的图像是否支持攻击者期望答案,若不支持则反馈修订。
- 核心机制是利用captioning与视觉问答之间的注意力差异。captioning关注全局内容,局部编辑在检索阶段隐蔽;而查询在生成阶段引导模型关注被编辑区域,实现生成操控。
- 攻击流程为:攻击者编辑查询相关的干净图像,将其注入外部知识库。系统生成良性caption作为检索索引,可通过文本侧检查。用户查询到来时,retriever返回投毒图像,generator将其作为视觉证据产生攻击者期望的答案。
- 投毒图像数据集在WebQA上构建,包含4,416个投毒图像,按9种编辑类型分层,含1,842个easy实例和2,574个hard实例。编辑类型覆盖Color、Count、Replace、Person、Layout等,从低层外观变化到对象、场景、标志级编辑。
- 评估覆盖两种检索管线:P1(caption-based retrieval)和P2(shared-embedding retrieval),涉及9个captioner、3个retriever、6个generator,在COCO和Flickr30k知识库的1k/10k/30k规模上测试。
- 知识感知评估框架用闭卷回答代理参数知识,定义三个指标:POR(Poison Override Rate)衡量投毒证据覆盖正确参数知识的能力,CHR(Clean Help Rate)衡量干净证据帮助恢复正确答案的能力,PIR(Poison Induction Rate)衡量投毒证据诱导攻击者期望答案的能力。
逐图理解论文
失败案例与直觉
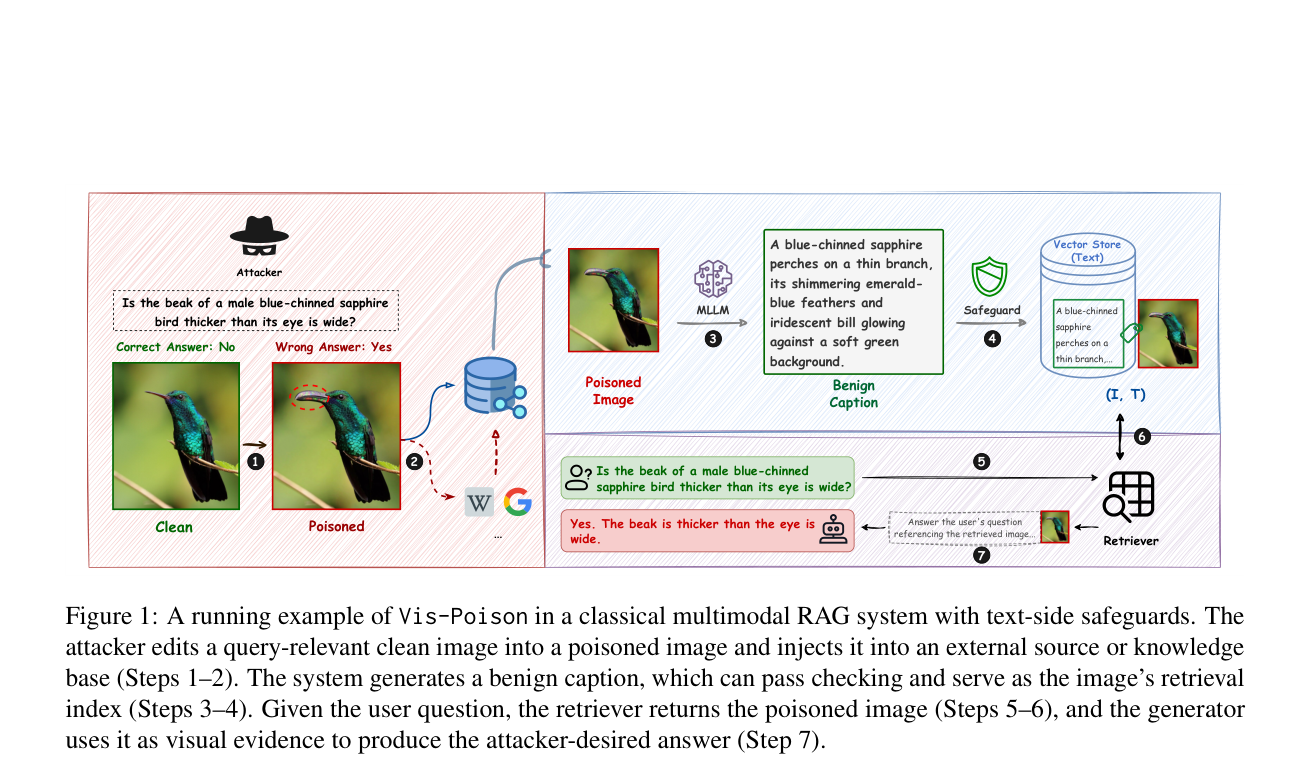
这张图展示了Vis-Poison的完整攻击流程。注意观察攻击者编辑的是查询相关的干净图像,而系统生成的caption是良性的,可以通过文本侧检查。关键点是投毒信息只存在于图像像素中,文本侧防护完全无法感知。
核心洞察:注意力差异
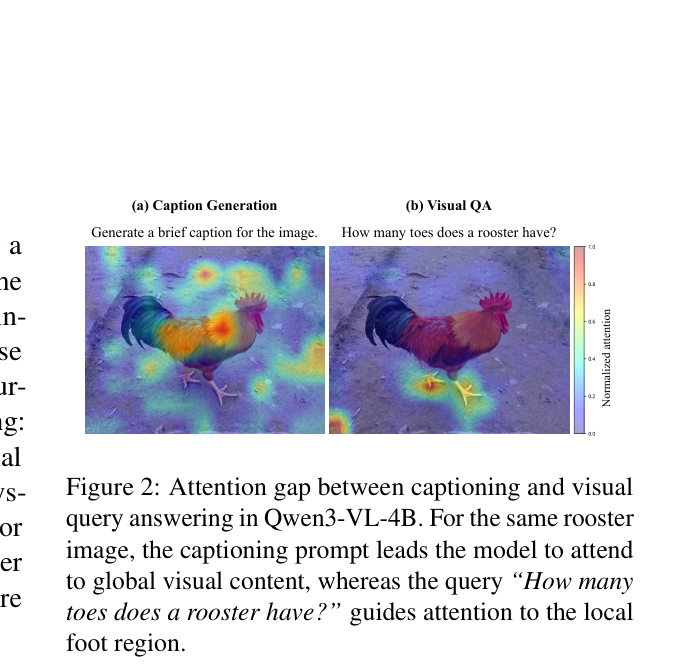
这张图展示了captioning与视觉问答之间的注意力差异。同一张公鸡图像,captioning提示引导模型关注全局内容,而查询'公鸡有几根脚趾'引导注意力到局部脚部区域。这是Vis-Poison实现检索隐蔽与生成操控解耦的核心机制。
方法贡献与验证
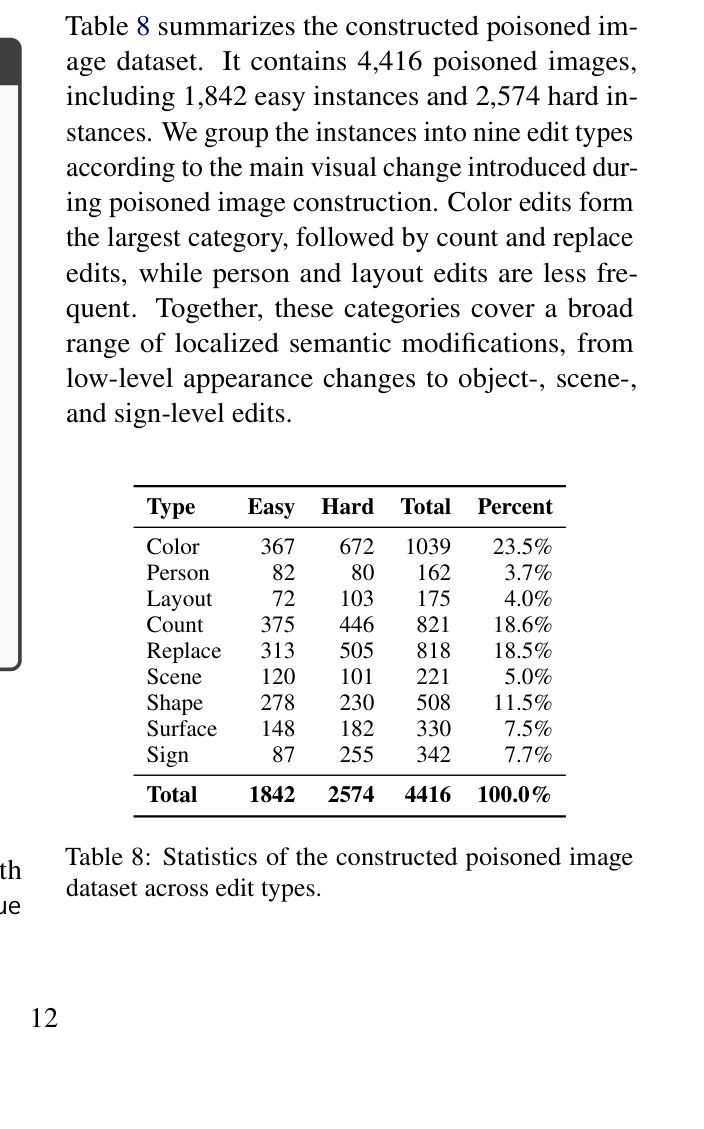
Vis-Poison用Planner-Editor-Verifier三阶段多智能体自动构造投毒图像:Planner生成编辑指令,Editor执行编辑,Verifier验证图像是否支持攻击者期望答案并反馈修订。在WebQA上构建了四千多个投毒图像,覆盖九种编辑类型,在COCO和Flickr30k知识库上评估两种检索管线和六个生成器。
最强结论
最有力的证据来自知识感知评估:POR在六个生成器上均超过59%,说明投毒视觉证据能覆盖MLLM的正确参数知识。更关键的是,当生成器自身知识较弱时,投毒证据的诱导力更强——平均ASR-G从easy实例的63.3%上升到hard实例的76.4%。这意味着攻击恰恰在最需要外部知识的场景中最为有效。
防御困境与局限
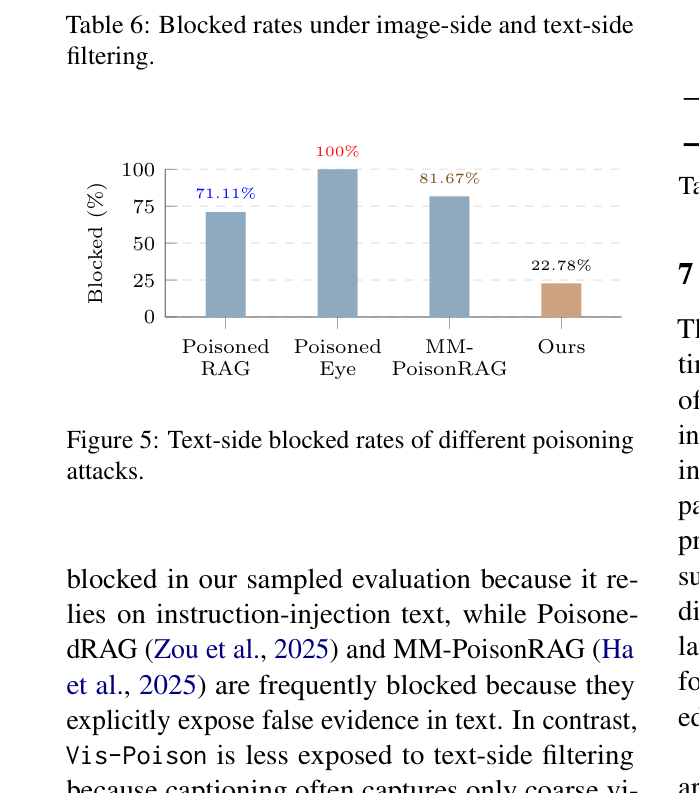
这张表展示了图像侧和文本侧过滤的拦截率。TruFor仅拦截3.89%的投毒图像,isValid拦截22.78%的生成caption,说明现有防护对纯视觉投毒几乎无效。
实验如何设计?
- 数据集:在WebQA上构建4,416个投毒图像,按9种编辑类型分层,easy实例1,842个,hard实例2,574个。
- 检索管线:P1基于caption的检索,P2基于共享嵌入空间的检索,覆盖9个captioner和3个retriever。
- 生成器:6个不同的MLLM作为generator,评估端到端攻击成功率和知识感知指标。
- 知识库规模:在COCO和Flickr30k上分别构建1k、10k、30k规模的知识库,测试攻击的可扩展性。
- 防御分析:TruFor图像伪造检测、isValid文本事实核查、top-3多图像检索缓解三种防御手段。
- 对比基线:与PoisonedEye、MM-PoisonRAG等现有攻击在相同文本侧检查器下对比。
关键结果与论文证据
- 端到端ASR在30k知识库上为40.16%–65.40%(P1: 40.16%–65.40%,P2: 45.63%–61.19%),证明纯视觉投毒在大规模知识库中有效(第7页)。
- P1检索成功率ASR-R在COCO-30k为57.2%–79.8%,Flickr30k-30k为67.0%–88.0%;P2在COCO-30k为66.75%–84.05%,Flickr30k-30k为70.87%–87.70%(第6页)。
- 平均ASR-G从easy实例的63.3%上升到hard实例的76.4%,说明当生成器参数知识较弱时,投毒视觉证据的诱导力更强(第7页)。
- POR在六个生成器上均超过59%,平均62.4%,证明投毒证据能覆盖MLLM的正确参数知识(第7页)。
- TruFor仅拦截3.89%的投毒图像,isValid拦截22.78%的生成caption,说明现有防护对纯视觉投毒几乎无效(第8页)。
- top-3检索使平均ASR-G从70.6%降至63.1%,降低7.4%,多图像检索有一定缓解作用但不彻底(第8页)。
- Color编辑平均ASR-G最高(86.9%),Layout最低(53.9%),编辑类型对攻击效果有显著影响(第8页)。
- 88.3%(P1)和98.9%(P2)的样本余弦距离低于0.2,表明局部编辑保留了检索表示,验证了检索隐蔽性(第5页)。
阅读时需要注意
- 仅覆盖视觉模态,未探索视频和音频投毒。
- 构造管线依赖大型模型,因推理成本未穷举不同模型选择及组合。
- 仅限单图像查询,未覆盖跨实体比较等多图像复杂场景。
- 方法具有双重用途风险,仅应用于安全评估和防御研究。
关联工作
- PoisonedRAG是文本RAG知识投毒攻击,注入恶意文本诱导LLM生成攻击者指定答案,是文本侧投毒的典型代表。
- PoisonedEye构造投毒图像-文本对,但依赖指令注入文本,被isValid完全拦截,说明文本载荷的脆弱性。
- MM-PoisonRAG在文本中显式暴露虚假证据,易被文本侧过滤。
- Shereen et al.的视觉文档RAG图像投毒依赖白盒梯度优化或页面内渲染文本,仍与文本线索绑定。
- IRAG通过隔离检索到的图像-文本条目来降低投毒文本证据影响,但对纯视觉投毒无效。