快速导读:提出首个面向在线视频问答中用户中断场景的基准OVIBench,定义三类中断并构建OVI-Train训练集,验证中断感知微调可显著提升模型性能。
OVIBench是首个面向在线视频问答中用户中断场景的基准测试。它不再假设模型在完整观看视频后一次性生成回答,而是模拟用户在模型生成过程中随时打断、纠正或发出无效信号的真实交互情境。论文的核心论点是:现有视频问答评测的离线单轮范式掩盖了模型在动态交互中的关键缺陷,而中断感知的评测与微调能够显著暴露并改善这些缺陷。
论文从五个公开视频数据集采集3200个视频,利用Qwen2.5-VL-32B生成问题与中断信号,构建开放域与多选题两种评测格式。通过离线模拟协议复现生成过程中的中断,并设计六维指标加分类准确率的评测体系。实验表明,主流模型在Cancellation上识别准确率接近100%,但在False Trigger上差异最大,而经过OVI-Train微调的7B模型在多选题评测中超越了72B同系列模型。
英文题目:OVIBench: Benchmarking Online Video Question Answering under Interruption
论文出处:arXiv 每日论文精选 · arXiv:2608.22279
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视频问答研究遵循离线单轮范式:模型接收完整视频后一次性生成回答。这种设定与真实交互存在根本性脱节。在实际的在线视频问答系统中,用户可能在模型生成回答的中途发起干预——终止当前回答、纠正语义方向、或发出与任务无关的信号。模型必须实时判断干预的性质并调整生成策略。
论文将中断分为三类:Cancellation表示用户明确终止当前回答;False Trigger表示不改变语义上下文的无效干预;Correction表示引入新语义约束要求修改回答。这三类中断对模型的要求截然不同:Cancellation要求立即停止,False Trigger要求忽略干扰继续生成,Correction要求整合新约束重新组织回答。
现有的视频评测基准如Video-MME、LVBench、StreamingBench、OVO-Bench等,虽然覆盖了离线理解、长视频推理、流式输入等维度,但均未涉及中断处理能力的评估。这一空白意味着,即使一个模型在离线基准上表现优异,它在真实交互中面对用户打断时可能完全失效。
论文指出的核心研究缺口是:缺乏一个系统化的框架来定义、模拟和评测在线视频问答中的中断处理能力。没有这样的框架,就无法量化模型的缺陷,也无法为改进提供明确的方向。
核心创新
- 首次形式化在线视频问答中的中断任务,定义Cancellation、False Trigger、Correction三类中断
- 提出离线模拟协议,在统一时间设定下复现生成过程中的中断,支持大规模可复现评测
- 设计六维互补指标(IAC/TFS/VES/IFA/CFS/CCS)全面评估中断理解与响应生成
- 构建OVI-Train中断感知微调数据集,7B微调模型超越72B同系列模型
方法概览
从五个公开数据集采集3200个视频,用Qwen2.5-VL-32B生成问题与中断信号,构建开放域与多选题两种评测格式;设计离线模拟协议复现生成过程中的中断;提出六维指标(IAC、TFS、VES、IFA、CFS、CCS)加中断类型分类准确率(CA)的评测体系;构建OVI-Train(20765条)对Qwen2.5-VL-7B进行LoRA微调。
- 数据构建:从五个公开数据集采集3200个视频,利用Qwen2.5-VL-32B进行场景分割、问题生成和中断信号插入。每个视频生成开放域与多选题两种格式的评测实例,中断类型覆盖Cancellation、False Trigger、Correction三类。
- 离线模拟协议:在统一时间设定下复现生成过程中的中断。模型自回归生成回答,在预设的中断点注入用户信号,模型需根据信号调整后续生成。该协议使大规模可复现评测成为可能,避免了真实在线系统的时间不确定性。
- 六维评测指标:Intent-Action Consistency(IAC)评估响应策略与识别意图是否一致;Textual Fluency Score(TFS)评估中断前后文本过渡的自然性;Visual Evidence Score(VES)评估响应与视频证据的一致性;Intent Fulfillment Accuracy(IFA)评估响应是否满足用户实际意图;Correction Following Score(CFS)评估纠正型中断后模型执行修正的程度;Contextual Consistency Score(CCS)评估中断前后内容层面的一致性。
- 分类准确率CA:单独评测模型对中断类型的识别能力,与响应质量指标解耦。这一设计使得研究者可以区分"模型识别了中断但响应不当"与"模型根本没有识别出中断"两种失败模式。
- Judge模型选择:在415条验证集上对比6个候选Judge模型与人工标注的MAE,选择与人类判断最一致的模型作为自动评分器。这一步骤保证了六维指标的可靠性。
- OVI-Train构建:共20765条训练实例,覆盖三类中断,用于对Qwen2.5-VL-7B进行LoRA微调。微调目标是让模型学会在生成过程中识别中断类型并调整响应策略。
逐图理解论文
研究缺口
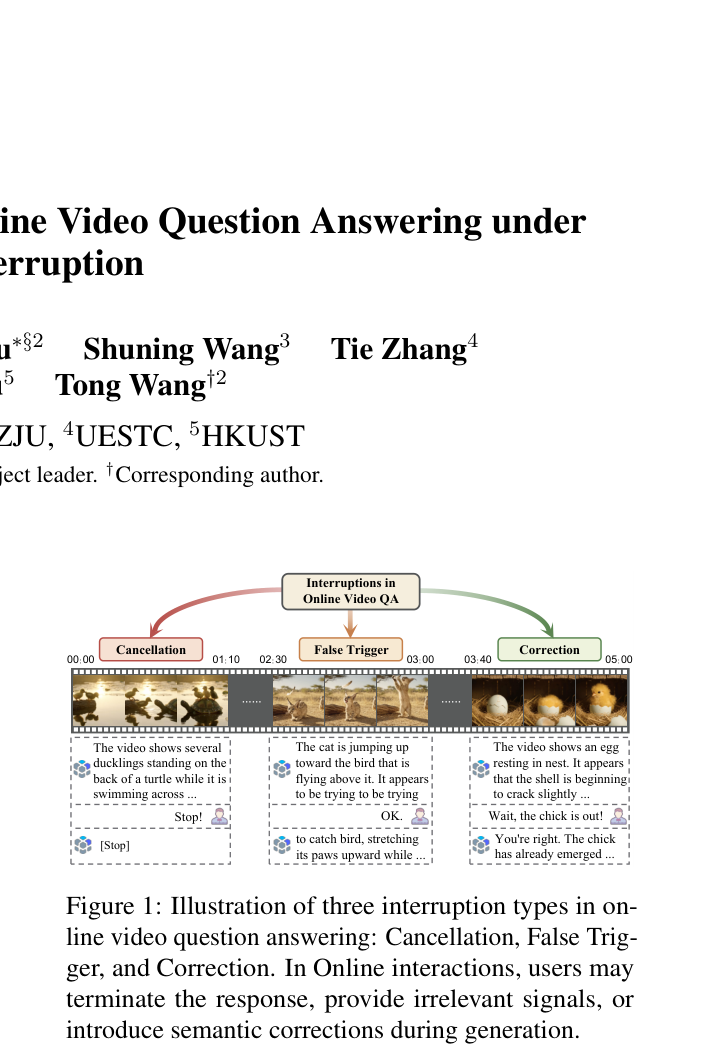
该图展示三类中断的直观对比:Cancellation中用户明确终止回答,False Trigger中用户发出无关信号,Correction中用户引入新的语义约束。观察此图可理解三类中断在交互时序上的本质差异。
论文贡献与验证
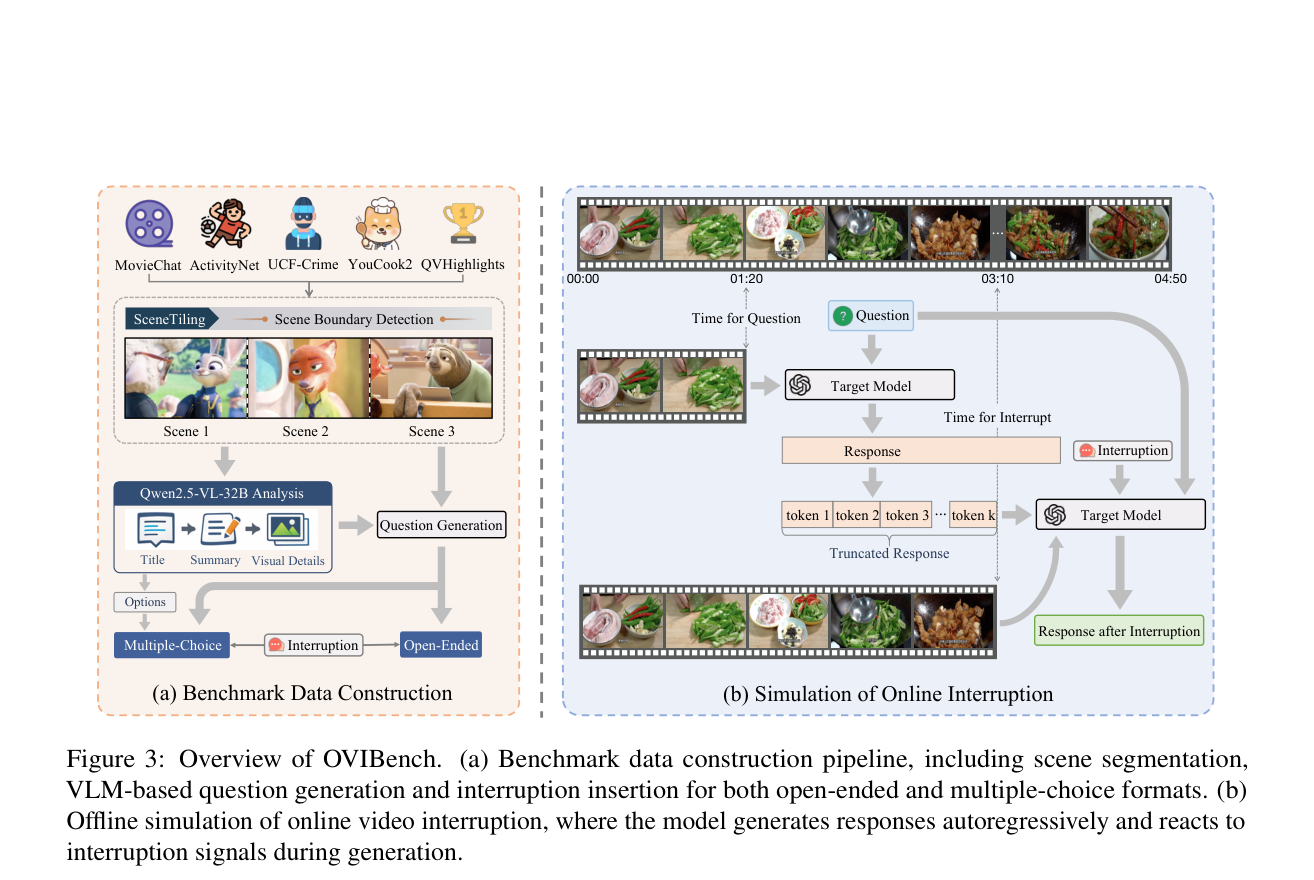
该图展示OVIBench的完整流程:上半部分为数据构建管线,包括场景分割、VLM生成问题和中断插入;下半部分为离线模拟协议,展示模型自回归生成过程中如何响应中断信号。
微调的关键证据
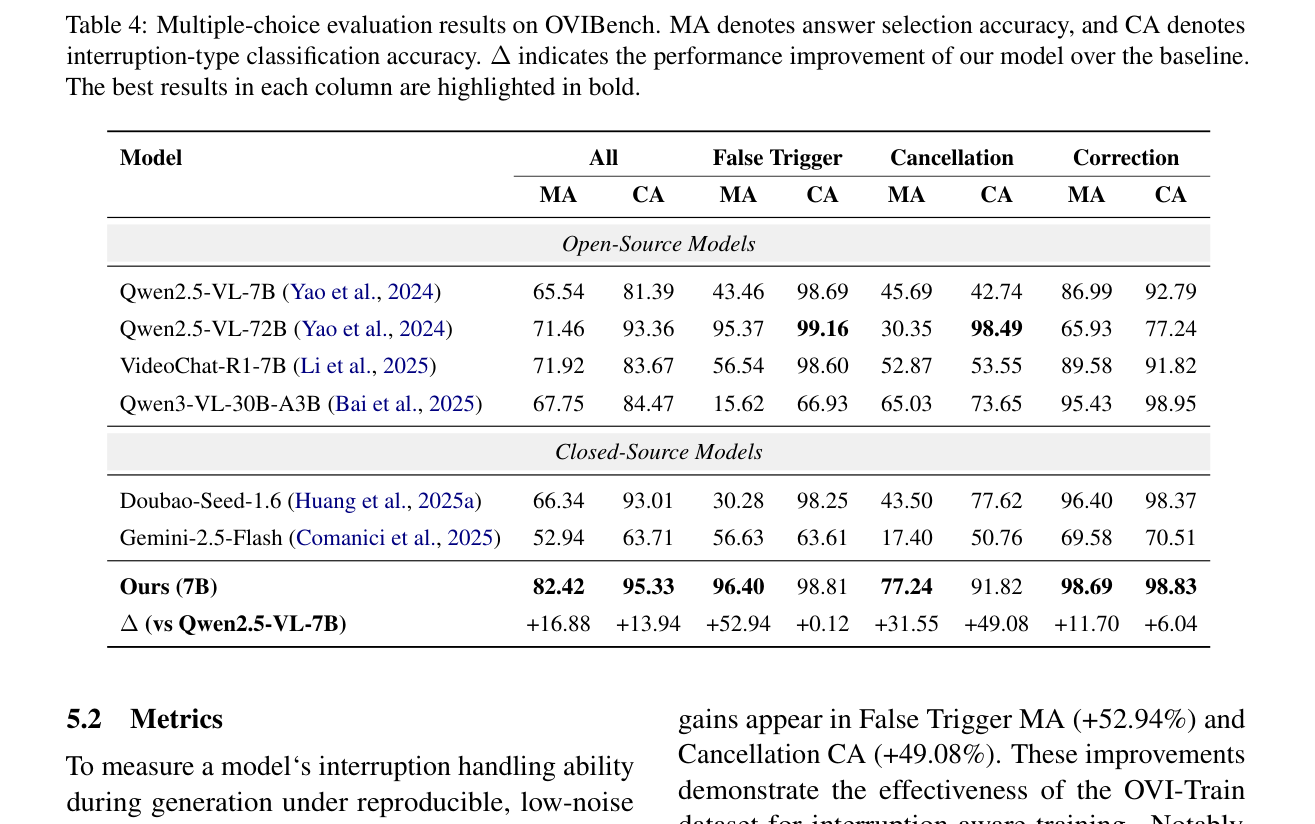
该表展示多选题评测结果,重点观察微调模型(带Δ标记)相对基线的提升幅度,以及7B微调模型与72B模型的对比。
实验如何设计?
- 开放域评测:7个主流VLM在OVIBench开放子集上对比六维指标与CA,覆盖开源与闭源模型。
- 多选题评测:微调模型与开源/闭源模型在MA和CA上的对比,评估中断感知微调的增益。
- 中断类型分类分析:三类中断的识别准确率对比,揭示不同中断类型的难度差异。
- 人类手写子集OVI-Human:在人工编写的中断实例上验证多选题评测结果,排除VLM生成数据的偏差。
- Judge模型验证:在415条验证集上与人工标注对比MAE,确保自动评分的可靠性。
关键结果与论文证据
- Cancellation识别准确率所有模型接近100%,说明显式终止信号极易识别(第6页)。
- False Trigger识别差异最大,小模型准确率明显偏低,说明区分无关干扰与有意义中断仍是核心难点(第6页)。
- Correction识别准确率约87%–92%,介于Cancellation与False Trigger之间,纠正意图可识别但比显式终止更模糊(第6页)。
- Doubao-Seed-1.6在开放域评测中综合最优,IAC达95.73%,CA达92.85%(第7页)。
- 微调后7B模型多选题MA为82.42%、CA为95.33%,较Qwen2.5-VL-7B基线提升+16.88%和+13.94%(第8页)。
- 微调模型在False Trigger上MA提升+52.94%,在Cancellation上CA提升+49.08%,说明中断感知微调对困难中断类型增益最大(第8页)。
- 微调7B模型超越Qwen2.5-VL-72B(MA 71.46%、CA 93.36%),表明针对中断的适配比单纯扩大模型规模更有效(第8页)。
- OVI-Train共20765条训练实例,其中QVHighlights来源最多(10845条),数据分布存在来源不均衡(第7页)。
阅读时需要注意
- 离线模拟协议无法完全复现真实在线系统的动态生成速度、网络延迟和用户输入时机,评测结果与真实部署存在差距。
- 仅覆盖三类中断,未涉及多轮追问、任务切换、混合意图等更复杂的交互场景。
- 数据构建依赖VLM生成,缺乏充分的人工标注和真实用户交互数据,生成偏差可能影响评测有效性。
- OVI-Train的泛化性未在更广泛模型架构、语言和真实语音/多用户交互场景中验证。
- 微调模型在Cancellation CA上提升仅+0.12%,接近天花板效应,说明该指标对微调不敏感。
关联工作
- Video-MME是离线视频理解综合评测基准,OVIBench在其基础上增加了中断维度,两者互补而非替代。
- StreamingBench关注流式视频输入下的推理一致性,但未涉及用户中断;OVIBench填补了这一空白。
- OVO-Bench强调渐进式观测与自适应推理,与OVIBench的在线交互理念相近,但OVIBench首次形式化了中断类型与评测协议。
- Talking Turns和Full-Duplex-Bench评测音频基础模型的轮次转换能力,OVIBench将类似理念扩展到视频问答领域。