快速导读:E2S-Pruner 将 Dempster–Shafer 证据理论引入视觉 token 剪枝,通过注意力头级可靠性建模、层级证据递归融合和空间新颖性正则,在无需训练的前提下实现视觉 token 的高效剪枝。
视觉语言模型(VLM)在推理时需要处理大量视觉 token,这些 token 数量远超文本 token,成为计算瓶颈。现有剪枝方法主要依赖注意力分数并直接聚合多头多层输出,但这种方式无法刻画证据的不确定性与冲突,导致互补证据被抑制、关键 token 被误剪。E2S-Pruner 将 Dempster–Shafer 证据理论引入视觉 token 剪枝,通过头级可靠性建模、层级证据递归融合和空间新颖性正则,在无需训练的前提下实现高效剪枝。
本文的核心论点是:视觉 token 剪枝本质上是一个多证据源决策问题,只有显式建模证据的可靠性、冲突与不确定性,才能在激进剪枝下保留真正关键的信息。E2S-Pruner 在 LLaVA-1.5-7B 和 Qwen2-VL-7B 上的实验验证了这一观点,在多个基准上取得了优于现有方法的聚合性能。
英文题目:E2S-Pruner: Progressive Two-Stage Evidence Fusion for Visual Token Pruning in Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2608.23253
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLM 推理中,视觉 token 数量远多于文本 token,是计算瓶颈。以 LLaVA-1.5-7B 为例,输入图像通常被切分为 576 个 patch token,而文本 token 往往只有几十个。这些视觉 token 在 LLM 的每一层都要参与自注意力计算,导致推理延迟和内存开销显著增加。
现有方法分为两类:相似度合并(如 ToME)和注意力分数剪枝(如 FastV)。ToME 通过合并相似 token 减少数量,FastV 则利用注意力分数在浅层一次性剪枝。但这些方法都直接聚合注意力分数,未显式建模证据可靠性、冲突与不确定性。
直接聚合的问题在于:不同注意力头、不同层对同一 token 的重要性判断可能相互矛盾。一个 token 可能在某个头中被认为重要,在另一个头中被认为不重要。直接平均或求和会掩盖这种冲突,导致互补证据被抑制,关键 token 被误剪。
Dempster–Shafer 证据理论为这一问题提供了自然的数学框架。它允许对假设集合分配信度,并显式表示不确定性。E2S-Pruner 将每个注意力头视为独立证据源,通过证据融合而非简单聚合来做出剪枝决策。
核心创新
- 首次将 Dempster–Shafer 证据理论引入 VLM 视觉 token 剪枝,显式建模多头证据的不确定性与冲突
- 定义注意力头级证据可靠性度量,综合决策清晰度与头间一致性构建层级 D–S 辨识框架
- 定义层间冲突度量并递归融合多层互补证据,利用 plausibility 与冲突联合确定保留优先级
- 提出空间新颖性正则约束,通过空间单元软奖励提升保留 token 的区域覆盖,防止局部集中
方法概览
E2S-Pruner 在浅、中、深三个 LLM 层执行三步剪枝。第一阶段将每个注意力头视为独立证据源,基于证据清晰度与头间一致性估计可靠性,为每个视觉 token 构建包含 important、unimportant、uncertain 三态的 D–S 辨识框架;第二阶段量化层间冲突并用 Dempster 规则递归融合多层证据,以 plausibility 和冲突联合定义保留优先级;最后引入空间新颖性约束,将图像划分为 G×G 空间单元,对每单元最高优先级 token 施加软奖励后做全局 Top-K 选择。
- E2S-Pruner 在浅、中、深三个 LLM 层执行三步剪枝。第一阶段将每个注意力头视为独立证据源,基于证据清晰度与头间一致性估计可靠性,为每个视觉 token 构建包含 important、unimportant、uncertain 三态的 D–S 辨识框架。
- 头级可靠性建模:清晰且一致的头响应获得高可靠性,模糊或冲突的响应贡献更大的不确定性。这一设计使得模型能够区分"确定重要"和"可能重要但不确定"的 token。
- 第二阶段量化层间冲突并用 Dempster 规则递归融合多层证据。不同层对同一 token 的判断可能存在冲突,Dempster 规则能够显式处理这种冲突,以 plausibility 和冲突联合定义保留优先级。
- 空间新颖性正则:将图像划分为 G×G 空间单元,对每单元最高优先级 token 施加软奖励后做全局 Top-K 选择。这一设计防止保留 token 过度集中在图像的某个区域,提升区域覆盖。
- 整个流程无需训练,只需在推理时计算注意力分数并进行证据融合,因此可以直接应用于现有的 VLM 模型。
- 与 SparseVLM 的渐进稀疏化不同,E2S-Pruner 的渐进性体现在证据融合的层级递归上,而非简单的预算分配。与 V2Drop 的表征变化剪枝不同,E2S-Pruner 关注的是证据层面的冲突与不确定性。
逐图理解论文
失败案例:直接聚合的陷阱
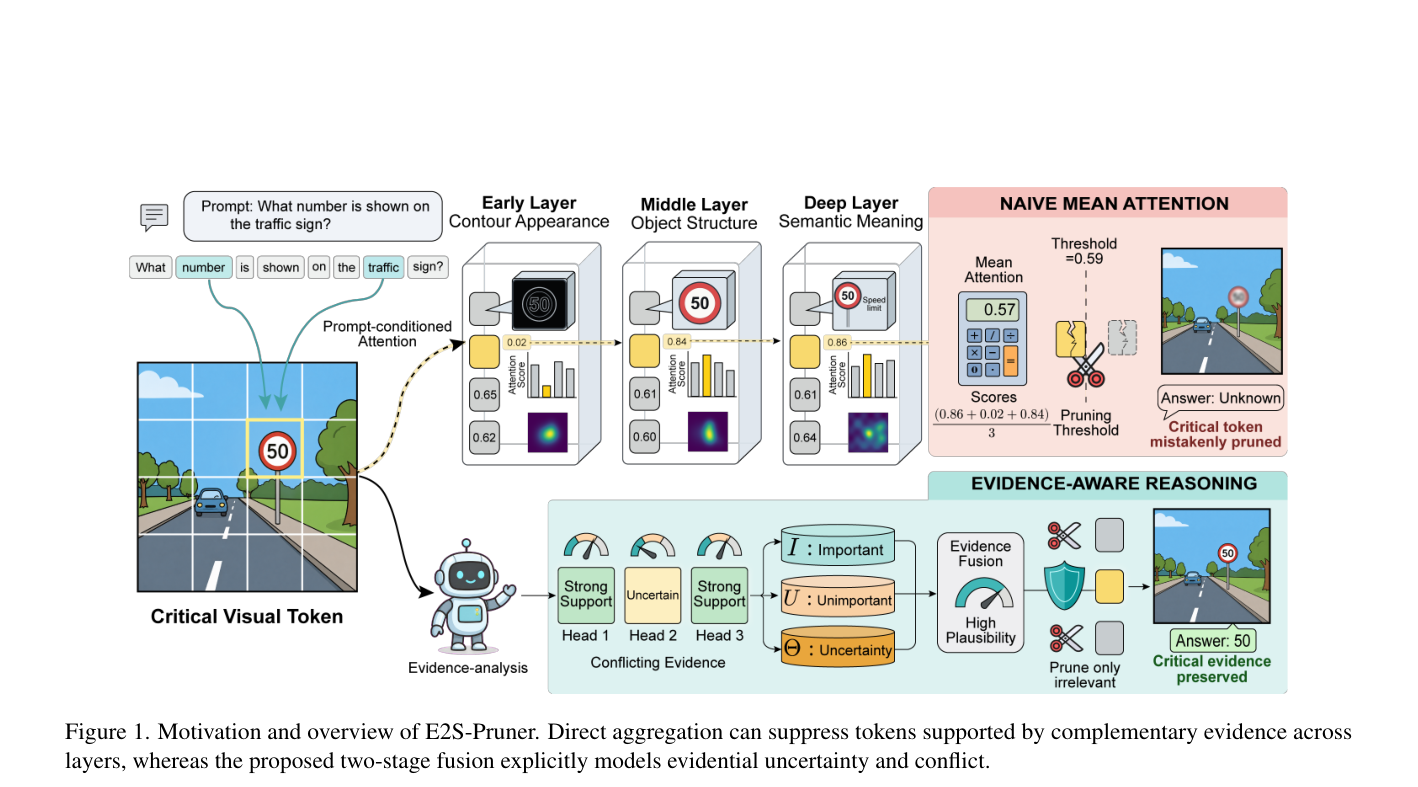
该图展示了 E2S-Pruner 的核心动机:直接聚合会抑制跨层互补证据支持的 token,而两阶段融合显式建模证据不确定性与冲突。观察左右对比可以理解为什么简单聚合会失败。
研究缺口:从聚合到证据推理
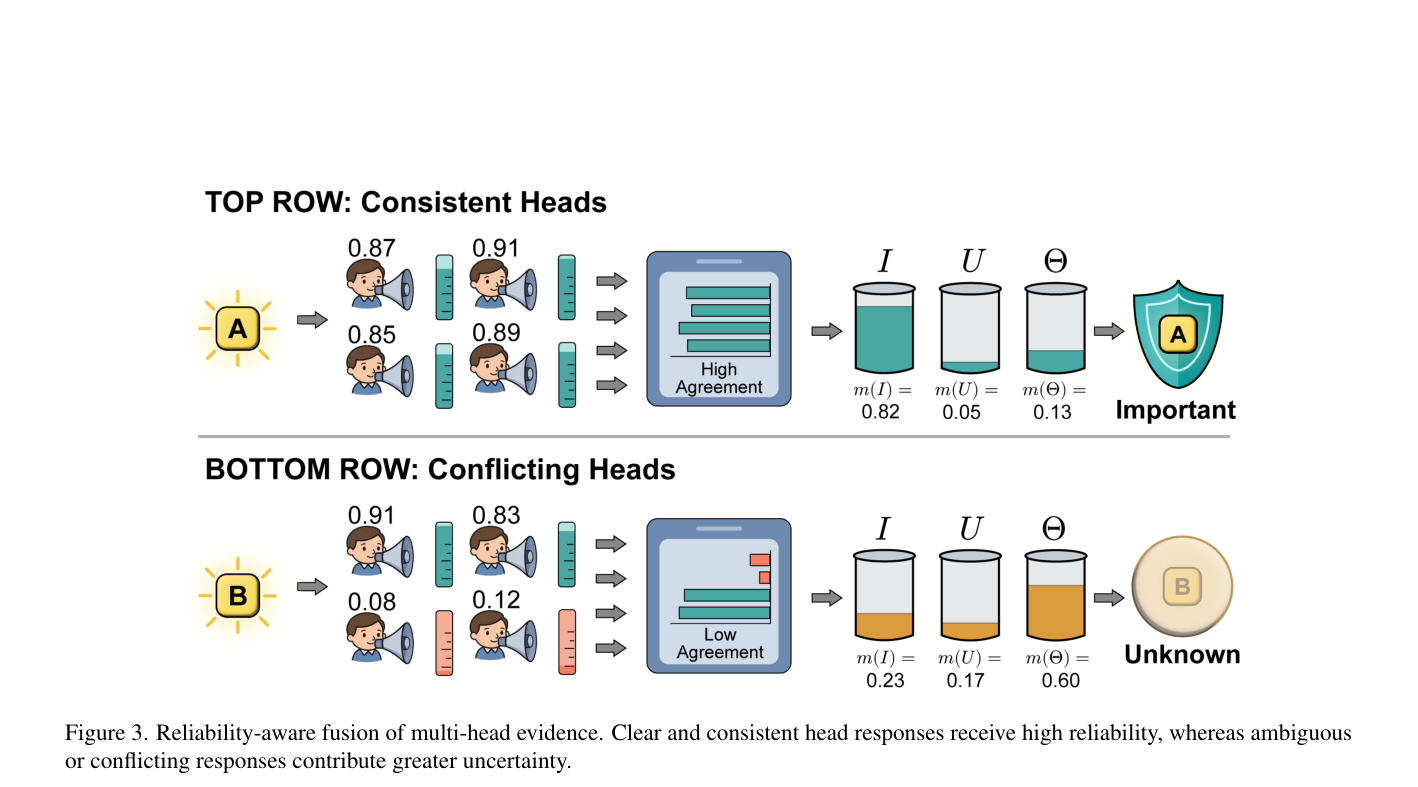
该图展示了头级可靠性融合机制:清晰且一致的头响应获得高可靠性,模糊或冲突的响应贡献更大不确定性。注意观察不同头的响应模式如何影响最终的证据分配。
验证与结论
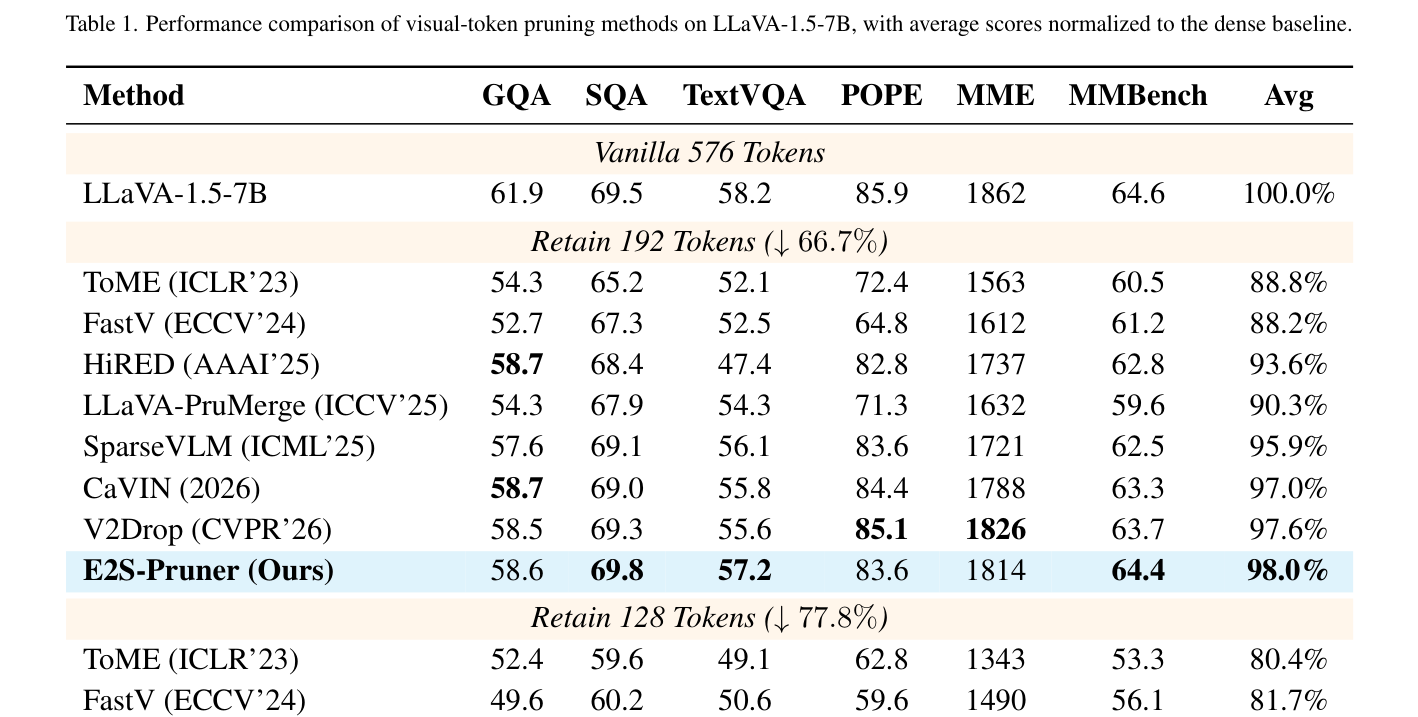
该表对比了 E2S-Pruner 与代表性方法在三种平均 token 预算下的性能。重点关注 64 token 预算下的聚合保留率,E2S-Pruner 的优势在极端剪枝下最为明显。
实验如何设计?
- 在 LLaVA-1.5-7B 上与 ToME、FastV、HiRED、LLaVA-PruMerge、SparseVLM、CaVIN、V2Drop 在 192/128/64 三种平均 token 预算下对比。
- 在 GQA、SQA、TextVQA、POPE、MME、MMBench 六个基准上评估,覆盖视觉问答、科学推理、场景文本识别、幻觉检测和多模态理解。
- 在 Qwen2-VL-7B 上以 66.7% 和 77.8% 两种 token 削减比例验证跨模型泛化。
- 消融实验验证完整证据推理、多头可靠性建模、跨层证据融合、冲突保护、空间新颖性约束各组件贡献。
- 分析五种不同 token 保留调度策略对性能的影响,确定最优的浅中深三层剪枝配置。
- 在 LLaVA-1.5-7B 上测量生成延迟、端到端延迟、GPU 峰值内存、吞吐量及 MMBench 精度。
关键结果与论文证据
- 在平均预算 192/128/64 token 时,E2S-Pruner 分别保留密集基线聚合性能的 98.0%、96.8%、90.6%,在所有预算下均取得最高聚合性能(Table 1,第 7 页)。
- 128 token 预算下相比 V2Drop 聚合保留率提升 2.8 个百分点,相比 SparseVLM 提升 3.6 个百分点(Table 1,第 7 页)。
- 64 token 预算下相比 V2Drop 和 SparseVLM 聚合保留率分别提升 3.7 和 4.1 个百分点,表明在极端剪枝下优势更明显(Table 1,第 7 页)。
- 128 token 预算下端到端延迟降低 48.5%,吞吐量达 10.37 items/s(1.96× 加速)(Table 4,第 11 页)。
- 64 token 预算下端到端延迟降低 51.5%,吞吐量达 11.02 items/s(2.09× 加速)(Table 4,第 11 页)。
- Qwen2-VL-7B 上 66.7% 和 77.8% 削减比例下分别保留 98.9% 和 95.4% 聚合性能,验证跨模型泛化(Table 5,第 12 页)。
- 消融实验中完整方法保留 97.7% 聚合性能,移除证据推理降至 92.9%,移除空间新颖性降至 96.3%,证明证据推理是核心贡献(Table 2,第 10 页)。
- 定性可视化显示 E2S-Pruner 在 TextVQA 场景中能保留包含文本的区域,而其他方法可能误剪这些关键 token(Figure 5,第 8 页)。
阅读时需要注意
- 证据融合与空间新颖性计算需要额外中间状态,GPU 峰值内存比密集基线高约 21%,实际部署需关注内存开销。
- 64 token 极端预算下 TextVQA 得分为 49.5,低于 LLaVA-PruMerge 的 54.0,细粒度场景文本区域易受信息损失。
- 论文中 Table 2 完整方法聚合保留率为 97.7%,与 Table 1 中 128 token 预算下的 96.8% 不一致,可能因消融实验采用不同评估子集或配置。
关联工作
- ToME 是基于特征相似度的 token 合并方法,是相似度合并类代表,但合并可能丢失空间信息。
- FastV 是基于注意力分数的单次浅层剪枝方法,是注意力剪枝类代表,但无法利用深层信息。
- LLaVA-PruMerge 利用视觉编码器 class-to-patch 注意力识别关键 token 并合并被移除 token,但依赖编码器而非 LLM 的注意力。
- HiRED 针对高分辨率输入,利用 class-token 注意力动态分配 token 预算,但未建模证据冲突。
- SparseVLM 利用 LLM 自注意力矩阵评分视觉 token,结合渐进稀疏化与动态预算分配,但直接聚合注意力分数。
- DART 通过测量候选 token 与 pivot token 间的冗余度保留互补信息,但未显式建模不确定性。
- V2Drop 根据相邻 LLM 层间表征变化渐进剪枝,优先移除变化缓慢的 token,但未处理多头证据冲突。
- CaVIN 从思维链数据中学习弱因果信号,恢复被常规剪枝丢弃的上下文 token,但需要额外训练数据。