快速导读:ParallelWorld 提出一种多步前瞻的测试时扩展框架,通过验证器引导的树搜索在可恢复模拟器中并行模拟多条未来轨迹,从而提升具身主动推理性能。
ParallelWorld 针对具身主动推理中的一个根本性局限提出解决方案:现有方法以贪心、单步前瞻的方式顺序生成探索轨迹,无法在行动前评估多条未来路径的潜在信息量。论文的核心主张是,通过在可恢复模拟器中并行模拟多条未来轨迹,并由验证器引导树搜索进行剪枝,智能体可以在承诺执行前获得对空间环境的更全面理解。
该框架的关键设计在于区分内部前瞻搜索与承诺执行:答案智能体仅在验证器排名第一的根到叶路径上推理,而非在整个搜索树上分散注意力。这一设计使得计算资源集中在物理一致的、最有希望的轨迹上,从而在 ESI-Bench 的 28 个子类别上一致超越单轨迹主动探索基线。
英文题目:ParallelWorld: Test-Time Scaling for Embodied Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2608.22971
原始论文:PDF / 论文页面
这篇论文解决什么问题?
具身推理正从静态感知转向主动探索。传统视觉问答假设智能体被动接收单张图像,但在真实场景中,关键信息往往被遮挡或需要从特定视角才能获取。主动探索方法允许智能体移动相机或操作物体来收集更多观测,但现有方法本质上仍是单轨迹顺序探索:基于当前观测选一个动作,执行,再观测,再选。
这种贪心策略的根本问题在于缺乏对延迟反馈的处理能力。在复杂遮挡空间中,一个动作的信息价值可能要到多步之后才能显现。如果智能体在第一步选择了低信息量的方向,它可能浪费大量探索步数却仍然无法定位关键线索。更严重的是,单步前瞻没有机制在行动前比较不同路径的潜在结果。
测试时扩展框架虽然在语言模型中已经出现,例如 Tree of Thoughts 和 Language Agent Tree Search,但这些方法在具身场景中仍然是短视的单步前瞻。它们没有利用模拟器的可恢复性来并行推演多步未来。ParallelWorld 填补的正是这个缺口:让智能体在承诺执行之前,先在模拟器中显式评估多条未来轨迹。
核心创新
- 提出多步前瞻的测试时扩展框架,使智能体在行动前并行模拟多条未来轨迹
- 引入验证器引导的树搜索机制,动态剪枝低信息量分支并优先保留高信息增益路径
- 设计交替扩展-收敛的分支宽度调度策略,平衡轨迹多样性与搜索集中度
- 区分内部前瞻搜索与承诺执行,答案智能体仅基于物理一致的 top-1 根到叶路径推理
方法概览
ParallelWorld 从可恢复模拟器状态出发,对每个保留分支枚举可执行相机与物理动作并渲染未来观测;验证器智能体评估候选分支并按预定义分支宽度调度(奇数步保留多分支、偶数步收敛至单分支)进行剪枝;被选状态重放后进入下一轮扩展;答案智能体仅在验证器排名第一的根到叶路径上推理,当置信度超过阈值或探索预算耗尽时终止。
- 前瞻性世界扩展:从可恢复的模拟器状态出发,对每个保留分支枚举所有可执行的相机动作和物理动作,渲染出对应的未来观测。这一步将单步前瞻扩展为多步并行推演。
- 验证器引导的树搜索:一个验证器智能体评估每个候选世界的潜在信息增益,对候选分支进行排序。验证器的判断依据是候选世界是否可能揭示与问题相关的隐藏信息。
- 分支宽度调度策略:采用交替扩展-收敛的调度——奇数步保留多个分支以维持轨迹多样性,偶数步收敛到单一分支以集中搜索资源。这一设计避免了固定分支宽度在探索后期浪费计算的问题。
- top-1 根到叶路径推理:答案智能体不在搜索树的所有节点上推理,而只在验证器排名第一的根到叶路径上推理。这确保了答案基于物理一致的轨迹,而非搜索树中可能相互矛盾的多个分支。
- 置信度驱动的终止机制:答案智能体在每个检查点输出答案和置信度,当置信度超过阈值或探索预算耗尽时终止探索。这一机制避免了不必要的额外探索。
- 内部搜索与承诺执行的分离:前瞻搜索在模拟器中进行,不改变真实环境状态;只有被选中的轨迹才会被重放执行。这一分离使得智能体可以安全地探索高风险路径。
逐图理解论文
失败案例:贪心探索的盲区
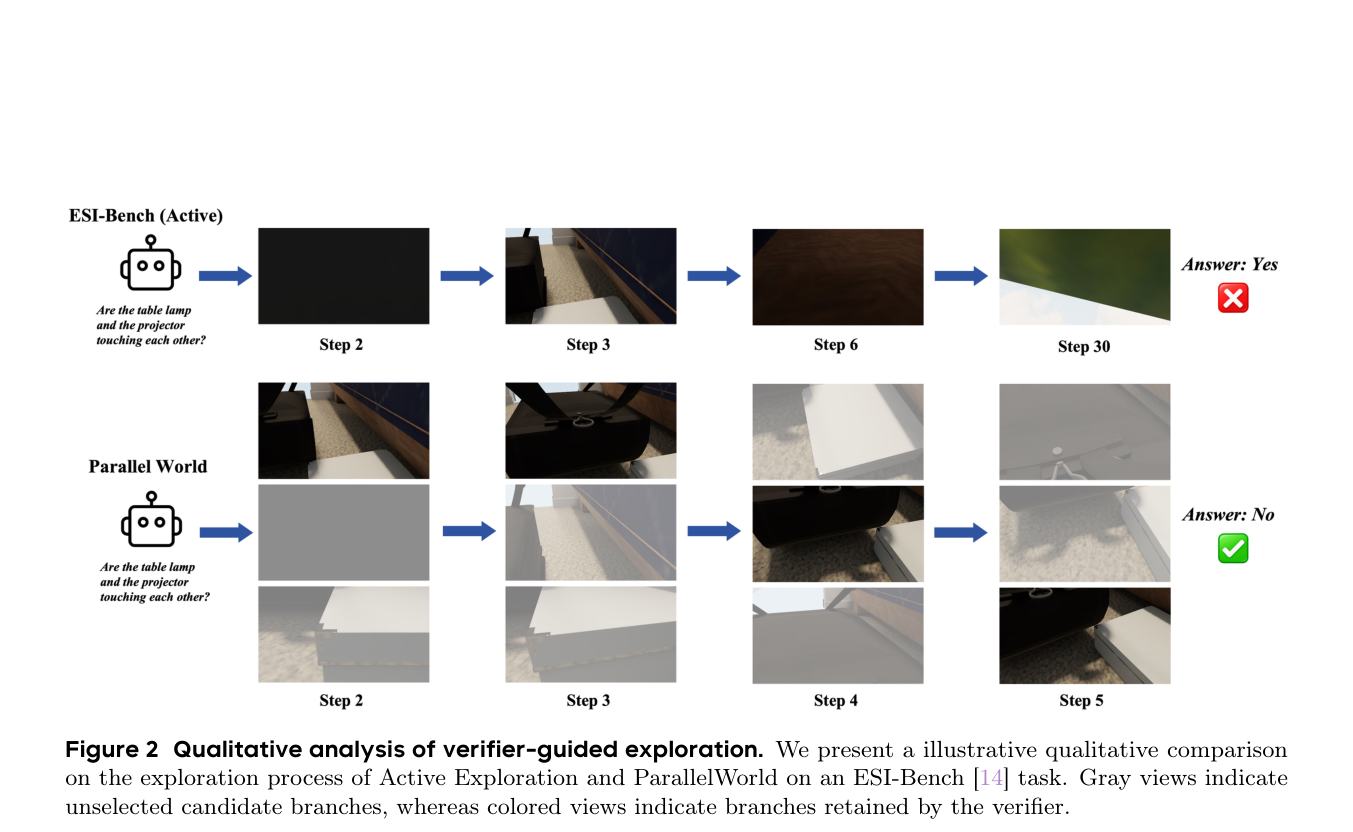
图 2 定性对比了 Active Exploration 和 ParallelWorld 的探索轨迹。灰色视图表示未被选中的候选分支,彩色视图表示被验证器保留的分支。观察 ParallelWorld 如何主动保留朝向遮挡区域的相机轨迹,而基线方法则沿着低信息量路径徘徊。
研究缺口:单步前瞻 vs 多步推演
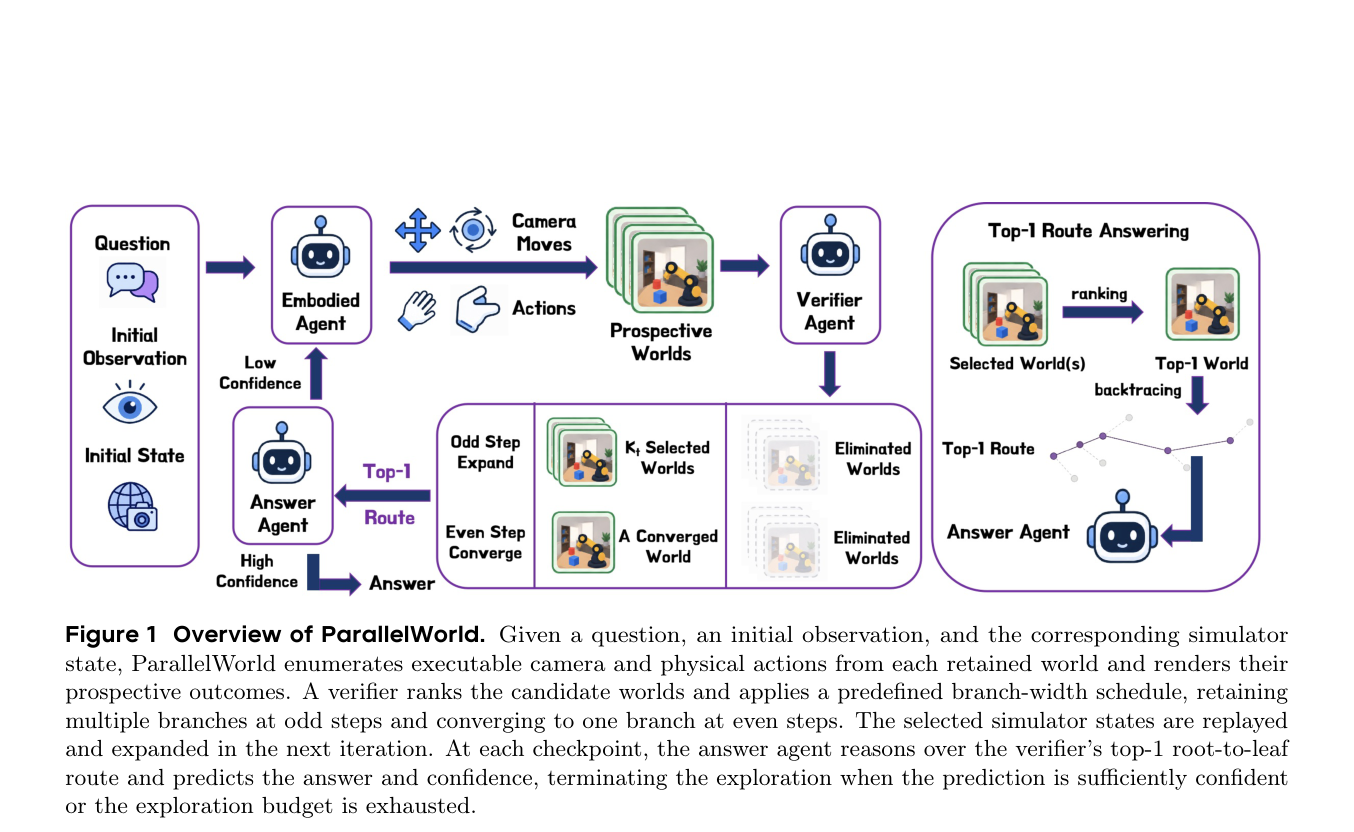
图 1 展示了 ParallelWorld 的完整流程:从初始观测和模拟器状态出发,枚举可执行动作并渲染未来观测,验证器排序后按分支宽度调度剪枝,被选状态重放进入下一轮。重点观察奇数步和偶数步的分支数量变化,这体现了交替扩展-收敛的调度策略。
Table 1 Quantitative results on ESI-Bench [14]
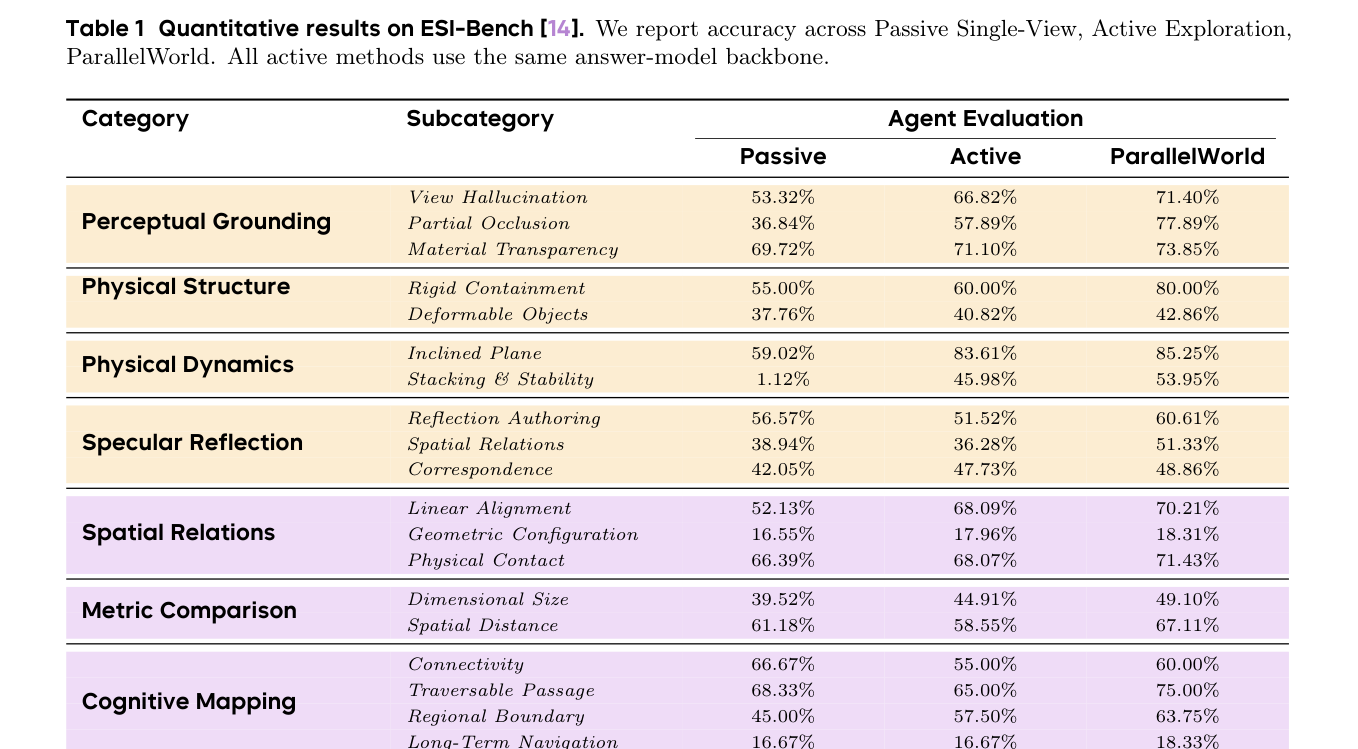
表 1 报告了 ESI-Bench 28 个子类别上的准确率对比。关注 Passive Single-View、Active Exploration 和 ParallelWorld 三列之间的差距,特别是在遮挡和时间理解类子类别上的提升幅度。
实验如何设计?
- 在 ESI-Bench 的 28 个子类别上评估,对比三种设置:Passive Single-View(被动单视图)、Active Exploration(主动探索基线)和 ParallelWorld。所有主动方法使用相同的答案模型骨干。
- 定性分析通过图 2 展示验证器引导探索过程,对比 Active Exploration 和 ParallelWorld 在同一任务上的探索轨迹。灰色视图表示未被选中的候选分支,彩色视图表示被验证器保留的分支。
- 消融实验比较固定分支宽度 K=2、K=3、K=4 与预定义 K 调度策略,报告准确率、平均运行时间和平均探索步数。所有配置使用相同的答案模型、最大探索深度和停止阈值。
- 论文使用 GPT-5.4 和 GPT-5.5 作为答案与验证器智能体。需要注意的是,这些模型版本在公开文献中尚未广泛验证,读者在解读结果时应保持谨慎。
关键结果与论文证据
- ParallelWorld 在 Unobserved Change 子类别上准确率从 Active Exploration 的 70.95% 提升至 89.86%(第 8 页),这是所有子类别中提升幅度最大的,表明多步前瞻对延迟反馈场景特别有效。
- 在 Spatial Distance 子类别上,准确率从 58.55% 提升至 67.11%(第 8 页),说明并行推演有助于度量比较类任务。
- 在 Rigid Containment 上,准确率从 60.00% 提升至 80.00%(第 7 页),在 Partial Occlusion 上从 57.89% 提升至 77.89%(第 7 页),表明遮挡场景是多步前瞻的主要受益场景。
- 消融实验显示 K Schedule 平均准确率为 59.56%,优于 K=2 的 55.52%、K=3 的 50.72% 和 K=4 的 51.87%(第 9 页)。这说明盲目增加分支数量反而有害,关键在于调度策略。
- K Schedule 的平均运行时间为 350.6 秒/问题,低于 K=2 的 590.8 秒、K=3 的 668.7 秒和 K=4 的 613.5 秒(第 9 页)。交替收敛策略在提升准确率的同时降低了计算开销。
- 定性分析显示,ParallelWorld 的验证器会主动保留朝向遮挡区域的相机轨迹,而 Active Exploration 则沿着低信息量的路径徘徊(第 8 页,图 2)。
- K Schedule 并非在所有子类别上优于固定宽度设置。在 Regional Boundary 子类别上,K=2 和 K=3 的表现更优(第 9 页),说明调度策略的最优形式可能依赖于任务类型。
- Liquid Volume 子类别因环境问题被排除在评估之外,完整 ESI-Bench 为 29 个子类别而非 28 个(第 7 页)。这一排除可能影响对框架泛化能力的全面评估。
阅读时需要注意
- 测试时计算开销大:每个保留世界都需要在完整动作空间上扩展,这意味着计算成本随分支宽度线性增长。尽管 K Schedule 降低了平均运行时间,但绝对开销仍然显著高于单轨迹方法。
- 探索质量依赖模拟器保真度:如果模拟器的渲染或物理模型与真实环境存在偏差,前瞻推演的结果可能误导验证器和答案智能体。
- 验证器可靠性是瓶颈:如果验证器错误地剪枝了包含关键信息的分支,后续探索将无法恢复。论文没有系统评估验证器失败的模式。
- 仅保留被选轨迹可能丢弃互补证据:来自替代分支的信息可能对答案推理有补充价值,但当前框架只使用 top-1 路径。
- 模型版本未广泛验证:GPT-5.4 和 GPT-5.5 在公开文献中缺乏独立的性能基准,结果的可复现性和可比性受到影响。
关联工作
- ESI-Bench 是用于衡量具身空间智能主动探索能力的评估基准,包含 29 个子类别,覆盖遮挡、度量比较、时间理解等多种空间推理任务。
- Explore until Confident 属于置信度感知的主动探索方法,采用单轨迹顺序探索范式,是 ParallelWorld 的直接对比基线。
- MindJourney 使用世界模型进行空间推理的测试时扩展,与 ParallelWorld 共享前瞻模拟的思想,但未采用验证器引导的树搜索。
- Language Agent Tree Search 将语言模型推理与环境反馈结合进行动作级树搜索,是测试时扩展在具身场景的早期尝试。
- Tree of Thoughts 通过结构化搜索实现语言模型的深思熟虑问题求解,为 ParallelWorld 的树搜索设计提供了概念基础。
- ω-EVA 使用潜在交互世界模型进行设想-验证-行动,与 ParallelWorld 的验证器引导机制有相似之处,但 ParallelWorld 的贡献在于显式的多步前瞻和分支宽度调度。