快速导读:Luce提出一种体素化多模态PBR高斯表示,通过结构化潜在VAE与rectified-flow transformer从单张图像联合生成几何与材质,输出可重光照的PBR高斯和带切线空间法线贴图的纹理网格。
Luce解决的核心问题是:单张图像生成3D资产时,如何让输出既能在标准渲染管线中重光照,又不丢失高频表面细节。现有方法要么把光照烘焙进表示(如TRELLIS系列),要么缺乏显式PBR材质分解(如LiTo用球谐函数),导致生成的资产无法在游戏引擎或DCC工具中直接使用。
Luce的答案是改变表示本身:把PBR材质分解(albedo、metallic-roughness、normals)直接编码到高斯原语上,每个占用体素携带三组独立高斯,共享同一体素结构。这个表示经SLatVAE压缩为紧凑潜在,再由SLatFlow以多层DINOv2特征为条件生成,最终解码为可重光照的PBR高斯,或经FlexiCubes提取网格并烘焙切线空间法线贴图。
英文题目:LUCE: RELIGHTABLE GAUSSIANS FOR 3D ASSET GENERATION
论文出处:arXiv 每日论文精选 · arXiv:2608.23943
原始论文:PDF / 论文页面
这篇论文解决什么问题?
3D表示的选择决定了生成模型的上限。3D Gaussian Splatting渲染高效,但通常把光照烘焙进高斯参数,换环境光照后外观不变,无法重光照。TRELLIS系列采用结构化潜在,生成质量高,但材质能力有限,输出是烘焙外观的网格。LiTo用球谐函数做表面光场tokenization,无法分解出albedo或metallic-roughness。
另一个被忽视的问题是高频表面细节。文字、logo、标签这类细节在生成过程中容易被模糊或扭曲,因为条件编码器通常只取深层语义特征,丢失了浅层空间信息。Luce的消融实验显示,单层DINOv2条件(layer 24)与多层条件(layers 6,12,18,24)在文字保真度上有显著差距。
因此研究缺口是双重的:一是缺乏把PBR材质分解与高效生成表示结合的方法,二是条件编码方式不足以保留高频空间细节。Luce同时针对这两点。
核心创新
- 多模态PBR高斯表示:albedo、metallic-roughness、normals三组独立高斯共享体素结构,支持deferred shading重光照
- SLatVAE:将多模态高斯云压缩为紧凑可扩散潜在,解码器以分辨率换密度(K=8→K'=32)
- 多层DINOv2条件(layers 6,12,18,24):融合浅层空间细节与深层语义,显著提升文字/logo保真度
- 切线空间法线贴图迁移:将解码的法线高斯烘焙到网格UV上,零多边形成本恢复亚体素表面细节
方法概览
Luce将每个占用体素赋予三组独立高斯(albedo、metallic-roughness、normals),经SLatVAE压缩为紧凑潜在;生成时先用TRELLIS 2的稀疏结构flow预测体素布局,再由SLatFlow(DiT,多层DINOv2特征条件)生成每体素PBR高斯潜在;解码为可重光照PBR高斯,或经FlexiCubes提取网格并烘焙切线空间法线贴图。
- 表示设计:每个占用体素赋予三组独立高斯,分别编码albedo、metallic-roughness、normals。三组高斯共享体素结构,但参数独立,渲染时用Cook-Torrance BRDF和split-sum image-based lighting做deferred shading,实现任意环境光照下的PBR着色。
- SLatVAE:编码器把稀疏多模态高斯云压缩为紧凑潜在网格,解码器以分辨率换密度(K=8→K'=32),从每个潜在体素解码出更密集的高斯。训练通过逐模态可微渲染监督。
- 生成流程分两阶段:先用TRELLIS 2的稀疏结构flow预测体素布局,再由SLatFlow(rectified-flow transformer)以多层DINOv2特征为条件生成每体素PBR高斯潜在。
- 多层DINOv2条件:融合layers 6,12,18,24的特征,浅层保留空间细节,深层提供语义,显著提升文字/logo保真度。
- 网格导出:同一潜在输入mesh decoder,经FlexiCubes提取网格,并把解码的法线高斯烘焙到网格UV上,得到切线空间法线贴图,零多边形成本恢复亚体素表面细节。
- 推理路径:GS路径直接渲染解码的PBR高斯,mesh路径输出带完整PBR材质集的纹理网格。
逐图理解论文
失败案例
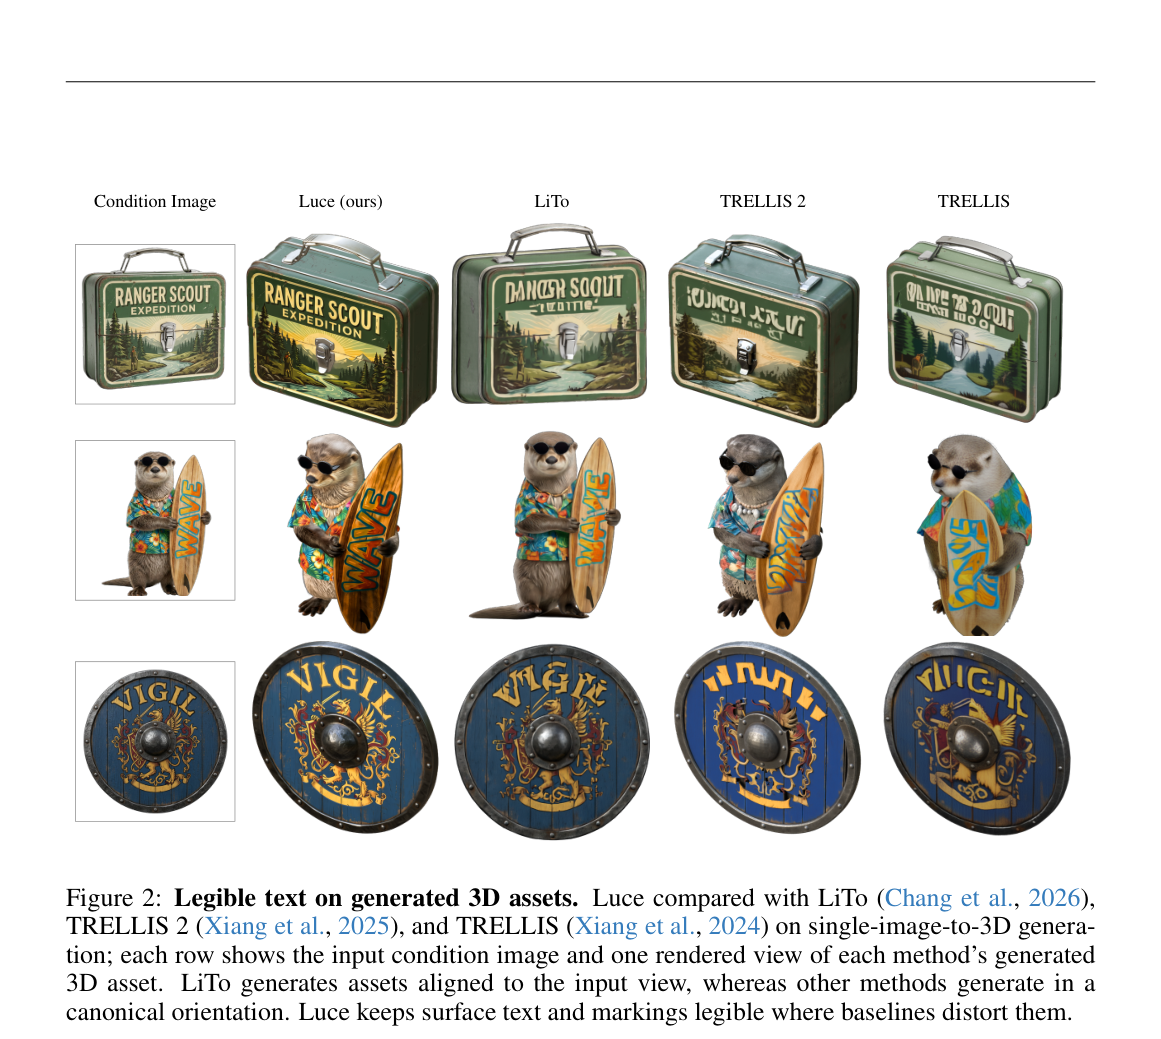
先看一个具体失败。给模型一张带文字标签的物体图,TRELLIS和LiTo生成的资产上,文字要么模糊要么扭曲。原因在于,TRELLIS把光照直接烘焙进表示,换环境光后外观不变;LiTo用球谐函数编码表面光场,根本分解不出albedo和metallic-roughness。文字这类高频细节,恰恰是烘焙和光场表示最先丢失的东西。
研究缺口
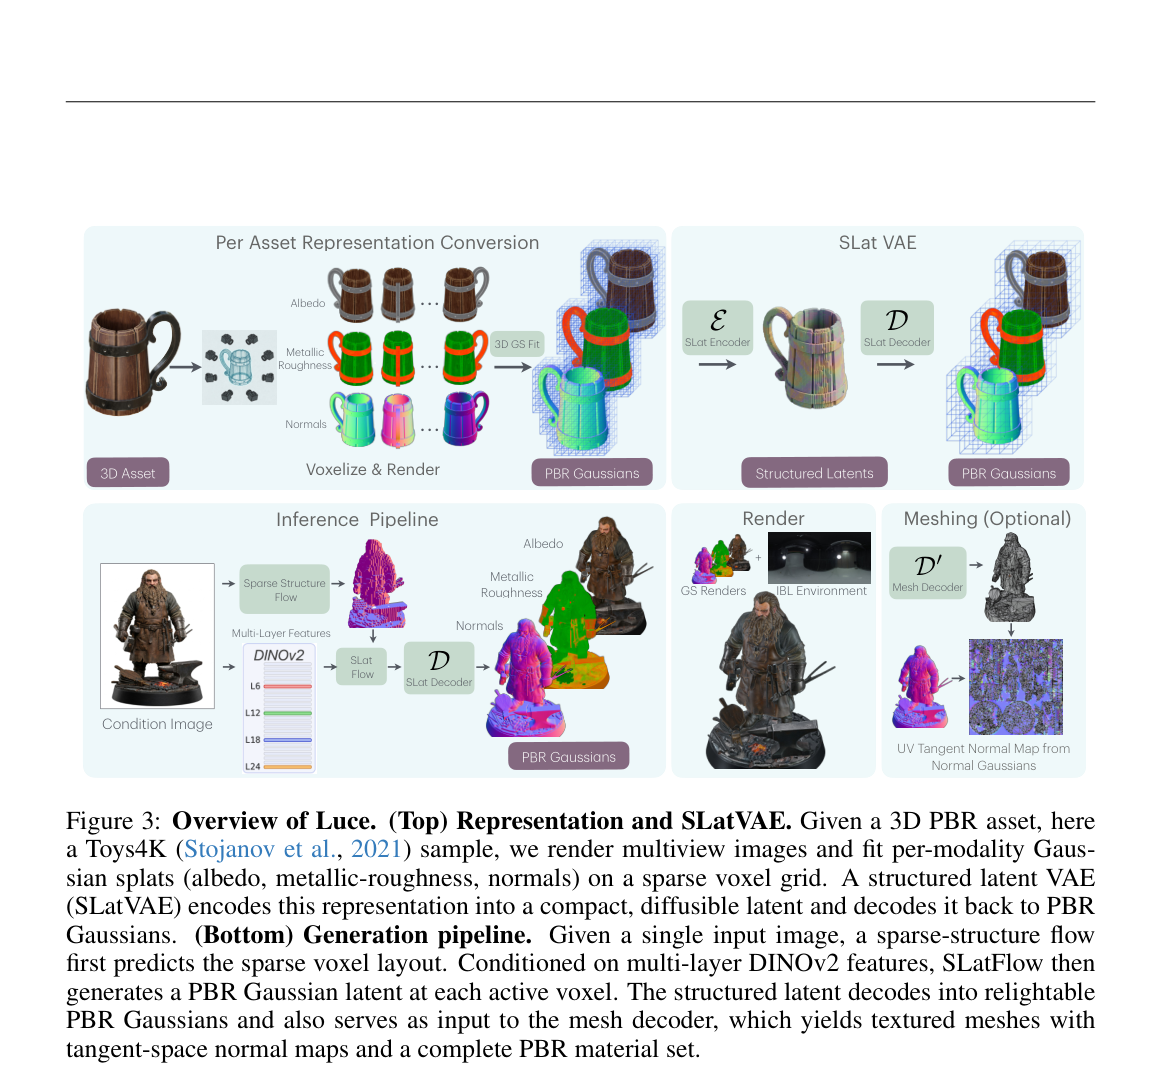
上半部分展示SLatVAE如何把多模态高斯云压缩为潜在并解码;下半部分展示两阶段生成流程。注意结构flow与SLatFlow的分工,以及mesh decoder与GS路径共享同一潜在。
验证与证据
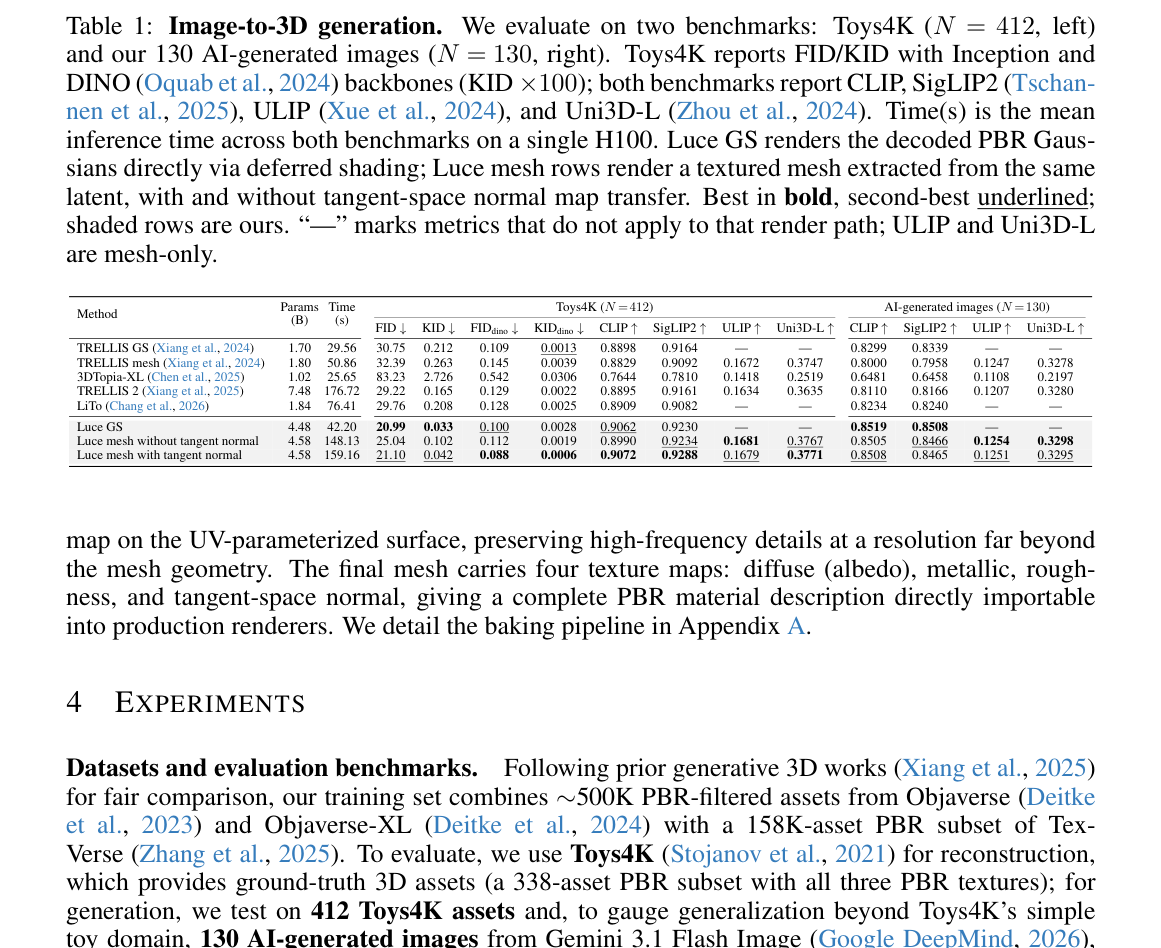
生成质量对比表。注意Luce GS与Luce mesh两行,以及ULIP/Uni3D-L仅适用于mesh路径的标注。
实验如何设计?
- Toys4K生成基准(N=412):报告FID/KID(Inception与DINO backbone)、CLIP、SigLIP2、ULIP、Uni3D-L。
- AI生成图像基准(N=130,Gemini 3.1 Flash Image):报告CLIP、SigLIP2、ULIP、Uni3D-L。
- Toys4K PBR子集重建(N=338):逐模态报告PSNR/SSIM/LPIPS,覆盖color、albedo、metallic-roughness、normal。
- 消融:单层vs多层DINOv2条件;有无切线空间法线贴图烘焙。
- 定性对比:与Blender EEVEE的PBR渲染对比,验证deferred PBR渲染器的正确性。
关键结果与论文证据
- Toys4K FID 20.99(Luce GS),较TRELLIS 2的29.22提升8.23(第7页)。
- AI生成图像CLIP 0.8519(Luce GS),超过TRELLIS GS的0.8299(第7页)。
- AI生成图像SigLIP2 0.8508(Luce GS),超过TRELLIS GS的0.8339(第7页)。
- 重建color PSNR 36.1 dB(Luce GS),超过TRELLIS 2的34.5 dB(第9页)。
- 重建normal PSNR 34.6 dB(Luce GS),超过TRELLIS 2的32.1 dB(第9页)。
- 切线法线烘焙使mesh normal PSNR从29.5提升至33.0 dB(第9页)。
- 多层DINOv2条件:Toys4K FID 20.99 vs 单层25.21;AI图像CLIP 0.8519 vs 0.8081(第18页)。
- 推理时间:GS路径约42s,mesh路径约148-159s(单H100,第7页)。
阅读时需要注意
- 有限分辨率体素化表示:相对整体尺寸过细的细节可能欠分辨。
- 材质模型仅覆盖标准PBR属性,不支持次表面散射、各向异性、半透明、薄膜干涉等复杂效果。
- 网格导出依赖FlexiCubes,UV提取质量有提升空间。
- 仅面向物体中心资产,未扩展到场景级生成。
- Toys4K条件视图光照与评估光照不同,烘焙外观方法与PBR方法比较存在系统性偏差。
关联工作
- TRELLIS(Xiang et al., 2024):结构化潜在3D生成范式与structure-then-latent两阶段流程的来源,Luce沿用其FlexiCubes网格解码器。
- TRELLIS 2(Xiang et al., 2025):Luce直接复用其稀疏结构VAE与flow,同为PBR完整输出的最强基线。
- LiTo(Chang et al., 2026):表面光场tokenization基线,用球谐函数无法分解材质,Luce在文字保真度上对比。
- 3D Gaussian Splatting:Luce的高斯参数化与alpha合成渲染基础,但去除球谐函数改用PBR解析着色。
- DINOv2:图像条件编码器,Luce创新性地融合多层特征(6,12,18,24)。