快速导读:提出 DoublesEval 诊断框架,以职业羽毛球双打为测试平台,通过关键帧分层探针定位 VLM 在多智能体战术推理中的失效点,并提出无需训练的测试时一致性检查器 TacticCheck。
DoublesEval 是一篇针对视觉语言模型(VLM)多智能体战术推理能力的诊断性研究。作者选择职业羽毛球双打作为测试平台,因为该场景天然包含四名球员、严格边界场地、快速角色转换和密集因果链,是结构可控的多智能体交互环境。论文的核心主张是:现有 VLM 视频评测基准主要关注单智能体动作识别或全局事件分类,无法暴露多智能体场景中角色归属、空间覆盖和跨事件因果推理等结构化推理失败。
DoublesEval 从 4 场 BWF 职业双打比赛中精选 60 个回合,以得分窗口为锚点,将每个回合分解为战术关键片段,构建四个诊断维度(L1 原子识别、L2 段内复合理解、L3 跨段因果推理、L4 战术抽象)的成对 SCQ/SAQ 问题,共约 9.6K 实例。评估采用两阶段流程:VLM 零样本推理加 GPT-5 标签映射裁判。此外,论文提出 TacticCheck,利用模型自身的 L1 预测构建战术检查清单,通过模式级一致性惩罚对高层候选答案重排序,无需参数更新和真值标签。
英文题目:DoublesEval: Diagnosing Multi-Agent Tactical Reasoning in Vision-Language Models via Professional Doubles Badminton
论文出处:arXiv 每日论文精选 · arXiv:2608.24439
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有 VLM 视频评测基准如 Video-MME 和 TempCompass 主要关注单智能体轨迹、时序排序和事件定位,未覆盖多智能体交互推理。FineBadminton 和 ShuttleSet 虽然涉及羽毛球视频理解,但前者侧重动作识别,后者面向监督学习而非 VLM 零样本推理。Winoground 揭示了 VLM 在视觉语言组合性和属性绑定上的缺陷,但未扩展到多智能体战术场景。
多智能体战术推理的核心难点在于:模型不仅要识别单个动作,还要将原子动作映射到动态角色归属、空间覆盖约束和因果链上。例如,一个杀球动作本身容易识别,但判断这个杀球是由哪一方的哪位球员发起、针对哪个空间区域、以及它如何导致后续的得分或失分,则需要联合建模智能体身份、空间配置、时序演化和角色依赖交互。
论文将这一语义差距形式化为四个诊断层级:L1 原子识别(单个关键帧内的球员、击球、位置等字段)、L2 段内复合理解(单个战术片段内的多字段联合)、L3 跨段因果推理(多个片段之间的因果链)、L4 战术抽象(整体战术意图和角色判断)。这种分层设计使得评测不仅能给出总体准确率,还能精确定位模型在哪一层失效。
核心创新
- 形式化多智能体战术推理为独立评测目标,提出基于关键帧的四层诊断框架 DoublesEval
- 采用成对 SCQ/SAQ 查询架构,同时评估封闭式判别与开放式推理能力
- 提出 TacticCheck:无需参数更新和真值标签的约束引导测试时一致性检查器,利用模型自身低层预测重排序高层答案
方法概览
DoublesEval 从 4 场 BWF 职业双打比赛精选 60 个回合,以得分窗口为锚点,将每个回合分解为战术关键片段,构建四个诊断维度(L1 原子识别、L2 段内复合理解、L3 跨段因果推理、L4 战术抽象)的成对 SCQ/SAQ 问题(约 9.6K 实例)。采用两阶段评估:VLM 零样本推理 + GPT-5 标签映射裁判。TacticCheck 利用模型自身的 L1 预测构建战术检查清单,通过模式级一致性惩罚对高层候选答案重排序。
- 数据构建:从 4 场 BWF 职业双打比赛精选 60 个回合,以得分窗口(最终得分拍及其前 3–5 拍的战术区间)为锚点,将每个回合分解为战术关键片段。
- 四层诊断框架:L1 原子识别、L2 段内复合理解、L3 跨段因果推理、L4 战术抽象,每层包含成对的 SCQ(单选题)和 SAQ(简答题),共约 9.6K 实例。
- 两阶段评估:VLM 零样本推理生成自由文本答案,GPT-5 标签映射裁判将自由文本对齐到预定义标签空间。SCQ 采用精确匹配,SAQ 由裁判评分。
- TacticCheck:利用模型自身的 L1 预测构建战术检查清单,通过模式级一致性惩罚对高层候选答案重排序,无需参数更新和真值标签。
- 标注可靠性:感知标签 κ∈[0.80,0.87],角色归属 κ∈[0.74,0.82];专家对齐 >87%(击球意图)、>79%(战术角色)。
- GPT-5 裁判可靠性验证:480 实例人工校验,裁判-专家一致性 κ=0.81,战术抽象维度最低 κ=0.73。
逐图理解论文
一个具体失败案例
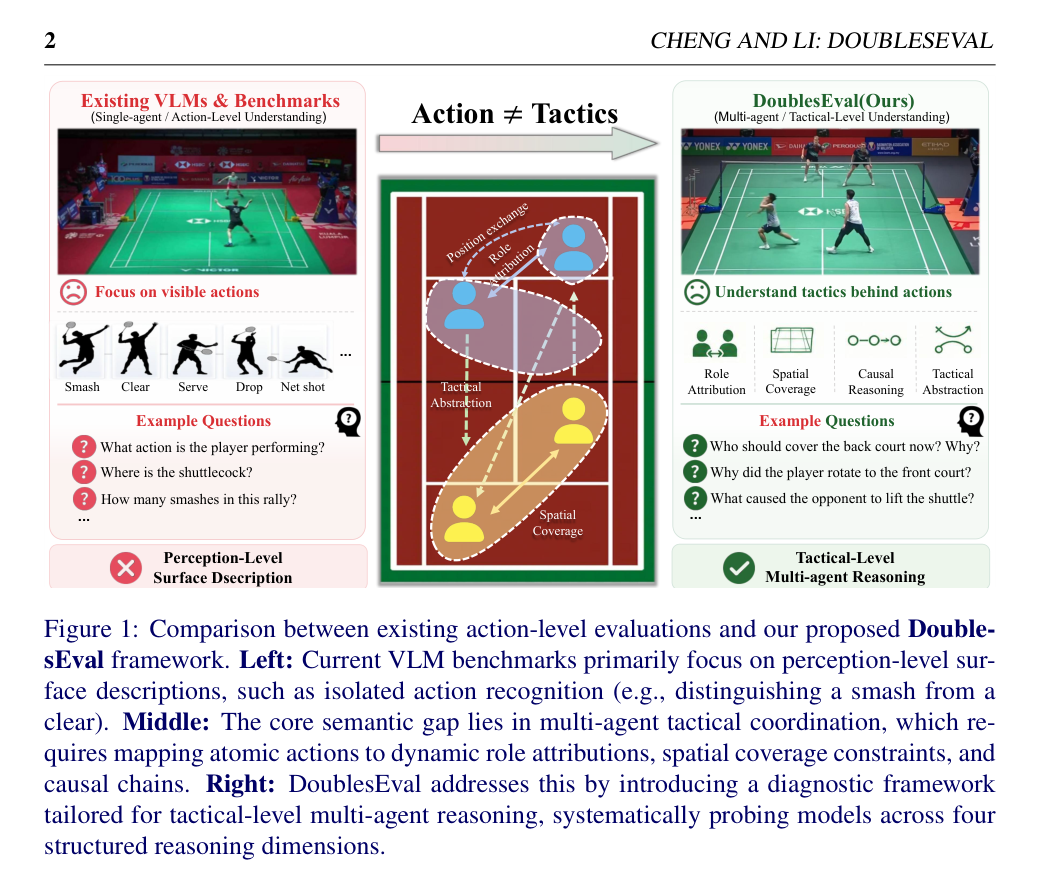
该图对比了现有动作级评测与 DoublesEval 的差异。左侧显示传统基准只关注孤立动作识别,中间指出多智能体战术协调的语义差距,右侧展示 DoublesEval 的四层诊断框架。观察此图可理解论文的核心动机:从感知层描述到战术级推理的跃迁。
研究差距与框架设计
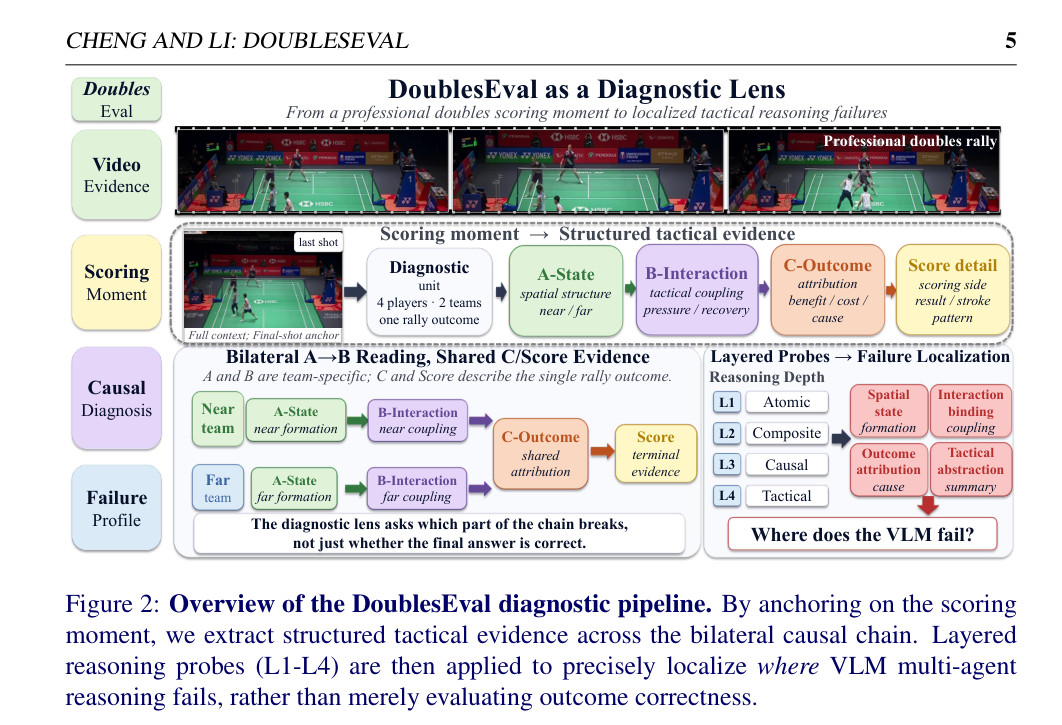
该图展示 DoublesEval 的诊断流程。以得分时刻为锚点,提取双边因果链上的结构化战术证据,然后应用 L1-L4 分层探针。观察此图可理解评测如何定位失效点而非仅判断最终答案正确性。
失效点诊断
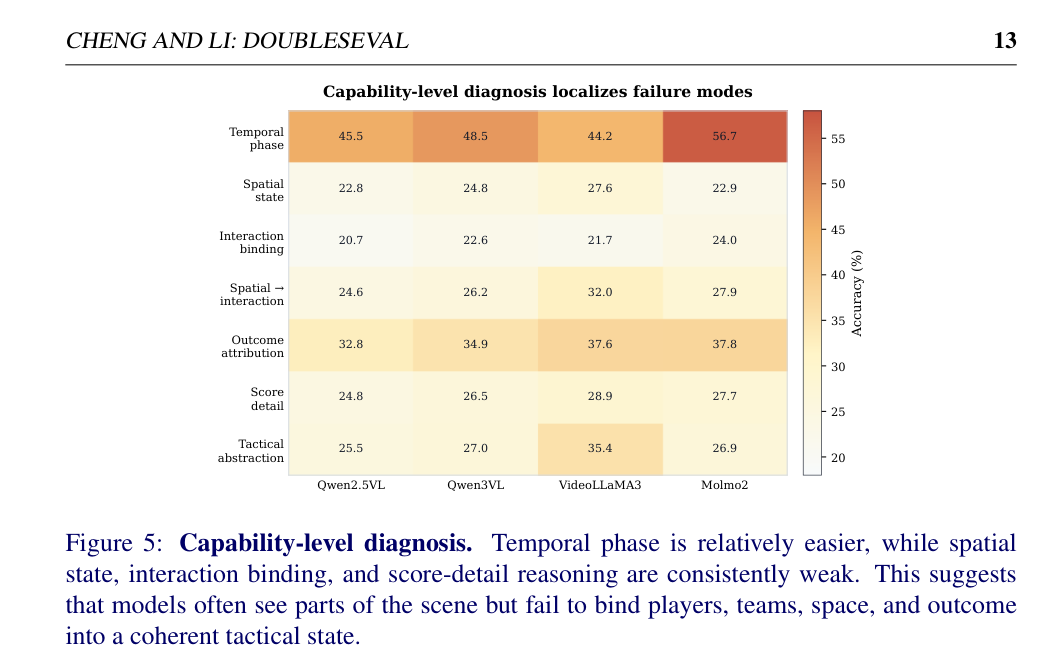
该图展示能力级诊断结果。时间相位相对容易,空间状态、交互绑定和比分细节推理持续薄弱。观察此图可理解模型能感知场景部分信息但无法绑定为连贯战术状态。
TacticCheck 的贡献与局限
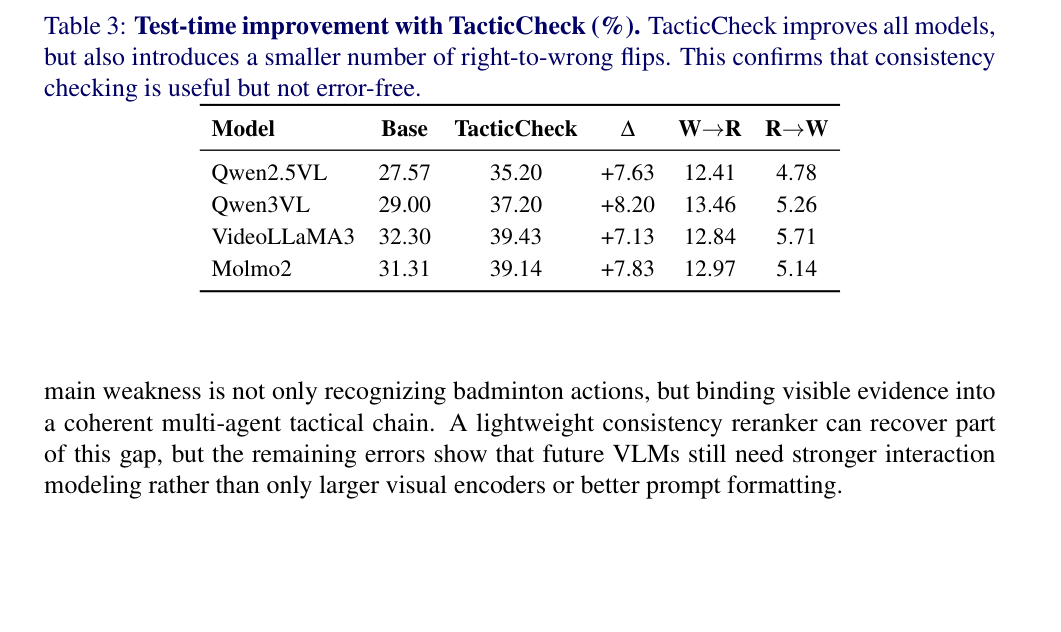
该表展示 TacticCheck 的测试时改进效果。所有模型都有提升,但也引入了少量 R→W 翻转。观察此表可理解一致性检查的收益与代价。
结论与意义
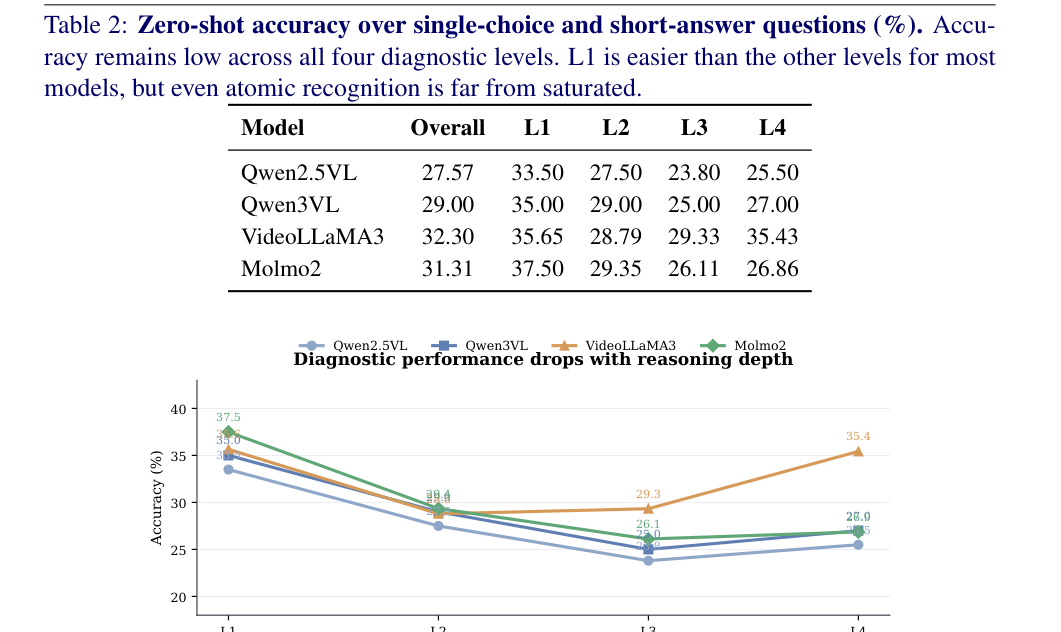
该表展示四个模型在 SCQ 和 SAQ 上的零样本准确率。所有诊断层级的准确率都很低,L1 相对容易但远未饱和。观察此表可理解 VLM 在多智能体战术推理上的整体表现水平。
实验如何设计?
- 在 60 个职业双打羽毛球回合(约 9.6K 实例)上零样本评估 4 个开源 VLM:Qwen2.5-VL、Qwen3-VL、VideoLLaMA3、Molmo2。
- 按四个诊断维度进行层级精度分析,并在能力级(时间相位、空间状态、交互绑定、结果归因、比分细节、战术抽象)和 L1 字段级进行细粒度诊断。
- 验证 TacticCheck 在 SCQ 子集上的测试时重排序增益,统计 W→R 和 R→W 翻转。
- GPT-5 裁判可靠性验证:480 实例人工校验,裁判-专家一致性 κ=0.81。
关键结果与论文证据
- 零样本总体准确率 27.57%–32.30%(四模型),远未达到稳健战术推理水平(Table 2, p.12)。
- L1 原子识别准确率 33.50%–37.50%,远未饱和,说明即使是最基础的原子识别也存在显著缺陷(Table 2, p.12)。
- 时间相位识别能力得分 44.2–56.7,为最高能力组;交互绑定仅 20.7–24.0,说明模型能感知时间但无法将球员、球队、空间与结果绑定为连贯战术状态(Figure 5, p.13)。
- Stroke pattern 为所有模型最难的 L1 字段,这意味着模型经常误读终端击球类型,而后续因果推理依赖这些字段(Figure 6, p.13)。
- TacticCheck 提升 6.55–7.83 个百分点,但准确率仍低于 40%,说明一致性检查有用但远未解决问题(Table 3, p.14)。
- TacticCheck 引入 4.78–5.71% 的 R→W 翻转,说明检查清单错误时会传播错误(Table 3, p.14)。
- L4 并非对所有模型都是最难层级(VideoLLaMA3 在 L4 表现最好),层级难度非严格单调,说明不同模型的失效模式不同(Figure 4, p.12)。
阅读时需要注意
- 仅 4 场来源比赛,球员对和战术风格覆盖有限,存在身份捷径风险(通过相对角色描述缓解)。
- TacticCheck 受限于 L1 预测质量,检查清单错误时会传播错误,且仅适用于 SCQ。
- 战术角色归属标注存在固有主观性。
- TacticCheck 后准确率仍低于 40%,远未达到稳健战术推理。
- 论文中 Table 2 的 Overall 列数值(27.57–32.30)与正文所述 28.65%–32.35% 不一致,存在表述矛盾。
关联工作
- FineBadminton:细粒度羽毛球视频理解数据集,侧重动作识别而非多智能体战术协调(p.2)。
- TempCompass:视频 LLM 诊断套件,暴露时序排序和事件定位缺陷,但限于单智能体轨迹(p.4)。
- Video-MME:多模态 LLM 视频分析综合评测基准,未覆盖多智能体交互推理(p.4)。
- ShuttleSet:羽毛球单打逐拍标注数据集,用于战术分析但面向监督学习而非 VLM 零样本推理(p.4)。
- Winoground:视觉语言组合性探针,揭示 VLM 词袋表征和属性绑定缺陷(p.4)。