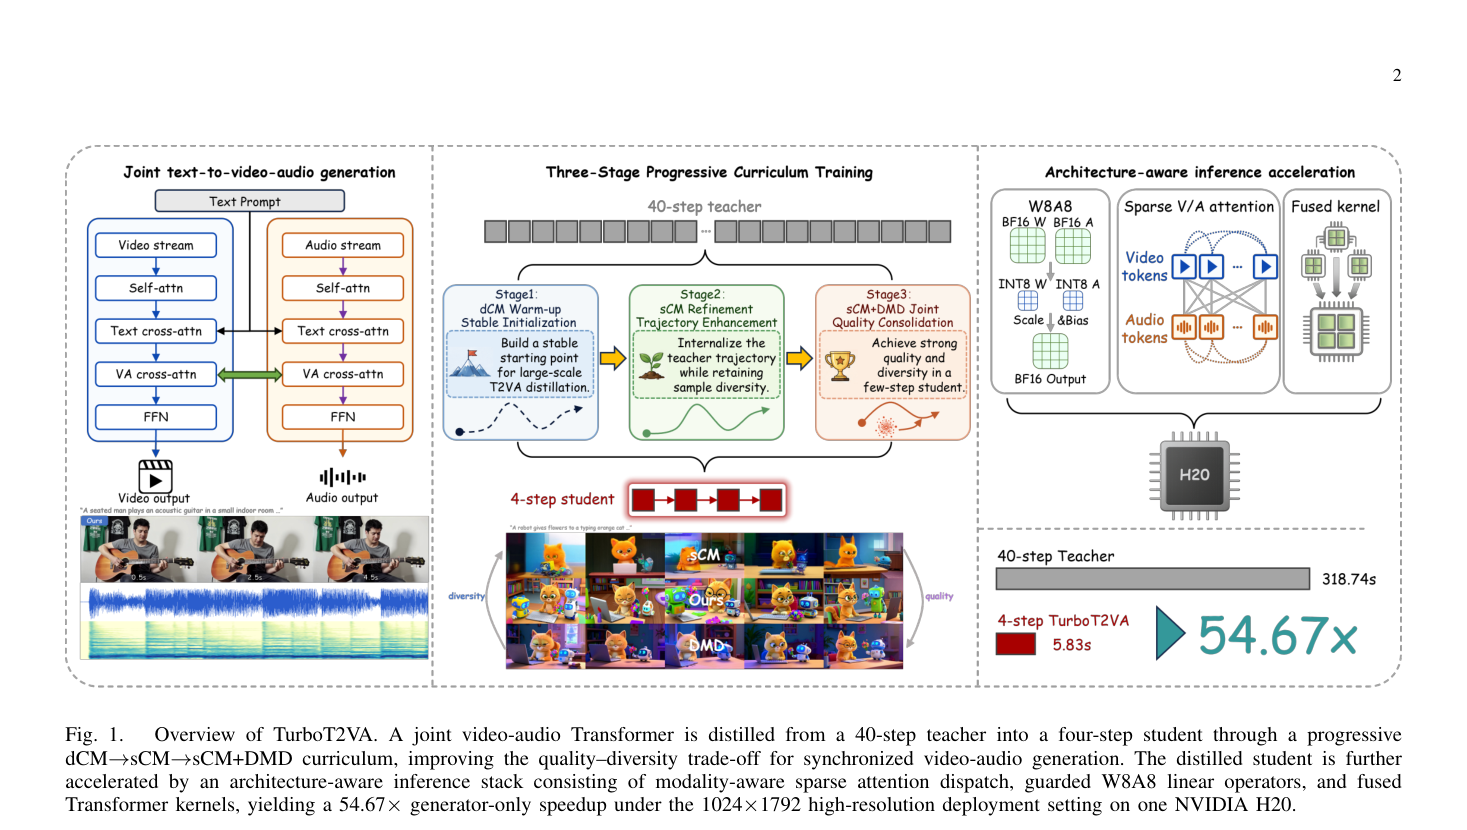
快速导读:TurboT2VA 通过渐进式 dCM→sCM→sCM+DMD 课程蒸馏与架构感知推理栈,将 19B 参数联合视频-音频模型从 40 步蒸馏至 4 步,在 1024×1792 分辨率下实现 54.67× 生成器加速。
TurboT2VA 针对大规模文本到视频-音频(T2VA)联合生成模型推理成本过高的问题,提出了一套从蒸馏到部署的完整加速方案。其核心思路是:在 19B 参数的 LTX-2 联合模型上,通过 Dual-Divergence Distillation 框架,将视频与音频两条模态沿同一轨迹联合蒸馏,并用三阶段课程(dCM 预热→sCM 精炼→sCM+DMD 联合优化)稳定训练,最终把采样步数从 40 步压缩到 4 步。
在此基础上,论文进一步设计了架构感知的推理栈,包括模态感知稀疏注意力、带保护的 W8A8 量化、融合 Transformer 算子与填充文本压缩,在 1024×1792 高分辨率部署场景下实现 54.67× 的生成器加速。值得注意的是,这一加速是纯生成器推理时间,不包含模型加载、VAE 解码与音视频合成等环节。
英文题目:TurboT2VA: Fast Large-Scale Text-to-Video-Audio Generation via Score-Regularized Consistency Distillation
论文出处:arXiv 每日论文精选 · arXiv:2608.24674
原始论文:PDF / 论文页面
这篇论文解决什么问题?
联合 T2VA 模型通过统一架构同时生成同步的视频与音频,避免了级联方案中先视频后音频带来的时序错位问题。但代价是推理成本极高:LTX-2 这类 19B 参数模型依赖多步扩散或流式采样,单次生成需要数十步前向传播,难以实时部署。
直接套用现有加速方法面临三重挑战。第一,模态不平衡:视频与音频的损失尺度差异巨大,共享 Transformer 中的联合梯度会被视频主导,音频信号被淹没。第二,连续时间一致性训练数值不稳定:sCM 涉及 JVP 与 TrigFlow 参数化,直接联合优化难以收敛。第三,质量-多样性权衡:sCM 偏向保持多样性但降低提示保真度,DMD 偏向提升质量但导致样本重复。
现有工作如 rCM 已将分数正则化引入连续时间一致性模型,但仅针对单模态图像生成。TurboT2VA 的关键洞察是:在联合 T2VA 场景下,视频与音频必须沿同一轨迹蒸馏,才能保持跨模态的时间一致性,而这需要专门的归一化策略与课程设计。
核心创新
- 首个面向 19B 参数联合 T2VA 模型的分数正则化一致性蒸馏框架,实现 4 步视频-音频生成
- 联合跨模态蒸馏:视频与音频通过共享前向图和 JVP 沿同一轨迹蒸馏,保持时间一致性
- 逐模态归一化(sCM 用 L2 方向归一化,DMD 用残差尺度归一化)解决模态不平衡
- 三阶段渐进课程蒸馏:dCM 预热→sCM 精炼→sCM+DMD 联合优化,平衡质量与多样性
- 架构感知推理栈:模态感知稀疏注意力调度(仅稀疏化自注意力,保留跨模态与文本交叉注意力为稠密)、带保护的 W8A8 后缩放量化、融合多模态 Transformer 算子、填充文本压缩
方法概览
基于 LTX-2 的 19B 联合视频-音频模型(14B 视频骨干 + 5B 音频骨干),提出 Dual-Divergence Distillation 框架:在共享跨模态 Transformer 上联合计算视频与音频的 sCM 轨迹一致性和 DMD 分布匹配损失,采用逐模态归一化平衡梯度;通过三阶段课程(dCM 预热→sCM 精炼→sCM+DMD 联合优化)稳定训练;推理端结合模态感知 SageSLA 稀疏注意力、带保护的 W8A8 量化线性算子、融合 Transformer 算子及填充文本压缩。
- 基于 LTX-2 的 19B 联合视频-音频模型作为教师与骨干,其中视频骨干 14B、音频骨干 5B,共享跨模态 Transformer。
- Dual-Divergence Distillation 在共享前向图上联合计算视频与音频的 sCM 轨迹一致性损失和 DMD 分布匹配损失,两条模态沿同一轨迹蒸馏。
- 逐模态归一化解决梯度不平衡:sCM 损失采用 L2 方向归一化,DMD 损失采用残差尺度归一化,使视频与音频的梯度贡献可比。
- 三阶段课程蒸馏:Stage 1 用 dCM 预热,建立稳定的离散时间一致性基础;Stage 2 切换到 sCM 精炼连续时间轨迹;Stage 3 引入 DMD 联合优化,平衡质量与多样性。
- 推理栈的模态感知 SageSLA 稀疏注意力只稀疏化自注意力,保留跨模态注意力与文本交叉注意力为稠密,避免破坏音视频同步。
- 带保护的 W8A8 量化线性算子要求 CUDA BF16 输入且 M/K/N 维度可被 128 整除,不满足条件时自动回退到 BF16。
- 融合 Transformer 算子减少内核启动开销,填充文本压缩仅支持 batch size 1 推理。
- 训练配置为 8×H20、100K 样本、约 7K 优化步,总耗时约 21 小时,采用 FSDP 分布式策略。
逐图理解论文
失败直觉:质量与多样性的两难
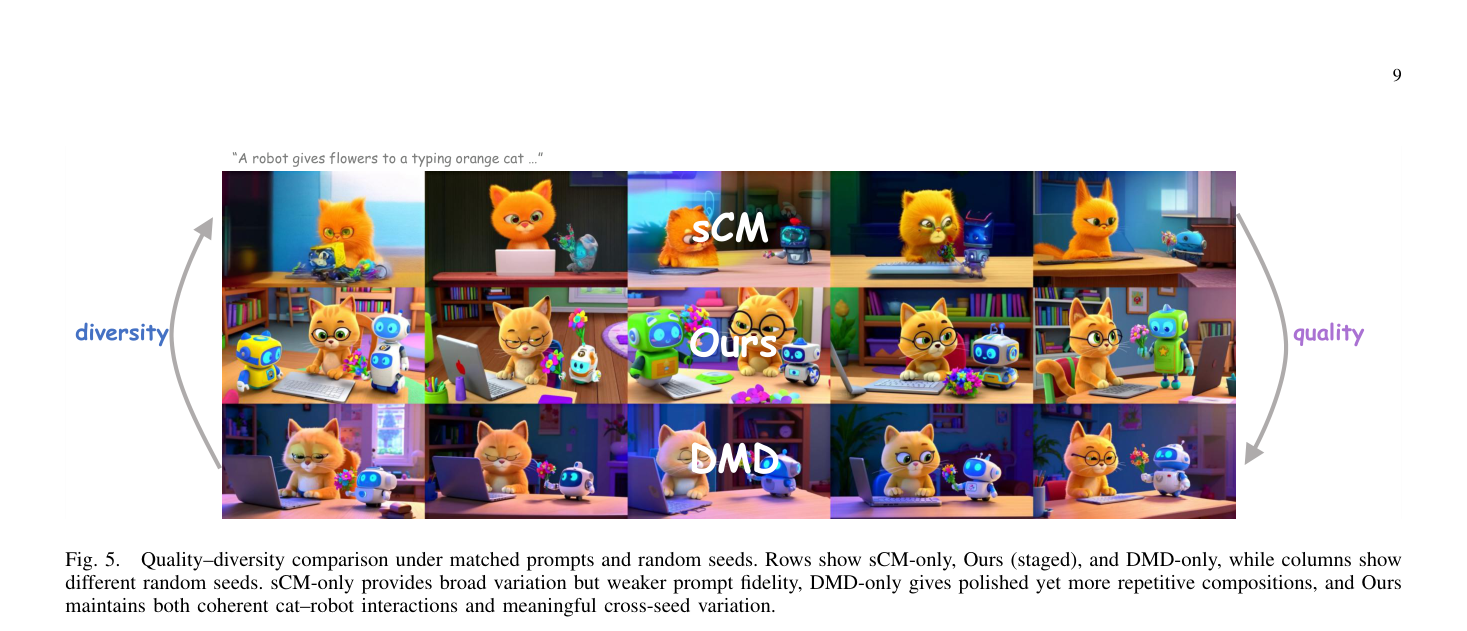
质量-多样性对比图按行展示 sCM-only、Ours(staged)和 DMD-only,按列展示不同随机种子。观察 sCM-only 的松散构图、DMD-only 的重复性,以及 Ours 如何在猫-机器人交互中保持跨种子变化。
研究缺口:模态不平衡与训练不稳定
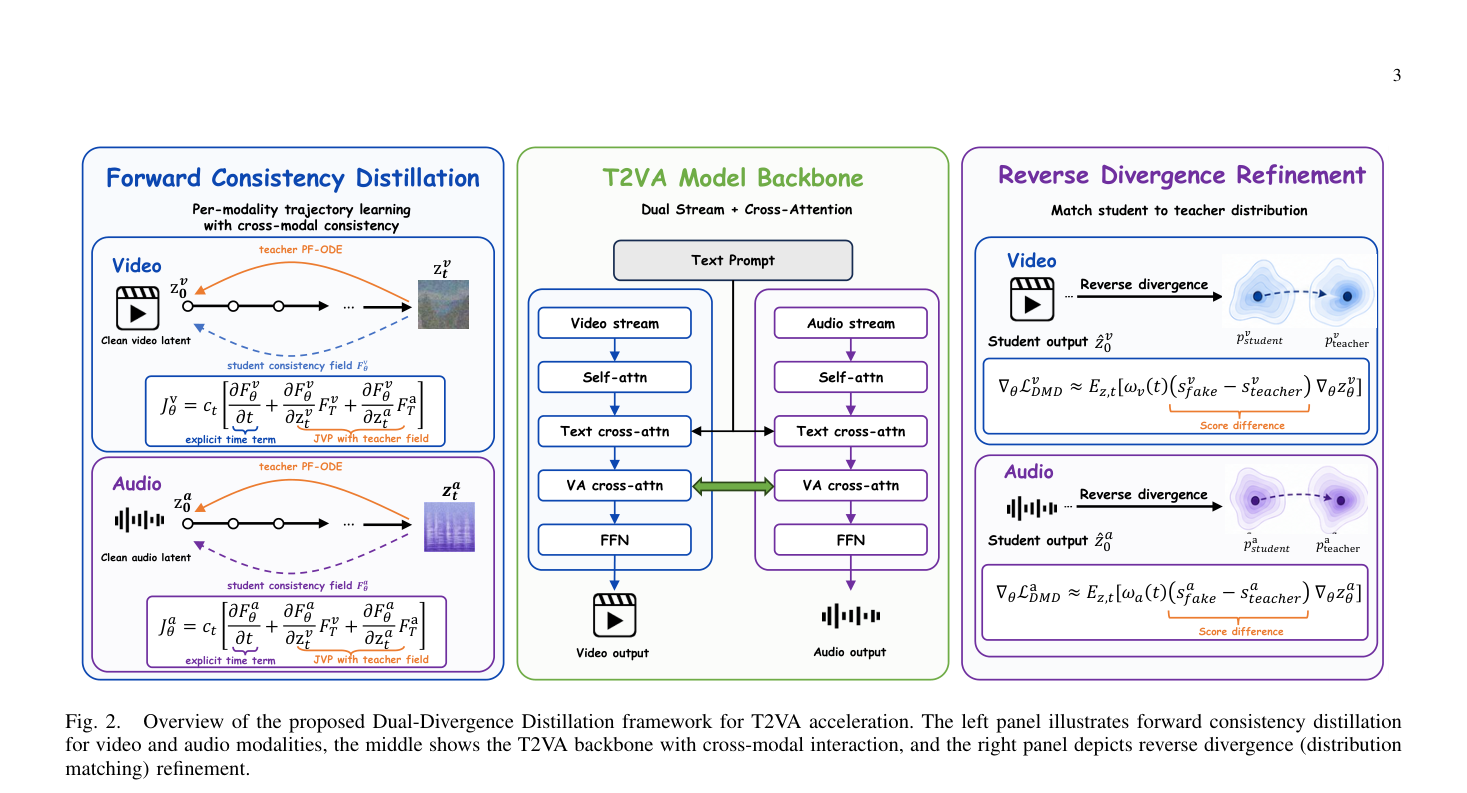
该图详细展示了 Dual-Divergence Distillation 框架:左面板是视频与音频的前向一致性蒸馏,中间是带跨模态交互的 T2VA 骨干,右面板是反向散度的分布匹配精炼。注意两条模态如何共享前向图与 JVP。
推理栈:从蒸馏到部署的最后一公里
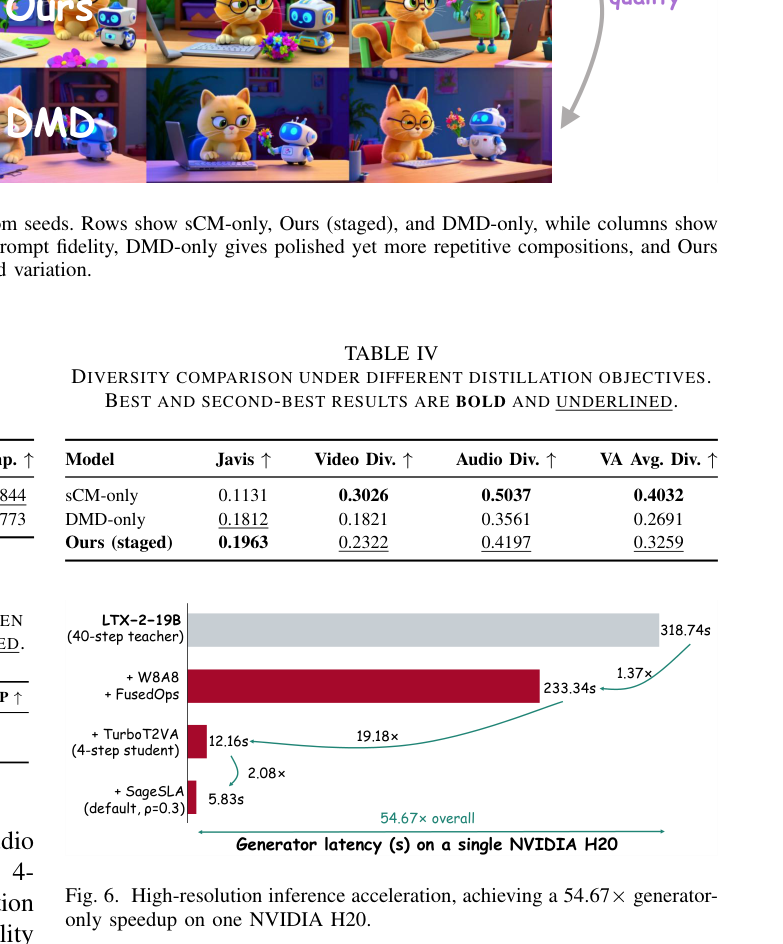
高分辨率推理加速图展示了 54.67× 生成器加速的组件分解。关注从稠密 4 步学生到 Full ρ=0.3 配置的延迟下降路径,理解稀疏注意力与量化的贡献。
结论与局限
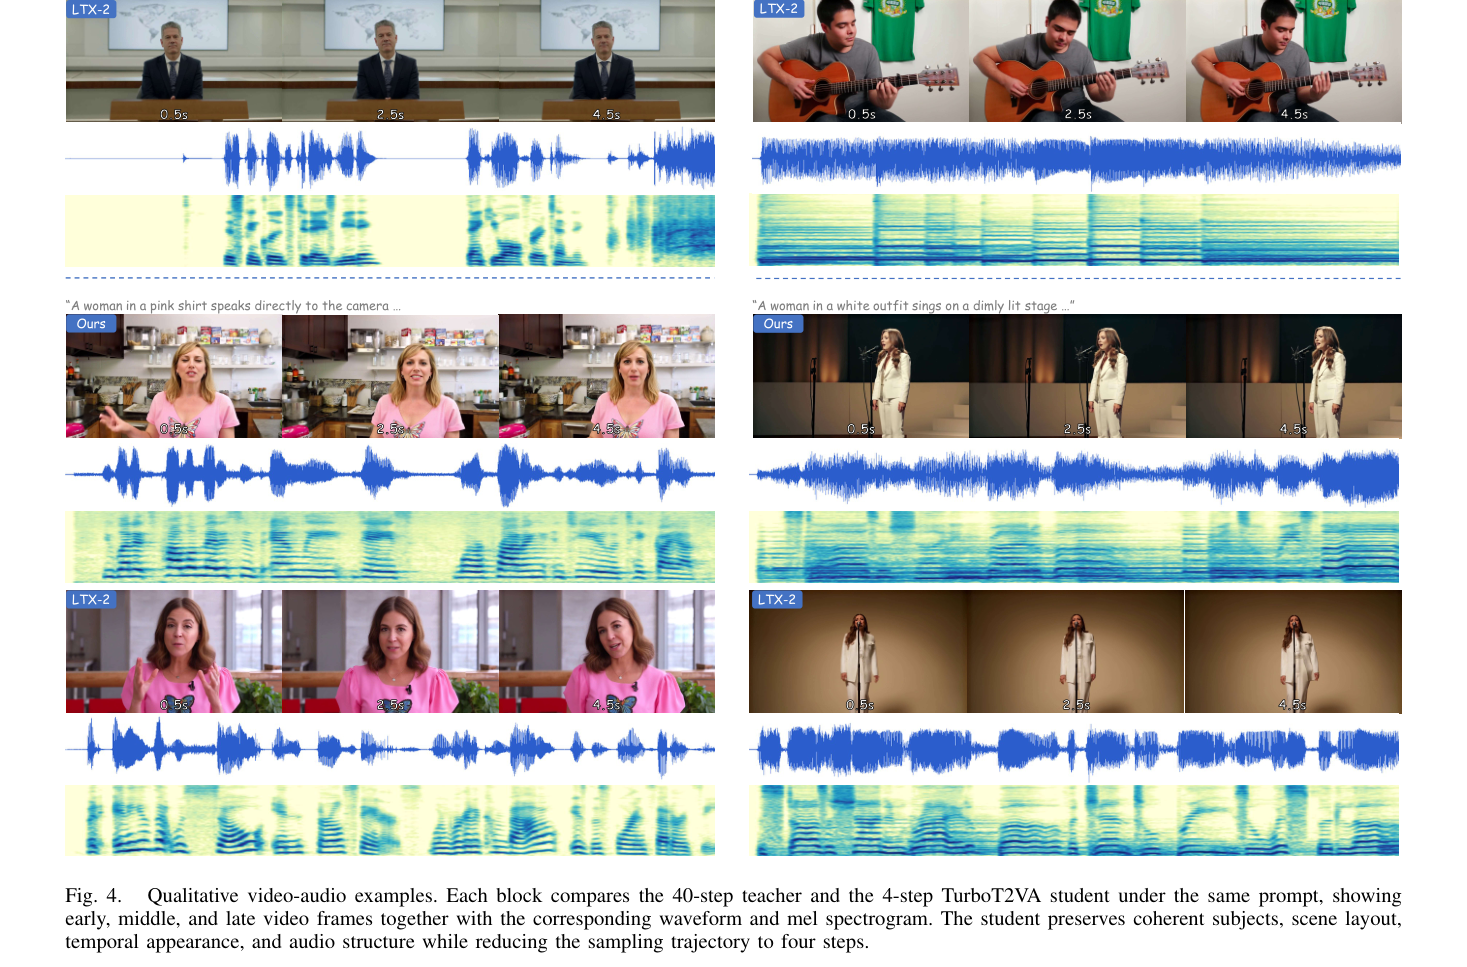
定性对比图展示了同一提示下 40 步教师与 4 步学生的早、中、晚期视频帧及对应波形和梅尔频谱。重点检查主体一致性、场景布局与音频结构是否在 4 步内得到保留。
实验如何设计?
- 主对比在 JavisBench 上进行,与闭源模型(Kling v3、Sora 2、Veo 3)、级联方案(TempoToken、TPoS、ReWaS、FoleyCrafter、MMAudio)及开源 T2VA 模型(JavisDiT、OVI、DaVinci-MagiHuman)对比。
- 视频保真度用 VBench 评估,涵盖美学质量、成像质量、运动平滑度、主体一致性与时间闪烁五个维度。
- 音频质量用 TTA-Bench 评估,文本-音频对齐用 MS-CLAP 度量。
- 多样性评估采用 200 个提示 × 8 个种子,用 ImageBind 嵌入计算提示内成对距离。
- 高分辨率推理加速在 1024×1792、121 帧、batch size 1 的单张 NVIDIA H20 上逐组件分解延迟。
- 消融实验覆盖渐进预热效果、联合 sCM+DMD 目标效果、采样步数(1/2/4 步)以及 SageSLA 保留率 ρ 的速度-质量前沿。
关键结果与论文证据
- 4 步蒸馏将标准分辨率(512×768)生成器延迟从 50.52s 降至 2.51s,实现 20.1× 加速(第 7 页)。
- 高分辨率(1024×1792)完整推理栈将生成器延迟从 318.74s 降至 5.83s,实现 54.67× 加速(第 9 页)。
- Javis 分数上,4 步学生达到 0.1963,超过 40 步教师的 0.165;Desync 从 0.617 降至 0.388,表明音视频同步性显著改善(第 7 页)。
- VBench 上,学生美学质量 0.5519、成像质量 0.6520,均优于教师的 0.5286 和 0.5884(第 9 页)。
- 多样性对比中,分阶段训练的 Ours 在 Javis 0.1963、视频多样性 0.2322、音频多样性 0.4197 上全面优于 DMD-only(0.1812/0.1821/0.3561)和 sCM-only(0.1131/0.3026/0.5037)(第 9 页)。
- 高分辨率组件延迟分解:稠密 4 步学生 16.50s,加入 W8A8+Fused 后 12.16s,Full ρ=0.3 配置降至 5.83s(第 10 页)。
- 训练曲线消融显示,分阶段 dCM→sCM→sCM+DMD 在进入联合阶段后超越直接 sCM+DMD 优化,并保持更强的后期性能(第 10 页)。
- ρ=0.2 比 ρ=0.3 延迟更低但 Desync 更高(0.4145 vs 0.4085),默认 ρ=0.3 是速度与同步性的权衡选择(第 10 页)。
阅读时需要注意
- 稀疏注意力是近似方法,分辨率或提示分布变化时保留率 ρ 需重新验证。
- W8A8 量化路径要求 CUDA BF16 输入且 M/K/N 维度可被 128 整除,不支持的形状回退到 BF16,可能损失加速效果。
- 填充文本压缩仅支持 batch size 1 推理,大批量场景下禁用。
- 训练数据规模为 100K 样本,相对较小,未探索更大规模数据下的扩展性。
- 延迟测量为生成器纯推理时间,排除模型加载、VAE 解码、音视频合成和磁盘 I/O,实际端到端延迟会更高。
- 多样性分数基于 ImageBind 嵌入的提示内成对距离,仅衡量样本间差异,不直接反映语义多样性质量。
关联工作
- LTX-2 作为教师模型和骨干架构,是 19B 参数的联合视频-音频基础模型,TurboT2VA 在其上构建蒸馏框架。
- dCM(离散时间一致性模型)用于 Stage 1 预热,sCM(Lu & Song 的连续时间一致性模型)用于 Stage 2 轨迹精炼。
- DMD/DMD2(分布匹配蒸馏)用于 Stage 3 质量提升,但单独使用会降低多样性。
- rCM(Zheng et al. 的分数正则化连续时间一致性模型)是 TurboT2VA 的直接前身,本文将其从单模态图像扩展到联合 T2VA。
- JavisDiT 是开源 T2VA 基线,提供 JavisBench 评估指标。
- TurboDiffusion 提供高效推理原语,TurboT2VA 在其基础上构建架构感知推理层。
- SageAttention/SageSLA 是稀疏-线性注意力机制,用于模态感知稀疏注意力调度。