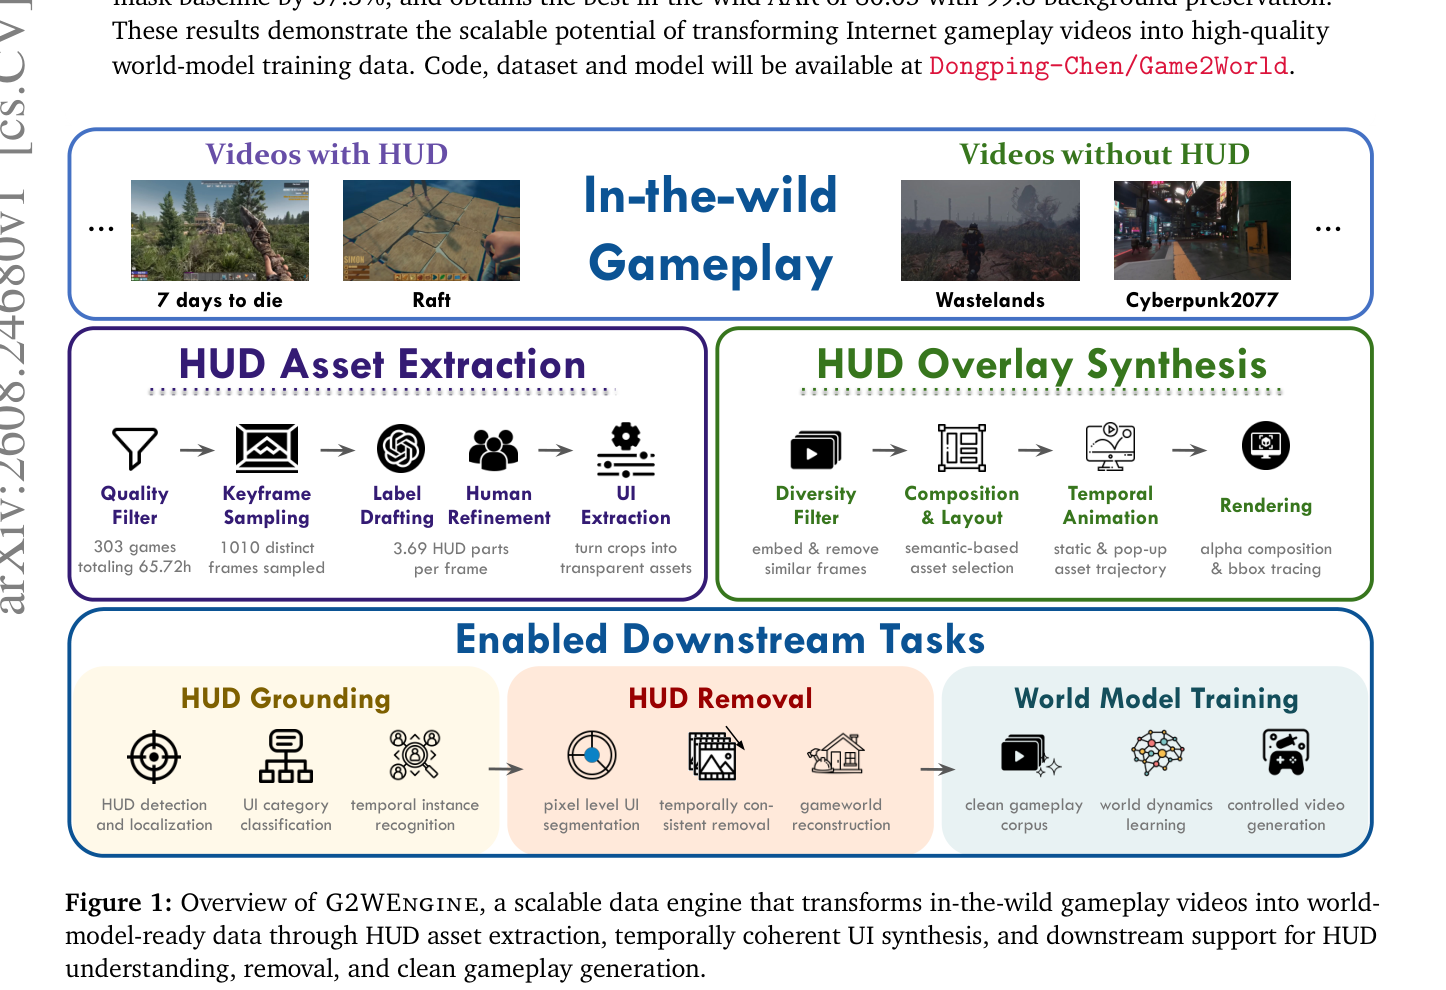
快速导读:提出G2WEngine数据引擎与GameCleaner模型,将含HUD的真实游戏视频自动转换为无UI的干净数据,用于提升世界模型训练质量。
世界模型需要多样化、长时程的交互数据来学习环境动态,但封闭模拟器采集成本高昂。互联网上存在海量游戏视频,理论上可以成为理想的数据来源,然而这些视频中的屏幕空间HUD、菜单、通知等界面元素与游戏世界本身纠缠在一起,引入了游戏特定的偏差和无关动态。本文提出G2WEngine数据引擎和GameCleaner模型,系统性地解决这一界面-世界解耦问题。
论文的核心贡献在于:首先通过先导实验量化了UI污染对世界模型训练的实际影响,然后构建了统一的GameUI-Taxonomy分类体系,基于此开发了可扩展的合成数据引擎,最终训练出无需掩码即可移除HUD的GameCleaner模型。实验表明,去除UI后VideoReward总体提升6.83%,运动质量提升18.8%,验证了数据清洗对世界模型训练的价值。
英文题目:Game2World Engine: Unlocking In-the-Wild Gameplay Videos for World Model Training
论文出处:arXiv 每日论文精选 · arXiv:2608.24680
原始论文:PDF / 论文页面
这篇论文解决什么问题?
世界模型的核心目标是学习环境的动态规律,使智能体能够预测行动的后果。DIAMOND使用扩散模型从Atari游戏记录构建强化学习环境,Genie从无标注互联网视频联合学习潜在动作与环境动态,这些工作都依赖干净的游戏画面。然而,真实游戏视频中HUD元素占据了大量屏幕空间,包括血条、小地图、任务提示、聊天窗口等,这些元素与游戏世界的物理动态无关,却会被模型错误地学习为环境的一部分。
先导实验(第4页)系统验证了这一担忧:研究者从5,442个干净片段训练Wan2.1-T2V-1.3B模型,对比干净数据与UI叠加数据的训练效果。结果显示,去除UI后VideoReward总体提升6.83%,其中运动质量提升18.8%,美学质量提升8.59%,运动一致性提升4.36%。这表明UI污染不仅影响视觉质量,更严重地损害了模型对运动动态的学习。
现有的视频修复方法如ProPainter虽然可以移除物理对象,但并未针对游戏UI的特殊性进行设计。游戏UI具有持久性(如血条始终存在)、时序一致性(如小地图随玩家移动更新)和功能多样性(如弹窗、通知、菜单)等特点,需要专门的分类体系和移除策略。
此外,缺乏统一的评估协议也是该领域的瓶颈。传统的像素级指标无法反映UI移除的语义正确性,而人工评估成本高且难以标准化。论文提出MLLM-as-a-judge评估协议,通过元素级边界框检查清单来评估移除质量,Cohen's κ达到0.820,与人工标注高度一致。
核心创新
- 先导实验系统量化UI对世界模型训练的影响(VideoReward +6.83%)
- GameUI-Taxonomy:21类游戏HUD元素的统一分类体系
- G2WEngine:可扩展的UI资产提取与合成数据引擎
- Game2World数据集:96K合成配对视频+1,079真实片段+5,132验证UI资产
- GameCleaner:无掩码游戏UI移除模型,结合MLLM语义理解与视频编辑
- MLLM-as-a-judge评估协议,含元素级边界框检查清单,Cohen's κ=0.820
方法概览
G2WEngine四阶段流程:定义GameUI-Taxonomy统一分类体系、从真实视频提取UI资产、策展干净游戏视频语料、合成时序一致的UI叠加配对数据。基于此训练GameCleaner,采用MLLM编码器+视频DiT架构,通过潜查询提取语义信息,无需掩码直接识别并移除HUD。
- GameUI-Taxonomy(第5页):将游戏HUD元素按功能角色和渲染行为分为21类,包括空间信息(小地图、指南针)、玩家状态(血条、能量条)、目标(任务提示)、消息(聊天、通知)、动作(技能栏)、外部叠加层(弹窗、菜单)等。这一分类体系是后续数据合成和评估的基础。
- G2WEngine四阶段流程(第7页):第一阶段从真实视频中提取UI资产,第二阶段策展干净游戏视频语料,第三阶段合成时序一致的UI叠加配对数据,第四阶段生成训练数据集。该引擎的可扩展性使得研究者能够生成大规模、多样化的配对数据。
- Game2World数据集:包含96K合成配对视频、1,079个真实片段和5,132个验证UI资产。合成数据通过时序一致的UI叠加生成,确保UI元素在视频帧间的运动与游戏场景保持一致。
- GameCleaner架构(第8页):采用MLLM编码器+视频DiT架构,通过潜查询提取语义信息,无需掩码直接识别并移除HUD。模型以Kiwi-Edit为基础进行初始化,提供指令与参考引导的视频编辑能力。
- 参考图机制:GameCleaner支持可选的参考图输入,通过参考图提供干净场景的先验信息。消融实验显示,20%参考图丢弃率最优,真实AAR从70.64提升至80.05,说明适度的参考图丢弃有助于模型学习更鲁棒的移除能力。
- MLLM-as-a-judge评估协议(第11页):使用多模态大语言模型作为评判器,通过元素级边界框检查清单评估UI移除质量。该协议包含removed F1=87.78%,Cohen's κ=0.820,验证了与人工标注的一致性。
- AAR(伪影调整移除分数):考虑移除后伪影的评分指标,避免简单移除率无法反映编辑质量的问题。EffectErase原始UI移除分数高达92.00,但Track-Clean仅16.12,说明原始移除率不能反映编辑质量,AAR和Track-Clean等指标更为可靠。
- 数据规模消融(第14页):数据规模从60%增加到100%时,真实AAR从54.96提升至80.05(+25.09),表明数据多样性和规模对泛化能力至关重要,且尚未收敛。
逐图理解论文
失败案例与直觉
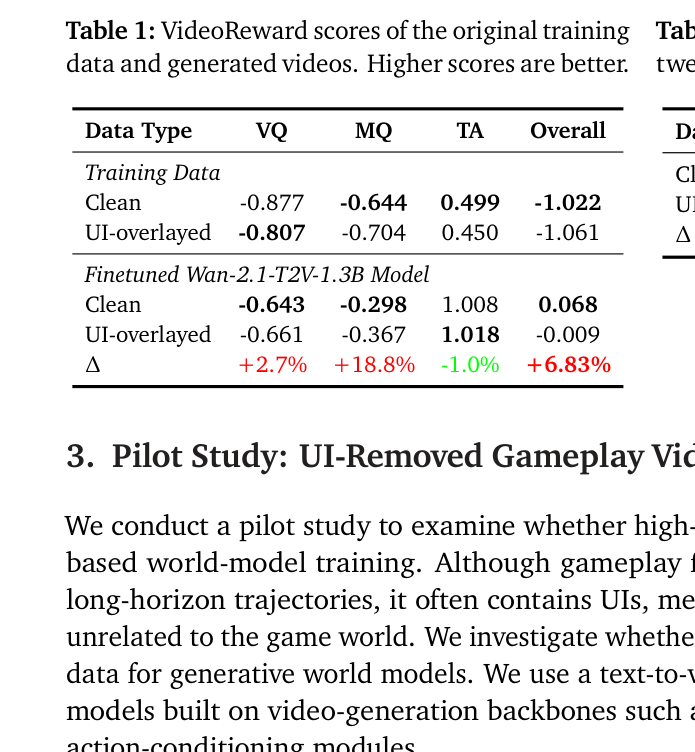
该表展示了原始训练数据与生成视频的VideoReward分数对比,干净数据的各项指标均优于UI叠加数据,是论文核心动机的量化证据。
研究空白
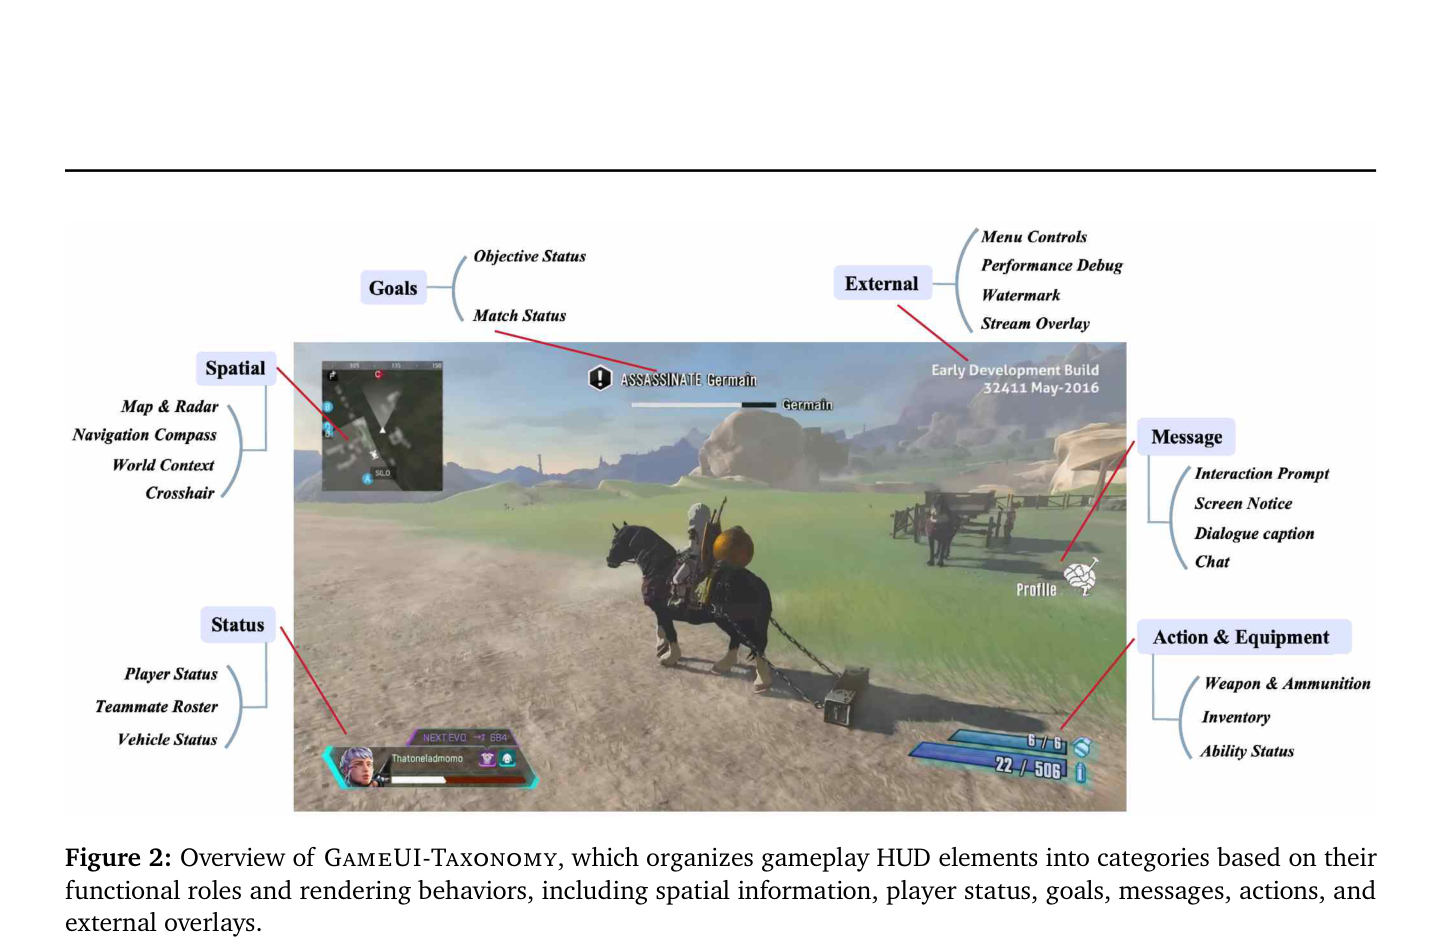
该图展示了GameUI-Taxonomy的分类结构,按功能角色和渲染行为组织HUD元素,是后续数据合成和评估的基础框架。
验证与结论
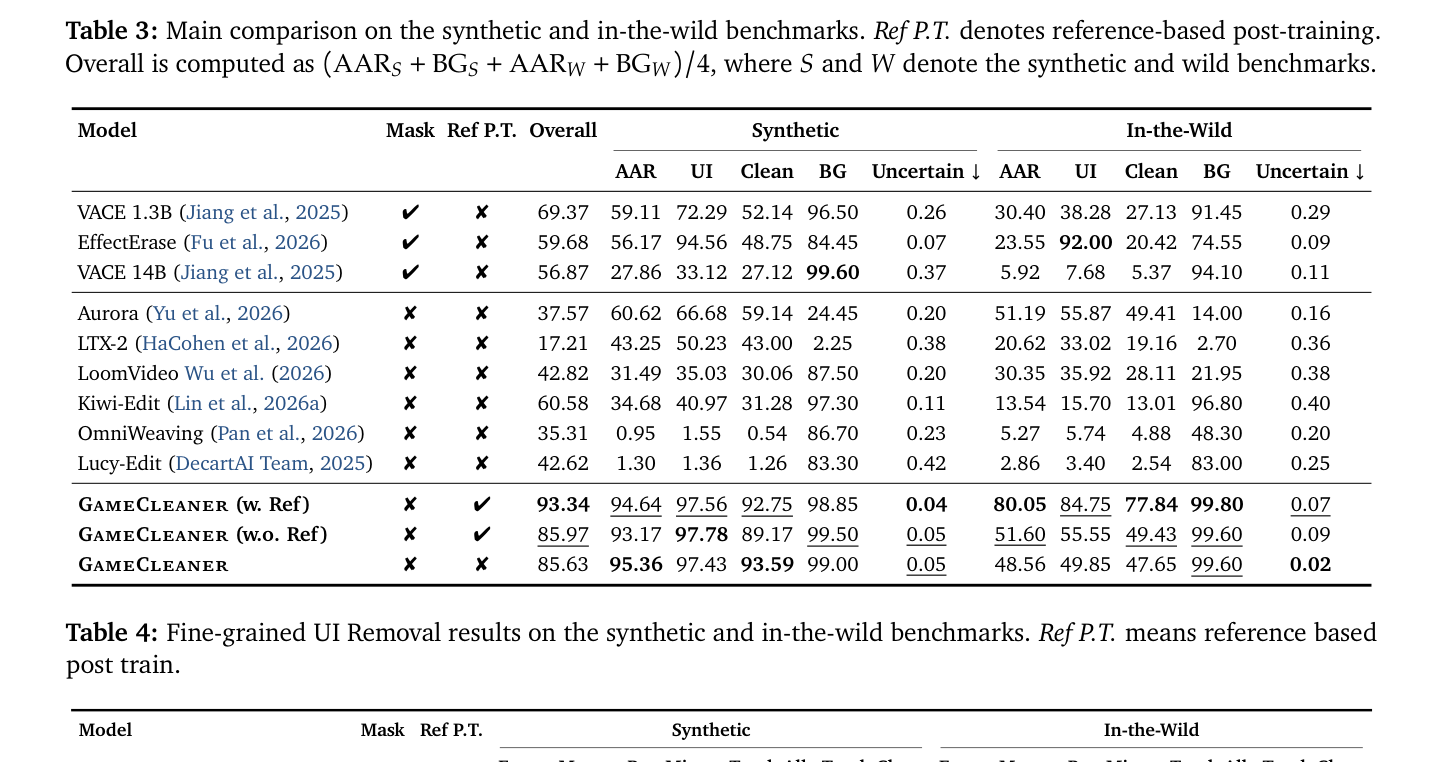
该表展示了主实验对比结果,GameCleaner在合成和真实基准上均超越基线模型,Overall=93.34证明了方法的有效性。
意义与局限
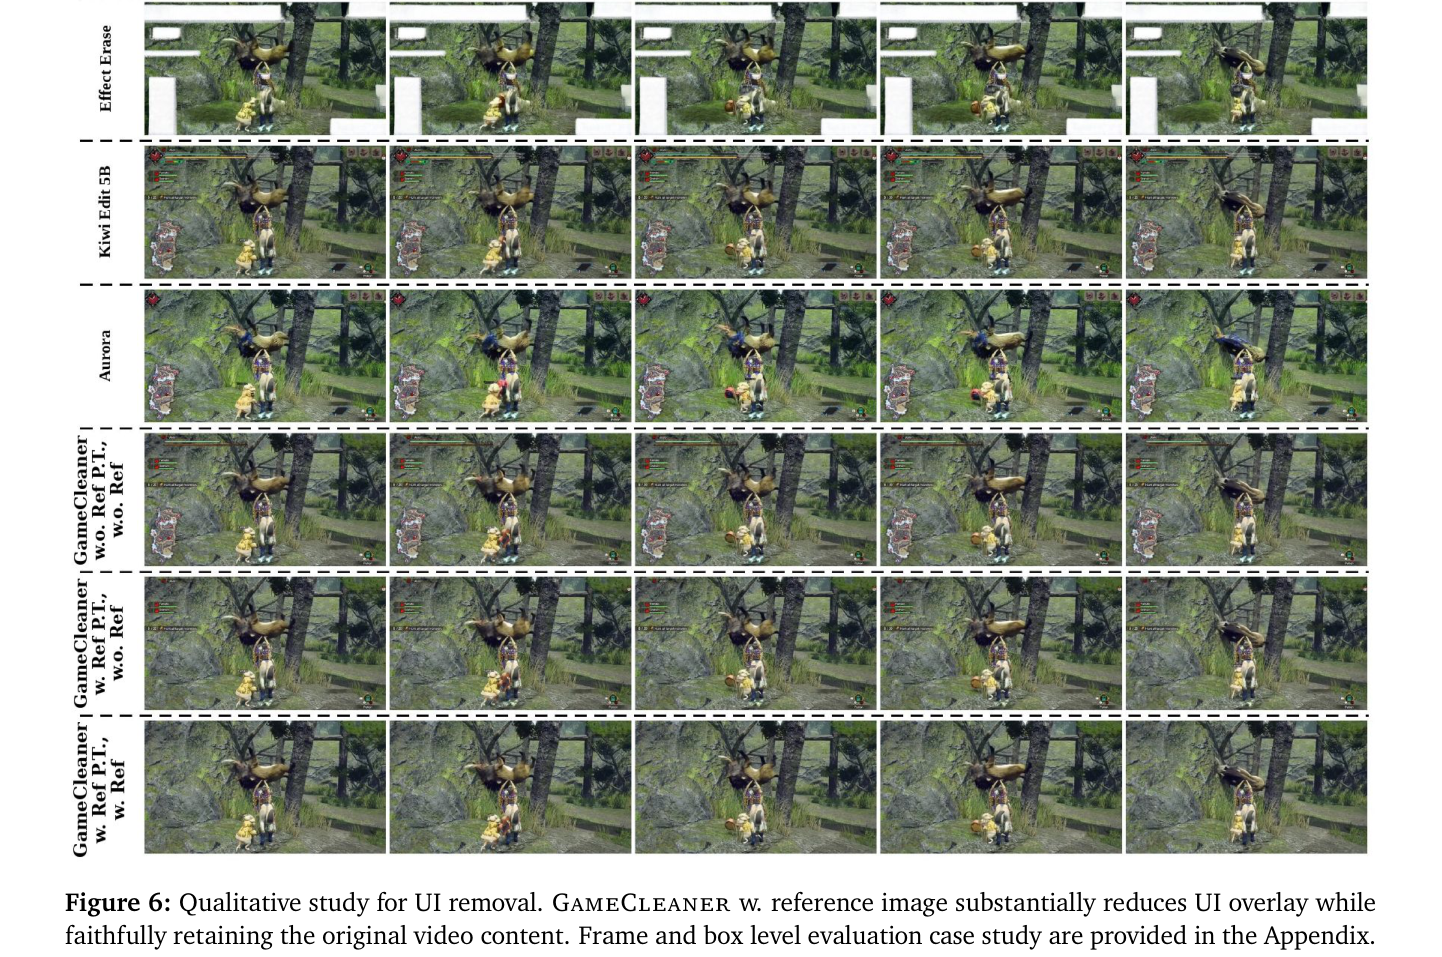
这项工作为世界模型训练解锁了海量互联网游戏视频数据,让界面-世界解耦从模糊的直觉变成了可量化的工程问题。但必须承认,GameCleaner对大型不透明界面和快速变化的叠加层重建仍不完美,真实场景的完整轨迹干净移除率只有68.12%。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 先导实验:使用5,442个干净片段训练Wan2.1-T2V-1.3B模型,对比干净数据与UI叠加数据的训练效果,评估VideoReward指标。
- 主实验:在合成和真实两个基准上对比8个基线模型(VACE、EffectErase、Aurora、LTX-2、LoomVideo、Kiwi-Edit、OmniWeaving、Lucy-Edit),评估AAR、BG、Track-Clean等指标。
- 消融实验:数据规模从60%到100%,参考图丢弃率从0%到80%,分析对真实AAR的影响。
- 评估协议验证:使用200个视频、6,150个标签验证MLLM评判器与人工标注的一致性,计算removed F1、Cohen's κ、ICC和Krippendorff's α。
- 分辨率敏感性实验:在800×448、1280×720、1920×1080三种分辨率下评估模型性能,发现评判器对分辨率敏感,需标准化评估分辨率。
关键结果与论文证据
- 去除UI后VideoReward总体提升6.83%,运动质量提升18.8%(第4页),证明UI污染对世界模型训练有显著负面影响。
- GameCleaner (w. Ref) Overall=93.34,合成AAR=94.64,BG=98.85;真实AAR=80.05,BG=99.80(第11页),在合成和真实基准上均表现优异。
- 标准GameCleaner合成AAR=95.36,BG=99.00,超越最强无掩码基线57.3%(第11页),证明无掩码方法的有效性。
- GameCleaner (w. Ref) 合成Track-Clean=95.47,真实Track-Clean=68.12(第11页),真实场景的完整轨迹干净移除仍具挑战性。
- MLLM评判器removed F1=87.78%,Cohen's κ=0.820(第11页),评估协议与人工标注高度一致。
- 20%参考图丢弃率最优:真实AAR从70.64提升至80.05(第14页),适度的参考图丢弃有助于鲁棒性。
- 数据规模60%→100%:真实AAR从54.96提升至80.05(+25.09)(第14页),数据规模对泛化能力至关重要且尚未收敛。
- AAR ICC(A,5)=0.926,Krippendorff's α=0.712(第15页),评估协议具有较高的评分者间可靠性。
阅读时需要注意
- Game2World未覆盖全部游戏类型、界面和录制条件,数据多样性仍有提升空间。
- GameCleaner对大型不透明界面、快速变化叠加层或与场景纠缠的UI重建不完美,真实Track-Clean仅68.12%。
- 下游研究使用文本条件视频生成作为代理,而非完整动作条件世界模型,实际应用效果需进一步验证。
- 缺少跨异构游戏的动作恢复模块,无法直接从清洗后的视频中恢复玩家操作。
- GameCleaner未做少步蒸馏,推理需完整生成轨迹,计算成本较高。
关联工作
- DIAMOND(第3页):使用扩散模型从Atari游戏记录构建强化学习环境,证明了游戏数据对世界模型训练的价值,但依赖封闭模拟器采集。
- Genie(第3页):从无标注互联网视频联合学习潜在动作与环境动态,展示了互联网视频数据的潜力,但未解决UI污染问题。
- ProPainter(第3页):视频修复方法,用于物理对象移除,未针对游戏UI的特殊性进行设计。
- Kiwi-Edit(第8页):GameCleaner的初始化基础模型,提供指令与参考引导的视频编辑能力。
- EffectErase(第11页):掩码辅助的视频对象移除基线,原始移除分数高但伪影多,Track-Clean仅16.12%。
- VACE(第11页):掩码辅助基线,背景保持好但移除能力弱,说明掩码方法在游戏UI移除上的局限性。