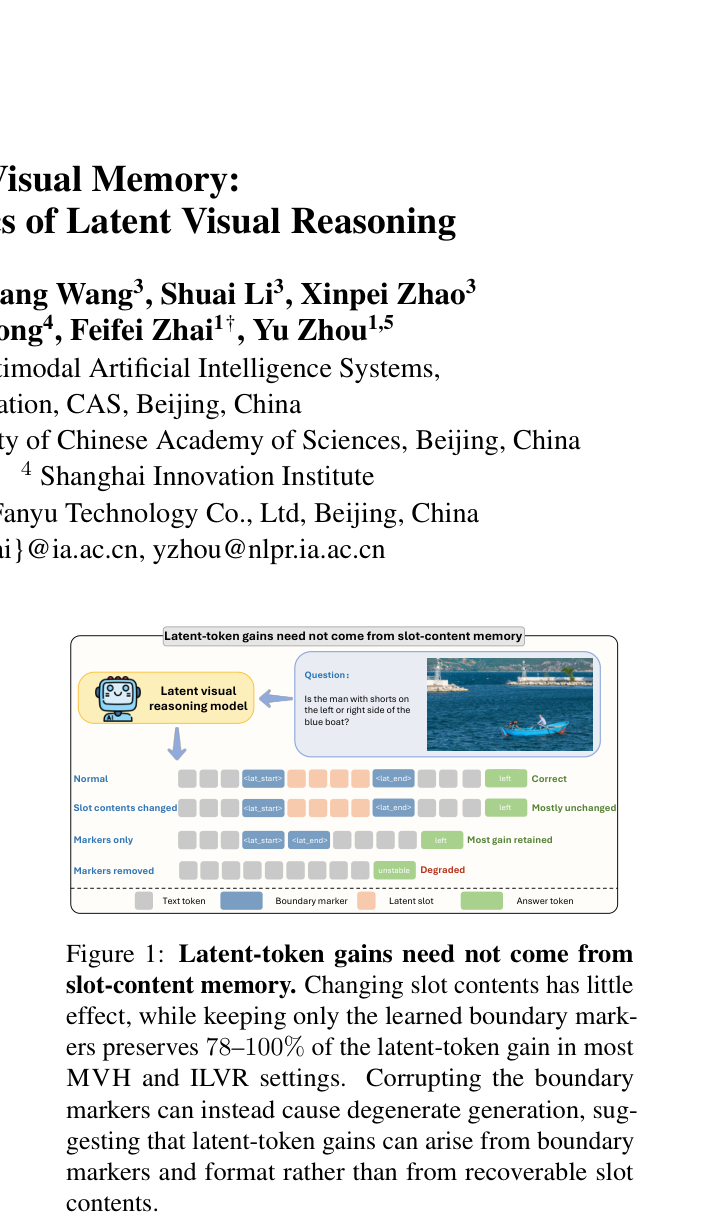
快速导读:该论文将潜在token分解为槽内容、边界标记和格式三个组件,通过构建内容有利的MVH探针,证明潜在槽内容并非可恢复的视觉记忆,潜在token的增益主要来自标记与格式控制及视觉注意力路由。
潜在视觉推理方法通过在MLLM解码序列中插入连续潜在token,被普遍认为能让模型在内部编码可恢复的视觉证据,类似一块内部草图板。本文挑战这一直觉:作者将潜在token分解为槽内容、边界标记和格式三个可独立干预的组件,并构建内容有利的MVH探针,在匹配设置下达到潜在视觉方法中最强精度,为视觉记忆假设提供最有利的检验条件。然而,四类互补测试一致表明,槽内容并非可恢复的视觉记忆,潜在token的增益主要来自标记与格式控制以及视觉注意力路由。
这一发现的重要性在于:相同精度的方法可能依赖截然不同的机制。论文的机制图显示,六种设置在V*基准上精度相近,却在标记依赖性和视觉子空间相似度上分离明显。这意味着仅凭基准精度无法判断一个潜在视觉方法是否真正利用了视觉证据,研究者需要机制诊断来避免被表面指标误导。
英文题目:Beyond Visual Memory: Mechanistic Diagnostics of Latent Visual Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2606.01287
原始论文:PDF / 论文页面
这篇论文解决什么问题?
潜在视觉推理方法在MLLM解码序列中插入连续潜在token,通常以⟨lat_start⟩和⟨lat_end⟩边界标记包裹。主流假设认为,潜在槽内容编码可恢复的视觉证据,模型在生成答案前先在内部"看"一遍图像。这一假设被广泛接受,却缺乏直接的机制检验。
近期分析开始挑战这一假设。CapImagine发现输入对潜在状态影响小、潜在状态对答案影响小,并展示显式文本想象可以匹配或超越潜在空间方法。Viveiros等人发现无信息dummy token几乎不改变精度,推断时潜在状态坍缩到狭窄区域。Zhang等人识别出"沉默视觉潜在"现象。
然而,这些分析都将潜在token视为单一单元,无法定位增益的具体来源。潜在token实际上包含多个可分离的组件:槽内容、边界标记和格式。如果不分解这些组件,就无法判断增益究竟来自视觉记忆、标记控制信号,还是其他机制。这正是本文要填补的研究空白。
核心创新
- 首次将潜在token分解为潜在槽、边界标记和格式三个可独立测试的组件
- 提出MVH内容有利探针,在匹配设置下达到潜在视觉方法中最强精度,为视觉记忆假设提供最有利检验条件
- 通过四类互补测试(扰动、注入、交换、仅标记解码)系统否定槽内容作为可恢复视觉记忆的假设
- 揭示标记与格式控制及视觉注意力路由是潜在token增益的主要来源,并发现相同精度下方法可依赖截然不同的机制
方法概览
将潜在token分解为槽内容、边界标记、格式三个可独立干预的组件;开发MVH(Mesoscale Visual Hypotheses)作为内容有利探针,用覆盖状态(全局均值+3×3区域均值)和问题相关锚点(基于编码器注意力与查询相关性的融合评分选取并重写)监督槽状态,SFT阶段用余弦对齐训练,RL阶段用GRPO优势与余弦对齐优化;随后通过槽内容替换、无图像注入、跨样本交换、仅标记解码四类测试检验视觉记忆假设,并通过标记扰动、自循环率、视觉子空间相似度和注意力熵差诊断标记依赖与视觉参与。
- 将潜在token分解为三个可独立干预的组件:槽内容(边界标记之间的连续状态区间)、边界标记(⟨lat_start⟩/⟨lat_end⟩学习分隔符)、格式(潜在插入的结构模式)。
- 提出MVH(Mesoscale Visual Hypotheses)作为内容有利探针:用覆盖状态(全局均值加3×3区域均值)和问题相关锚点(基于编码器注意力与查询相关性选取并重写的视觉token)监督槽状态。
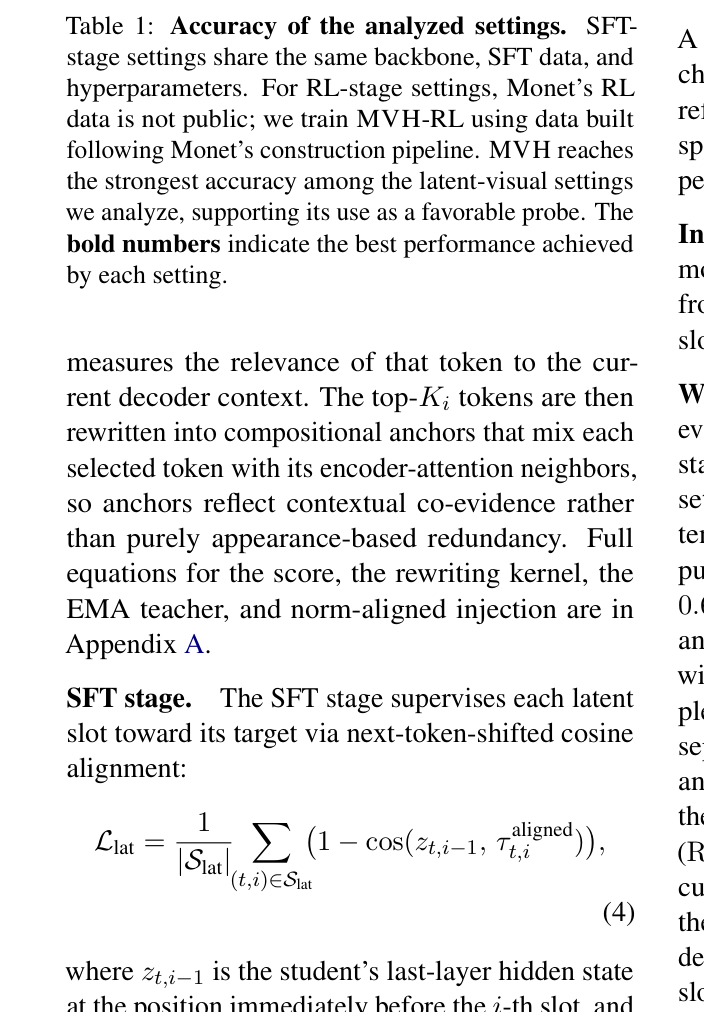
- SFT阶段用余弦对齐训练槽状态逼近视觉目标;RL阶段用GRPO优势与余弦对齐联合优化,使槽内容在训练信号上尽可能接近视觉记忆。
- 四类槽内容测试:替换测试(零向量、随机向量、固定向量替换槽状态)、无图像注入测试(移除图像后注入图像条件下的槽状态)、跨样本交换测试(将真实槽状态从捐赠样本注入目标样本)、仅标记解码测试(保留边界标记、移除槽内容)。
- 标记依赖诊断:零化标记嵌入、替换为未使用特殊token,测量精度下降与自循环生成率。
- 视觉参与诊断:视觉子空间对齐探针(槽状态与投影视觉token表示的top-5余弦相似度)和注意力熵差分析(比较潜在位置与答案位置的图像注意力集中度ΔH)。
逐图理解论文
一个反直觉的失败案例
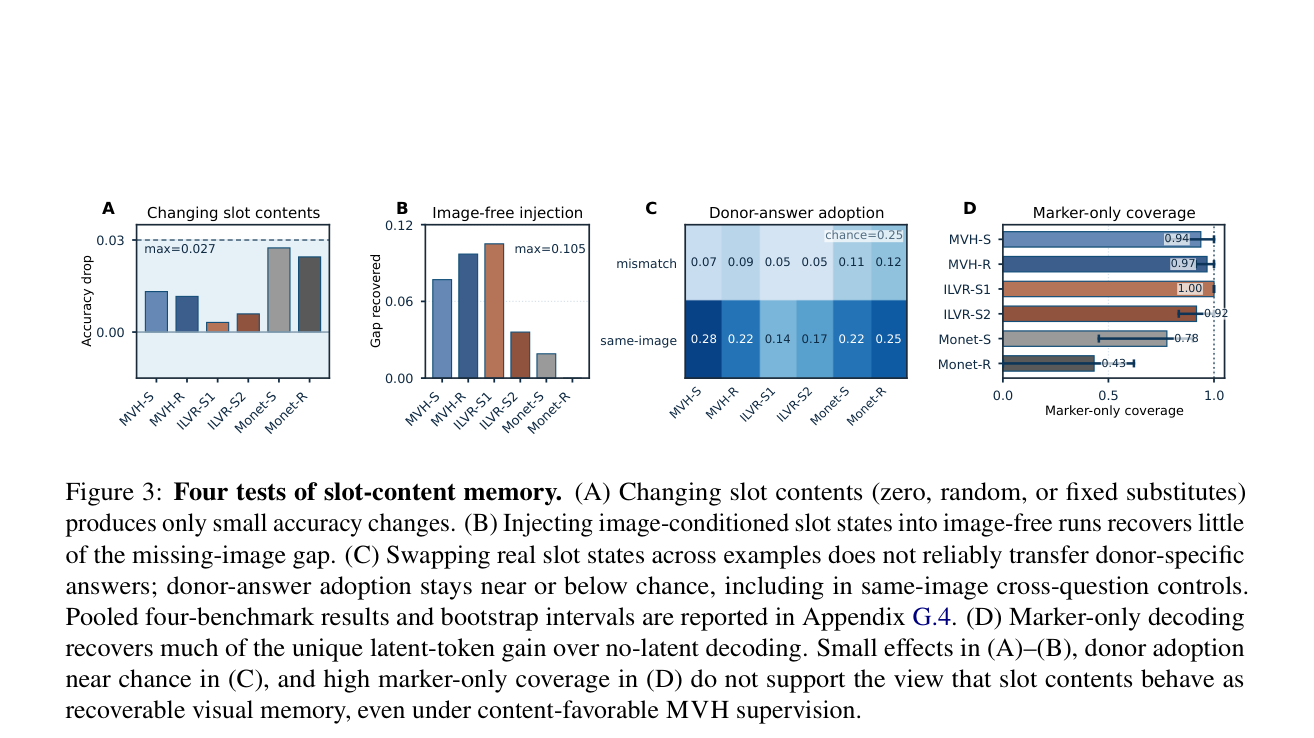
图3汇总四类槽内容测试:替换、注入、交换、仅标记解码。四类测试一致表明槽内容不表现为可恢复的视觉记忆。
研究空白:把潜在token拆开看
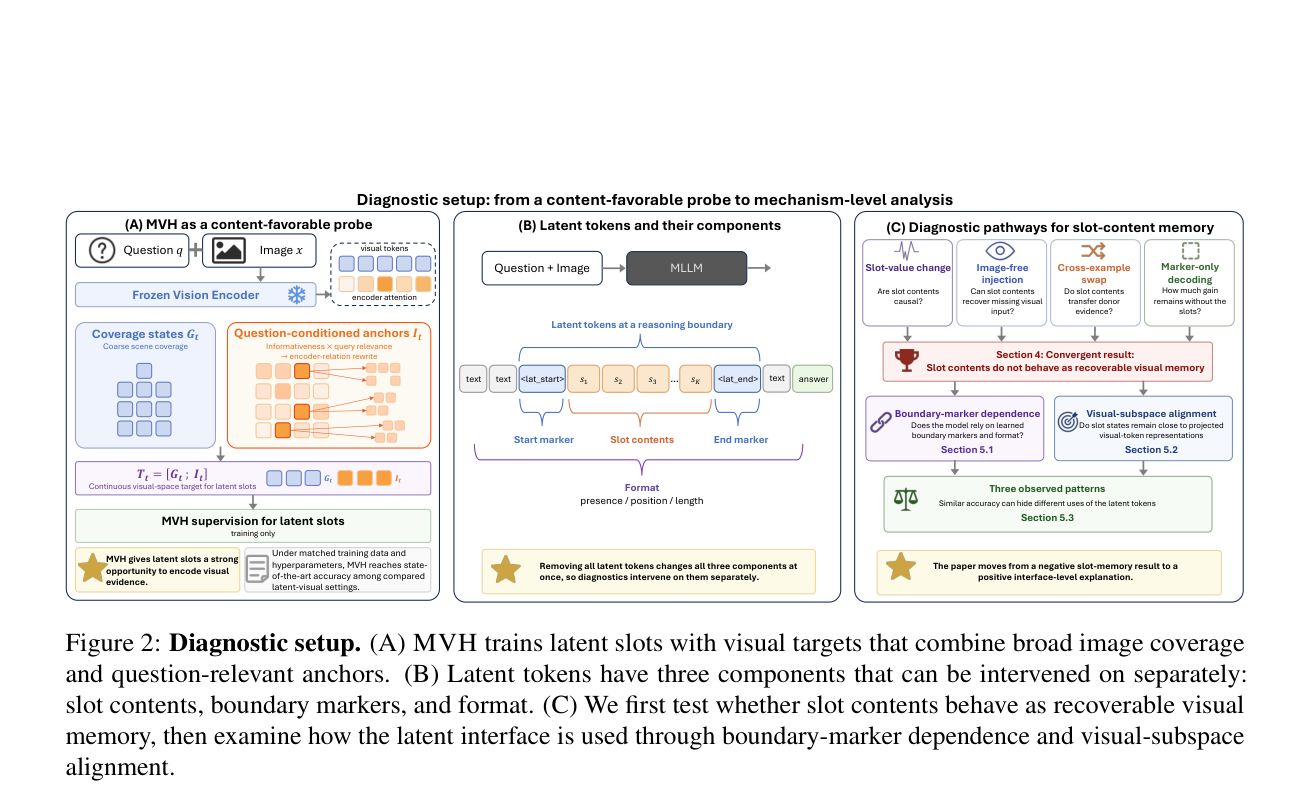
图2展示诊断框架:MVH用覆盖状态和问题相关锚点监督槽状态,潜在token被分解为槽内容、边界标记和格式三个可独立干预的组件。
内容有利探针与四类测试
为了给视觉记忆假设最有利的检验条件,作者提出了MVH探针,用覆盖状态和问题相关锚点监督槽状态,在匹配设置下达到了潜在视觉方法中最强的精度。然后,他们用四类互补测试检验槽内容:替换、无图像注入、跨样本交换、仅标记解码。结果一致表明,槽内容不表现为可恢复的视觉记忆。
标记依赖与视觉注意力路由
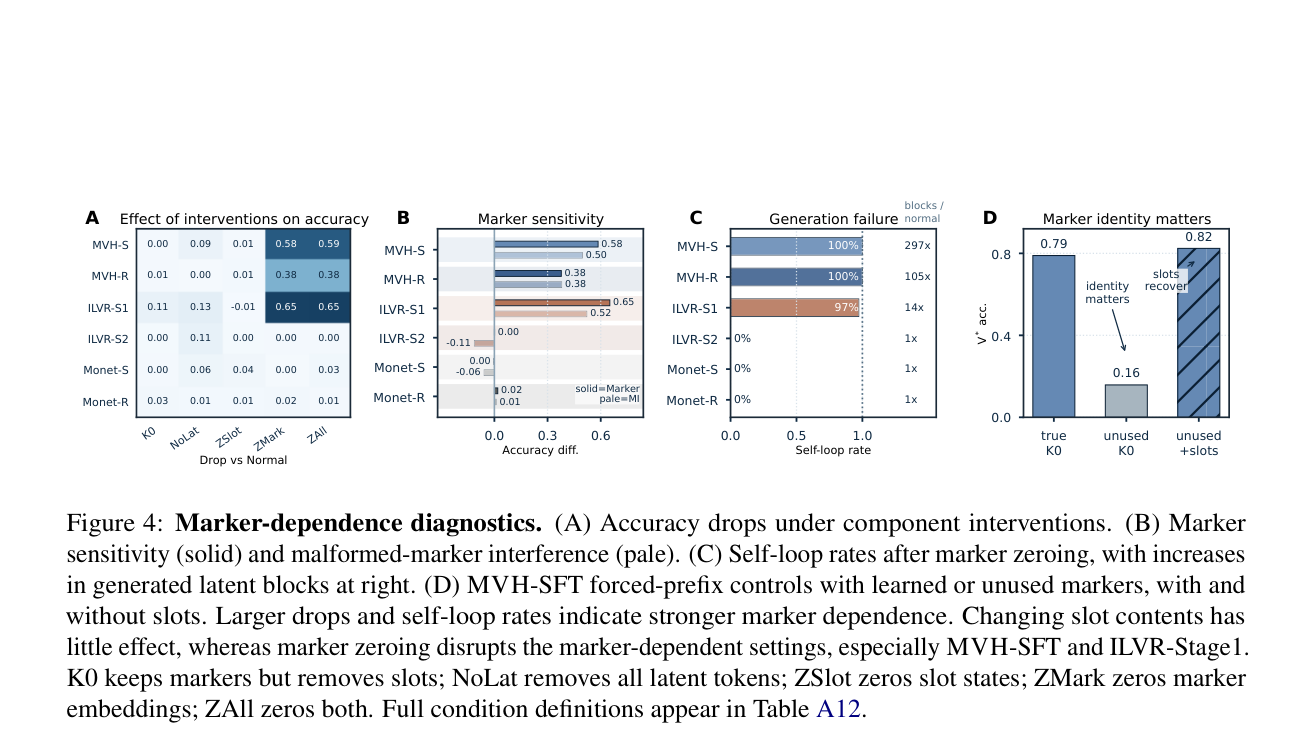
图4展示标记依赖诊断:零化标记嵌入导致MVH-SFT和ILVR-Stage1精度大幅下降并触发自循环生成,而Monet几乎不受影响。
机制图与结论
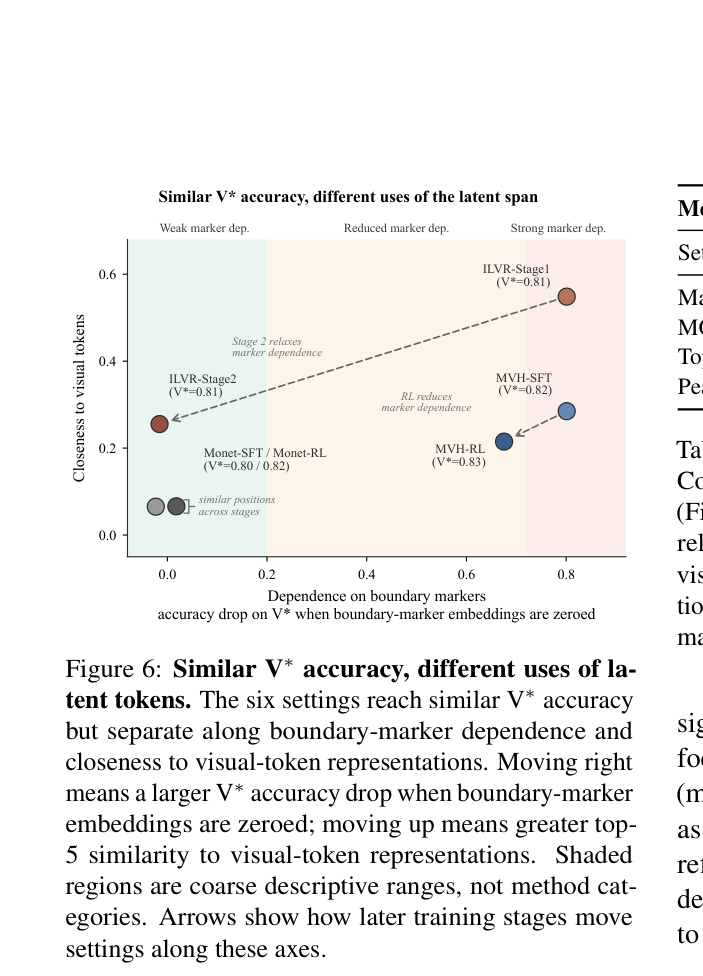
图6是机制图:六种设置在V*精度上相近,却在标记依赖性和视觉子空间相似度上分离明显,箭头显示训练阶段如何移动设置。
实验如何设计?
- 在V*、HRBench-4K、HRBench-8K、MME-RealWorld-Lite四个感知密集型基准上评估六种方法-阶段设置:MVH-SFT、MVH-RL、ILVR-Stage1、ILVR-Stage2、Monet-SFT、Monet-RL。
- SFT阶段设置共享相同骨干、SFT数据和超参数;Monet的RL数据未公开,MVH-RL使用按Monet构建流程自建的数据训练,RL阶段对比非数据匹配。
- 槽内容替换测试在四个基准上汇总,测量精度变化;无图像注入测试的有效子集较小,作者将其视为支持性而非决定性证据。
- 跨样本交换测试包含同图跨问题对照,以排除图像级信息的混淆。
- 标记扰动诊断在六种设置上分别进行,记录精度下降和自循环生成率。
关键结果与论文证据
- MVH-RL平均精度69.7,MVH-SFT平均精度67.8,均优于ILVR和Monet各阶段,支持MVH作为内容有利探针的有效性(第4页,表1)。
- 槽内容替换导致精度变化最大仅0.027,表明槽内容对最终答案的因果贡献极小(第5页,图3A)。
- MVH-SFT无图像注入仅恢复缺失图像差距的7.8%(盲精度0.228→注入后0.276,全图精度0.845),槽内容几乎不携带可转移的视觉证据(第5页,图3B)。
- 跨样本交换的捐赠答案采纳率为5.3–12.7%,所有95% bootstrap区间低于25%随机水平,槽内容不编码样本特定的视觉记忆(第5页,图3C)。
- 仅标记解码在多数MVH和ILVR设置中保留78–100%的潜在token独有增益,边界标记而非槽内容是增益的主要载体(第5页,图3D)。
- 零化标记嵌入导致MVH-SFT精度下降0.585,ILVR-Stage1下降0.651,MVH-RL下降0.378,而ILVR-Stage2和Monet下降≤0.02,标记依赖性在不同设置间差异巨大(第6页,图4B)。
- MVH-SFT和ILVR-Stage1在零化标记后自循环率接近100%(MVH-SFT 100%,ILVR-Stage1 97%),Monet各阶段为0%,标记承担格式控制功能(第6页,图4C)。
- MVH和ILVR的峰值ΔH在1.90–2.43之间(层25–27),Monet峰值ΔH<1.0,表明MVH和ILVR的潜在token参与视觉注意力路由,而Monet不参与(第7页,图5)。
阅读时需要注意
- 分析仅覆盖使用全图VLM接口并在解码序列中插入潜在槽的方法,更强视觉瓶颈或外部视觉工作空间的架构可能表现不同。
- 研究基于Qwen系列骨干和感知密集型基准,更广泛的模型家族、视频输入、具身任务或长程规划可能引入额外用途。
- 诊断仅检验槽内容是否作为可恢复视觉记忆,不排除槽提供计算、时序、格式化或路由容量的其他角色。
关联工作
- CapImagine发现输入对潜在状态影响小、潜在状态对答案影响小,并展示显式文本想象匹配或超越潜在空间方法,与本文的槽内容否定结论一致。
- Viveiros等人发现无信息dummy token几乎不改变精度,推断时潜在状态坍缩到狭窄区域,为标记控制信号假设提供独立支持。
- Let's Think Dot by Dot展示无内容filler token可支持文本Transformer中的隐藏计算,与本文标记控制信号发现平行。
- Mirage、LVR、ILVR、Monet是本文分析的代表性潜在视觉推理方法,其中ILVR和Monet的多个训练阶段被直接对比。