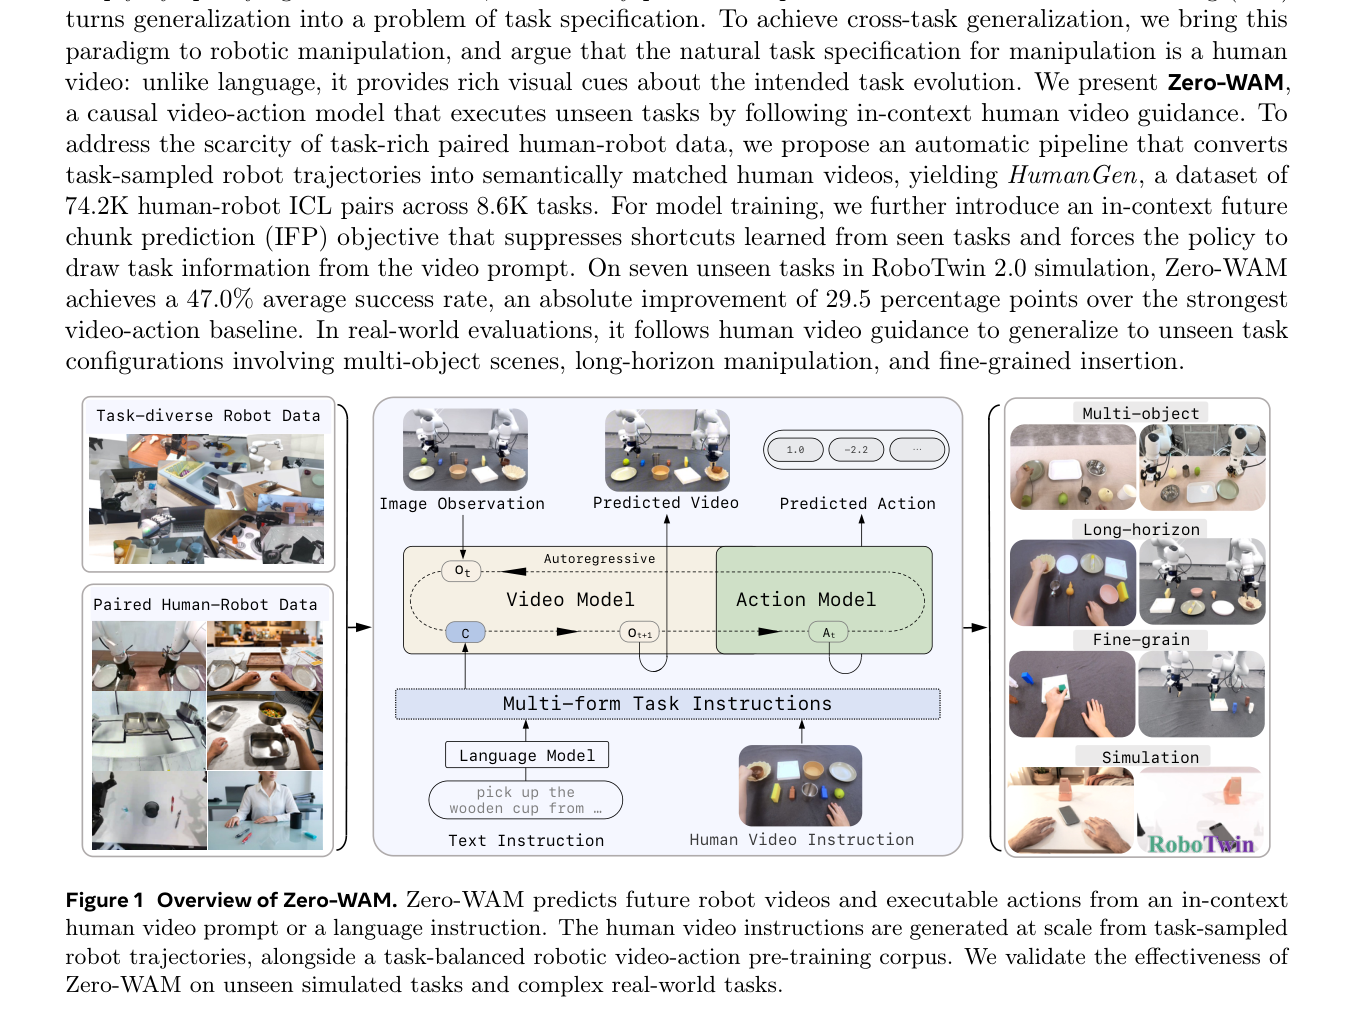
快速导读:Zero-WAM 提出以人类视频作为上下文任务指令,通过大规模自动生成的人-机器人配对数据(HumanGen)和上下文未来块预测(IFP)目标,实现零样本跨任务机器人操作泛化。
Zero-WAM 的核心主张是:零样本跨任务泛化的瓶颈不在模型容量,而在任务规格的充分性与训练数据的任务多样性。语言指令往往欠指定操作任务,无法表达空间约束、中间状态和时间结构;而人类演示视频能直接呈现期望的视觉状态变化,是更自然的任务接口。Zero-WAM 将这一直觉形式化为上下文世界-动作建模,使单一策略既能接受语言指令,也能接受人类视频指令。
论文的贡献集中在三个层面:数据层面,提出可扩展的上下文人类视频生成流水线,从任务采样机器人轨迹自动生成语义匹配的人类视频,构建 HumanGen 数据集;训练层面,提出 IFP 上下文未来块预测目标,迫使主视频分支编码人类视频中的任务信息而非学习捷径;评估层面,在 RoboTwin 2.0 仿真与真实双臂 Franka 机器人上验证了零样本跨任务泛化能力。
英文题目:Zero-WAM: In-Context World-Action Modeling from Human Videos for Open-Ended Task Generalization
论文出处:arXiv 每日论文精选 · arXiv:2608.26103
原始论文:PDF / 论文页面
这篇论文解决什么问题?
零样本跨任务泛化要求策略执行训练中未见过的操作任务。现有 VLA 和 video-action 模型主要依赖语言作为任务接口,但语言难以充分表达空间约束、中间状态和时间结构。例如,'把杯子放到盘子上'无法精确描述放置位置、姿态和中间动作序列。
人类演示视频能直接呈现期望的视觉状态变化,是更自然的任务规格。但大规模任务丰富的人-机器人配对数据稀缺且昂贵:人工采集人类演示成本高,且难以覆盖多样化的机器人 embodiment 和任务分布。
更深层的问题是捷径学习。当模型同时接收人类视频和机器人视频时,它可能忽略人类视频中的任务信息,仅依赖机器人视频的视觉线索预测动作。这使得上下文视频指令形同虚设,模型无法真正泛化到新任务。
核心创新
- 将零样本机器人任务泛化形式化为上下文世界-动作建模,单一策略同时支持语言和人类视频指令
- 提出可扩展的上下文人类视频生成流水线,自动将任务采样机器人轨迹转换为语义匹配的人类视频,构建 HumanGen 数据集(74.2K 人-机器人 ICL 对,8.6K 任务)
- 提出 Task-diverse VA 任务均衡采样策略,将公共机器人数据重新划分为 6000+ 任务,每 epoch 约 400K 轨迹
- 提出 IFP(in-context future chunk prediction)目标,预测多个跨步未来视频块,迫使主视频分支编码人类视频中的任务信息
- 使用 RoPE 高度轴偏移区分 ICL 人类视频与机器人视频潜在表示
方法概览
Zero-WAM 是一个因果 video-action 模型,支持语言和人类视频两种任务指令。通过任务级采样机器人轨迹并自动生成语义匹配的人类视频,构建 HumanGen 数据集(74.2K 对,8.6K 任务);同时构建 Task-diverse VA 任务均衡预训练语料。训练时引入 IFP 目标,从当前机器人视频表示预测多个跨步未来视频块,抑制捷径学习。模型基于 Wan-2.2-TI2V-5B,采用 Mixture-of-Transformers 架构,视频 Transformer 预测未来视频块,动作 Transformer 通过逆动力学解码动作。
- Zero-WAM 基于 Wan-2.2-TI2V-5B,采用 Mixture-of-Transformers 架构:视频 Transformer 预测未来视频块,动作 Transformer 通过逆动力学从预测的未来视频解码动作。
- 任务指令支持两种形式:语言指令或人类视频指令。人类视频作为上下文前缀,与当前机器人视频拼接后输入模型。
- HumanGen 数据构建:从任务采样机器人轨迹出发,通过 VLM 和视频生成模型自动转换为语义匹配的人类视频,保留任务语义但改变 embodiment、背景、视角和物体实例。
- Task-diverse VA 任务均衡采样:将公共机器人数据重新划分为 6000+ 任务,每 epoch 约 400K 轨迹,避免任务分布不均导致的偏置。
- IFP 目标:从当前机器人视频表示预测多个跨步未来视频块,迫使主视频分支编码人类视频中的任务信息,抑制捷径学习。
- RoPE 高度轴偏移:区分 ICL 人类视频与机器人视频的潜在表示,避免位置编码混淆。
- 训练采用 teacher forcing 与 flow matching,推理时使用 classifier-free guidance 生成未来视频并解码动作。
逐图理解论文
研究缺口
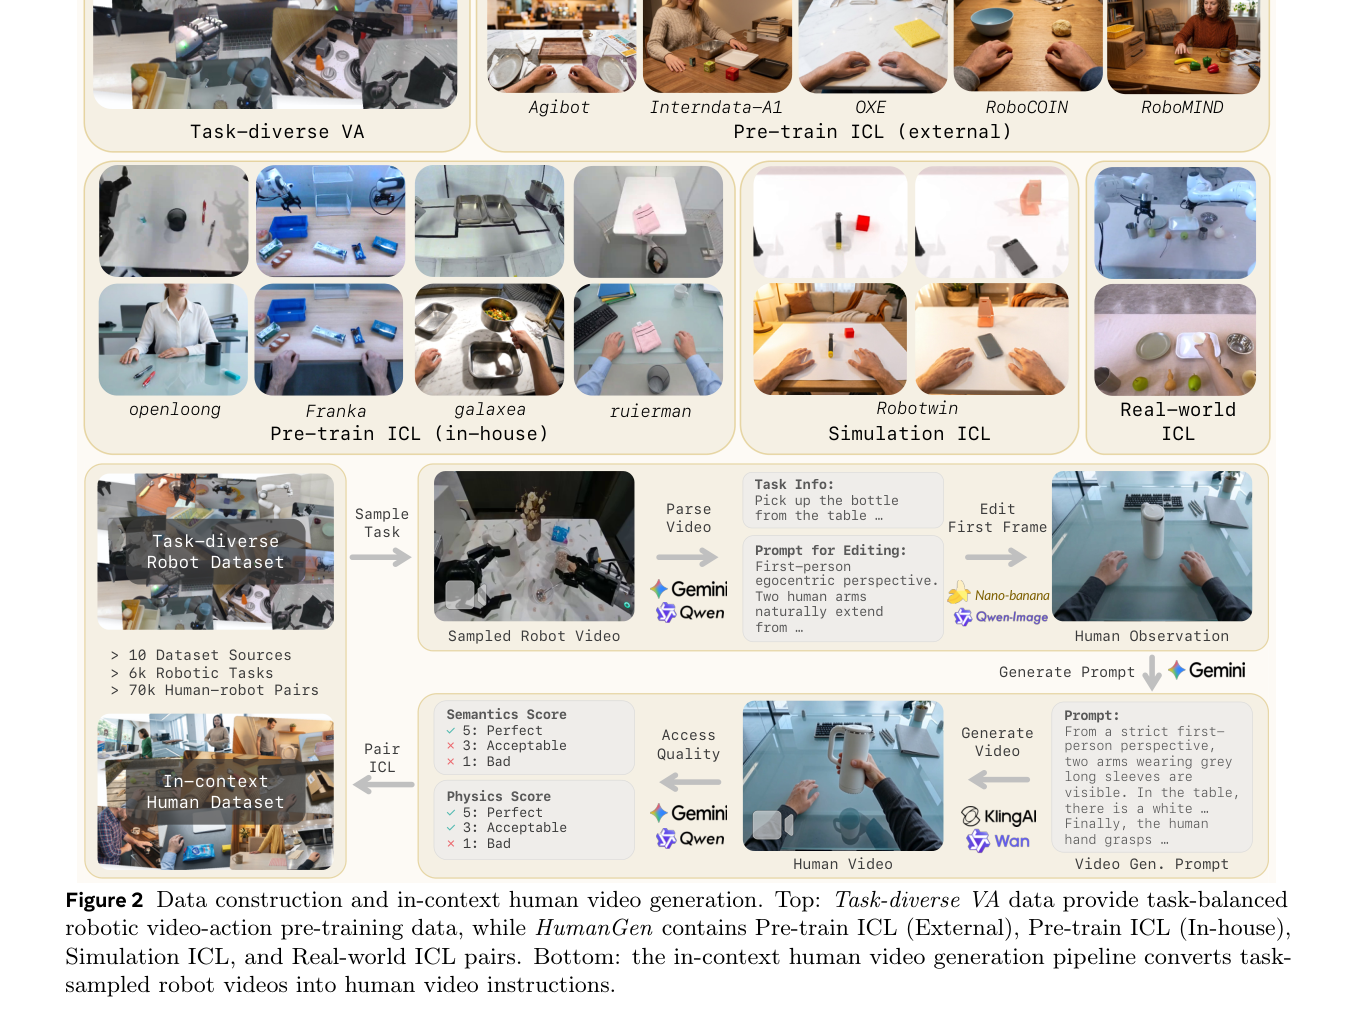
上半部分展示 Task-diverse VA 数据与 HumanGen 的构成,下半部分展示人类视频生成流水线:从任务采样机器人视频出发,经 VLM 和视频生成模型转换为语义匹配的人类视频。
实验验证
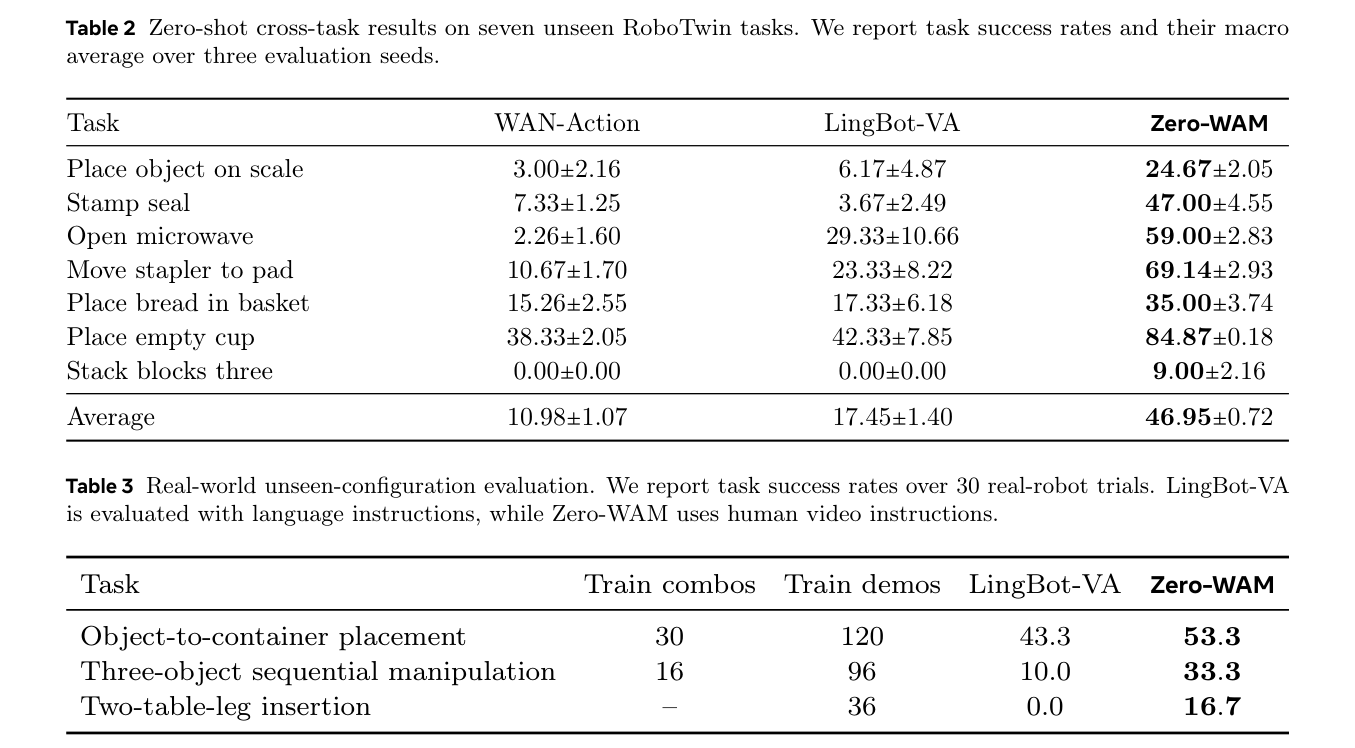
查看 7 个未见任务的成功率对比,Zero-WAM 在所有任务上均优于基线,尤其在长时序任务 stack blocks three 上实现非零突破。
消融与结论
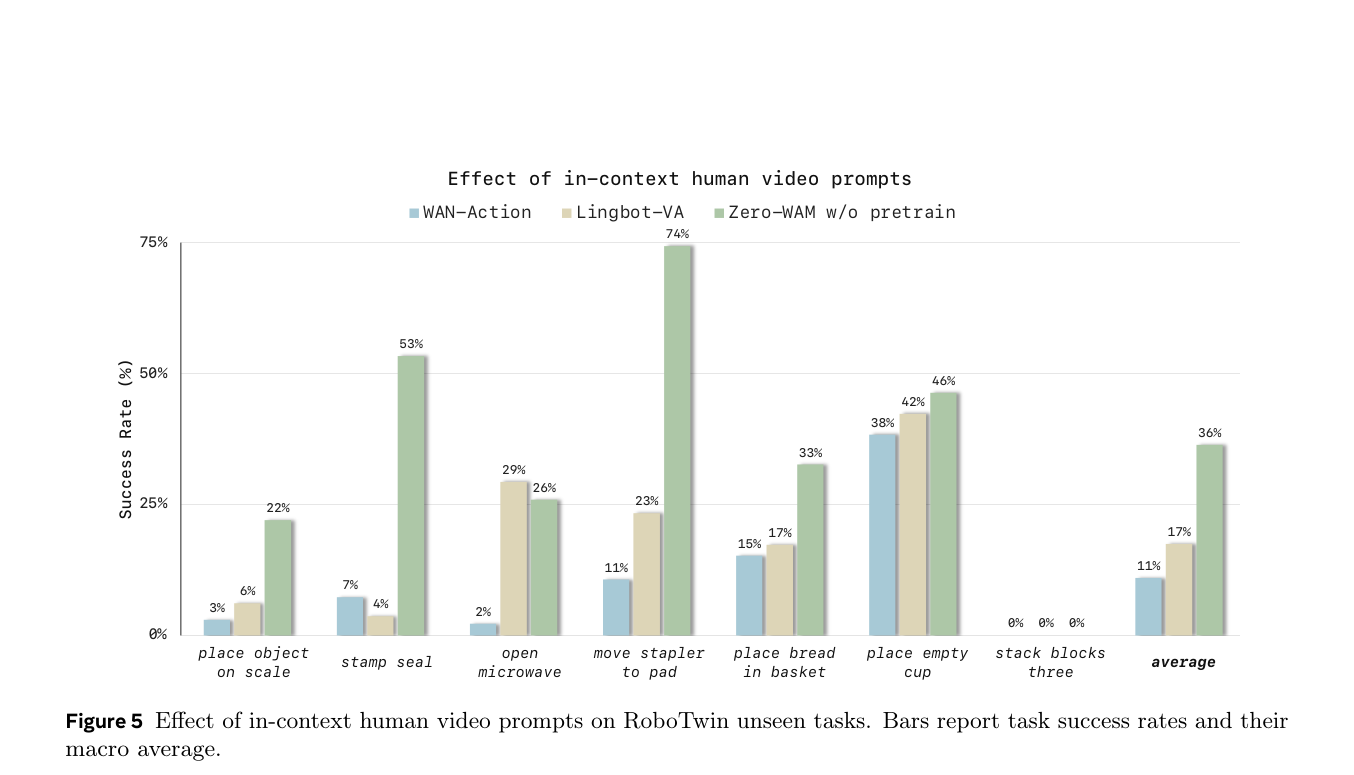
柱状图展示加入人类视频指令后的提升效果,验证 ICL 人类视频提示对零样本泛化的贡献。
实验如何设计?
- RoboTwin 2.0 仿真:7 个未见任务零样本跨任务评估,涵盖未见物体操作、关节物体操作、双臂操作和长时序操作,3 个随机种子,每任务 100 次闭环 rollout。
- 真实世界:双臂 Franka 机器人,3 个任务族(物体到容器放置、三物体顺序操作、双桌腿插入),每任务族 30 次试验。
- 消融一:ICL 人类视频提示效果,比较仅用已见 RoboTwin 任务训练时有无人类视频指令的差异。
- 消融二:IFP 模块,比较完整 Zero-WAM 与去除 IFP 的变体。
- 消融三:任务均衡机器人预训练数据,比较 LingBot-VA 与 text-only Zero-WAM 变体。
关键结果与论文证据
- Zero-WAM 在 RoboTwin 7 个未见任务上平均成功率 46.95%,比 LingBot-VA(17.45%)绝对提升 29.50 个百分点,比 WAN-Action(10.98%)提升 35.97 个百分点(Table 2, p.11)。
- Zero-WAM 在所有 7 个未见任务上均优于两个基线;place empty cup 达 84.87%,stack blocks three 是唯一非零方法(9.00%)(Table 2, p.11)。
- 真实世界物体到容器放置:Zero-WAM 53.3% vs LingBot-VA 43.3%(Table 3, p.11)。
- 真实世界三物体顺序操作:Zero-WAM 33.3% vs LingBot-VA 10.0%(Table 3, p.11)。
- 真实世界双桌腿插入:Zero-WAM 16.7% vs LingBot-VA 0.0%(Table 3, p.11)。
- 消融:仅用 43 个已见 RoboTwin 任务训练时,加入人类视频指令将平均成功率从 10.98% 提升至 36.36%(Figure 5, p.13)。
- 消融:IFP 将 7 任务平均成功率从 28.55% 提升至 46.95%,并在 stack blocks three 上从 0.00% 突破至 9.00%(Figure 6, p.14)。
- 消融:text-only Zero-WAM 变体达 39.44%,比 LingBot-VA 高 21.99 个百分点,验证任务均衡采样的贡献(Figure 6, p.14)。
阅读时需要注意
- 实验主要聚焦静态桌面操作,未扩展到移动操作和更长时序任务。
- stack blocks three 等长时序未见任务成功率仍较低(9.00%),长时序泛化仍是挑战。
- 真实世界双桌腿插入成功率有限(16.7%),受精确物理插入难度制约。
- 人类视频由生成模型合成,可能引入物理不合理或语义偏差,数据质量依赖 VLM 和视频生成模型能力。
- 预训练耗时 15,360 GPU hours,计算成本高,限制了快速迭代和复现。
关联工作
- LingBot-VA 是 Zero-WAM 直接继承的因果 video-action 框架,使用 Wan-2.2 初始化,并作为主要基线。
- WAN-Action 是基于 Wan-2.2-TI2V-5B 的直接基线,仅用已见 RoboTwin 任务训练。
- IFP 目标借鉴 Next Forcing 的多块预测思想。
- BC-Z 是使用人类视频作为任务提示的早期工作,但依赖人工收集演示,难以扩展。
- Vid2Robot 采用端到端视频条件策略学习,使用交叉注意力 Transformer。
- WAM-TTT 通过测试时训练从原始人类视频引导冻结 WAM,与 Zero-WAM 的零样本路径形成对比。