SimVTA:用仿真对齐驾驶世界模型的视频与轨迹
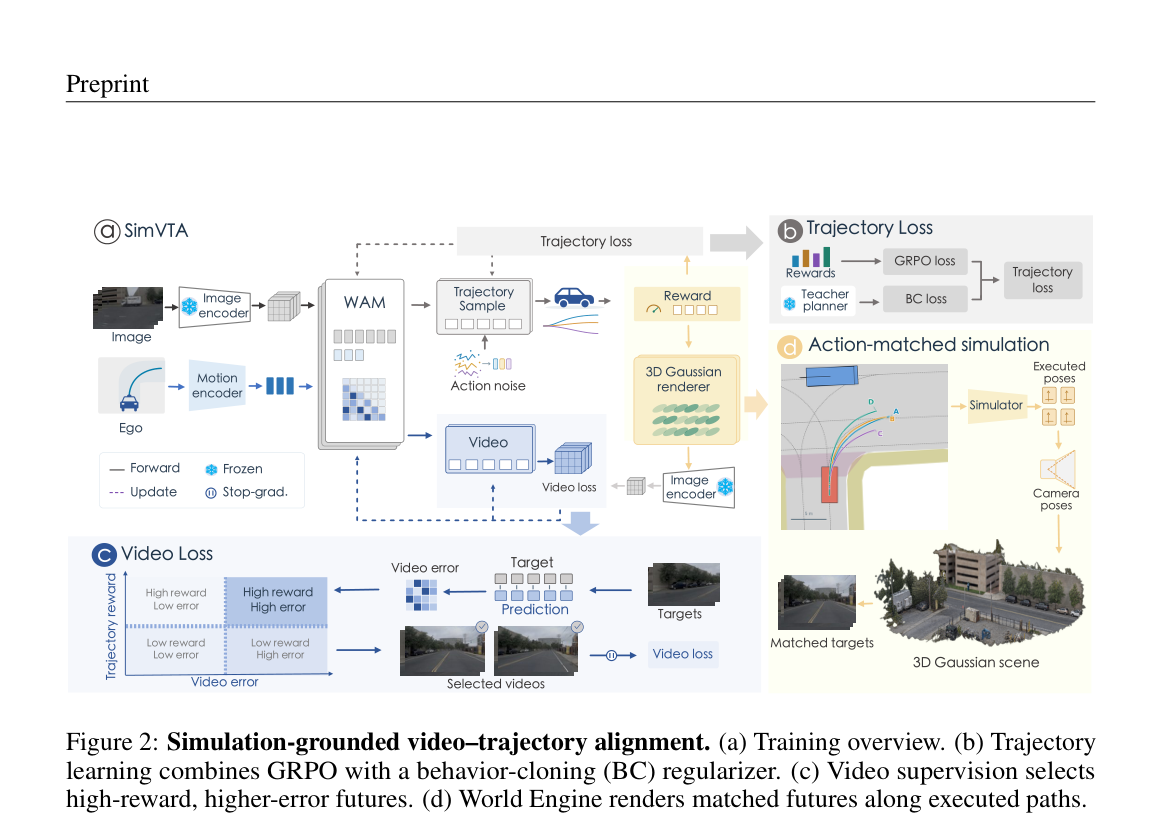
SimVTA 用 World Engine 沿当前策略候选轨迹渲染匹配未来视频,把轨迹 GRPO 与高误差视频监督接到共享表征上,弥补驾驶日志只覆盖已记录动作的缺口。
SimVTA 用 World Engine 沿当前策略候选轨迹渲染匹配未来视频,把轨迹 GRPO 与高误差视频监督接到共享表征上,弥补驾驶日志只覆盖已记录动作的缺口。
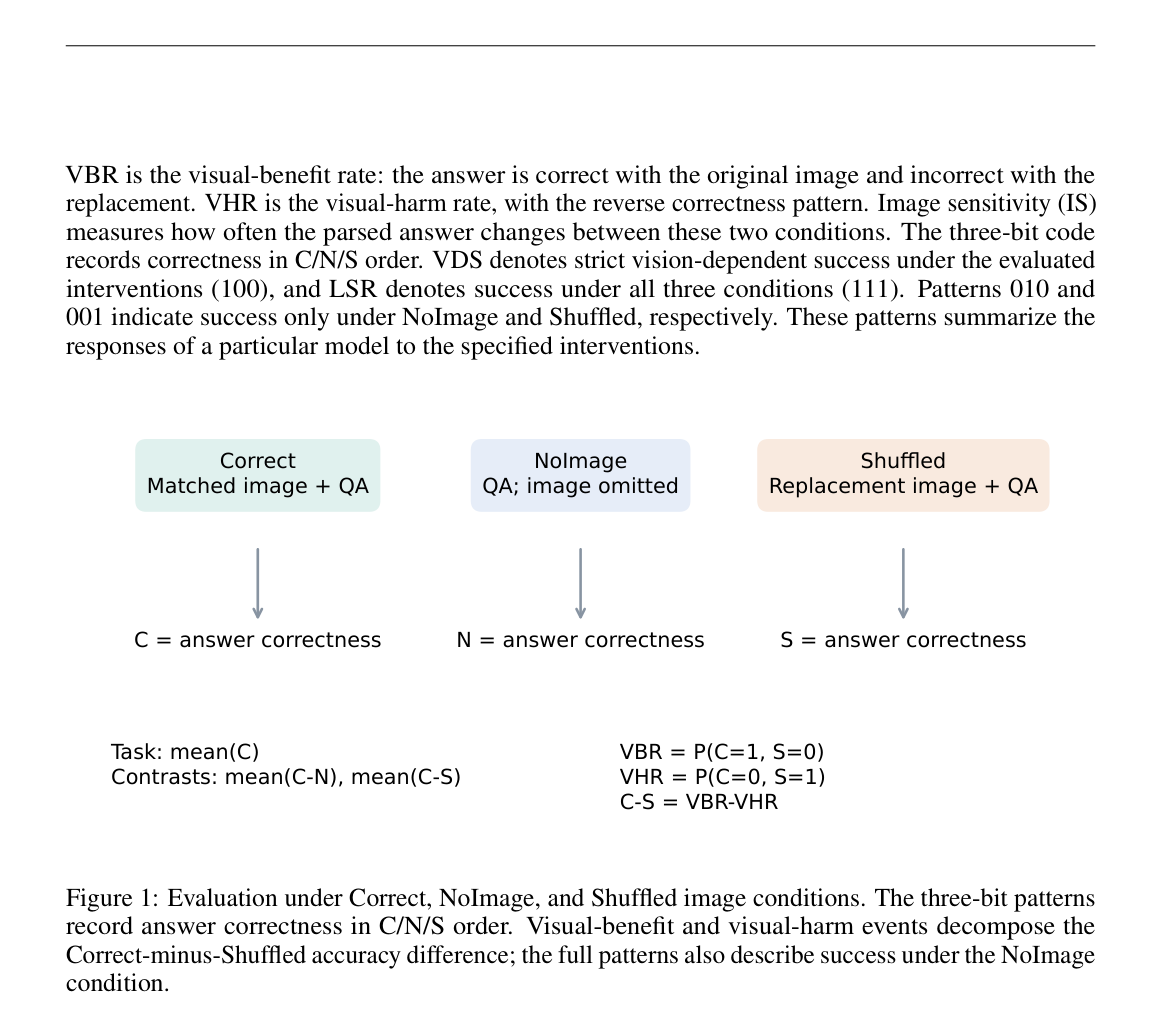
在 Qwen2.5-VL-3B 与 PMC-VQA 上,用正确/无图/打乱图干预与配对转移,审计 SFT 与 GRPO 后训练如何改写个体图像收益,而非只看平均准确率;本文是研究审计,不是临床产品。
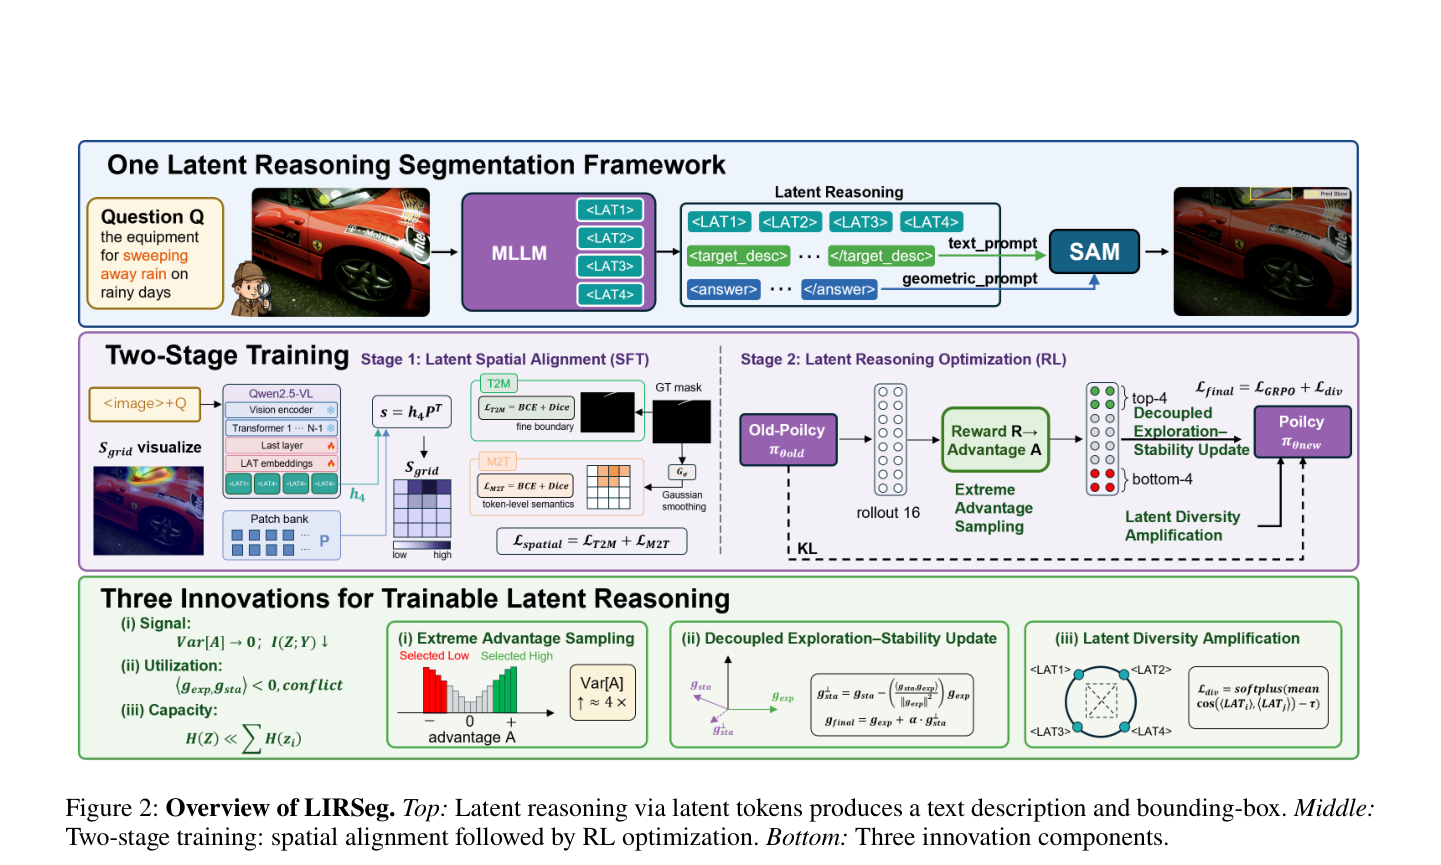
LIRSeg 用少量可学习潜空间令牌完全替代显式 CoT,经空间对齐与 GRPO,并配合 EAS/DES/LDA,在推理分割上提点同时把推理令牌压到约十六分之一。
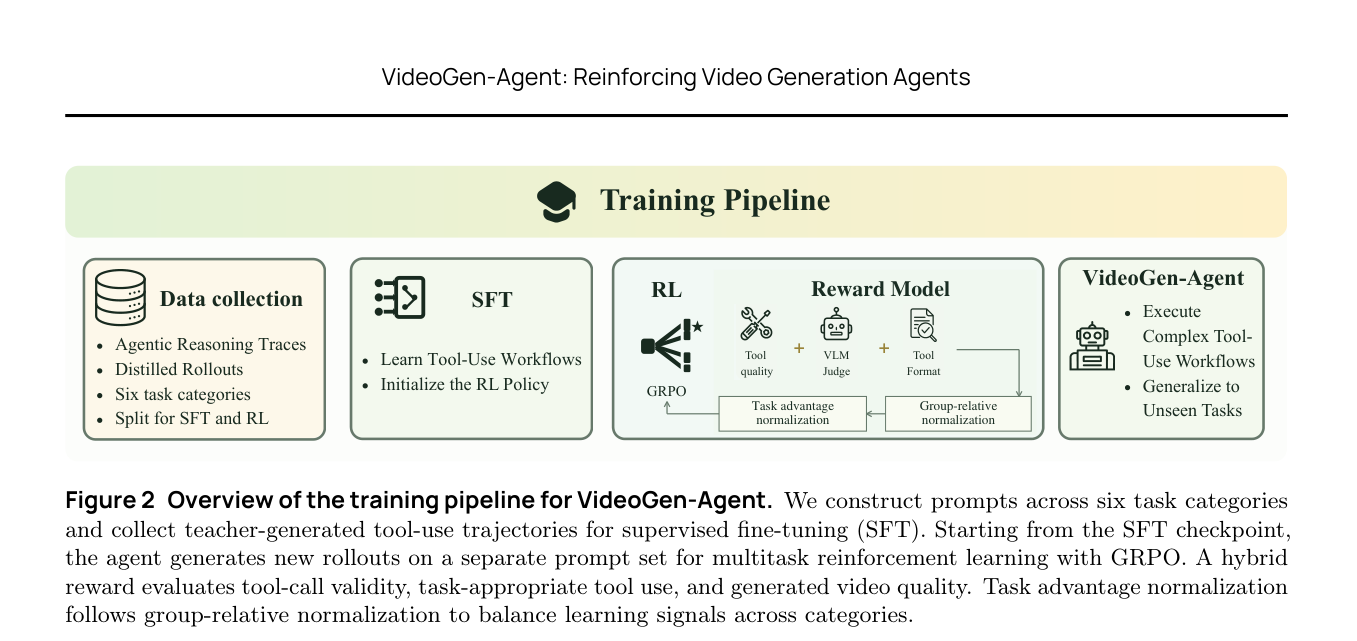
VideoGen-Agent 用教师轨迹监督微调和多任务 GRPO,训练一个共享策略去调度检索、仿真、生成与校验工具,并可用更强生成器替换后端。
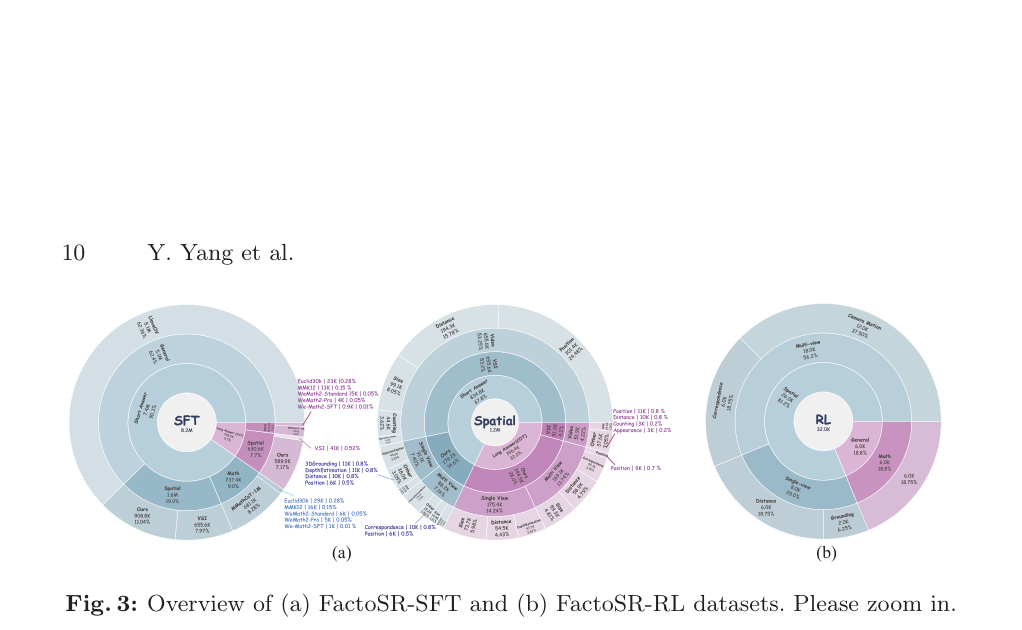
FactoSR提出了一种基于分解式强化学习(Factorized RL)的框架,通过解耦XY平面、Z深度和T时间维度的可验证奖励,显著提升了VLM在4D空间推理任务中的表现。
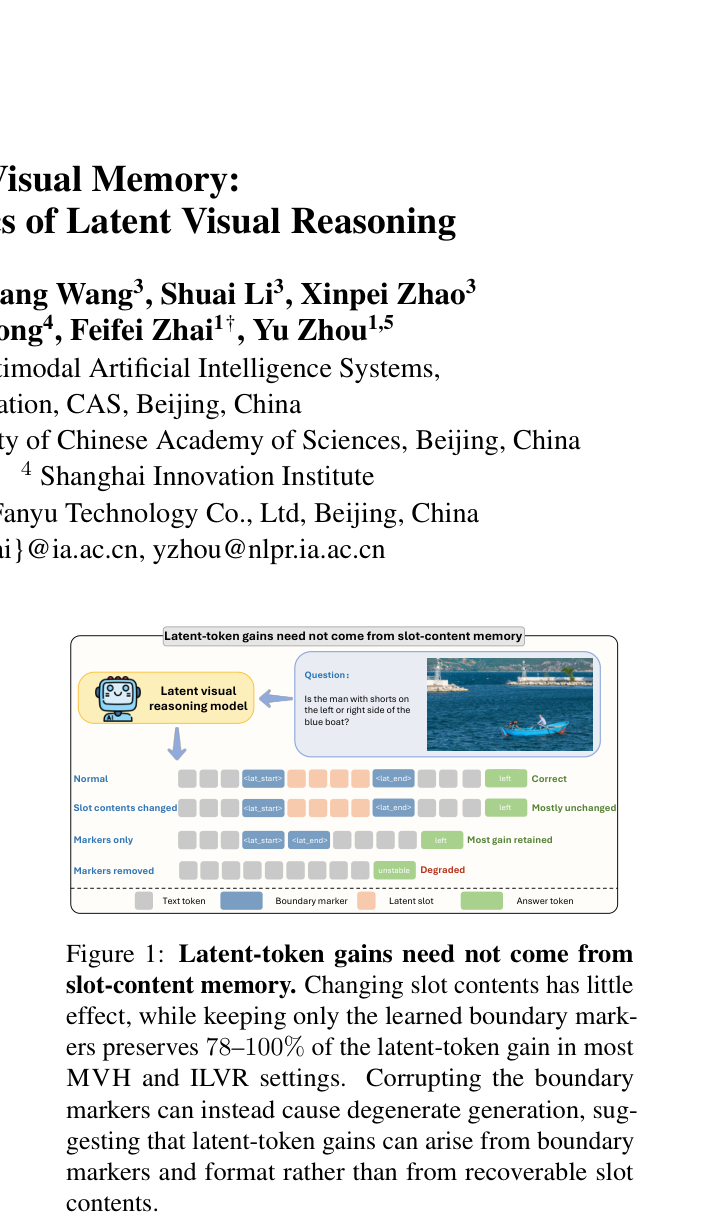
该论文将潜在token分解为槽内容、边界标记和格式三个组件,通过构建内容有利的MVH探针,证明潜在槽内容并非可恢复的视觉记忆,潜在token的增益主要来自标记与格式控制及视觉注意力路由。
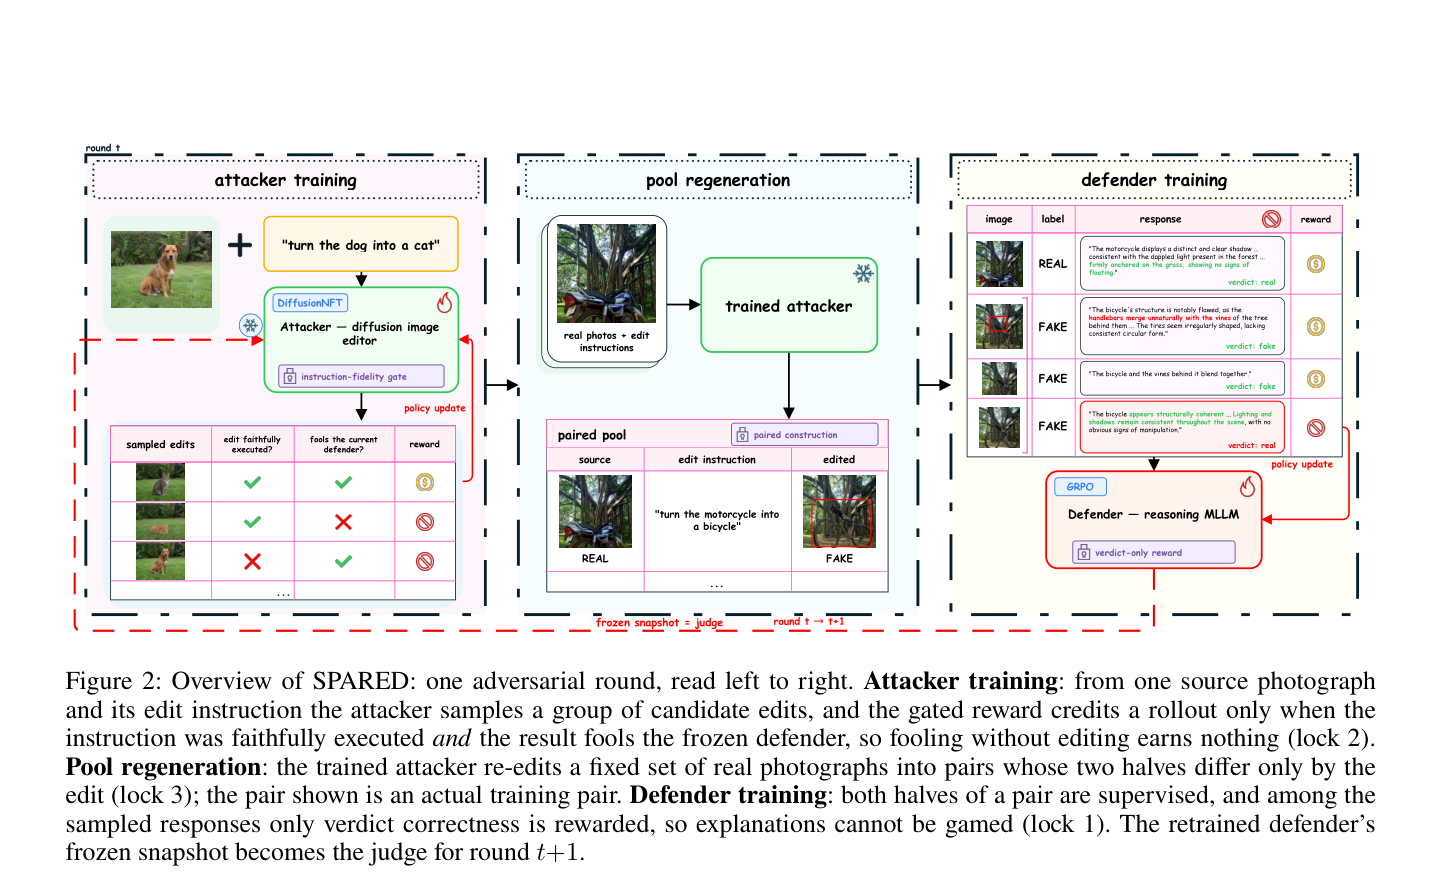
SPARED的核心判断是:来源捷径、模板化解释和静态决策边界,这三个问题看似独立,其实都源于同一个根源——训练数据的构造方式。如果真实图和假图来自不同渠道,检测器就学会分辨渠道;如果解释语料是模板生成的,检测器就学会背模板;如果训练集固定不变,检测器的边界就静止不动。所以关键不是换更大的模型,而是换一种造数据的方式。
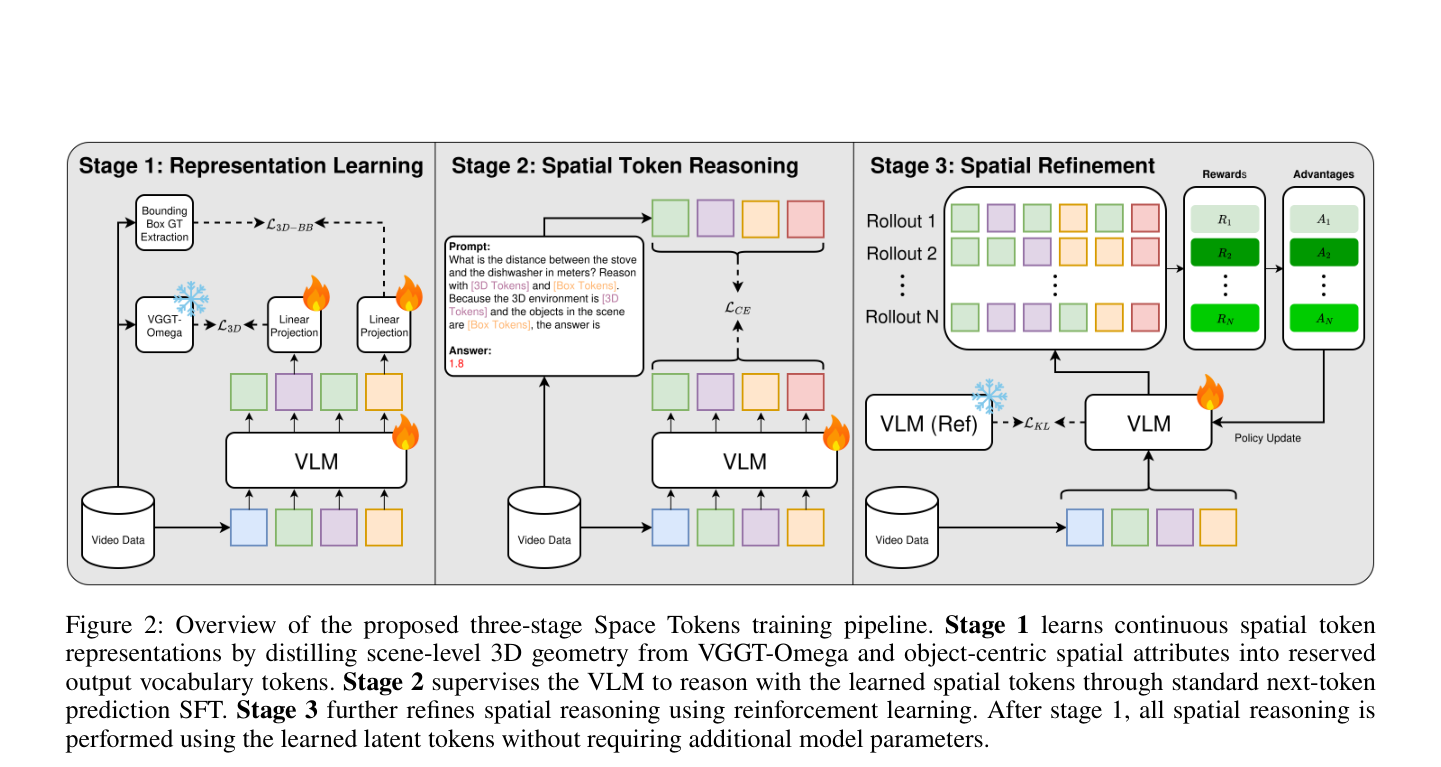
提出 Space Tokens 框架,将场景级 3D 几何与物体中心空间属性蒸馏为连续潜在 token,在不增加推理模块的前提下提升 VLM 空间推理能力。