快速导读:Forge4D是首个从未标定稀疏视角视频中以流式方式实现度量尺度4D人体-物体重建、新视角合成与任意时刻插值的前馈模型。
Forge4D要回答的核心问题是:能否在不依赖迭代优化、不要求相机标定的前提下,从几段稀疏视角视频中直接前馈式地重建出度量尺度正确的4D人体-物体场景,并且还能生成输入帧之间任意时刻的3D表示?这个问题之所以难,是因为动态场景重建传统上被拆成两个互相牵制的子问题:一是从图像恢复几何与相机,二是从时间序列恢复运动。前者已有VGGT等视觉几何基础模型可以前馈完成,但输出是点云,无法光真实渲染;后者则长期依赖稠密多视角视频和逐场景优化。
Forge4D的答案是:把4D重建分解为流式3D高斯重建与密集运动预测两个任务,并用三阶段训练将它们耦合起来。第一阶段先学会从稀疏视角图像前馈重建静态3DGS,同时引入metric gauge把尺度对齐到真实世界;第二阶段用可学习的state token以流式方式传递时序信息;第三阶段预测每个3D高斯的双向运动,并通过retargeting loss和occlusion-aware optical flow loss自监督优化,最终用occlusion-aware fusion MLP合并变形后的3DGS实现新时刻合成。
英文题目:Forge4D: Feed-Forward 4D Human Reconstruction and Interpolation from Uncalibrated Sparse-View Videos
论文出处:arXiv 每日论文精选 · arXiv:2509.24209
原始论文:PDF / 论文页面
这篇论文解决什么问题?
动态场景重建的经典路线是迭代优化:对每一段视频,反复调整3D表示和相机参数,直到渲染结果与输入图像一致。这类方法精度可以很高,但速度慢,且通常要求相机已经标定。一旦相机未标定,优化空间急剧增大,收敛变得困难。
前馈方法试图绕开迭代优化。VGGT等模型可以从无标定图像序列中直接预测点云和相机位姿,但点云本身无法支撑光真实渲染。NoPoSplat和AnySplat把前馈思想扩展到无标定3DGS重建,然而它们只处理静态场景。L4GM虽然迈出了前馈4D重建的一步,但分辨率低、真实场景泛化差,且因GPU内存限制最多输入8个时间戳。
更根本的困难在于监督信号。动态场景缺乏密集运动真值,无法直接监督每个3D高斯的运动。Forge4D的应对策略是:不追求显式的运动标注,而是通过渲染一致性来间接监督运动——预测的运动把3DGS变形到目标时刻后,渲染结果应当与目标帧一致。这种自监督思路把运动学习转化为一个可微的渲染问题。
此外,尺度问题在无标定设置下尤为突出。VGGT输出的点云尺度是任意的,如果直接用于3DGS重建,新视角光度监督会因尺度漂移而不稳定。Forge4D提出metric gauge正则化,强制模型输出与真实世界度量尺度对齐,这是后续所有模块能够稳定训练的前提。
核心创新
- 首个从未标定稀疏视角视频实现度量尺度4D人体-物体重建的前馈模型
- 提出metric gauge正则化,将VGGT输出尺度与真实世界度量尺度对齐,稳定新视角光度监督
- 提出state token流式机制,分解空间与时间维度,以内存友好方式实现时序一致性
- 将密集运动预测形式化为3D高斯点匹配任务,提出自监督retargeting loss
- 提出occlusion-aware optical flow loss,利用SEA-RAFT伪光流和循环一致性掩码增强运动合理性
- 提出运动引导的occlusion-aware Gaussian fusion方法,消除时序冗余并抑制闪烁伪影
方法概览
Forge4D将4D重建分解为流式3D高斯重建与密集运动预测两个任务,采用三阶段训练:(1)基于VGGT骨干的静态前馈3DGS重建,引入metric gauge对齐真实世界尺度;(2)引入可学习state token以流式方式传递时序信息,保证跨帧尺度一致性;(3)密集运动预测模块预测每个3D高斯的双向运动,通过retargeting loss和occlusion-aware optical flow loss自监督优化,并用occlusion-aware fusion MLP融合变形后的3DGS实现新时刻合成。
- 三阶段训练框架:第一阶段训练静态前馈3DGS重建,以VGGT为骨干,从稀疏视角图像预测3D高斯和相机位姿;第二阶段引入可学习的state token,以流式方式逐帧传递时序信息,保证跨帧尺度一致性;第三阶段训练密集运动预测模块,预测每个3D高斯的双向运动。
- metric gauge正则化:在静态重建阶段,通过正则化项约束VGGT输出的尺度,使其与真实世界度量尺度对齐。论文第6页的gauge示意图展示了尺度对齐前后的差异。这一设计使新视角光度监督在训练中保持稳定,也为后续运动预测提供了尺度一致的几何基础。
- state token流式机制:将时间维度与空间维度解耦。每个时间戳的3DGS重建只依赖当前帧图像和上一时刻的state token,而不是把所有帧一次性输入网络。这样既降低了内存占用,又保持了跨帧的尺度与几何一致性,使模型能够处理更长的视频序列。
- 密集运动预测:把运动学习形式化为3D高斯点匹配问题。对每个3D高斯,预测其到相邻时间戳的双向运动向量。这一形式化使运动预测可以直接利用3DGS的显式几何结构,而不需要额外的运动表示。
- retargeting loss:将预测运动变形后的3DGS渲染到目标帧,与目标帧真值做光度监督。这是运动预测的核心自监督信号,使网络在没有密集运动真值的情况下也能学到合理的运动。
- occlusion-aware optical flow loss:利用SEA-RAFT生成伪光流真值,并通过dual consistency factor识别遮挡点,对遮挡区域降低权重。这一损失在2D光流层面约束预测运动,增强了运动的合理性,特别是在遮挡边界附近。
- occlusion-aware Gaussian fusion:在生成新时刻3DGS时,用MLP融合相邻帧变形后的3DGS,并根据遮挡信息加权。这一模块消除了时序冗余,抑制了闪烁伪影。论文第14页的消融实验显示,加入fusion后TL-STD显著下降,说明时序稳定性得到明显改善。
逐图理解论文
失败案例与直觉
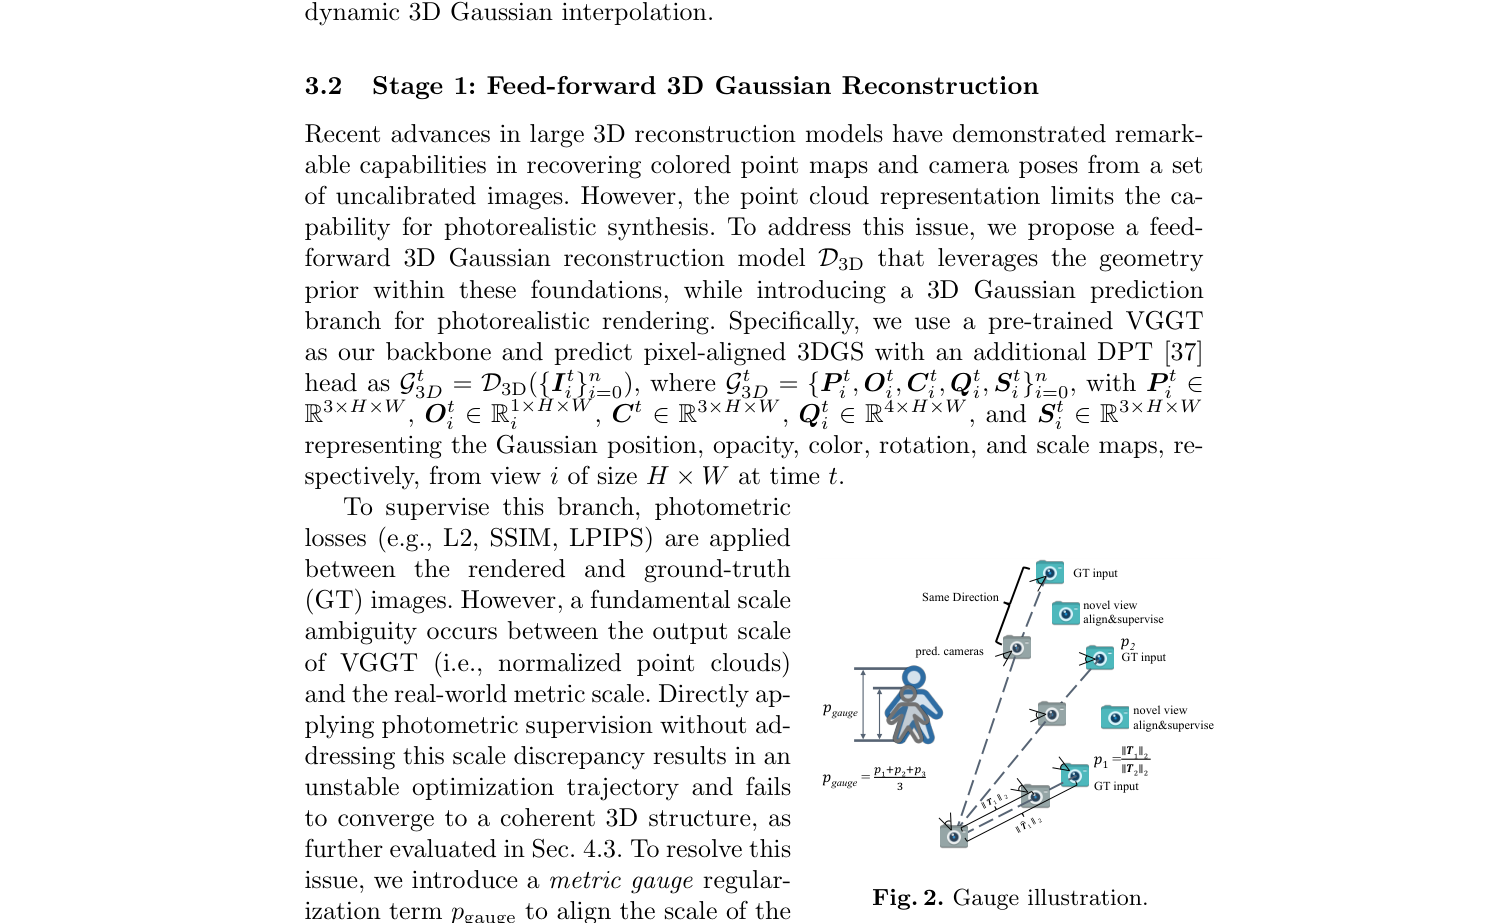
gauge示意图对比了尺度对齐前后的点云。注意对齐后点云与真实世界尺度的匹配程度,这是metric gauge正则化有效性的直观证据。
研究空白
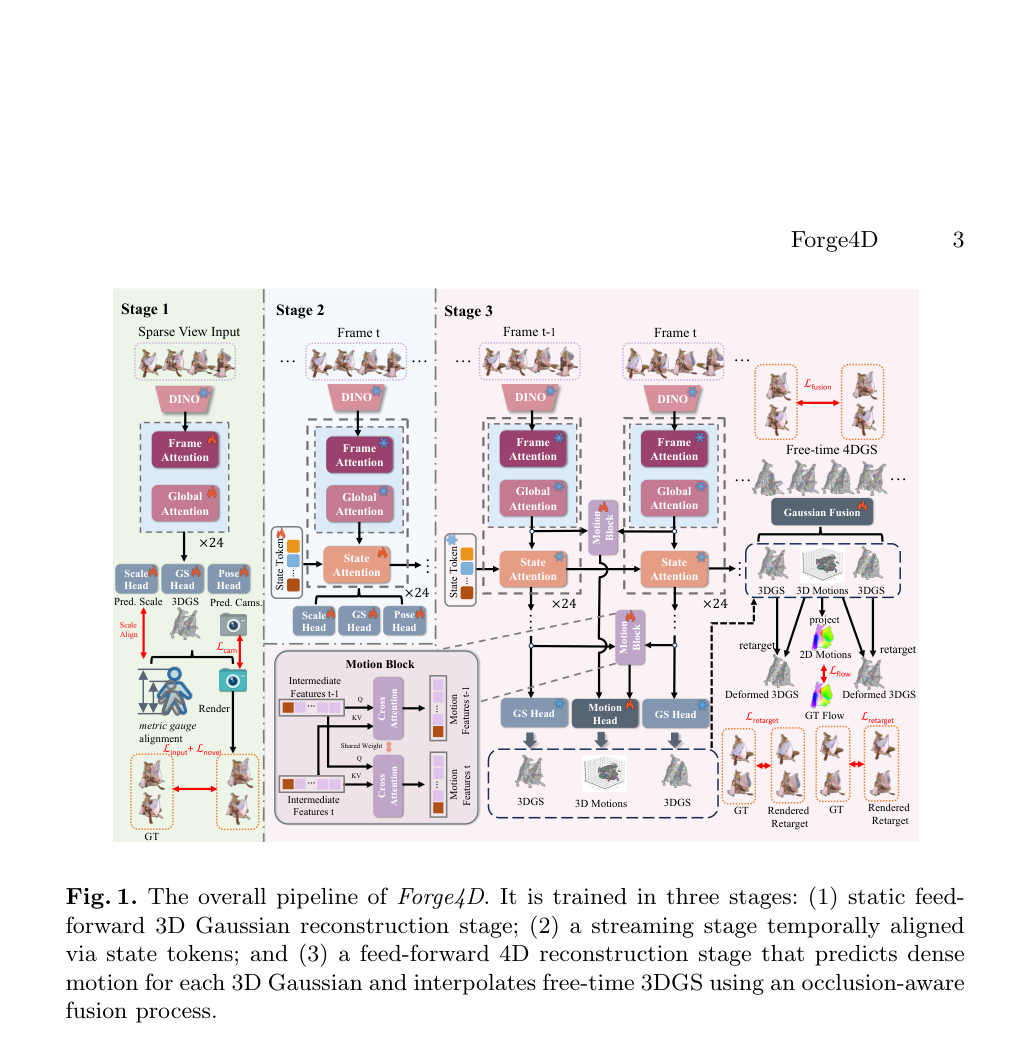
整体pipeline图展示了三阶段训练流程:静态前馈3DGS重建、state token流式对齐、密集运动预测与occlusion-aware fusion。重点观察三个阶段之间的数据流,理解空间与时间维度如何被解耦。
验证与结论
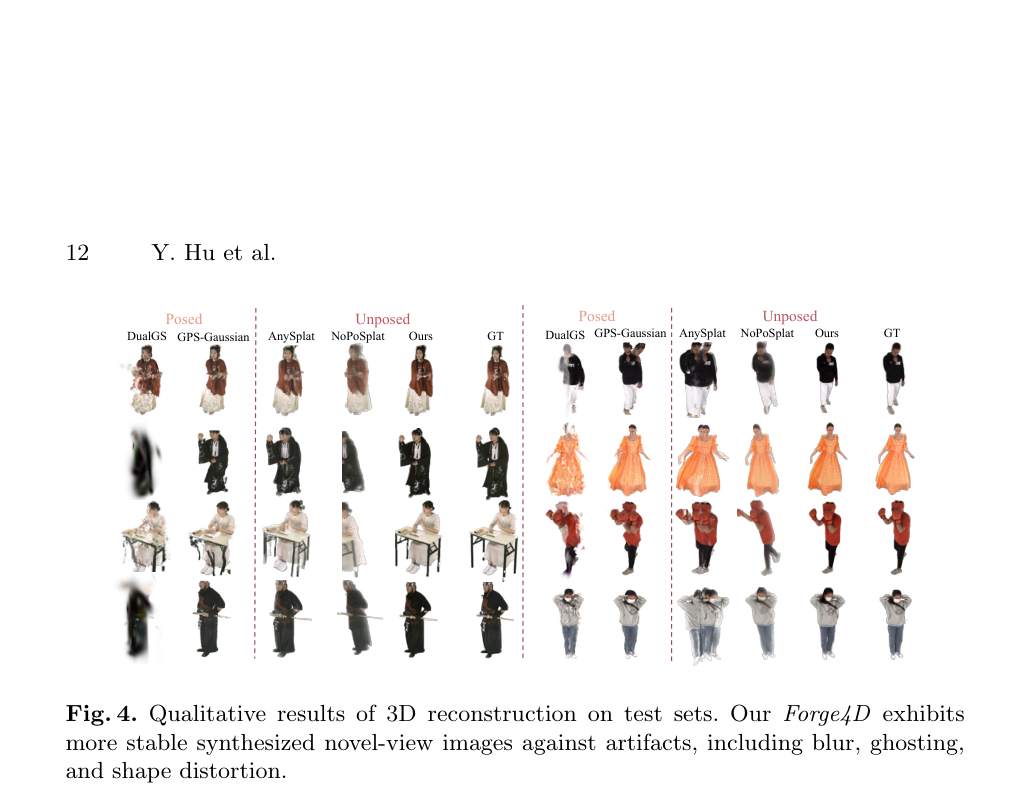
测试集上的定性对比展示了Forge4D相对基线在模糊、鬼影和形状畸变方面的优势。重点观察人体边缘和快速运动区域的渲染质量差异。
意义与局限
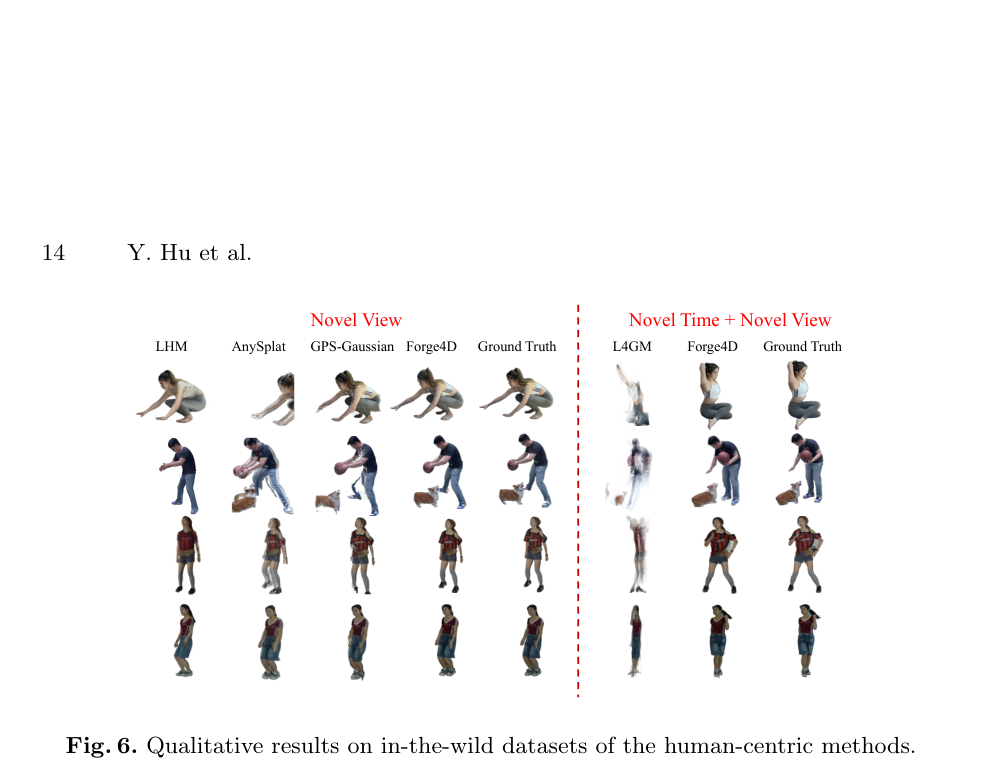
野外数据集上的定性结果展示了真实场景泛化能力。关注非受控光照和复杂背景下的重建稳定性,这是与实验室数据集结果的重要区别。
实验如何设计?
- 训练数据:DNA-Rendering训练集,包含2,078段人体-物体交互视频。所有模型使用4个输入视角、约45°相机角度训练和评估。
- 评估数据集:DNA-Rendering留出测试集、Genebody完整数据集,以及SelfCap和VVC两个野外数据集。野外数据集用于检验真实场景泛化能力。
- 对比基线:新视角合成对比DualGS、D-3DGS、Queen、GPS-Gaussian、NoPoSplat、AnySplat;新时刻与新视角合成对比D-3DGS、SpaceTimeGS、L4GM。其中L4GM因GPU内存限制最多输入8个时间戳,对比实验在此条件下进行。
- 密集运动预测评估:在自建MetaHuman4D合成数据集上进行,与POMATO对比。评估前需对初始时间戳3D点与GT网格做尺度、平移、旋转对齐,以消除坐标系差异。
- 度量尺度预测评估:与MoGe-2对比,衡量模型输出的尺度与真实世界尺度的偏差。
- 消融实验:覆盖metric gauge、state token、retargeting loss、optical flow loss、Gaussian fusion、相机数量、采样率、视频长度和推理速度等维度。
关键结果与论文证据
- 静态重建质量:在DNA-Rendering上新视角合成PSNR达到29.8167,SSIM 0.9606,LPIPS 0.0542,超过所有对比基线(第10页Table 1)。
- 4D重建质量:在DNA-Rendering上新时刻+新视角PSNR 29.0378,SSIM 0.9566,LPIPS 0.0535;在Genebody上PSNR 27.4247,SSIM 0.9459,LPIPS 0.0601(第10页Table 2)。
- 与前馈基线L4GM的差距:Forge4D超越L4GM最高达+12.57 dB PSNR,说明前馈4D重建的质量上限被显著提升(第12页)。
- 野外泛化:在SelfCap+VVC上,新视角PSNR 26.2735,新时刻PSNR 25.4726,表明模型在真实场景中仍能保持合理性能(第12页Table 3)。
- 度量尺度预测:平均误差0.0264m,远优于MoGe-2的0.3309m,验证了metric gauge正则化的有效性(第12页Table 4)。
- 密集运动预测:Motion Error 0.00953,Point Distance 0.0215,优于POMATO的0.01274和0.7555,说明运动预测在几何精度上具有优势(第12页Table 5)。
- 时序稳定性:无Gaussian Fusion时TL-STD为0.9446,加入Fusion后降至0.5379,降低约75.6%,证明fusion模块有效抑制了闪烁(第14页Table 7)。
- 推理速度:完整模型延迟224.27ms,基础帧率4.45 FPS;插值10帧达44.42 FPS,插值20帧达88.48 FPS,说明插值路径具有实时潜力(第14页Table 6)。
阅读时需要注意
- 大运动或较长帧间隔下性能下降:帧间对应减少,且恒定速度假设被破坏,导致运动预测精度降低。
- 线性运动模型为一阶简化:对复杂非线性运动(如快速旋转、突然变向)的表达能力有限。
- 基础帧率4.45 FPS(不含插值):虽然插值路径可达实时,但完整重建路径的实时交互性仍有提升空间。
关联工作
- VGGT作为骨干网络提供几何先验和相机位姿估计,是Forge4D能够前馈运行的基础。DUSt3R是更早的前馈视觉几何模型,支持无标定图像序列的点云重建。
- NoPoSplat和AnySplat将前馈3DGS重建扩展到无标定设置,但仅限静态场景。Forge4D可以看作是对这一路线的动态扩展。
- L4GM是前馈4D高斯重建的代表性工作,但分辨率低、真实场景泛化差。Forge4D在相同的前馈范式下显著提升了质量和泛化能力。
- POMATO将点图匹配与时序运动结合用于动态3D重建,是密集运动预测的直接对比对象。Forge4D将运动学习形式化为几何对应问题,在运动精度上取得优势。
- StreamSplat是同期工作,面向无标定视频流的在线动态3D重建,但未将运动学习形式化为几何对应问题。Forge4D的密集运动预测模块在这一维度上提供了更明确的几何解释。