快速导读:GaussVLA 提出 Gaussian Spatial Tokenizer (GST) 与 Depth-Aware Chain-of-Thought (DA-CoT),将 2D 视觉特征提升为结构化 3D 高斯 token 并进行深度感知推理,在仅 200M 参数下于 LIBERO 达到 93.5% 平均成功率。
GaussVLA 的核心论点是:现有视觉-语言-动作(VLA)模型把视觉观测编码成扁平的2D patch token,丢失了度量级3D几何结构,而单纯注入单目深度又只能提供逐像素标量,无法编码表面朝向与几何置信度。GaussVLA 的回应是把2D证据提升为带均值、协方差和置信度的3D高斯原语,并让空间推理直接锚定到动作预测目标上。
论文提出两个互补模块:Gaussian Spatial Tokenizer(GST)负责把冻结双流编码器(SigLIP语义特征 + Depth Anything V2深度特征)的输出反投影为3D高斯token,再经空间注意力池化压缩;Depth-Aware Chain-of-Thought(DA-CoT)以少量可学习查询在语言和flow-time条件下交叉注意力这些几何token,生成结构化推理表示。两者与语言、动作、时间嵌入拼接后输入共享的Mamba骨干,由flow-matching动作头预测速度场。
英文题目:GaussVLA: Geometry-Aware Spatial Reasoning for Vision-Language-Action Model
论文出处:arXiv 每日论文精选 · arXiv:2608.24959
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLA模型继承了预训练视觉-语言骨干的语言基础,但视觉前端普遍缺乏度量级3D几何信息。2D patch token只能表达图像平面上的外观关系,无法直接回答“物体在三维空间中离夹爪多远”“表面朝向如何”这类操作必需的问题。
一个直接的补救思路是注入单目深度。但深度图只是逐像素标量,它不编码局部表面朝向,也不携带“这个深度估计有多可靠”的置信度信息。在遮挡、透明物体或纹理缺失区域,深度估计误差会直接污染下游推理。
近期工作尝试了不同路径:SpatialVLA注入伪点云token,但对深度误差敏感且缺乏结构化几何表示;CoT-VLA在2D图像坐标中进行文本链式推理,可解释但自回归延迟高,且推理过程与动作解码脱节;RD-VLA把推理移入潜在循环空间以恢复速度,却牺牲了可审计性。
GaussVLA 识别出的研究缺口是:现有方法要么停留在2D token空间,要么把深度当作无结构的标量附加信息,没有一个把“几何结构”和“几何置信度”同时编码进紧凑token表示,并让空间推理直接服务于动作预测。
核心创新
- Gaussian Spatial Tokenizer (GST):将 2D patch 特征与深度提升为带 3D 均值、协方差和置信度的各向异性高斯原语,并通过置信度感知空间注意力池化压缩为紧凑几何 token
- Depth-Aware Chain-of-Thought (DA-CoT):非自回归结构化推理模块,少量可学习查询在语言和 flow-time 联合条件下交叉注意力 GST token,将空间推理直接锚定到动作预测目标
- 统一高效框架:Mamba 线性时间序列建模 + flow-matching 动作头,200M 参数实现 12.97 ms/step 端到端推理延迟
方法概览
GaussVLA 采用冻结双流编码器(SigLIP 提取语义特征,Depth Anything V2 提取深度),GST 将 patch 对齐的语义-深度特征反投影为 3D 高斯原语(均值 μ、对数方差 σ、置信度 α),经空间注意力池化得到紧凑几何感知 token;DA-CoT 以少量可学习查询在语言与 flow-time 条件下交叉注意力聚合 GST token,生成结构化推理 token;两者与语言、动作、时间嵌入拼接后输入 Mamba 骨干,由 flow-matching 动作头预测速度场。训练目标包括 flow-matching 损失、opacity 加权深度一致性损失和 DA-CoT 监督损失。
- GST 的输入是冻结双流编码器输出:SigLIP提取语义特征,Depth Anything V2提取稠密深度特征,两者在patch级别对齐。
- GST 将每个patch的语义-深度特征反投影为3D高斯原语,参数化为均值μ、对数方差σ和置信度α(opacity),形成各向异性的几何token。
- GST 通过置信度感知的空间注意力池化,把大量patch级高斯原语压缩为紧凑的几何感知token(默认128个查询),置信度低的区域在池化中权重降低。
- DA-CoT 以少量可学习查询(默认4个)在语言嵌入和flow-time条件的联合作用下,交叉注意力聚合GST token,生成结构化推理token,是非自回归的,避免了逐token文本生成的延迟。
- GST token、DA-CoT token、语言嵌入、动作嵌入和时间嵌入拼接后输入共享的Mamba骨干,利用线性时间序列建模处理多模态序列。
- 动作头采用flow-matching,学习条件速度场,以10步Euler ODE生成连续动作序列(action chunk)。
- 训练目标包括flow-matching损失、opacity加权的深度一致性损失(诱导α学习深度感知置信度)和DA-CoT监督损失。
- 总参数约200M,其中可训练参数179M,端到端推理延迟在RTX Pro 6000 Blackwell上为12.97 ms/step。
逐图理解论文
失败案例与直觉
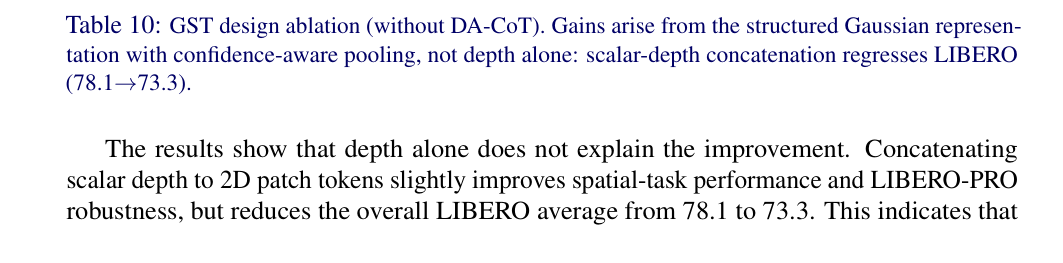
检查GST设计消融:标量深度拼接使LIBERO从78.1%回退到73.3%,证明增益来自结构化高斯表示与置信度感知池化,而非深度本身。
方法贡献
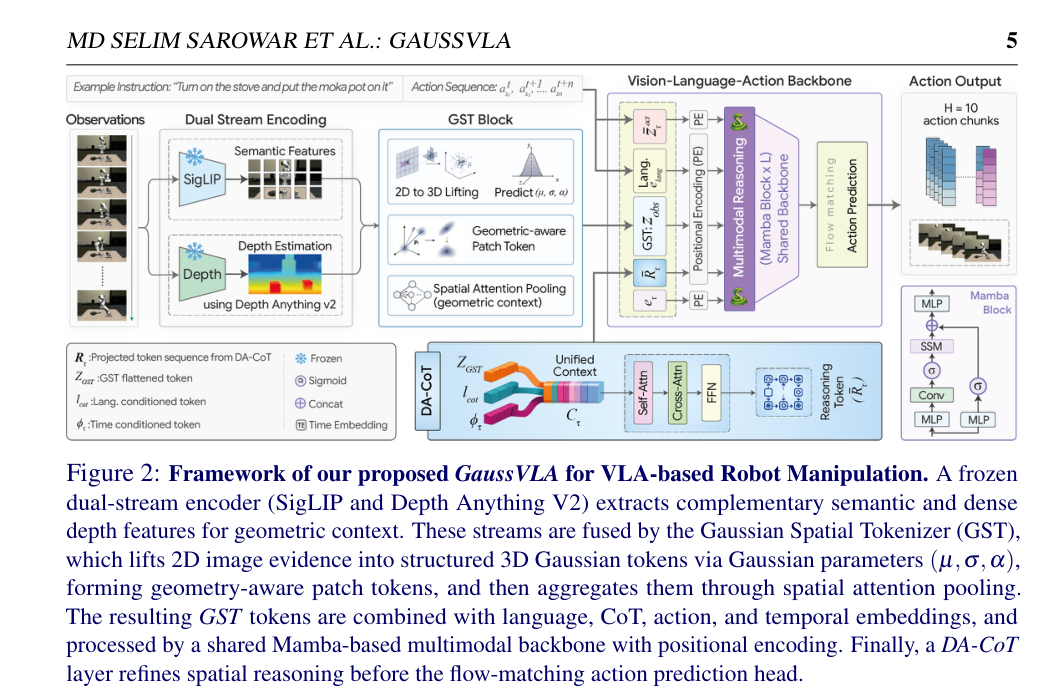
观察整体框架:冻结双流编码器(SigLIP与Depth Anything V2)分别提取语义和深度特征,GST将其提升为3D高斯token并经空间注意力池化压缩,DA-CoT层在flow-matching动作头之前细化空间推理。重点看GST与DA-CoT在数据流中的位置关系。
证据与验证
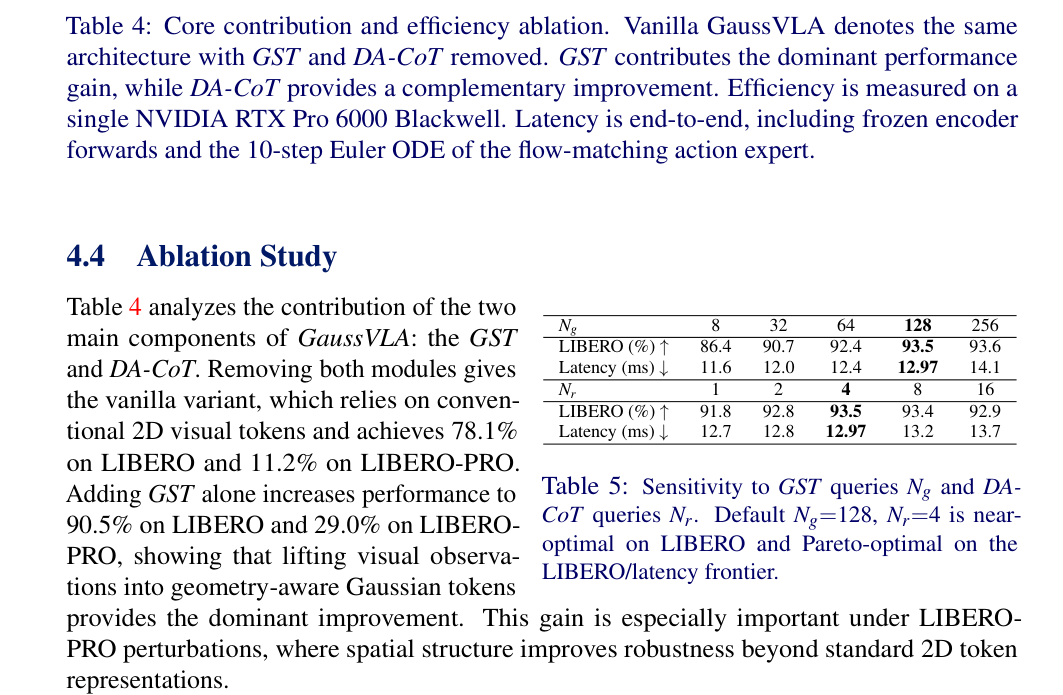
查看核心消融:Vanilla(无GST和DA-CoT)78.1%,加GST后90.5%,再加DA-CoT到93.5%,说明GST贡献主导增益,DA-CoT提供互补提升。同时注意延迟和GFLOPs列,验证效率。
结论与意义
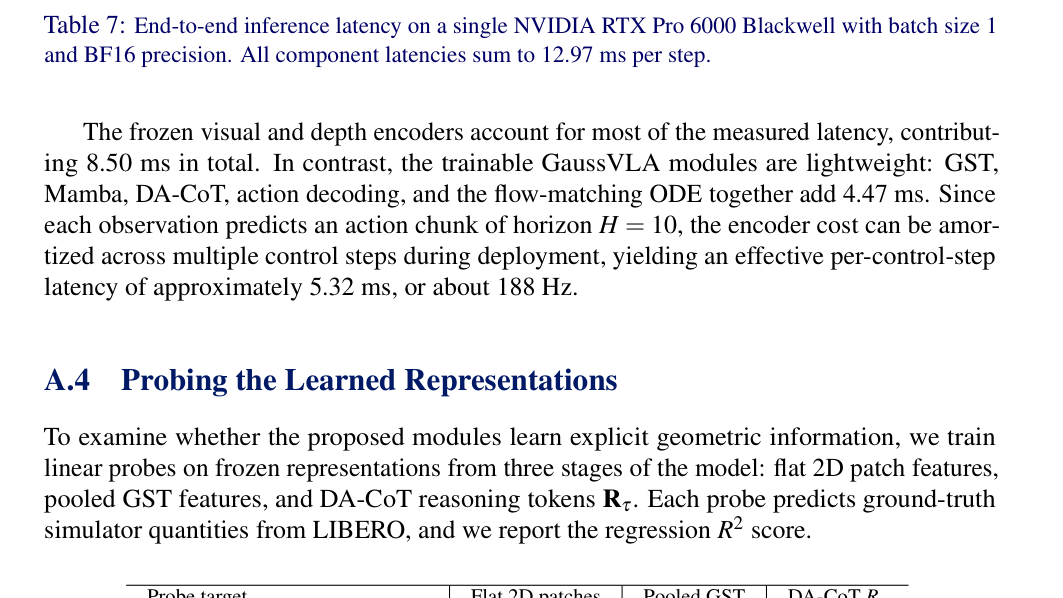
GaussVLA最有力的结论是:显式3D几何结构比扁平2D token或标量深度更能支撑VLA的空间推理,而且这种几何感知可以用很小的参数代价实现——200M参数、端到端12.97毫秒一步。它的意义在于提供了一个可复用的设计范式:把几何结构和几何置信度同时编码进token,让推理直接锚定动作。一个诚实的局限是,在LIBERO-PRO的位置与任务级扰动下,平均归一化成功率只有0.33,视角泛化仍然脆弱。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- LIBERO仿真基准:Spatial/Object/Goal/Long四个套件,每任务40次rollout,报告平均成功率。
- Meta-World难度分层操作:Easy/Mid/Hard/Very Hard四档,检验几何感知在不同操作难度下的泛化。
- CALVIN ABCD→D长时程连续任务:10%子集,报告1-5连续任务完成率与平均完成序列长度。
- LIBERO-PRO鲁棒性基准:五种扰动类型下的归一化成功率,检验几何结构对扰动的鲁棒性。
- 真实世界SO-101机器人:多任务设置与Pick-Place ID/OOD试验,对比ACT和SpatialVLA。
- 消融与探针:GST/DA-CoT贡献、查询数量敏感性、动作解码器、GST设计、DA-CoT组件、置信度偏置移除,以及线性探针回归R²验证3D几何信息编码。
关键结果与论文证据
- LIBERO平均成功率93.5%,其中Spatial套件100.0%,Object 95.8%,Goal 95.3%,Long 83.0%(第11页)。
- 核心消融显示GST贡献主导增益:Vanilla 78.1% → +GST 90.5% → Full 93.5%;LIBERO-PRO上11.2% → 29.0% → 33.3%(第13页)。
- DA-CoT token的线性探针R²:物体中心0.78,夹爪-物体距离0.82,物体朝向0.61,显著高于扁平2D patch token和池化GST表示(第20页)。
- 标量深度拼接反而使LIBERO从78.1%回退到73.3%,证明增益来自结构化高斯表示与置信度感知池化,而非深度本身(第21页)。
- 深度感知接地是DA-CoT的主导推理成分:两套件平均从83.9%提升到87.0%(+3.1 pt),CoT监督额外贡献+1.1 pt(第22页)。
- opacity α与深度不确定性代理的Pearson相关:u∇ +0.61,uσd +0.54,upc +0.47,说明α通过损失间接学到了深度感知置信度(第23页)。
- Meta-World平均SR 54.9%,Very Hard 41.6%;CALVIN平均完成序列长度1.474,但5连续任务完成率为0.000(第12页)。
- LIBERO-PRO平均归一化SR仅0.33,低于OpenVLA(0.52)和π0.5(0.53),位置与任务级扰动下性能下降明显(第12页)。
阅读时需要注意
- LIBERO-PRO上位置与任务级扰动下性能显著下降,平均归一化SR仅0.33,视角泛化和语言侧鲁棒性受限。
- CALVIN 5连续任务完成率为0.000,极长时程恢复能力不足,落后于GR-1。
- Meta-World Mid/Hard分档落后于π0(47.9 vs 48.2和37.3 vs 41.7)。
- GST的opacity α不直接消费深度不确定性信号,深度感知置信度仅通过损失间接诱导。
- 表1中参数标注为1B与正文200M不一致;表9中+4.74 pt提升联合反映了解码器设计与容量增加,无法完全归因于解码器设计。
关联工作
- SpatialVLA注入伪点云token增强空间感知,但缺乏结构化几何表示与置信度建模(第3页)。
- CoT-VLA在2D图像坐标中进行文本链式推理,可解释但自回归延迟高(第3页)。
- π0采用flow-matching动作专家加混合transformer,GaussVLA在LIBERO上超越其8.7%相对平均成功率(第3页)。
- 3D-VLA使用RGB-D与点云表示增强空间感知,但对深度误差和传感器噪声敏感(第3页)。
- RoboMamba将Mamba架构用于视觉-语言推理与连续运动控制,GaussVLA继承其线性时间序列建模思路(第4页)。