快速导读:本文提出 VT-Contrast,一种在 VideoLM 训练中对视频 token 表示施加时间反事实对比监督的方法,通过区分保持时间顺序的正样本与打乱顺序的负样本,增强模型对事件动态和时间顺序的感知能力。
本文针对 VideoLM 在时间理解任务上的局限性,提出了 VT-Contrast 方法。现有 VideoLM 主要依赖语言建模损失进行监督,该损失仅约束生成的文本,未直接约束内部视频 token 表示对时间顺序的敏感性,导致模型可能依赖静态视觉线索或语言先验而非真正的时间动态来回答时间相关问题。
本文提出的 VT-Contrast 方法通过在视频 token 空间施加时间反事实对比监督,有效解决了这一问题。该方法从同一视频中构建保持原始顺序的 Anchor 视图、轻微扰动但保持顺序的 Positive 视图,以及通过非恒等置换打乱顺序的 Negative 视图,利用 InfoNCE 损失拉近正样本并推远负样本,从而增强模型对时间顺序的感知能力。
英文题目:The Shape of Time: Video-Token Contrast for Temporal Understanding in VideoLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.04110
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VideoLM 将视频帧编码为视觉 token 并输入 LLM 生成文本。虽然输入是有序的,但监督信号仅作用于输出文本,使得视频 token 表示在时间维度上约束不足。现有的时间感知架构或辅助任务未直接在视频 token 空间施加时间顺序约束。
例如,当视频中的事件顺序被反转时,模型往往难以区分原始视频和反转视频,因为它们共享相似的静态视觉内容。这种对时间动态的忽视导致模型在时间理解任务上的表现不佳。
本文通过引入时间反事实对比学习,直接在视频 token 表示层面施加时间顺序约束,从而解决这一问题。
核心创新
- 提出表示级别的时间反事实对比目标 VT-Contrast,直接在视频 token 空间区分时间顺序差异,而非仅依赖文本响应。
- 引入基于 Kendall tau 距离的时间反事实难度分级机制,通过控制顺序扰动程度来优化对比信号的有效性。
- 采用 Emergence-aware 监督策略,仅对特定深层的最后一帧视频 token 施加对比约束,聚焦于时间信息聚合后的表示。
方法概览
VT-Contrast 从同一视频中构建三种视图:保持原始顺序的 Anchor 视图、轻微扰动但保持顺序的 Positive 视图、以及通过非恒等置换打乱顺序的 Negative 视图(时间反事实)。使用 Kendall tau 距离对负样本的难度进行分级。在 VideoLM 的特定深层(late-layer)提取最后一帧(last-frame)视频 token 表示,通过 InfoNCE 损失拉近 Anchor 与 Positive,推远 Anchor 与 Negative。该损失与标准语言建模损失联合优化。
- 从同一视频中构建三种视图:保持原始顺序的 Anchor 视图、轻微扰动但保持顺序的 Positive 视图、以及通过非恒等置换打乱顺序的 Negative 视图(时间反事实)。
- 使用 Kendall tau 距离对负样本的难度进行分级,通过控制顺序扰动程度来优化对比信号的有效性。
- 在 VideoLM 的特定深层(late-layer)提取最后一帧(last-frame)视频 token 表示,通过 InfoNCE 损失拉近 Anchor 与 Positive,推远 Anchor 与 Negative。
- 该损失与标准语言建模损失联合优化,确保模型在生成文本的同时,其内部表示也能对时间顺序保持敏感。
- 采用 Emergence-aware 监督策略,仅对特定深层的最后一帧视频 token 施加对比约束,聚焦于时间信息聚合后的表示。
逐图理解论文
失败案例
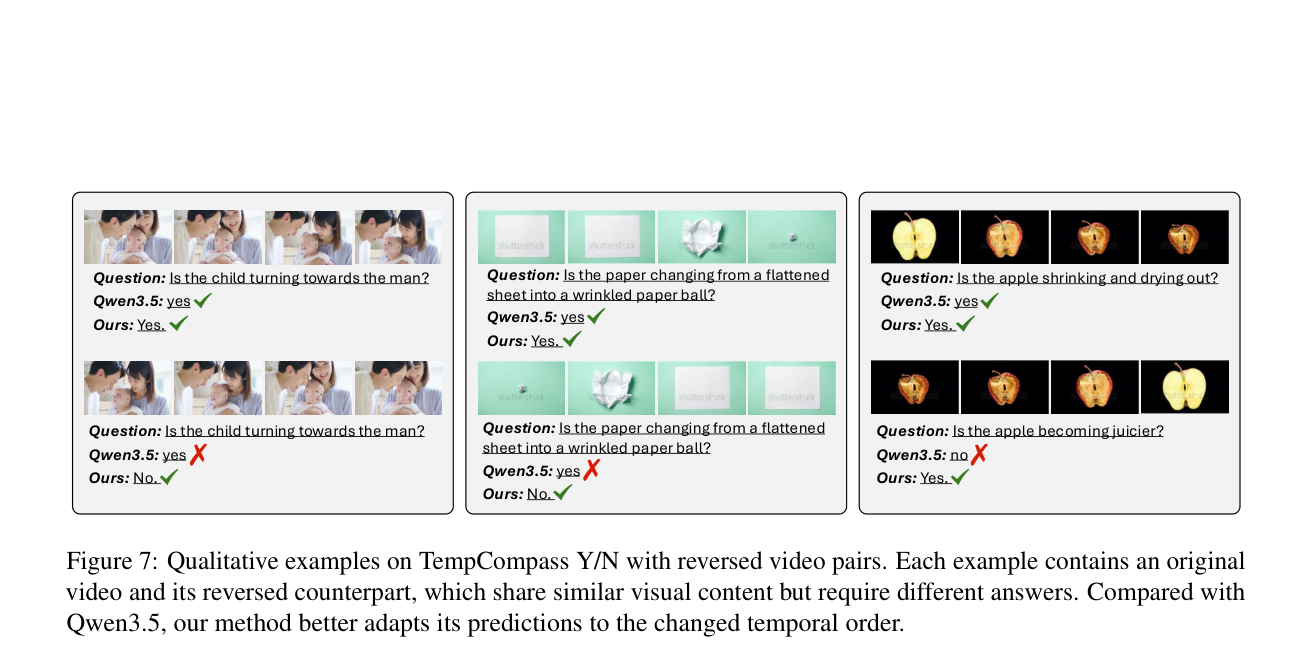
该图展示了 TempCompass Y/N 上的定性示例,其中每个示例包含一个原始视频及其反转对应物。与 Qwen3.5 相比,我们的方法能够更好地适应其预测以应对改变的时间顺序。
研究缺口
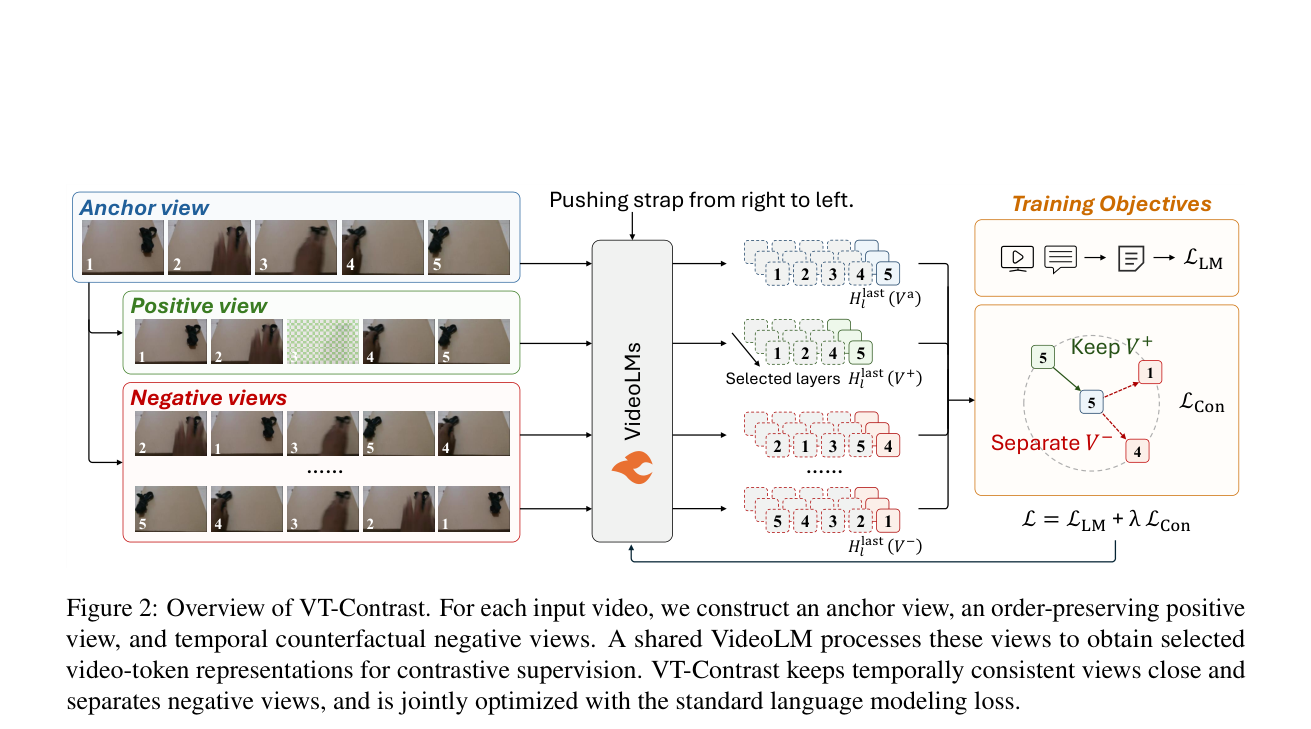
该图概述了 VT-Contrast 的整体流程。对于每个输入视频,构建锚点视图、保持顺序的正样本视图和时间反事实负样本视图。共享的 VideoLM 处理这些视图以获取用于对比监督的视频 token 表示。
最强结论
该表报告了在不同帧设置下,TOMATO、TempCompass 和 Vinoground 上的主要结果。我们的 4B 模型在大多数基准上优于最近的 4B MLLM,并且我们的方法在大多数设置下也优于相应的 Qwen3.5 模型。
意义与局限
该方法为视频语言模型的时间理解提供了新的监督范式,但验证仅限于中等规模数据,且增加负样本数量会增加训练开销。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在 TOMATO, TempCompass, Vinoground 等时间理解基准上,与 Qwen3.5, InternVL3.5, LLaVA-OneVision 等模型对比。
- 消融实验验证了时间反事实目标、Token 表示选择(Last-frame vs All-frame)、负样本难度(Hard vs Simple vs Full)、负样本数量及温度系数的影响。
- 在 InternVL3.5-4B 上验证方法的跨模型泛化性,并在 Video-MME 上评估通用视频问答能力。
- 分析训练开销,包括不同负样本数量下的时间步耗时和显存占用。
关键结果与论文证据
- Ours-2B 在 8-frame 设置下,TOMATO 得分 31.47,较 Qwen3.5-2B (25.74) 提升 +5.73;TempCompass Y/N 提升 +3.95。(Page 6)
- Ours-4B 在 8-frame 设置下,TOMATO 得分 36.46,较 Qwen3.5-4B (33.42) 提升 +3.04。(Page 6)
- 消融实验显示,加入 VT-Contrast (λ=0.1) 相比 LM-only,TOMATO 提升 +2.02,TempCompass Y/N 提升 +2.12,Vinogroup Group 提升 +2.20。(Page 7)
- 使用 Hard negatives (Kendall tau ∈ (0, 0.5]) 比 Full negatives 在 TOMATO 上高 0.61 (31.47 vs 30.86),在 TempCompass Y/N 上高 1.35 (74.97 vs 73.62)。(Page 8)
- 在 InternVL3.5-4B 上,8-frame 设置下 TOMATO 提升 +1.55,TempCompass Match 提升 +2.74。(Page 14)
- 在 Video-MME 通用视频问答上,Ours-2B 在 16-frame 设置下整体准确率提升 +1.14 (56.07 vs 54.93)。(Page 14)
阅读时需要注意
- 验证仅限于中等规模的监督微调,未在更大规模或更多样化的视频文本数据(如长视频、多事件场景)上充分验证。
- 增益可能依赖于基础模型的时间建模和生成能力,例如在 TempCompass Caption 任务上,4B 模型并未始终优于 2B 模型。
- 当前实现未针对效率进行专门优化,增加负样本数量会显著增加训练时间和显存开销。
关联工作
- Visual Jigsaw (Wu et al., 2026) 通过 GRPO 训练顺序预测,但依赖任务级响应而非直接表示级监督。(Page 6)
- T3 (Li et al., 2025b) 从合成文本任务迁移时间推理,未直接约束视频 token 表示。(Page 2)
- VideoMAE (Tong et al., 2022) 使用重建目标提供视觉监督,但需要额外分支且计算成本高。(Page 2)
- Qwen3.5 (Qwen Team, 2026) 是本文的基础模型,本文在其 0.8B, 2B, 4B 变体上进行微调。(Page 6)
- InternVL3.5 (Wang et al., 2025) 是对比基线及泛化性验证模型,用于证明方法在不同 VideoLM 家族上的有效性。(Page 6)