快速导读:本文提出 Principia 基准,通过评估成对物体在图像空间中的关系不变量(无需相机标定),揭示当前视频生成模型和视觉语言模型在视觉质量高企的同时,物理一致性极低且随规模扩大并未显著改善。
当前视频生成模型常被宣传为“世界模型”,但视觉逼真度并不等同于物理正确性。现有评估基准如 VBench 主要关注视觉质量,无法有效衡量物理一致性;而现有的物理评估方法往往依赖绝对测量或相机标定,这些参数在生成视频中通常未知或模糊,导致评估困难。
本文提出 Principia 基准,通过评估成对物体在图像空间中的关系不变量(无需相机标定),揭示当前视频生成模型和视觉语言模型在视觉质量高企的同时,物理一致性极低且随规模扩大并未显著改善。
英文题目:Principia: Relational Physics Tests for Video Models
论文出处:arXiv 每日论文精选 · arXiv:2609.04200
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视频生成模型的评估长期面临“视觉质量”与“物理正确性”脱节的问题。VBench 等主流基准在视觉质量维度上得分普遍较高,但无法捕捉模型在运动轨迹、碰撞、摩擦等物理现象上的系统性错误。
现有的物理视频评估基准(如 Physics-IQ, Morpheus, PhysVid)通常依赖绝对测量(如速度、加速度)或需要恢复相机内参和度量尺度。然而,生成视频中的相机运动、帧率和尺度往往是模糊或未知的,这使得基于绝对测量的评估方法难以直接应用。
此外,最接近的前驱工作(如 Galileo's equivalence)仅针对重力现象,缺乏对多种牛顿力学现象的通用覆盖。因此,缺乏一种无需标定、能直接量化物理定律违反程度的通用评估方法。
核心创新
- 提出了 Principia 基准,包含 500+ 真实世界成对物体场景,覆盖 8 种牛顿力学现象。
- 设计了无需标定的关系一致性评分(Unit-free Relational Consistency Score),直接在图像空间量化物理定律的违反程度。
- 构建了 Principia-Synth 合成数据集,包含物理正确和故意违反物理定律的视频,用于评估 VLM 的物理推理能力。
- 揭示了视觉质量与物理保真度解耦的现象,以及模型规模扩大并不均匀提升物理一致性的规律。
方法概览
Principia 基准包含 500+ 个真实世界场景,覆盖 8 种牛顿力学现象(重力、恢复系数、摩擦、转动惯量、抛体运动、动量、单摆、弹簧振子)。核心方法是“关系一致性评分”(Relational Consistency Score),通过比较同一场景中两个遵循相同物理定律的物体的运动关系(如到达时间相等、位移比例等)来量化物理违反程度。该评分仅依赖像素空间的比值和相等关系,无需相机内参、帧率或度量尺度。此外,利用 Isaac Sim 构建了 Principia-Synth 合成数据集,用于评估 VLM 检测物理违规的能力。
- Principia 基准包含 500+ 个真实世界场景,覆盖 8 种牛顿力学现象:重力、恢复系数、摩擦、转动惯量、抛体运动、动量、单摆、弹簧振子。
- 核心方法是“关系一致性评分”(Relational Consistency Score),通过比较同一场景中两个遵循相同物理定律的物体的运动关系(如到达时间相等、位移比例等)来量化物理违反程度。
- 该评分仅依赖像素空间的比值和相等关系,无需相机内参、帧率或度量尺度,实现了 Unit-free 评估。
- 利用 Isaac Sim 构建了 Principia-Synth 合成数据集,包含物理正确和故意违反物理定律的视频,用于评估 VLM 检测物理违规的能力。
- 评估假设模型能生成基本的定性正确运动,通过方向一致性分数(DCS)过滤非合规视频,确保评分聚焦于物理关系而非基础运动生成缺陷。
逐图理解论文
直觉失败案例
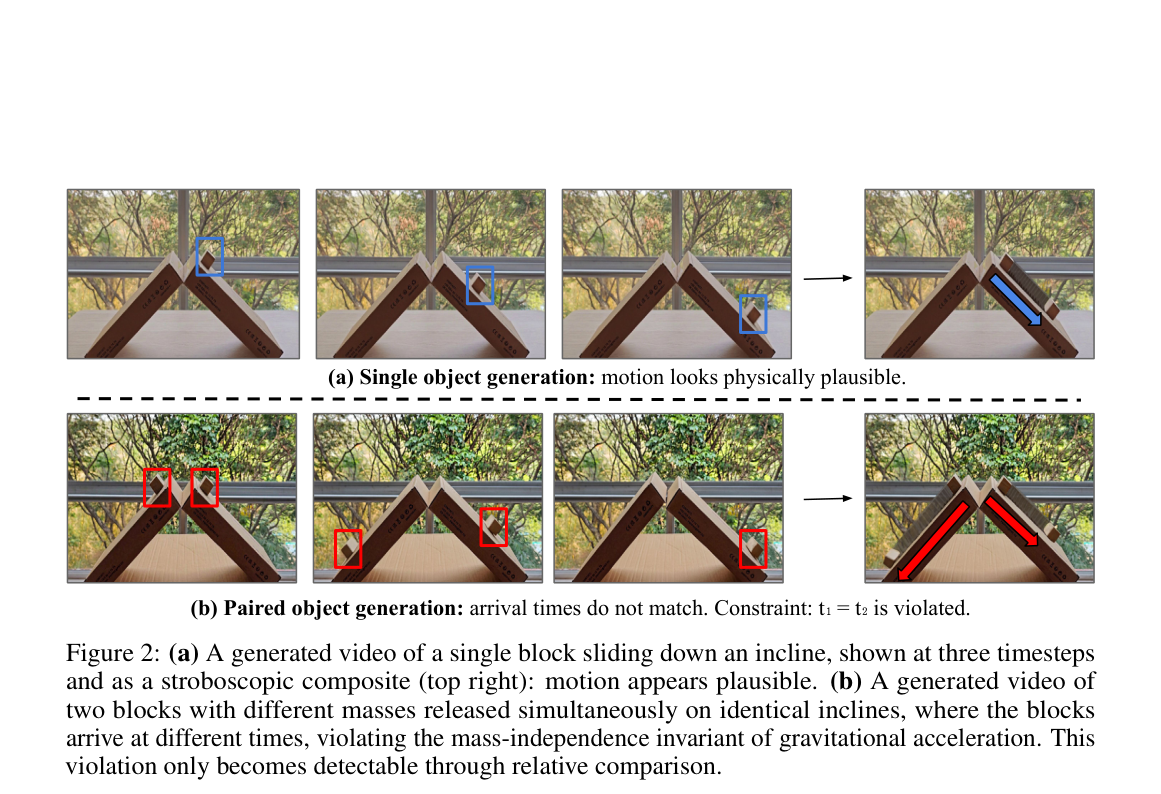
图 2 展示了单个滑块和成对滑块的运动对比。单个滑块运动看似合理,但成对滑块因质量不同导致到达时间不同,违反了重力加速度的质量无关不变量。这直观说明了关系不变量在检测物理违规中的必要性。
研究空白
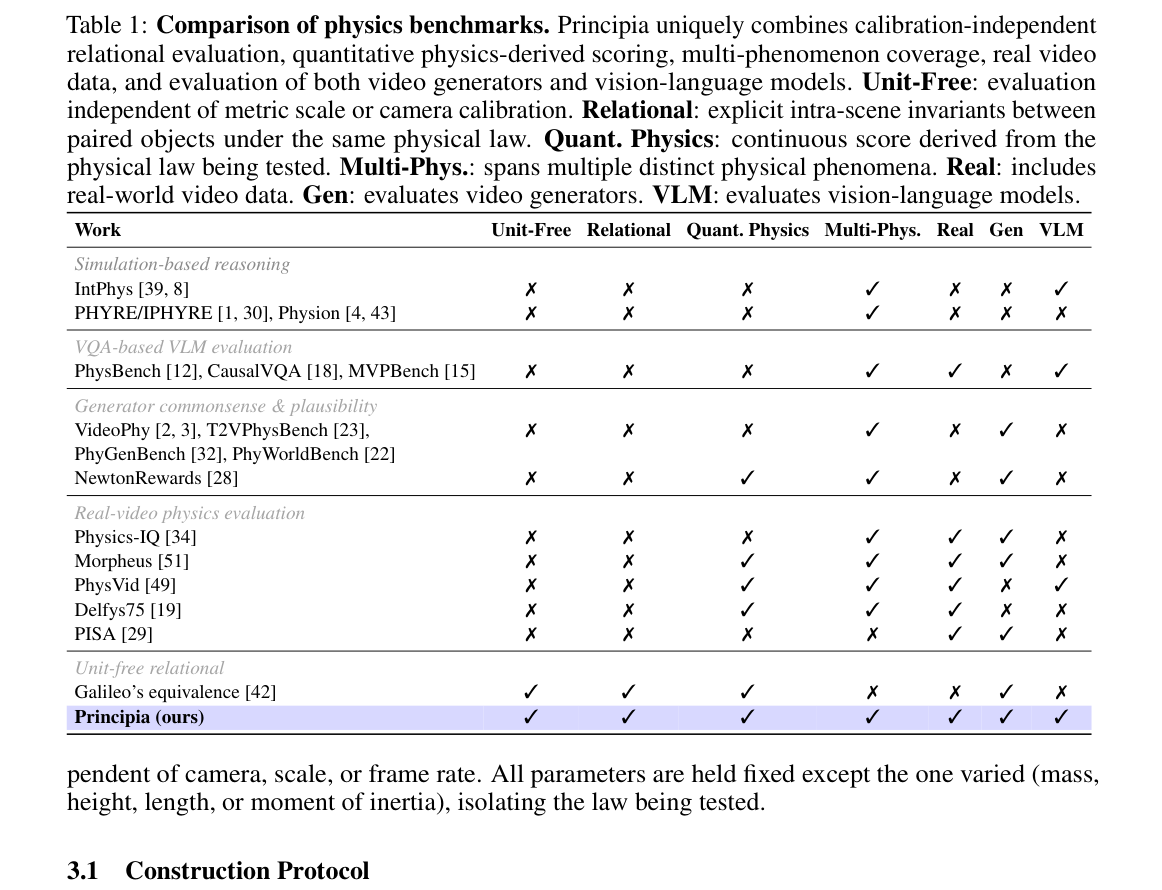
表 1 对比了现有物理基准。Principia 是唯一结合无标定关系评估、定量物理评分、多现象覆盖、真实视频数据以及同时评估视频生成器和 VLM 的基准。
核心贡献
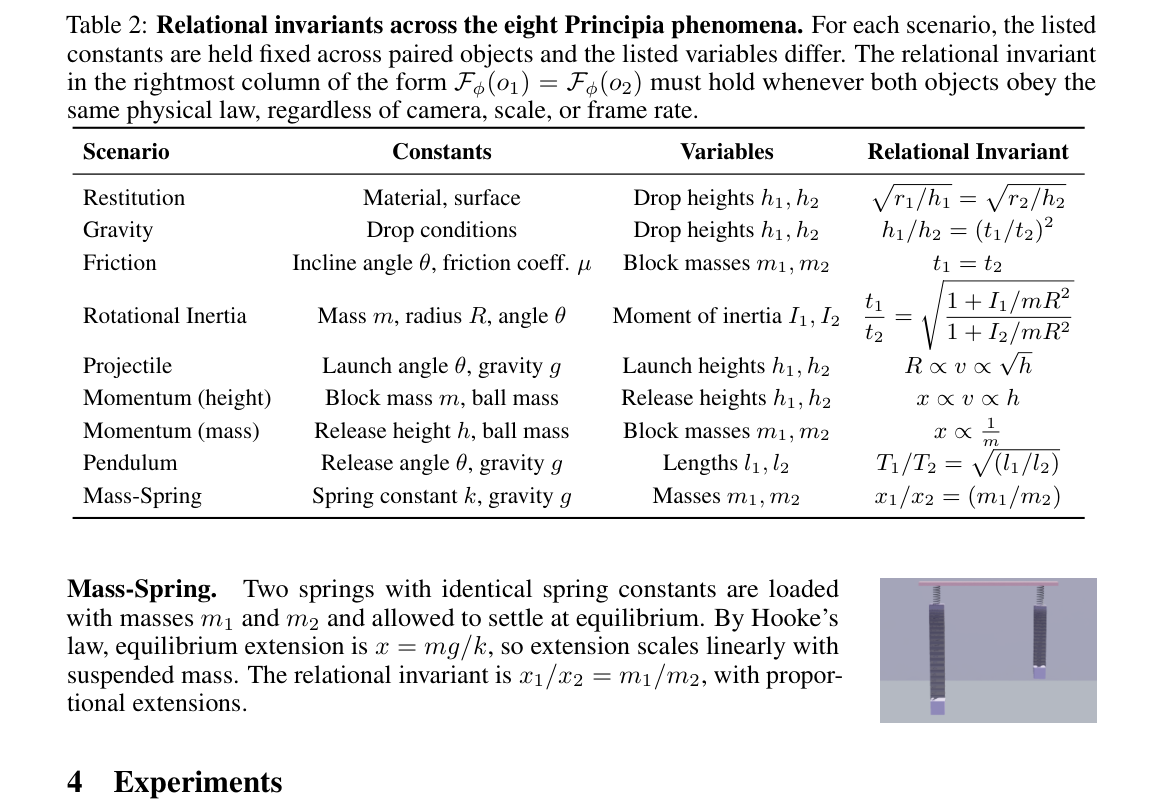
表 2 列出了 8 种现象的关系不变量。对于每种场景,列出了保持固定的常量和变化的变量,以及必须满足的关系不变量形式。
关键发现
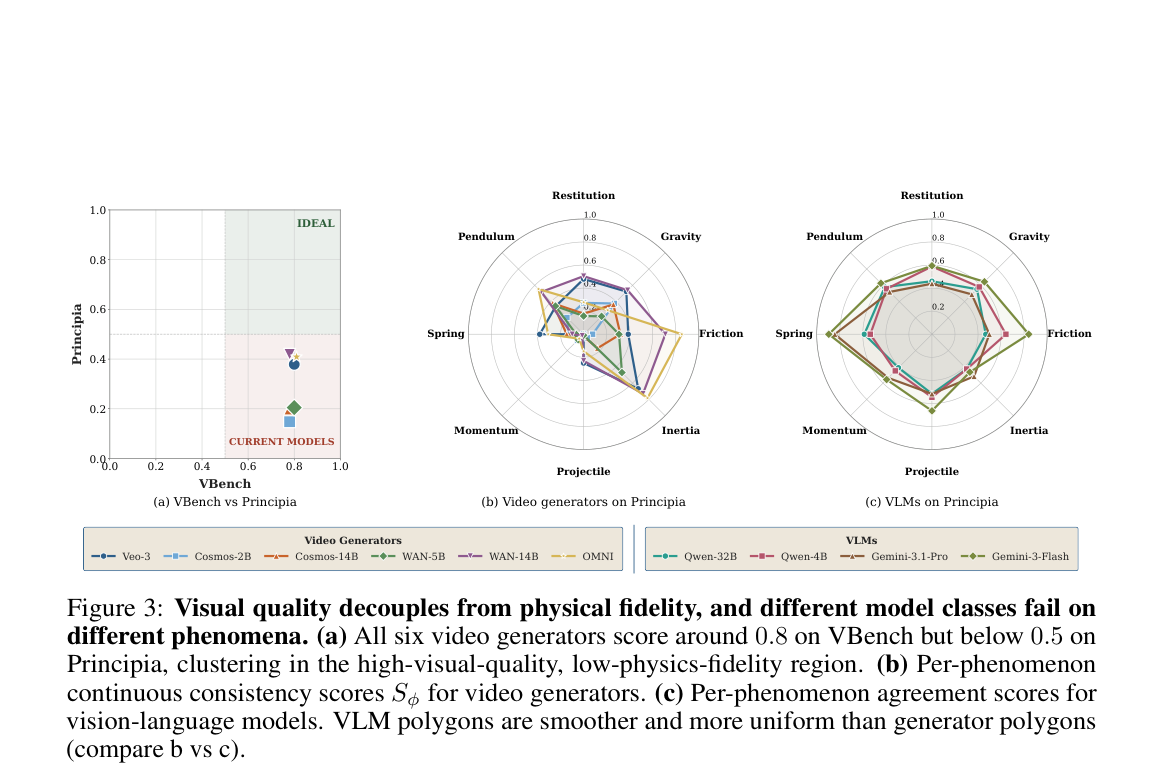
图 3 展示了视觉质量与物理保真度的解耦。所有 6 个视频生成器在 VBench 上得分约 0.8,但在 Principia 上低于 0.5。不同模型在不同现象上表现各异,没有模型在所有现象上占优。
VLM 评估
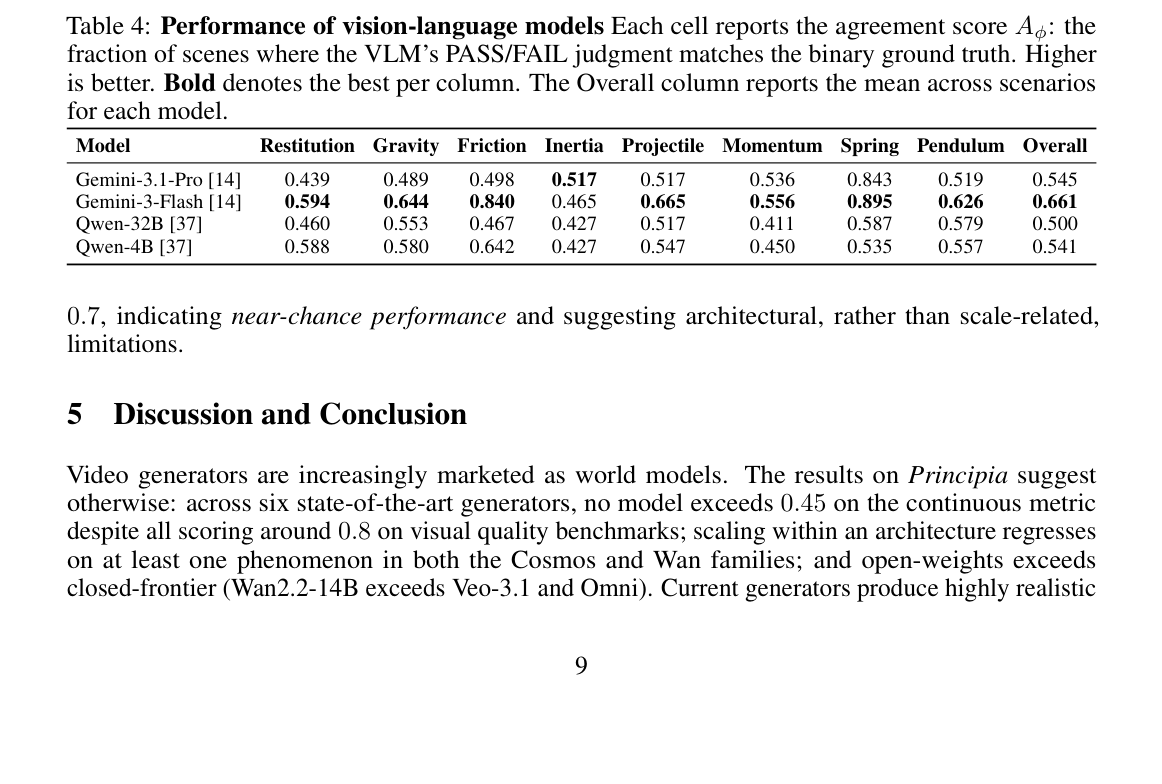
表 4 报告了 VLM 在 Principia-Synth 上的性能。最佳 VLM (Gemini-3-Flash) 的平均一致性得分仅为 0.661,多数模型接近随机水平。
实验如何设计?
- 评估了 6 个最先进的视频生成模型(Veo-3.1, Omni, Wan2.2-5B/14B, Cosmos-2.5-2B/14B)在 Principia 上的表现。
- 评估了 4 个视觉语言模型(Gemini-3.1-Pro, Gemini-3-Flash, Qwen-32B, Qwen-4B)在 Principia-Synth 上检测物理违规的能力。
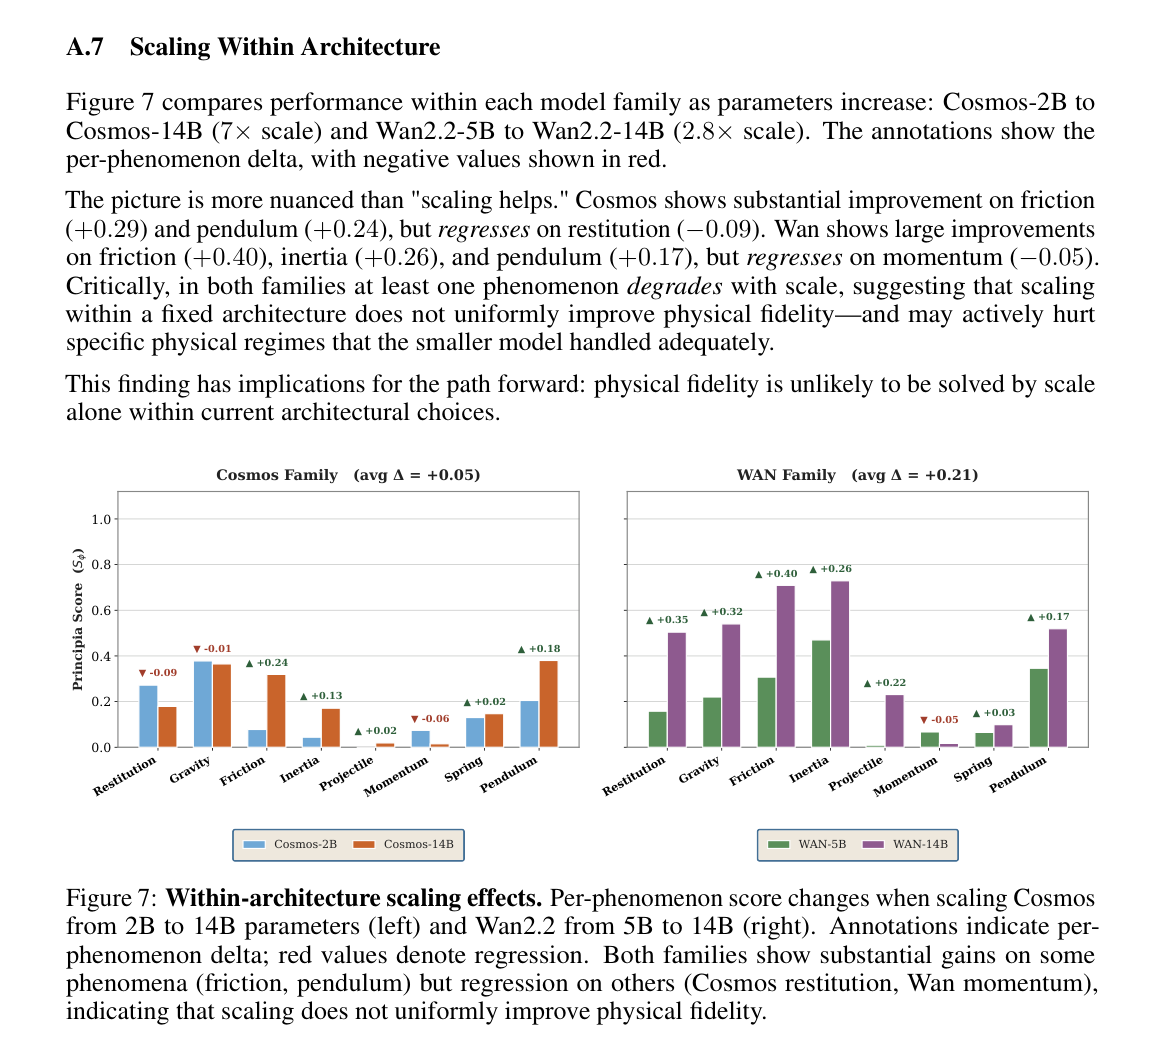
- 分析了模型内部规模扩大(Scaling)对物理一致性的影响(Cosmos 2B->14B, Wan 5B->14B, Qwen 4B->32B, Gemini Flash->Pro)。
- 进行了相机运动鲁棒性分析,验证评分对相机平移和缩放的敏感性。
关键结果与论文证据
- 所有 6 个视频生成模型在 VBench 上得分约 0.8,但在 Principia 上得分低于 0.5(范围 0.14-0.42),表明视觉质量与物理保真度近乎正交(Page 7)。
- Wan2.2-14B 取得最佳整体 Principia 得分 0.419,略高于 Omni (0.409) 和 Veo-3.1 (0.379)(Page 7)。
- 最佳 VLM (Gemini-3-Flash) 在 Principia-Synth 上的平均一致性得分仅为 0.661,多数模型接近随机水平(Page 9)。
- 在 Cosmos 和 Wan 模型家族中,规模扩大导致至少一种物理现象的性能下降(如 Cosmos 恢复系数 -0.09, Wan 动量 -0.05)(Page 17)。
- VLM 规模扩大(Qwen 4B->32B, Gemini Flash->Pro)并未提升性能,反而导致整体性能下降(Qwen -0.04, Gemini -0.12)(Page 20)。
阅读时需要注意
- 仅测试宏观牛顿力学,未涵盖流体动力学、软体变形或热力学现象。
- 生成视频中可能出现的幻觉物体、缺失物体或严重变形未被自动区分,这些失败与物理推理无关但会影响评分。
- 评估假设模型能生成基本的定性正确运动,通过 DCS 过滤非合规视频,这可能掩盖了模型在基础运动生成上的缺陷。
- Principia 评分对相机运动敏感,特别是抛体运动场景,水平平移会改变表观范围顺序,导致评分错误。
关联工作
- VBench 评估视觉质量,Principia 评估物理一致性,两者近乎正交(Page 7)。
- Galileo's equivalence 仅针对重力现象,Principia 将其推广到 8 种现象(Page 4)。
- Physics-IQ, Morpheus, PhysVid 通常依赖绝对测量或标定,Principia 无需标定(Page 4)。
- Isaac Sim 用于生成 Principia-Synth 合成数据集(Page 5)。