快速导读:SafeRI 提出了一种流式风险识别与门控 LoRA 框架,仅在 VLM 生成轨迹出现不安全漂移时激活安全参数,从而在提升安全性的同时最小化对通用能力的干扰。
SafeRI 针对大型视觉语言模型(VLM)在自回归生成过程中动态显现的安全风险,提出了一种流式风险识别与门控 LoRA 干预框架。其核心思想是将安全对齐从全局重学习问题转化为选择性轨迹控制问题,仅在生成轨迹出现不安全漂移时激活安全参数,从而避免对已安全轨迹的不必要扰动。
该框架包含两个核心组件:轻量级线性风险识别器和门控 LoRA 适配器。识别器读取冻结骨干网络最后一层的 hidden states,预测当前前缀状态是否即将进入不安全区域;当风险得分超过阈值时,门控机制激活 LoRA,持续 K 步将生成轨迹重定向至安全回复。这种设计在提升安全性的同时,最小化了对通用多模态能力的干扰,有效缓解了“安全对齐税”问题。
英文题目:SafeRI: Recognition and Intervention for Token-Level Safety Intervention in Large Vision Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.03544
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有 VLM 安全对齐方法(如 always-on fine-tuning 或 global adapters)会全局修改模型行为,导致对已安全轨迹的不必要扰动,产生“安全对齐税”,降低通用多模态能力或导致过度拒绝。输入级防御无法预见生成内容,输出级防御滞后,而训练时对齐则永久改变模型分布。
VLM 的安全风险往往在自回归生成过程中动态显现,而非仅由输入决定。因此,需要一种能够根据生成状态动态决定是否干预的机制。SafeRI 正是针对这一需求,提出了基于 pre-token hidden states 的流式风险识别与门控 LoRA 干预框架。
与 Safety Reminder 等使用 soft prompts 的推理时 guardrail 不同,SafeRI 使用学习的 LoRA 激活机制,能够更精细地控制干预时机和强度。与 IMMUNE 等推理时对齐基线相比,SafeRI 在保持通用能力方面表现更优。
核心创新
- 将后对齐安全加固形式化为选择性轨迹控制问题,而非全局重学习。
- 提出流式风险识别器,基于 pre-token hidden states 进行因果但非回溯的风险预测。
- 设计门控 LoRA 机制,仅在检测到风险时激活,保持安全轨迹下的原始策略不变。
- 两阶段解耦训练:分离识别边界学习与安全续写生成学习,避免相互干扰。
方法概览
SafeRI 包含两个核心组件:1. Streaming Risk Recognizer:一个轻量级线性头,读取冻结骨干网络最后一层的 hidden states,预测当前前缀状态是否即将进入不安全区域(二分类:Safe/Unsafe)。2. Gated LoRA Intervention:插入在骨干网络中间层的 LoRA 适配器。当识别器得分超过阈值 τ 时,门控机制激活 LoRA,持续 K 步(sticky window),将生成轨迹重定向至安全回复;风险消退后门控关闭,恢复冻结骨干策略。训练分为两阶段:Stage 1 训练识别器边界分类,Stage 2 训练 LoRA 生成安全续写。
- Streaming Risk Recognizer:一个轻量级线性头,读取冻结骨干网络最后一层的 hidden states,预测当前前缀状态是否即将进入不安全区域(二分类:Safe/Unsafe)。
- Gated LoRA Intervention:插入在骨干网络中间层的 LoRA 适配器。当识别器得分超过阈值 τ 时,门控机制激活 LoRA,持续 K 步(sticky window),将生成轨迹重定向至安全回复;风险消退后门控关闭,恢复冻结骨干策略。
- 两阶段解耦训练:Stage 1 训练识别器边界分类,Stage 2 训练 LoRA 生成安全续写。这种分离避免了识别与干预模块之间的相互干扰。
- Sticky Window 机制:风险触发后保持激活 K 步,确保干预的连续性。每次新的阈值跨越都会重置窗口到 K 步,防止风险反复触发导致的频繁切换。
- LoRA 插入位置选择:通过消融实验确定中间五层(Middle 5 layers)为最优插入位置,带来最大的安全增益和最小的通用能力损失。
- 阈值 τ 和窗口大小 K 的调优:通过实验确定最优的 τ 和 K 值,平衡安全性与通用能力。
逐图理解论文
失败案例
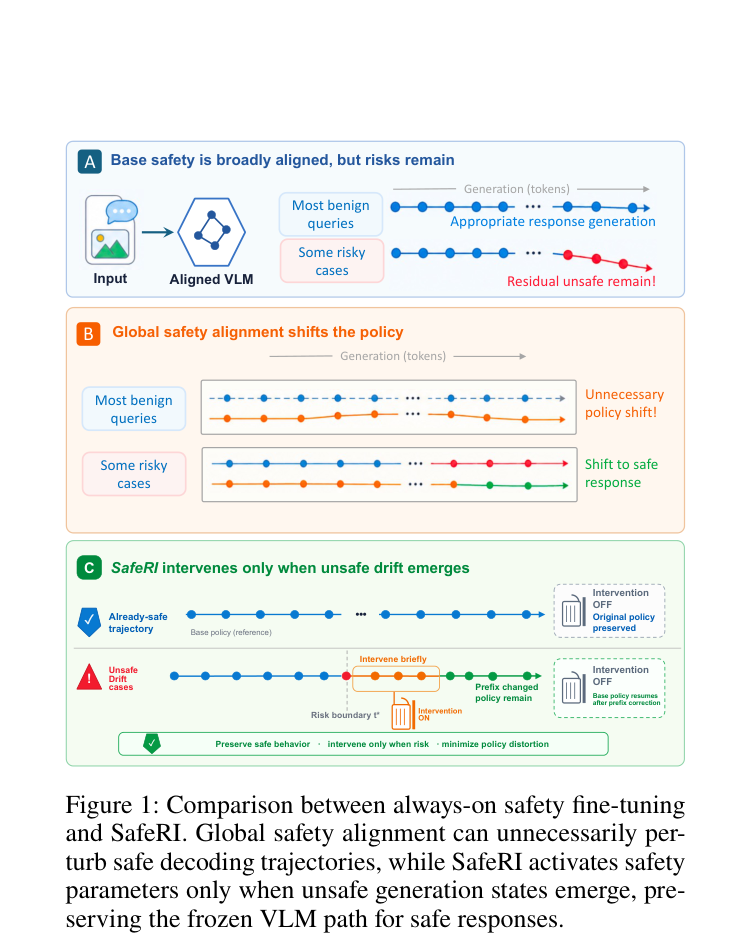
该图对比了 always-on safety fine-tuning 和 SafeRI 的工作机制。全局安全对齐会不必要地扰动安全解码轨迹,而 SafeRI 仅在出现不安全生成状态时激活安全参数,保持冻结 VLM 路径用于安全响应。
核心贡献
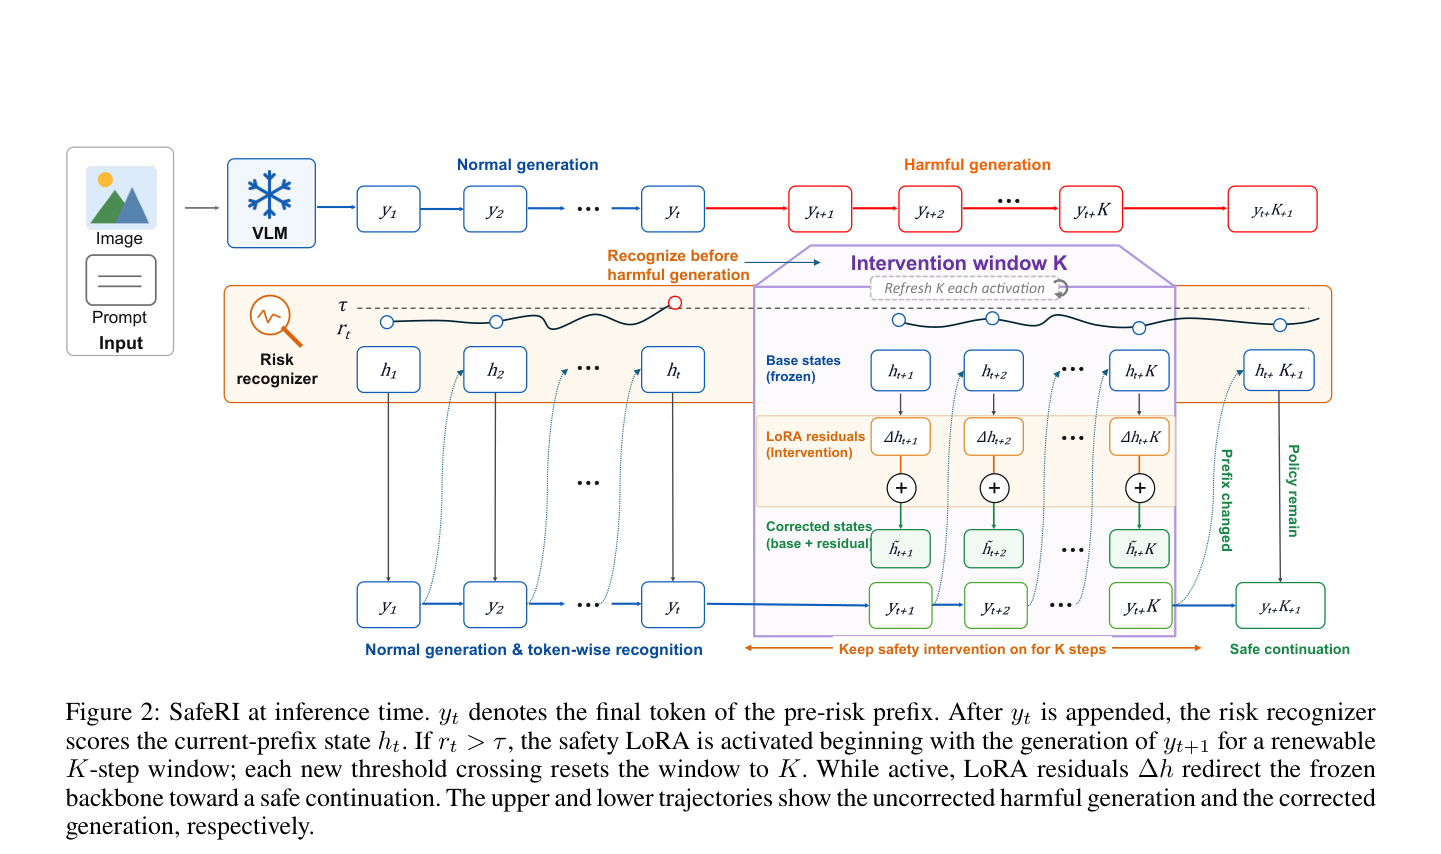
该图展示了 SafeRI 在推理时的工作流程。yt 表示风险前缀的最后一个 token。在 yt 附加后,风险识别器对当前前缀状态 ht 进行评分。如果 rt > τ,安全 LoRA 从生成 yt+1 开始激活,持续 K 步窗口;每次新的阈值跨越都会重置窗口到 K 步。
最强结论
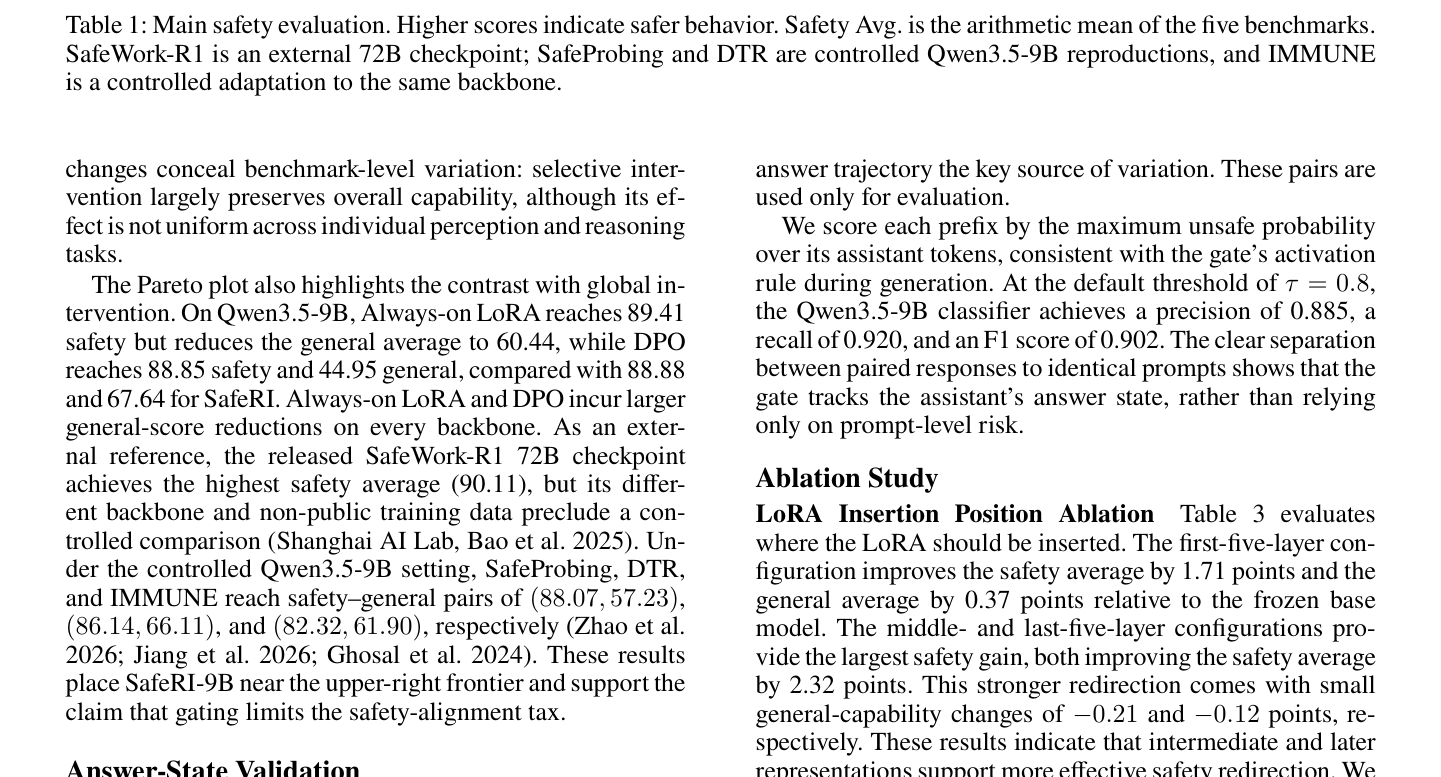
该表展示了主要安全评估结果。更高的分数表示更安全的行为。Safety Avg. 是五个基准的算术平均值。SafeWork-R1 是外部 72B 检查点;SafeProbing 和 DTR 是受控的 Qwen3.5-9B 复现,IMMUNE 是相同骨干的受控适配。
意义与局限
SafeRI 为 VLM 提供了可解释、低开销的推理时安全干预机制,但其效果依赖于风险检测器的准确校准和细粒度的边界监督。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在 Qwen3.5-9B, Qwen3.5-4B, Qwen3.5-2B, Llama3.2-Vision-11B 上评估安全性与通用能力。
- 对比基线包括 Base, Always-on LoRA, DPO, SafeProbing, DTR, IMMUNE, SafeWork-R1。
- 消融实验涵盖 LoRA 插入位置、门控阈值 τ、干预窗口大小 K。
- 分析激活原因(input-induced vs. drift-based)及推理效率。
- 使用 SPA-VL 数据集构建训练数据,并在 HarmBench, MSSBench 等基准上评估安全性。
关键结果与论文证据
- Qwen3.5-9B Safety Avg. 从 Base 的 86.56 提升至 88.88,General Avg. 从 67.85 微降至 67.64(Page 6)。
- Qwen3.5-9B Always-on LoRA Safety Avg. 为 89.41,但 General Avg. 降至 60.44;DPO General Avg. 降至 44.95(Page 6)。
- Qwen3.5-9B 识别器在 τ=0.8 时 Precision 0.885, Recall 0.920, F1 0.902(Page 6)。
- LoRA 插入中间五层(Middle 5 layers)带来 +2.32 Safety Avg. 增益,General Avg. 变化 -0.21(Page 7)。
- 干预窗口 K=8 时 Safety Avg. 88.88, General Avg. 67.64,优于 K=4 (65.00) 和 K=12 (67.07)(Page 7)。
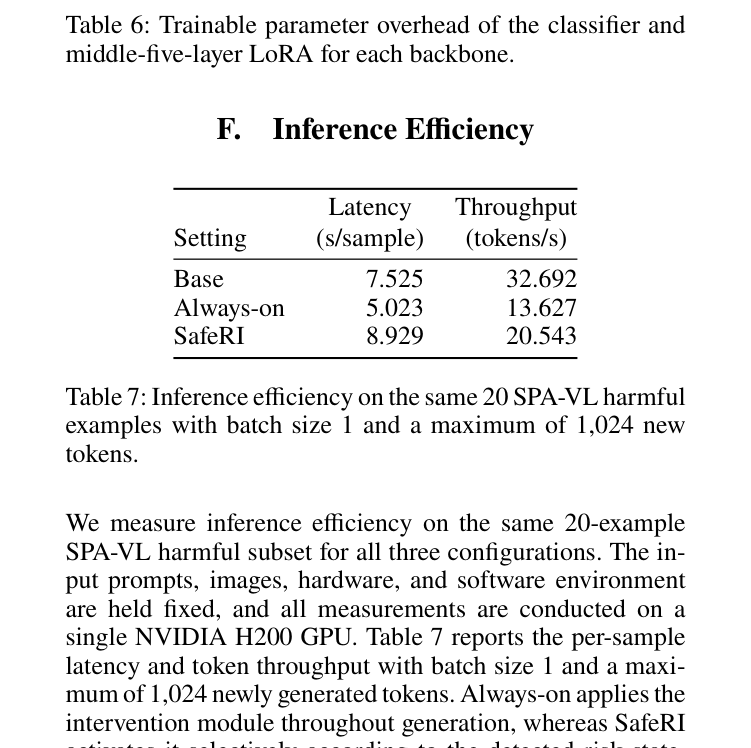
- SafeRI 推理延迟 8.929 s/sample,吞吐量 20.543 tokens/s;Always-on 延迟 5.023 s/sample,吞吐量 13.627 tokens/s(Page 12)。
- Qwen3.5-9B 可训练参数开销:Classifier 8,194 + LoRA 6,062,080 ≈ 6.07M(Page 12)。
阅读时需要注意
- 依赖准确的风险检测器校准和细粒度的不安全生成边界监督。
- 聚合能力的保持并不意味着所有单个基准测试性能均匀提升,安全-效用权衡仍具有任务依赖性。
- 当前采用 off-policy 训练范式,识别与干预模块基于固定轨迹优化,未联合适应模型自身生成的演化轨迹。
关联工作
- VLGuard (Zong et al. 2024):Training-time safety alignment baseline; SafeRI avoids global perturbation. (Page 2)
- SPA-VL (Zhang et al. 2024):Source dataset for training data construction. (Page 2)
- Safety Reminder (Tang et al. 2025):Inference-time guardrail using soft prompts; SafeRI uses learned LoRA activation. (Page 2)
- IMMUNE (Ghosal et al. 2024):Inference-time alignment baseline; SafeRI shows better utility preservation. (Page 2)
- LoRA (Hu et al. 2022):Parameter-efficient adaptation technique used for the intervention module. (Page 2)
- SafeProbing (Zhao et al. 2026):Controlled baseline for in-decoding safety awareness probing. (Page 6)
- DTR (Jiang et al. 2026):Dynamic Token Reweighting baseline. (Page 6)