快速导读:本文提出了一种可提示的局部化运动表示方法,通过在全局视频上下文中提取特定区域的运动嵌入,实现了高精度的对象级运动迁移与组合场景生成,并在局部动作分类任务中优于基于裁剪或掩码的全局方法。
真实世界场景具有高度的组合性,多个实体往往同时运动且相互交互。现有的视频运动表示方法大多采用全局编码或像素级光流,前者容易将不同实体的动态纠缠在一起,后者则缺乏语义可解释性。这种局限性使得在复杂场景中精确控制特定对象的运动变得极具挑战。
本文提出了一种可提示的局部化运动表示方法,旨在解决这一核心问题。该方法通过在全局视频上下文中提取特定区域的运动嵌入,实现了高精度的对象级运动迁移与组合场景生成。其核心思想是,运动是关系性的,必须依赖全局参考系才能被准确解释,因此局部化表示不能以牺牲全局上下文为代价。
英文题目:What Moves? Localized Motion Representations for Compositional Scene Control
论文出处:arXiv 每日论文精选 · arXiv:2609.04383
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在视频生成与控制领域,运动表示的粒度一直是一个关键问题。全局运动嵌入虽然能够捕捉场景的整体动态,但无法区分不同实体的独立运动,导致在需要精确控制特定对象时出现运动泄漏或歧义。相反,像素级光流虽然提供了密集的运动信息,但缺乏语义结构,难以直接用于高层级的运动迁移任务。
简单的空间裁剪或后处理掩码方法看似能够解决局部化问题,但实际上会丢失解释运动所需的全局上下文。例如,相机运动、物体间的交互以及尺度变化等信息对于准确理解局部运动至关重要。如果仅依赖裁剪后的局部区域,模型可能会错误地将相机运动归因于物体运动,或者在物体发生交互时产生运动混淆。
此外,现有的运动迁移方法通常处于两个极端:要么是低层轨迹控制,虽然保真度高但缺乏泛化性,无法适应不同的物体结构;要么是全局语义迁移,虽然能够泛化到不同结构但缺乏空间隔离性,导致运动错误地传播到非目标区域。这种二元对立限制了视频生成在复杂组合场景中的应用。
核心创新
- 提出可提示的局部化运动表示,在保留全局上下文的同时提取区域特定运动嵌入。
- 证明局部运动编码需要全局上下文,裁剪或后处理掩码方法不足以捕捉准确的局部动态。
- 实现对象级运动迁移和组合场景生成,支持从多个源视频提取运动并重组到单一目标场景中。
方法概览
模型包含三个组件:(1) Content Encoder 提取静态区域外观特征作为查询;(2) Motion Encoder 处理完整视频,利用内容嵌入作为查询提取持久且区域特定的运动令牌;(3) Masked Tracks Decoder 通过预测区域内稀疏点的未来轨迹来监督运动令牌,使用 L2 损失。在生成阶段,将运动和内容令牌附加到视频扩散模型(CogVideoX-5B)的时间自注意力层中,通过 LoRA 微调。
- Content Encoder:提取静态区域的外观特征,作为查询以提供外观锚定,确保运动表示与特定物体的视觉特征相关联。
- Motion Encoder:处理完整视频,利用内容嵌入作为查询,提取持久且区域特定的运动令牌。这一过程保留了全局上下文,使得运动表示能够准确反映物体在场景中的动态关系。
- Masked Tracks Decoder:通过预测区域内稀疏点的未来轨迹来监督运动令牌,使用 L2 损失。这种监督方式强制模型学习局部化的运动信息,同时避免了对非目标区域的过度拟合。
- 视频模型条件化:在生成阶段,将运动和内容令牌附加到视频扩散模型(CogVideoX-5B)的时间自注意力层中,通过 LoRA 微调。这种设计使得模型能够在生成过程中精确地利用局部运动表示,实现可控的视频生成。
- 运动选择性优化:通过平衡区域内运动保真度和区域外运动泄漏度,优化运动表示的空间隔离性。运动选择性定义为保真度与泄漏度的差值,是评估局部化运动表示质量的关键指标。
- 组合场景生成:支持从多个源视频提取运动并重组到单一目标场景中。这一能力使得用户可以将不同视频中的运动片段组合在一起,生成具有复杂动态的新场景。
逐图理解论文
直觉与失败案例
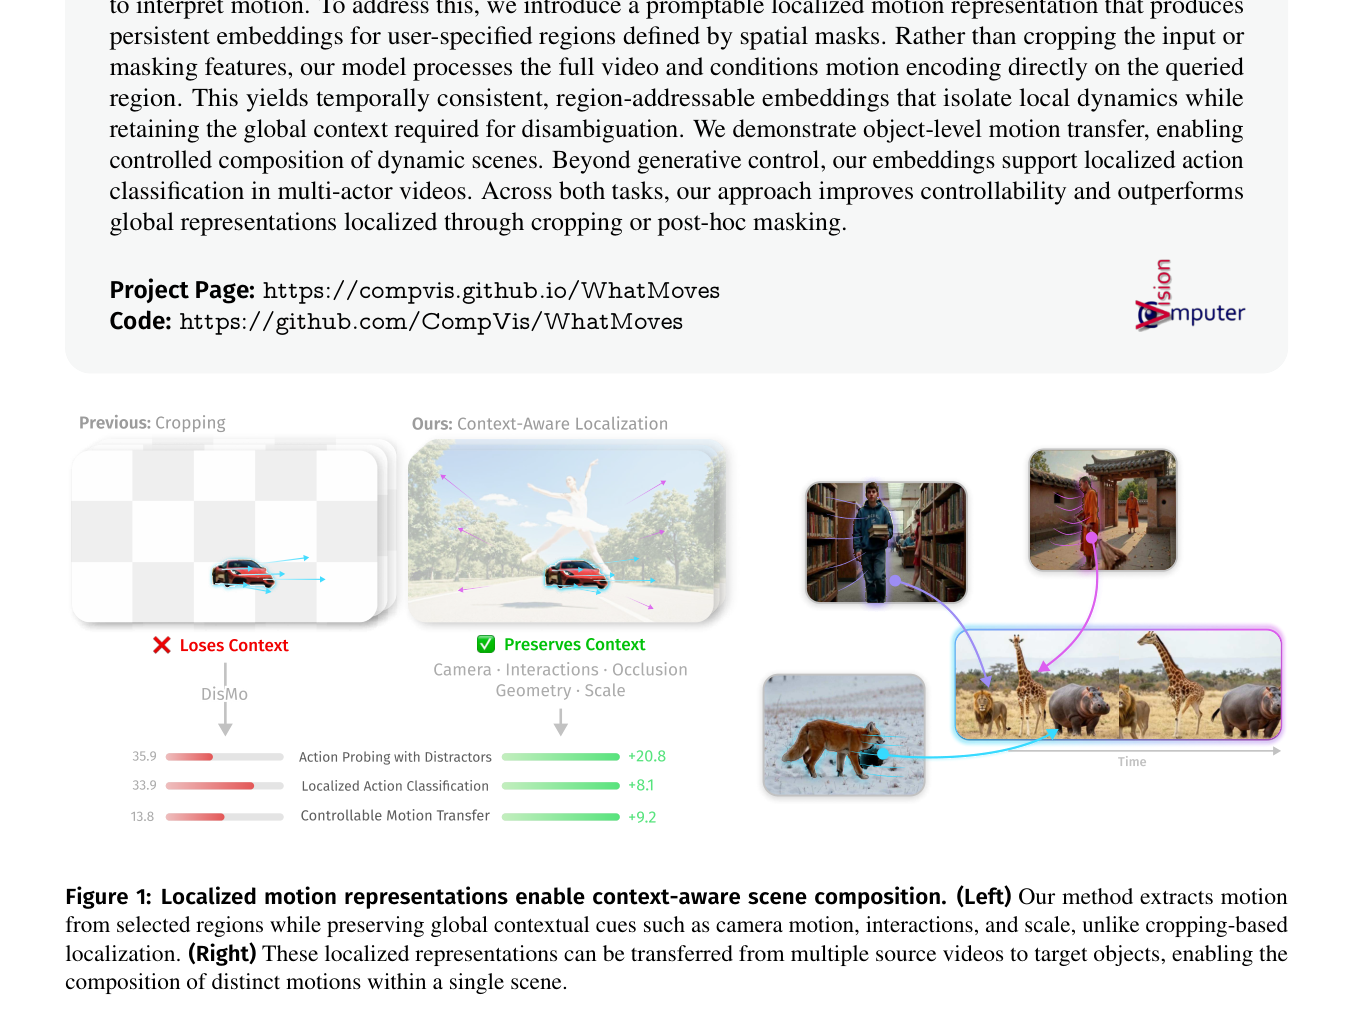
该图展示了局部化运动表示如何启用上下文感知的场景组合。左侧对比了本文方法与基于裁剪的局部化方法,突出显示了保留全局上下文的重要性。右侧展示了从多个源视频提取运动并转移到目标对象的能力,直观地说明了组合场景生成的过程。
研究差距
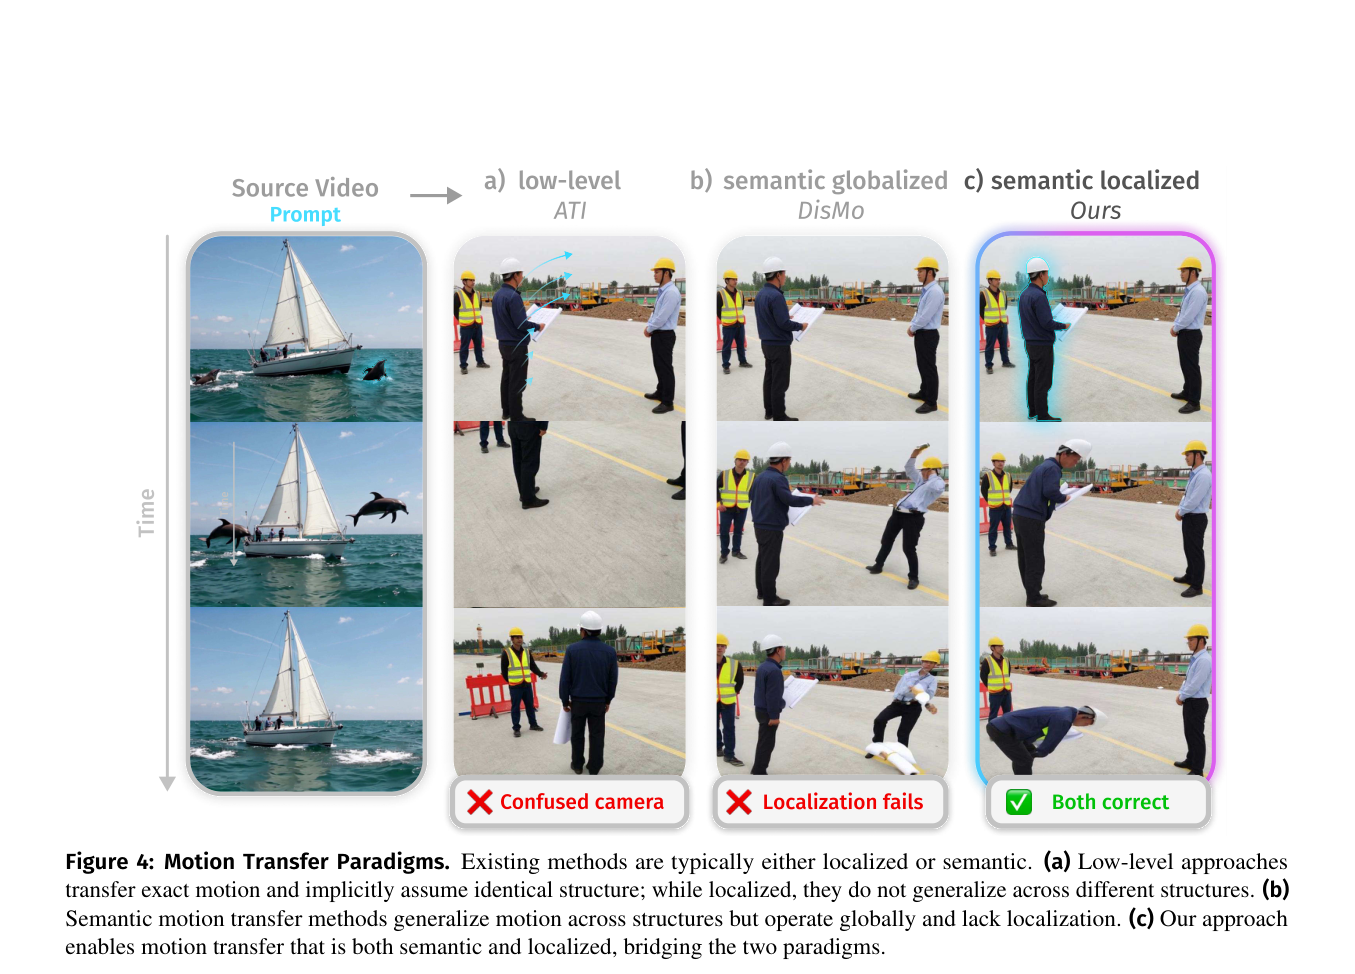
该图对比了现有的运动迁移范式。低层方法转移精确运动但缺乏泛化性,语义方法泛化运动但缺乏局部化,而本文方法桥接了这两种范式,实现了既语义又局部化的运动迁移。这一对比图清晰地阐明了本文方法的创新点和优势。
核心贡献
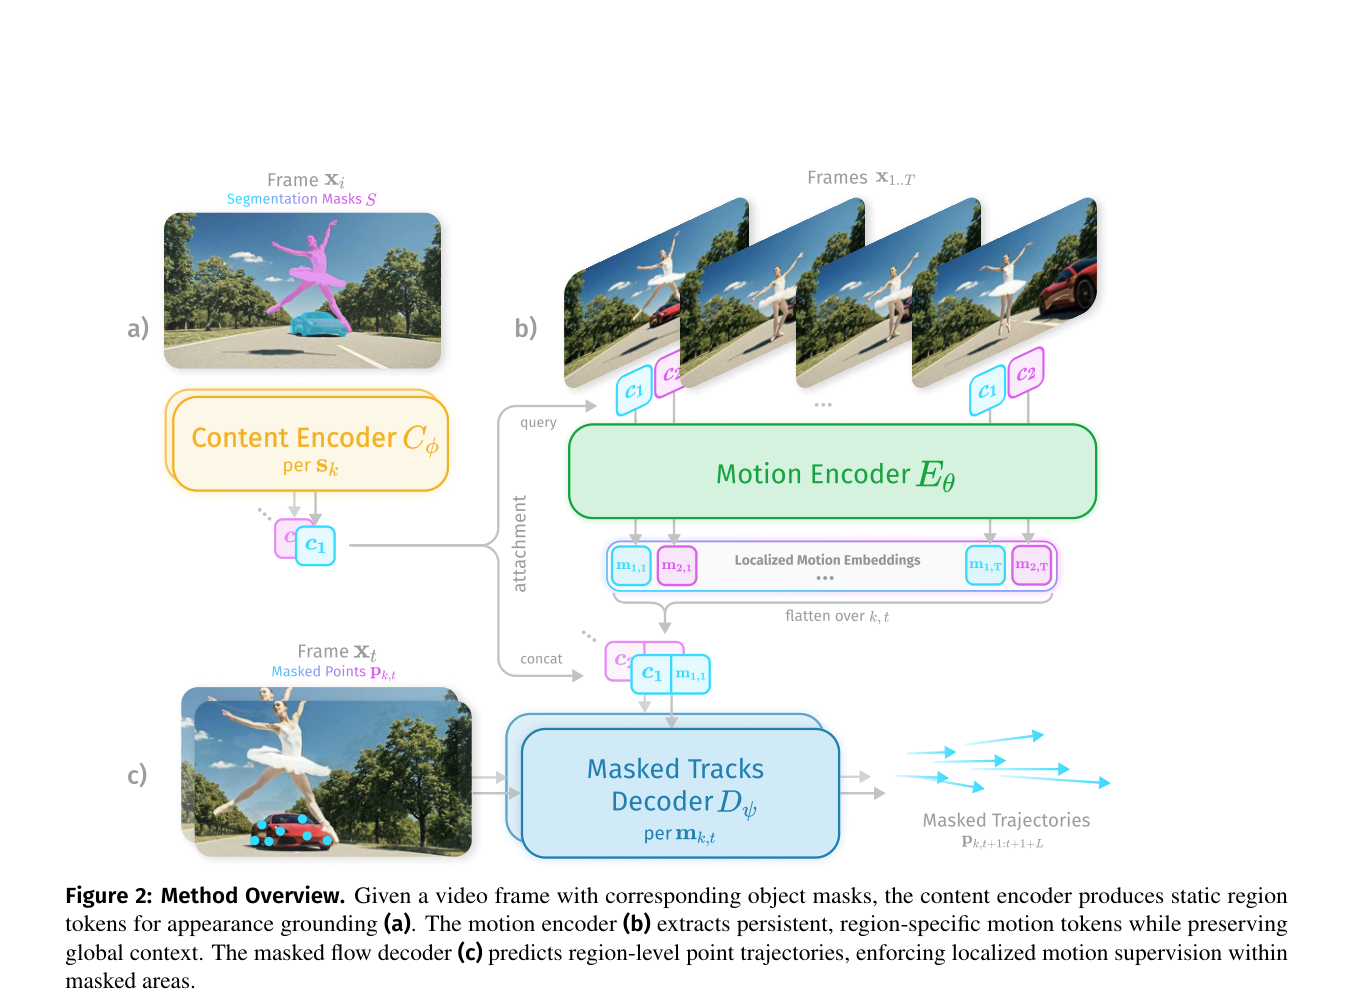
该图概述了本文方法的整体架构。内容编码器产生静态区域令牌,运动编码器提取持久且区域特定的运动令牌,掩码流解码器预测区域级点轨迹。这一流程图清晰地展示了三个组件之间的交互关系,以及局部化运动监督的实现方式。
最强结论
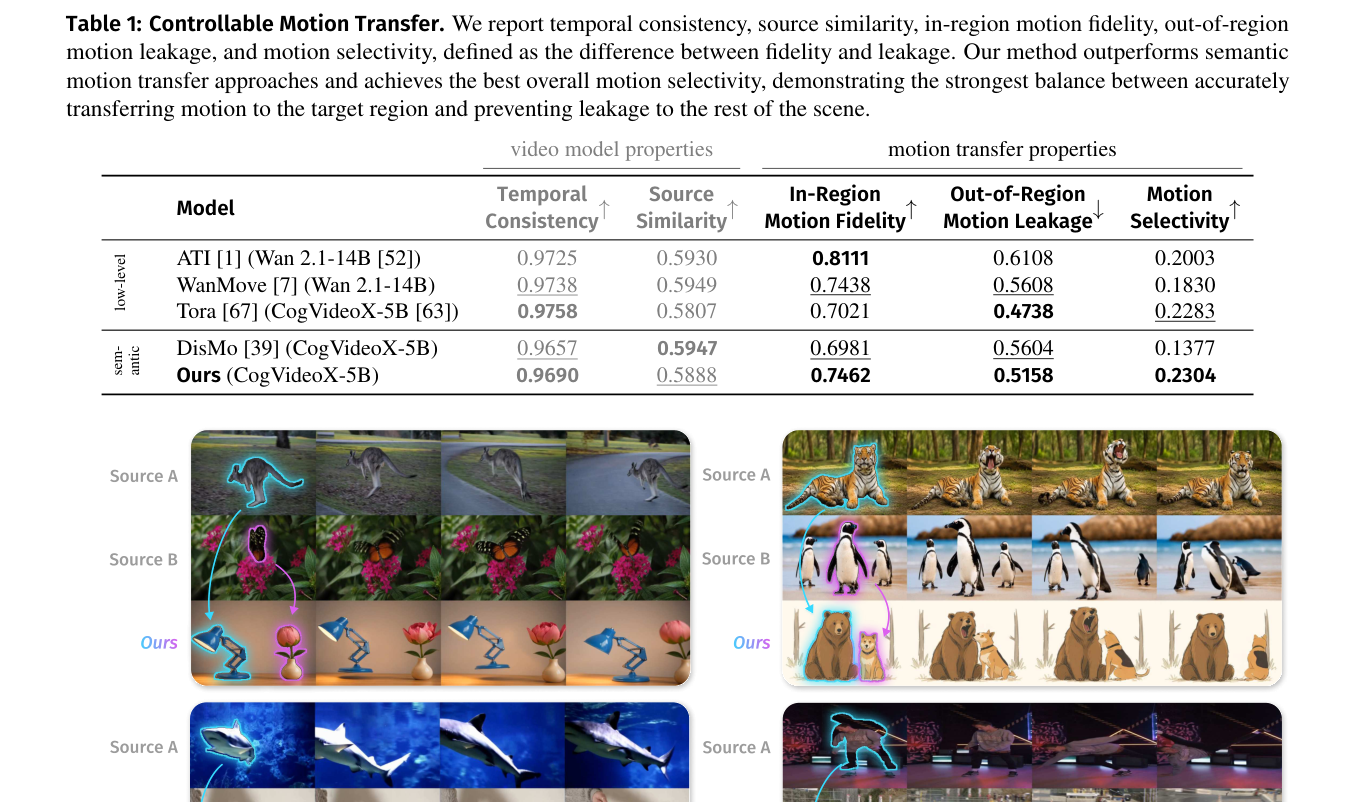
该表报告了可控运动迁移的结果,包括时间一致性、源相似性、区域内运动保真度、区域外运动泄漏和运动选择性。本文方法在运动选择性上表现最佳,证明了其在平衡运动保真度和空间隔离性方面的优势。
实验如何设计?
- Controllable Motion Transfer:评估运动迁移到指定目标区域的能力,对比低层轨迹方法和全局语义方法,重点关注运动保真度和泄漏度。
- Composable Motion Transfer:评估从多个源视频提取运动并组合到单一场景的能力,测试模型在复杂组合场景中的表现。
- Localized Action Classification:在 A2D 数据集上评估零样本局部动作分类,测试模型对干扰项的鲁棒性,以及局部化表示在动作识别中的有效性。
- Global Motion Understanding:在 SSv2, Jester, Diving48, ARID, IARD 等基准上评估全局动作分类性能,验证模型在保留全局上下文方面的能力。
- Motion Retrieval:在 SemanticMoments 合成基准上评估外观变换下的运动检索能力,测试运动表示对视觉变化的鲁棒性。
- Action Probing under Distractors:在 LAOM DCS 数据集上评估视觉干扰下的动作对齐能力,验证局部化表示在存在干扰项时的性能优势。
关键结果与论文证据
- 在运动迁移任务中,本文方法在运动选择性上显著优于 DisMo 和 ATI,表明其在平衡运动保真度和空间隔离性方面具有优势(第8页)。
- 人类偏好研究显示,本文方法在真实感、运动迁移质量和局部性方面获得了更高的用户评分,进一步验证了其生成质量(第9页)。
- 在局部动作分类任务中,本文方法优于基于裁剪或掩码的全局方法,证明局部运动编码需要全局上下文才能准确捕捉局部动态(第10页)。
- 在全局动作分类基准上,本文方法表现出与 DisMo 相当的性能,表明其在保留全局上下文方面的有效性(第10页)。
- 在运动检索任务中,本文方法在外观变换下表现出鲁棒的检索能力,验证了运动表示的语义泛化性(第10页)。
- 在视觉干扰下的动作探测任务中,本文方法显著优于全局 DisMo 和 RGB 裁剪方法,表明表示级别的局部化能够更好地保留动作相关信息(第11页)。
阅读时需要注意
- 运动编码器需要处理完整视频,计算成本可能高于仅处理裁剪区域的方法,限制了其在实时应用中的扩展性。
- 依赖准确的对象掩码作为输入,掩码质量可能影响最终性能,对自动掩码生成算法的准确性提出了较高要求。
- 在低层运动保真度上略低于纯轨迹方法(如 ATI),但在空间隔离性上更优,表明在保真度和泛化性之间存在一定的权衡。
关联工作
- DisMo:主要对比基线,全局运动表示方法,本文方法在局部化控制和动作分类上优于它,突出了局部化表示的优势。
- ATI:低层轨迹控制方法,运动保真度高但缺乏泛化性和空间隔离性,本文方法在保持高保真度的同时实现了更好的空间隔离。
- CogVideoX:作为视频生成骨干网络,本文方法通过 LoRA 微调其以支持局部运动条件,展示了与现有视频生成模型的兼容性。
- DINOv2:用于帧嵌入初始化,提供强大的视觉特征基础,增强了内容编码器的外观锚定能力。
- MaskLAM:在干扰项下的动作探测任务中作为对比基线,本文方法在表示级别的局部化上表现出更好的鲁棒性。